

Compania Google a lansat un nou codec audio Lyra, optimizat pentru a oferi o calitate maximă a transmisiei vocale chiar și în condiții de linii de comunicație foarte lente. Codul sursă al lui Lyra este scris în C++ și este deschis sub licența Apache 2.0, dar printre dependențele necesare pentru funcționare se numără o bibliotecă proprietară libsparse_inference.so care implementează nuclee pentru calcule matematice. Se observă că biblioteca proprietară este temporară — în viitor, Google promite să dezvolte o alternativă deschisă și să asigure suport pentru diverse platforme.
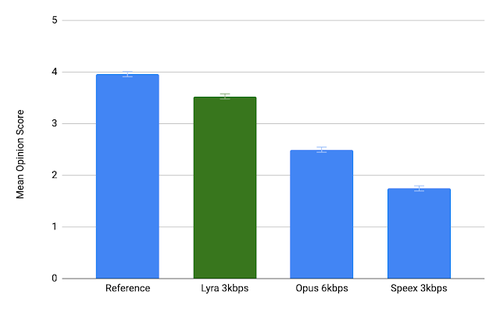
În ceea ce privește calitatea datelor vocale transmise la viteze reduse, Lyra depășește semnificativ codecurile tradiționale care utilizează metode de procesare digitală a semnalelor. Pentru a asigura o calitate ridicată a transmisiei vocii în condiții de volum limitat de informații transmise, în afară de metodele obișnuite de comprimare a sunetului și conversie a semnalelor, Lyra folosește un model de vorbire bazat pe un sistem de învățare automată, care permite recrearea informației lipsă pe baza caracteristicilor tipice ale vocii. Modelul utilizat pentru generarea sunetului a fost antrenat folosind mii de ore de înregistrări vocale în peste 70 de limbi.
Codecul include un coder și un decoder. Algoritmul de funcționare al coderului constă în extragerea parametrilor datelor vocale la fiecare 40 de milisecunde, comprimarea acestora și transmiterea către destinatar prin rețea. Pentru transmiterea datelor este suficient un canal de comunicație cu o viteză de 3 kilobiți pe secundă. Parametrii sonori extrasi includ spectrograma mel-logaritmică, care are în vedere caracteristicile energiei vocale în diferite intervale de frecvență și este pregătită ținând cont de modelul percepției auditive umane.
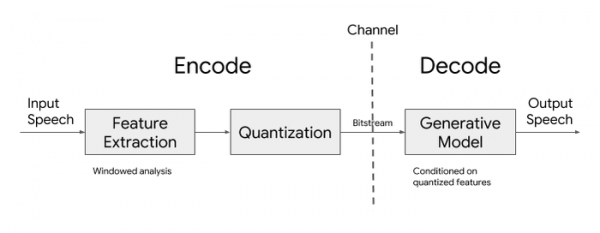
Decodorul utilizează un model generativ care recreează semnalul de vorbire pe baza parametrilor audio transmiși. Pentru a reduce complexitatea calculilor, a fost aplicat un model ușor bazat pe rețele neuronale recurente, care este o variantă a modelului de sinteză vocală WaveRNN, în care se folosește o frecvență de eșantionare mai mică, dar se generează simultan mai multe semnale în diferite intervale de frecvență. Semnalele obținute sunt apoi suprapuse pentru a crea un singur semnal de ieșire corespunzător frecvenței de eșantionare specificate.
Pentru a accelera procesul, au fost de asemenea utilizate instrucțiuni procesor speciale disponibile pe procesoarele ARM pe 64 de biți. Ca urmare, în ciuda utilizării învățării automate, codec-ul Lyra poate fi utilizat pentru codificarea și decodificarea vorbirii în timp real pe smartphone-uri de mijloc, demonstrând o întârziere a transmisiei semnalului de 90 de milisecunde.
Sursa: opennet.ro
