

De-a lungul anilor de utilizare a Kubernetes în producție, am acumulat multe povești interesante despre cum bug-urile din diferitele componente de sistem au dus la consecințe neplăcute și/sau neclare, afectând funcționarea containerelor și a pod-urilor. În acest articol, am compilat unele dintre cele mai frecvente sau interesante dintre ele. Chiar dacă nu aveți niciodată ocazia să vă confruntați cu astfel de situații, a citi despre aceste scurte mistere — mai ales „din prima mână” — este întotdeauna captivant, nu-i așa?...
Povestea 1. Supercronic și Docker-ul suspendat
Pe unul dintre clustere, am avut periodic Docker-ul „suspendat”, ceea ce a împiedicat funcționarea normală a clusterului. În log-urile Docker-ului, am observat următoarele
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create failed: No space left on device
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
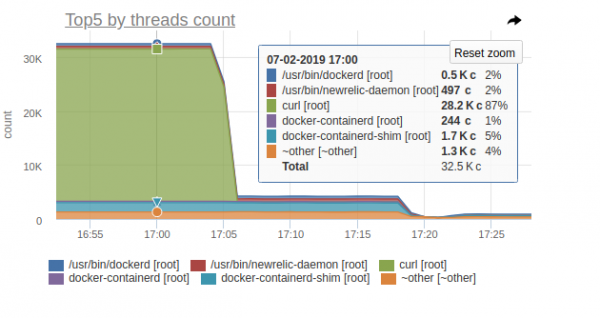
În această eroare, cel mai mult ne interesează mesajul: pthread_create failed: No space left on device. O examinare rapidă a explicat că Docker-ul nu poate fork-ui un proces, ceea ce a dus periodic la „suspendare”.
În monitorizarea situației, se observă următoarea imagine:
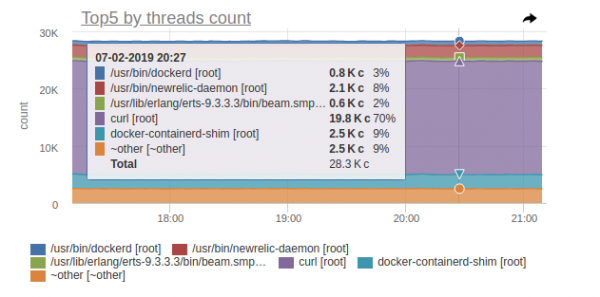
O situație similară se observă și pe alte noduri:
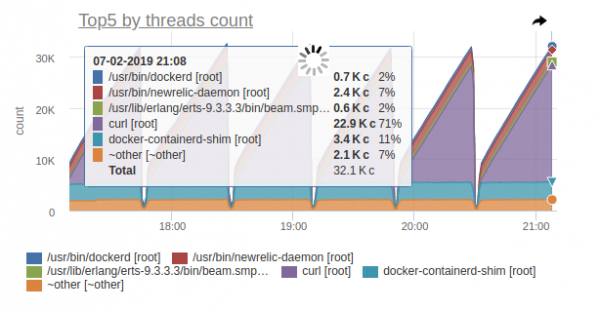
Pe aceleași noduri vedem:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
S-a dovedit că acest comportament este o consecință a funcționării pod-ului cu (o unealtă scrisă în Go, pe care o folosim pentru a rula sarcini cron în pod-uri):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
Problema este următoarea: când sarcina este lansată în supercronic, procesul generat de acesta nu se poate încheia corect, transformându-se în .
Notă: Mai exact, procesele sunt generate de sarcini cron, însă supercronic nu este un sistem init și nu poate "adopta" procesele care au fost generate de copiii săi. Atunci când apar semnalele SIGHUP sau SIGTERM, acestea nu sunt transmise proceselor generate, rezultând în faptul că procesele copil rămân în statut de zombie. Mai multe informații despre acest subiect pot fi găsite, de exemplu, în .
Există câteva metode de rezolvare a problemelor:
- Ca o soluție temporară — creșteți numărul PID-urilor în sistem într-un singur moment:
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - Sau să faceți lansarea sarcinilor în supercronic nu direct, ci folosind același , care poate încheia corect procesele și nu generează zombii.
Povestea 2. „Zombii” la eliminarea cgroup
Kubelet a început să consume o cantitate mare de CPU:
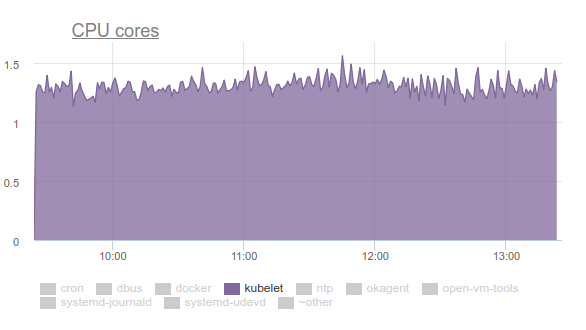
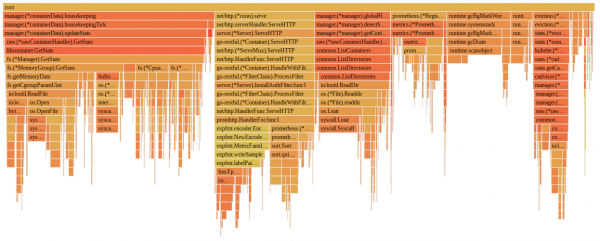
Asta nu va plăcea nimănui, așa că ne-am înarmat cu și am început să investigăm problema. Concluziile investigației au fost următoarele:
- Kubelet pierde mai mult de o treime din timpul procesorului pentru a extrage date despre memorie din toate cgroup:

- În corespondența dezvoltatorilor kernel-ului se poate găsi . Pe scurt, esența este că diverse fișiere tmpfs și alte lucruri similare nu sunt complet eliminate din sistem la eliminarea cgroup — rămân așa-numitele zombie. În cele din urmă, acestea vor dispărea din cache-ul paginilor, dar serverul are multă memorie, iar nucleul nu vede sensul în a cheltui timp pentru a le elimina. Prin urmare, acestea continuă să se acumuleze. De ce se întâmplă asta? Este un server cu sarcini cron care creează constant noi job-uri și, împreună cu acestea, noi pod-uri. Astfel, pentru containere se creează noi cgroup-uri, care sunt în cele din urmă eliminate.
- De ce cAdvisor în kubelet consumă atât de mult timp? Este ușor de observat prin simpla execuție
time cat /sys/fs/cgroup/memory/memory.stat. Dacă pe o mașină sănătoasă operația durează 0,01 secunde, pe cron02 problematică durează 1,2 secunde. Totul se datorează faptului că cAdvisor citește datele din sysfs foarte încet, încercând să contabilizeze memoria utilizată și cgroup-urile zombie. - Pentru a elimina forțat zombie, am încercat să curățăm cache-urile, așa cum a fost recomandat în LKML:
sync; echo 3 > /proc/sys/vm/drop_caches, — dar nucleul s-a dovedit a fi mai complicat și a înghețat mașina.
Ce trebuie să facem? Problema se rezolvă (, iar descrierea este în ) actualizând nucleul Linux la versiunea 4.16.
Povestea 3. Systemd și mount-ul său
Din nou, kubelet consumă prea multe resurse pe anumite noduri, dar de data aceasta — deja memorie:
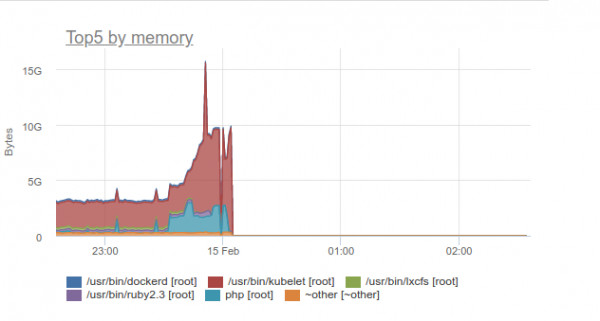
S-a descoperit că există o problemă în systemd, folosit în Ubuntu 16.04, care apare atunci când se gestionează mount-urile ce sunt create pentru a se conecta subPath din ConfigMap-uri sau secret-uri. După finalizarea muncii pod-ului serviciul systemd și mount-ul său auxiliar rămân în sistem. În timp, se acumulează o cantitate uriașă de acestea. Există chiar probleme legate de acest subiect:
- ;
- .
… în ultimul dintre care se face referire la PR în systemd: (problemă în systemd — ).
Problema nu mai există în Ubuntu 18.04, dar dacă doriți să continuați să utilizați Ubuntu 16.04, s-ar putea să aveți nevoie de workaround-ul nostru pe această temă.
Așadar, am creat următorul DaemonSet:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… și este folosit un astfel de script:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… și acesta este rulat la fiecare 5 minute cu ajutorul deja menționatului supercronic. Dockerfile-ul său arată astfel:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
Povestea 4. Concurența în planificarea pod-urilor
S-a observat că: dacă pe un nod se plasează un pod și imaginea acestuia este descărcată foarte lent, atunci un alt pod, care "a ajuns" pe același nod, pur și simplu nu începe să descarce imaginea noului pod.În schimb, așteaptă până când se termină descărcarea imaginii pod-ului anterior. Ca urmare, pod-ul care a fost deja planificat și imaginea căruia ar putea fi descărcată într-un minut, va rămâne o perioadă îndelungată în stadiul containerCreating.
În evenimente va fi cam așa:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal pulling image "registry.example.com/infra/openvpn/openvpn:master"Deci, rezultă că o singură imagine dintr-un registru lent poate bloca desfășurarea pe nod.
Din păcate, soluțiile sunt destul de limitate:
- Încercați să folosiți registrul Docker direct în cluster sau în mod direct cu clusterul (de exemplu, GitLab Registry, Nexus etc.);
- Folosiți utilitare precum .
Istoria 5. Blocarea nodurilor din cauza lipsei de memorie
În timpul utilizării diferitelor aplicații, am întâmpinat și situații în care un nod devenea complet inaccesibil: nu răspundea la SSH, toate demonii de monitorizare cădeau, iar în jurnale nu apărea nimic (sau aproape nimic) anormal.
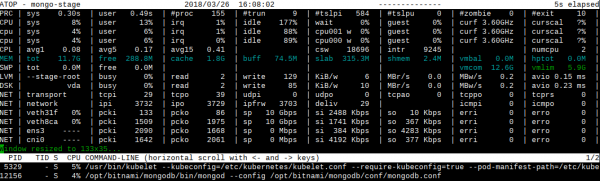
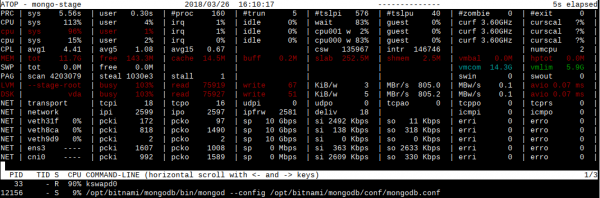
O să explic cu imagini folosind un exemplu de nod, unde funcționa MongoDB.
Așa arată atop la accidente:
Iată cum arată — după accidente:
În monitorizare, de asemenea, se observă o creștere bruscă, în care nodul devine inaccesibil:
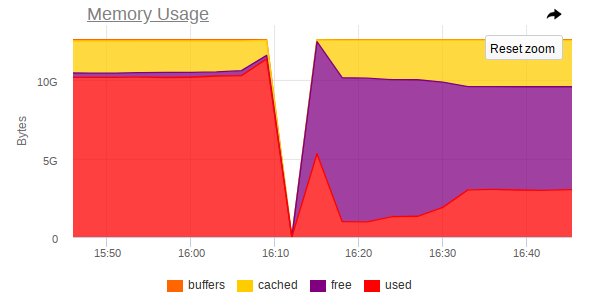
Astfel, din capturile de ecran se poate observa că:
- Memoria RAM de pe mașină este aproape pe sfârșite;
- Se observă o creștere bruscă a consumului de memorie RAM, după care accesul la întreaga mașină se deconectează brusc;
- Pe Mongo se trimite o sarcină mare, care determină procesul SGBD să folosească mai multă memorie și să citească activ de pe disc.
Se pare că, dacă în Linux se termină memoria liberă (apare presiunea de memorie) și swap-ul nu este disponibil, atunci la apariția OOM killer-ului poate duce la un echilibru între aruncarea paginilor în cache-ul paginilor și scrierea lor înapoi pe disc. Acest lucru este gestionat de kswapd, care eliberează curajos cât mai multe pagini de memorie pentru distribuirea ulterioară.
Din păcate, sub o sarcină mare de intrare/ieșire împreună cu o cantitate mică de memorie liberă, kswapd devine gâtul de sticlă al întregii sisteme, deoarece pe el se leagă tot alocările (paginile defectuoase) de memorie din sistem. Acest lucru poate dura foarte mult, dacă procesele nu vor să folosească mai multă memorie, și se fixează la marginea prăpastiei OOM-killer.
Este o întrebare legitimă: de ce OOM killer apare atât de târziu? În iterația sa actuală, OOM killer-ul este extrem de prost: va distruge procesul doar atunci când va eșua încercarea de a aloca o pagină de memorie, adică dacă pagina defectuoasă apare cu eroare. Acest lucru nu se întâmplă de mult timp, deoarece kswapd eliberează curajos paginile de memorie, resetând cache-ul de pagini (întreg I/O de disc din sistem, de fapt) înapoi pe disc. Detalii mai exacte, cu descrierea pașilor necesari pentru a remedia problemele de acest fel în nucleu, pot fi găsite .
Această comportare cu nucleul Linux 4.6+.
Istoria 6. Podurile rămân în starea Pending
În unele clustere în care funcționează cu adevărat multe poduri, am început să observăm că majoritatea lor rămân foarte mult timp "suspendate" în stare Pending, deși containerele Docker sunt deja pornite pe noduri și pot fi manipulate manual.
Cu toate acestea, în describe nu este nimic rău:
  Tip    Motiv                    Vârstă               De la                     Mesaj
  ----    ------                  ----               ----                     -------
  Normal  Programat               1m                 default-scheduler        Atribuire reușită a sphinx-0 la ss-dev-kub07
  Normal  Atașare volum de succes  1m                 attachdetach-controller  Atașarea volumului.Attach a reușit pentru volumul "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  Montare volum de succes   1m                 kubelet, ss-dev-kub07    Montarea volumului.SetUp a reușit pentru volumul "sphinx-config"
  Normal  Montare volum de succes   1m                 kubelet, ss-dev-kub07    Montarea volumului.SetUp a reușit pentru volumul "default-token-fzcsf"
  Normal  Montare volum de succes   49s (x2 pe parcursul a 51s)  kubelet, ss-dev-kub07    Montarea volumului.SetUp a reușit pentru volumul "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normal  Extras                  43s                kubelet, ss-dev-kub07    Imaginea containerului "registry.example.com/infra/sphinx-exporter/sphinx-indexer:v1" este deja prezentă pe mașină
  Normal  Creat                  43s                kubelet, ss-dev-kub07    Container creat
  Normal  Pornit                 43s                kubelet, ss-dev-kub07    Container pornit
  Normal  Extras                  43s                kubelet, ss-dev-kub07    Imaginea containerului "registry.example.com/infra/sphinx/sphinx:v1" este deja prezentă pe mașină
  Normal  Creat                  42s                kubelet, ss-dev-kub07    Container creat
  Normal  Pornit                 42s                kubelet, ss-dev-kub07    Container pornit
După ce am cercetat, am făcut ipoteza că kubelet pur și simplu nu reușește să trimită API-ului informațiile despre starea podurilor, probele de liveness/readiness.
Și, studiind ajutorul, am găsit următoarele parametre:
--kube-api-qps - QPS de utilizat în comunicarea cu api-server-ul Kubernetes (presetat 5)
--kube-api-burst  - Burst de utilizat în comunicarea cu api-server-ul Kubernetes (presetat 10)
--event-qps - Dacă > 0, limitează crearea evenimentelor pe secundă la această valoare. Dacă 0, nelimitat. (presetat 5)
--event-burst - Dimensiunea maximă a înregistrărilor de evenimente foarte diverse, permite temporar înregistrările de evenimente să explodeze la acest număr, fără a depăși event-qps. Folosit doar dacă --event-qps > 0 (presetat 10)
--registry-qps - Dacă > 0, limitează QPS pentru pull-urile registry la această valoare.
--registry-burst - Dimensiunea maximă a pull-urilor foarte diverse, permite temporar pull-urile să explodeze la acest număr, fără a depăși registry-qps. Folosit doar dacă --registry-qps > 0 (presetat 10)
As you can see, valorile presetate sunt destul de mici, și în 90 % acoperă toate nevoile... Totuși, în cazul nostru, acest lucru s-a dovedit a fi insuficient. De aceea, am setat următoarele valori:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… și am repornit kubelet-urile, după care pe graficele de acces la API-server am observat următoarea imagine:
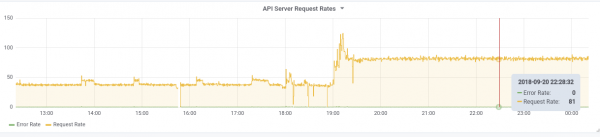
… și da, totul a început să meargă rapid!
P.S.
Îi mulțumesc mult inginerilor din compania noastră pentru ajutorul în adunarea bug-urilor și pregătirea articolului, în special colegului nostru din echipa R&D, Andrei Klimentiev ().
P.P.S.
Citiți și în blogul nostru:
- «».
- Ciclul de sfaturi și trucuri Kubernetes:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
