

Nota traducătorului.: autorii acestui articol sunt inginerii dintr-o mică companie cehă numită pipetail. Au reușit să compileze o listă remarcabilă de [probleme uneori banale, dar încă] atât de relevante legate de utilizarea clusterelor Kubernetes.
De-a lungul anilor de utilizare a Kubernetes, am avut ocazia să lucrăm cu un număr mare de clustere (atât gestionate, cât și negestionate - pe GCP, AWS și Azure). Cu timpul, am început să observăm că unele erori se repetă constant. Totuși, nu e nimic de care să ne fie rușine: noi înșine am comis cele mai multe dintre ele!
Articolul reunește cele mai frecvente greșeli, precum și menționează cum pot fi corectate.
1. Resurse: cereri și limite
Acest punct merită cu siguranță cea mai mare atenție și primele locuri în listă.
Cererea de CPU este de obicei fie deloc specificată, fie are o valoare foarte mică (pentru a găzdui cât mai multe pod-uri pe fiecare nod). Astfel, nodurile devin supraîncărcate. În timpul unei sarcini mari, puterea de procesare a nodului este complet utilizată, iar o sarcină de lucru specifică primește doar ceea ce a 'cerut' prin throttling CPU. Acest lucru conduce la creșteri ale latențelor în aplicație, timeout-uri și alte consecințe neplăcute. (Pentru mai multe detalii, citiți un alt articol recent tradus de noi: „” — n. trad.)
BestEffort (extrem de nu recomandat):
resources: {}Cererea extrem de mică de CPU (extrem de nu recomandat):
   resources:
      Requests:
        cpu: "1m"
Pe de altă parte, stabilirea unei limite de CPU poate duce la o ocolire nejustificată a ciclurilor de către pod-uri, chiar dacă procesorul nodului nu este complet utilizat. Din nou, acest lucru poate duce la creșterea latențelor. Discuțiile continuă în jurul parametrului CPU CFS quota din nucleul Linux și throttling-ul CPU în funcție de limitele stabilite, precum și dezactivarea cotei CFS... Din păcate, limitele de CPU pot provoca mai multe probleme decât pot rezolva. Detalii suplimentare pot fi găsite la linkul de mai jos.
Supra-alocarea (overcommiting) memoriei poate duce la probleme mai mari. Atingerea limitei de CPU duce la omisiuni de cicluri, în timp ce atingerea limitei de memorie duce la 'uciderea' pod-ului. Ați observat vreodată OOMkill? Да, речь идет именно о нем.
Doriți să reduceți la minimum probabilitatea acestui eveniment? Nu alocați volume excesive de memorie și utilizați QoS Garantat (Calitate a Serviciului), setând cererea de memorie egală cu limita (așa cum este în exemplul de mai jos). Citiți mai multe despre acest lucru în (inginer principal la Zalando).
Burstable (probabilitate mai mare de a primi OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Ce ar putea ajuta la configurarea resurselor?
Folosind metrics-server puteți verifica consumul curent de resurse CPU și utilizarea memoriei de către poduri (și containerele din interiorul acestora). Probabil că îl folosiți deja. Pur și simplu executați comenzile următoare:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Cu toate acestea, acestea arată doar utilizarea curentă. Acesta poate oferi o idee aproximativă despre ordinele de magnitudine, dar în cele din urmă va fi nevoie de istoricul modificării metricilor în timp (pentru a răspunde la întrebări de genul: „Care a fost încărcătura maximă a CPU-ului?”, „Ce încărcătură a fost ieri dimineață?” — etc.). Pentru aceasta, puteți utiliza Prometheus, DataDog și alte instrumente. Acestea doar obțin metricile de la metrics-server și le stochează, iar utilizatorul le poate solicita și construi grafice corespunzătoare.
permite de automatizat acest proces. Acesta urmărește istoricul utilizării procesorului și memoriei și ajustează noile cerințe și limite pe baza acestei informații.
Utilizarea eficientă a capacităților de calcul este o sarcină dificilă. Este ca și cum ai juca constant Tetris. Dacă plătești prea mult pentru capacitățile de calcul cu un consum mediu scăzut (să zicem, ~10%), îți recomandăm să te uiți la produsele bazate pe AWS Fargate sau Virtual Kubelet. Acestea sunt construite pe un model de facturare serverless / pay-per-usage, ceea ce în astfel de condiții poate fi mai ieftin.
2. Liveness și readiness probes
În mod implicit, verificările de sănătate liveness și readiness în Kubernetes nu sunt activate. Și uneori sunt uitate…
Dar cum altfel poți iniția repornirea serviciului în cazul unei erori nereparabile? Și cum află un echilibror de sarcină că un anumit pod este gata să primească trafic? Sau că este capabil să proceseze mai mult trafic?
Adesea, aceste probe sunt confundate una cu cealaltă:
- Liveness — verifica „viabilitatea”, care repornește podul în cazul în care acesta se închide eșuat;
- Readiness — verificarea disponibilității, aceasta deconectează pod-ul de la serviciul Kubernetes în cazul unui eșec (acest lucru poate fi verificat cu ajutorul
kubectl get endpoints) și traficul către acesta nu ajunge până când următoarea verificare nu se finalizează cu succes.
Ambele aceste verificări SE EFECTUEAZĂ PE PARCURSUL ÎNTREGULUI CICLU DE VIAȚĂ AL POD-ULUI. Este foarte important.
Există o concepție greșită frecventă că probele de readiness sunt efectuate doar la început, astfel încât echilibrorul de sarcină să poată ști că pod-ul este gata (Gata) și poate începe să proceseze traficul. Cu toate acestea, acesta este doar un mod de aplicare.
Un alt mod este de a determina că traficul către pod este excesiv și îl suprasolicită (sau pod-ul efectuează calcule intensive în resurse). În acest caz, verificarea readiness ajută să reducă încărcarea pe pod și să-l «răcească». Finalizarea cu succes a verificării readiness în viitor permite din nou, creșterea încărcării pe pod. În acest caz (în cazul unui eșec al probei de readiness), eșecul verificării liveness ar fi foarte contraproductiv. De ce să reporniți pod-ul care este sănătos și muncește din greu?
Prin urmare, în unele cazuri, absența totală a verificărilor este mai bună decât activarea lor cu parametrii configurați greșit. Așa cum s-a menționat mai devreme, dacă verificarea liveness replică verificația readiness, atunci sunteți într-o mare încurcătură. O posibilitate ar fi să configurați , iar să-l lăsați deoparte.
Ambele tipuri de verificări nu ar trebui să eșueze în cazul căderii dependențelor comune; altfel, acest lucru va duce la un eșec în cascadă (de tip avalanșă) al tuturor pod-urilor. Cu alte cuvinte, .
3. LoadBalancer pentru fiecare serviciu HTTP
Cel mai probabil aveți în cluster servicii HTTP pe care doriți să le expuneți lumii externe.
Dacă deschideți un serviciu ca type: LoadBalancer, controlerul său (în funcție de furnizor) va furniza și va coordona un LoadBalancer extern (nu neapărat funcționând la L7, mai degrabă la L4), ceea ce poate afecta costurile (o adresă IP statică externă IPv4, puterea de calcul, tarifarea pe secundă) din cauza necesității de a crea un număr mare de astfel de resurse.
În acest caz, este mult mai logic să folosiți un singur echilibror de sarcină extern, deschizând serviciile ca type: NodePort. Sau, ceea ce este și mai bine, să implementați ceva de genul nginx-ingress-controller (sau traefik), care va acționa ca un singur NodePort endpoint-ul asociat cu un echilibru extern de sarcină și va rutează traficul în cluster folosind ingress-resurse Kubernetes.
Alte servicii (micro) din cluster care interacționează între ele pot «comunica» prin servicii de tip ClusterIP și mecanismul încorporat de descoperire a serviciilor prin DNS. Doar nu folosiți DNS-uri/IP-uri publice, deoarece acest lucru poate afecta latența și poate crește costurile serviciilor de cloud.
4. Scalarea automată a cluster-ului fără ținerea contului de caracteristicile sale
Atunci când se adaugă noduri în cluster și se elimină, nu trebuie să ne bazăm pe anumite metrici de bază, cum ar fi utilizarea CPU pe aceste noduri. Planificarea pod-ului trebuie să se facă ținând cont de numeroase limitări, cum ar fi afinitatea pod-urilor/nodurilor, taints și tolerations, cerințele resurselor, QoS etc. Folosirea unui autoscaler extern care nu ia în considerare aceste nuanțe poate duce la probleme.
Imaginați-vă că un anumit pod trebuie să fie planificat, dar toate resursele CPU disponibile sunt solicitate/ocupate și podul rămâne blocat în starea Pending. Autoscaler-ul extern vede utilizarea medie curentă a CPU (nu cea solicitată) și nu inițiază extinderea (scale-out) — nu adaugă un nou nod. Ca rezultat, acest pod nu va fi planificat.
În același timp, scalarea inversă (scale-in) — eliminarea unui nod din cluster — este întotdeauna mai greu de realizat. Imaginează-ți că ai un pod stateful (cu stocare persistentă conectată). Volumele persistente aparțin de obicei unei zone de disponibilitate specifice și nu sunt replicate în regiune. Astfel, dacă autoscaler-ul extern elimină un nod cu acest pod, planificatorul nu va putea planifica acest pod pe un alt nod, deoarece asta se poate face doar în zona de disponibilitate în care se află stocarea persistentă. Podul va rămâne blocat în starea Pending.
În comunitatea Kubernetes, este foarte popular . Acesta funcționează în cluster, suportă API-uri de la principalii furnizori de cloud, ia în considerare toate limitările și poate scalara în cazurile menționate mai sus. De asemenea, este capabil să efectueze scale-in păstrând toate limitările stabilite, economisind astfel bani (care altfel ar fi cheltuiți pe resurse neutilizate).
5. Neglijarea posibilităților IAM/RBAC
Fii atent la utilizarea utilizatorilor IAM cu secrete persistente pentru mașini și aplicații. Organizați acces temporar, utilizând roluri și conturi de serviciu (conturi de serviciu).
Adesea ne confruntăm cu situația în care cheile de acces (și secretele) sunt codificate în configurația aplicației, precum și cu neglijarea rotației secretelor, în ciuda accesului la Cloud IAM. Utilizați roluri IAM și conturi de serviciu în locul utilizatorilor, acolo unde este cazul.
Uitați de kube2iam și treceți direct la rolurile IAM pentru conturile de serviciu (așa cum este descris în Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
O singură notă. Nu este atât de complicat, nu-i așa?
În plus, nu atribuiți conturilor de serviciu și profilurilor instanțelor privilegii admin și cluster-admin, dacă nu au nevoie de ele. Acest lucru este un pic mai complicat de implementat, în special în RBAC K8s, dar merită cu siguranță efortul.
6. Nu vă bazați pe anti-afinitate automată pentru pod-uri
Imaginați-vă că aveți trei replici ale unei anumite desfășurări pe un nod. Nodul pică, iar împreună cu el, și toate replicile. O situație neplăcută, nu-i așa? Dar de ce toate replicile erau pe același nod? Nu ar trebui ca Kubernetes să asigure disponibilitate ridicată (HA)?!
Din păcate, planificatorul Kubernetes nu respectă de la sine regulile de existență separată (anti-afinitate) pentru pod-uri. Acestea trebuie specificate explicit:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
Asta e tot. Acum pod-urile vor fi planificate pe noduri diferite (această condiție este verificată doar în timpul planificării, nu în timpul execuției lor — de aici și requiredDuringSchedulingIgnoredDuringExecution).
Aici vorbim despre podAntiAffinity pe noduri diferite: topologyKey: "kubernetes.io/hostname", — și nu despre zone de disponibilitate diferite. Pentru a implementa o HA completă, va trebui să digerați această temă mai profund.
7. Ignorarea PodDisruptionBudget-urilor
Imaginați-vă că aveți o sarcină de producție în clusterul Kubernetes. Periodic, nodurile și întregul cluster trebuie actualizate (sau scoase din exploatare). PodDisruptionBudget (PDB) este un fel de acord de garanție de servicii între administratorii cluster-ului și utilizatori.
PDB permite evitarea întreruperilor în funcționarea serviciilor cauzate de lipsa nodurilor:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
În acest exemplu, tu, ca utilizator al cluster-ului, îți informezi administratorii: „Hei, am un serviciu zookeeper și, indiferent de ce faceți, aș dori ca cel puțin 2 replici ale acestui serviciu să fie întotdeauna disponibile.”
Pentru mai multe detalii, poți citi .
8. Mai mulți utilizatori sau medii într-un cluster comun
Spațiile de nume Kubernetes (namespaces) nu asigură o izolație puternică.
Există o concepție greșită comună cum că, dacă desfășori o sarcină ne-prod într-un spațiu de nume și o sarcină prod într-altul, acestea nu se vor influența reciproc… Totuși, un anumit nivel de izolație poate fi atins prin intermediul cererilor/restricțiilor de resurse, prin stabilirea de cote, configurarea priorityClass-urilor. O oarecare izolație „fizică” în planul de date este asigurată de affinities, tolerations, taints (sau nodeselectors), însă o astfel de separare este destul de dificilă de realizat.
Cei care trebuie să combine ambele tipuri de sarcini de lucru într-un singur cluster vor trebui să accepte complexitatea. Dacă nu există o astfel de nevoie și poți să creezi înca un cluster (să zicem, în cloud-ul public), atunci este mai bine să faci așa. Aceasta va permite atingerea unui nivel de izolație mult mai ridicat.
9. externalTrafficPolicy: Cluster
Foarte des observăm că tot traficul către cluster intră printr-un serviciu de tip NodePort, pentru care, în mod implicit, este setată politica externalTrafficPolicy: Cluster. Aceasta înseamnă că NodePort este deschis pe fiecare nod din cluster și poți utiliza oricare dintre acestea pentru a interacționa cu serviciul dorit (setul de pod-uri).
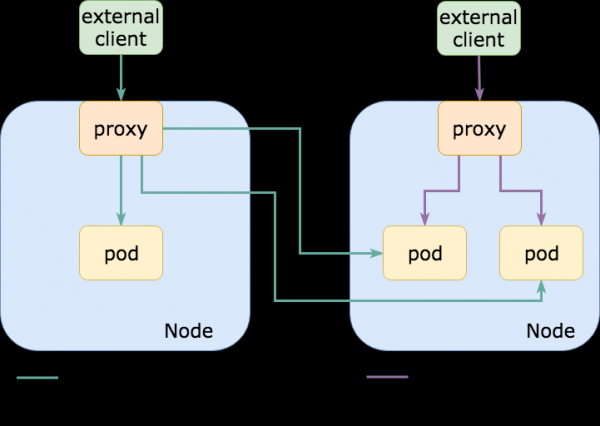
În acest context, pod-urile reale asociate cu serviciul NodePort menționat anterior sunt de obicei disponibile doar pe un anumit subset al acestor noduri. Cu alte cuvinte, dacă mă conectez la un nod care nu are pod-ul necesar, acesta va redirecționa traficul către un alt nod, adăugând o porțiune de tranzit (hop) și crescând latența (dacă nodurile se află în zone de disponibilitate/data center-uri diferite, latența poate fi destul de ridicată; de asemenea, va crește costul pentru traficul egress).
Pe de altă parte, dacă pentru un anumit serviciu Kubernetes este setată politica externalTrafficPolicy: Local, atunci NodePort este deschis doar pe acele noduri unde sunt efectiv rulante pod-urile necesare. Când se folosește un load balancer extern, care verifică starea (healthchecking) endpoint-urilor (așa cum face AWS ELB), acesta va trimite traficul doar către nodurile necesare., ceea ce va avea un impact pozitiv asupra întârzierilor, nevoilor de calcul, facturilor pentru egress (și bunul simț impune același lucru).
Este foarte probabil că deja folosiți ceva de genul traefik sau nginx-ingress-controller ca punct final NodePort (sau LoadBalancer, care folosește și el NodePort) pentru rutarea traficului HTTP ingress, iar activarea acestei opțiuni poate reduce semnificativ întârzierile pentru astfel de solicitări.
În puteți afla mai multe despre externalTrafficPolicy, avantajele și dezavantajele acesteia.
10. Nu vă legați de clustere și nu abuzați de control plane.
În trecut, serverele erau denumite cu nume proprii: , HAL9000 și Colossus… Astăzi, în locul lor, au venit identificatori generați aleatoriu. Totuși, obiceiul a rămas, iar acum numele proprii sunt date clusterelelor.
O poveste tipică (bazată pe evenimente reale): totul a început cu o dovadă de concept, așa că clusterul purta cu mândrie numele testing… Au trecut ani, și acesta ESTE ÎNCĂ folosit în producție, iar toți se tem să îl atingă.
Nu este nimic amuzant în faptul că clusterele devin animale de companie, așa că vă recomandăm să le ștergeți periodic, exersând în același timp recuperarea în caz de eșec (în acest sens vă va ajuta — nota trad.)). În plus, nu ar strica să ne ocupăm și de stratul de control (control plane).Frica de a-l atinge — nu este un semn prea bun. Etcd e mort? Oamenii, voi ați intrat într-o mare bucluc!
Pe de altă parte, nu trebuie să exagerați cu manipulările asupra lui. În timp, stratul de control poate deveni lent.Cel mai probabil, aceasta se datorează numărului mare de obiecte create fără rotație (o situație obișnuită atunci când folosiți Helm cu setările implicite, ceea ce duce la neactualizarea stării sale în configmap-uri/secrete — ca rezultat, se acumulează mii de obiecte în stratul de control) sau cu editarea constantă a obiectelor kube-api (pentru scalarea automată, pentru CI/CD, pentru monitorizare, jurnalele de evenimente, controllere etc.).
În plus, vă recomandăm să verificați acordurile SLA/SLO cu furnizorul de Kubernetes gestionat și să acordați atenție garanțiilor. Furnizorul poate garanta disponibilitatea stratului de control (sau a subcomponentelor acestuia), dar nu întârzieri p99 pentru solicitările pe care i le trimiteți. Cu alte cuvinte, se poate introduce kubectl get nodes, iar răspunsul va fi primit doar după 10 minute, iar aceasta nu va constitui o încălcare a condițiilor acordului de servicii.
11. Bonus: utilizarea etichetei latest
Aceasta este deja o clasă. În ultima vreme, ne întâlnim cu o astfel de tehnică nu atât de des, deoarece mulți, învățați din experiența amară, au încetat să folosească eticheta :latest și au început să fixeze versiunile (pin). Ura!
ECR ; recomandăm să vă familiarizați cu această caracteristică remarcabilă.
Rezumat
Nu așteptați ca totul să funcționeze dintr-o dată: Kubernetes nu este o panacee. O aplicație slabă (și, posibil, va deveni chiar mai gravă). Neatenția duce la complexitate excesivă, la un management lent și tensionat. În plus, riscați să rămâneți fără o strategie de recuperare în caz de dezastru. Nu contați că Kubernetes "din cutie" va asigura izolare și disponibilitate ridicată. Petreceți puțin timp pentru a face aplicația dvs. cu adevărat cloud native.
Puteți întâlni experiențele nereușite ale diferitelor echipe în de la Henning Jacobs.
Cei care doresc să completeze lista de erori prezentată în acest articol ne pot contacta pe Twitter (, ).
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «» (recenzie și videoclip al prezentării);
- «».
Sursa: habr.com
