

În pragul începerii cursului v-am pregătit traducerea unei alte resurse utile.
Codificarea Huffman este un algoritm de compresie a datelor care formulează ideea centrală a comprimării fișierelor. În acest articol, vom discuta despre codificarea cu lungime fixă și variabilă, coduri univoc decodabile, reguli de prefix și construirea arborelui Huffman.
Știm că fiecare simbol este stocat sub forma unei secvențe de 0 și 1 și ocupă 8 biți. Aceasta se numește codificare de lungime fixă, deoarece fiecare simbol folosește aceeași cantitate fixă de biți pentru stocare.
Să presupunem că avem un text. Cum putem reduce cantitatea de spațiu necesară pentru a stoca un simbol?
Ideea principală constă în codificarea de lungime variabilă. Putem utiliza faptul că unele simboluri din text apar mai des decât altele (), pentru a dezvolta un algoritm care va reprezenta aceeași secvență de simboluri cu un număr mai mic de biți. În codificarea de lungime variabilă, atribuim simbolurilor un număr variabil de biți în funcție de frecvența apariției acestora în textul respectiv. În cele din urmă, unele simboluri pot ocupa doar 1 bit, iar altele 2, 3 sau mai mult. Problema cu codificarea de lungime variabilă constă doar în decodificarea ulterioară a secvenței.
Cum putem decodifica unică secvența de biți, știind-o?
Să luăm în considerare șirul „aabacdab”. Acesta conține 8 simboluri, iar în cazul codificării de lungime fixă, pentru a-l stoca, ar fi necesari 64 biți. Observăm că frecvența simbolurilor „a”, „b”, „c” și „d” este de 4, 2, 1, 1 respectiv. Să încercăm să-l reprezentăm „aabacdab” cu un număr mai mic de biți, folosind faptul că „a” apare mai frecvent decât „b”, iar „b” apare mai frecvent decât „c” și „d”. Încercăm să codificăm „a” cu un bit, egal cu 0, „b” vom atribui codul de două biți 11, iar cu ajutorul a trei biți 100 și 011 vom codifica „c” și „d”.
În final, vom obține:
a
0
b
11
c
100
d
011
Astfel, șirul „aabacdab” îl vom codifica ca 00110100011011 (0|0|11|0|100|011|0|11), folosind codurile prezentate mai sus. Totuși, problema principală va fi decodificarea. Când vom încerca să decodificăm șirul 00110100011011, vom obține un rezultat ambiguu, deoarece acesta poate fi reprezentat ca:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
etc.
Pentru a evita această ambiguitate, trebuie să ne asigurăm că codificarea noastră respectă un concept precum regula prefixului, care implică faptul că codurile pot fi decodificate într-un singur mod unic. Regula prefixului asigură că niciun cod nu va fi prefixul altuia. Prin cod, ne referim la biții utilizați pentru a reprezenta un simbol specific. În exemplul de mai sus 0 – acesta este un prefix 011, ceea ce încalcă regula prefixului. Așadar, dacă codurile noastre respectă regula prefixului, se poate efectua decodificarea unică (și invers).
Să revizuim exemplul de mai sus. De data aceasta, vom aloca pentru simboluri „a”, „b”, „c” și „d” coduri care respectă regula prefixului.
a
0
b
10
c
110
d
111
Cu o astfel de codificare, șirul „aabacdab” va fi codificat ca 00100100011010 (0|0|10|0|100|011|0|10). Iar acum 00100100011010 vom putea decodifica univoc și ne vom întoarce la șirul nostru inițial „aabacdab”.
Codificarea Huffman
Acum că ne-am familiarizat cu codificarea de lungime variabilă și regula prefixului, să discutăm despre codificarea Huffman.
Metoda se bazează pe crearea arborilor binari. În acesta, un nod poate fi fie final, fie intern. Inițial, toate nodurile sunt considerate frunze (finale), care reprezintă simbolul în sine și greutatea sa (deci frecvența de apariție). Nodurile interne conțin greutatea simbolului și fac referire la două noduri moștenitoare. După un consens general, bitul "0" reprezintă urmarea pe ramura stângă, iar "1" – pe ramura dreaptă. Într-un arbore complet N frunze și N-1 noduri interne. Se recomandă ca, atunci când se construiește arborele Huffman, simbolurile neutilizate să fie eliminate pentru a obține coduri de lungime optimă.
Vom folosi o coadă de prioritate pentru a construi arborele Huffman, în care nodului cu cea mai mică frecvență îi va fi acordat cel mai mare prioritate. Pașii pentru construirea acestuia sunt descriși mai jos:
- Creați un nod-frunză pentru fiecare simbol și adăugați-le în coada cu prioritate.
- Cât timp în coadă există mai mult de un frunză, faceți următoarele:
- Eliminați două noduri cu cel mai înalt prioritate (cea mai mică frecvență) din coadă;
- Creați un nou nod intern, unde aceste două noduri vor fi moștenitoare, iar frecvența de apariție va fi suma frecvențelor acestor două noduri.
- Adăugați noul nod în coada de prioritate.
- Singurul nod rămas va fi rădăcina, iar construirea copacului se va încheia aici.
Să presupunem că avem un text care constă doar din caractere „a”, „b”, „c”, „d” și „e”, iar frecvențele apariției lor sunt 15, 7, 6, 6 și 5 respectiv. Mai jos sunt ilustrațiile care reflectă pașii algoritmului.
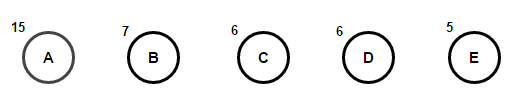
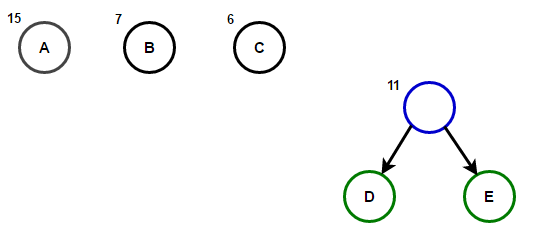
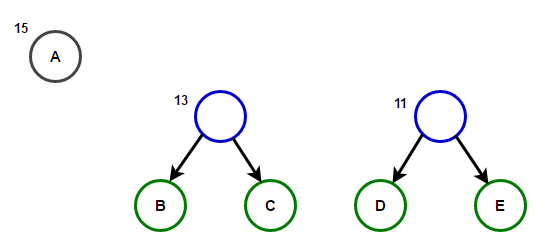
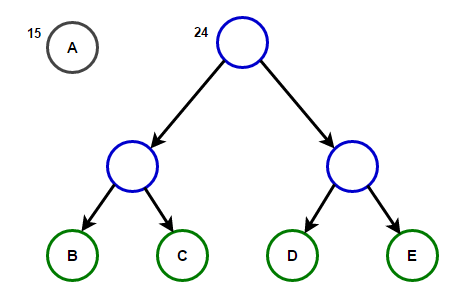
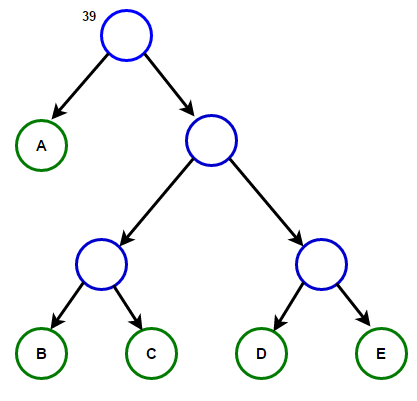
Drumul de la rădăcină la orice nod final va stoca codul optim de prefix (cunoscut și sub numele de cod Huffman), corespunzător caracterului asociat cu acest nod final.
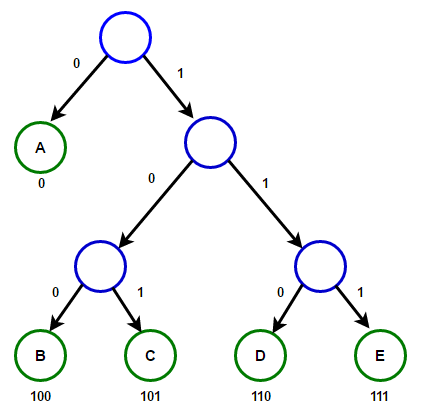
Copacul Huffman
Mai jos veți găsi implementarea algoritmului de compresie Huffman în limbajele C++ și Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Un nod de arbore
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// parcurge arborele Huffman și stochează codurile Huffman
// într-o hartă.
public static void encode(Node root, String str,
Map<Character, String> huffmanCode)
{
if (root == null)
return;
// nod de frunză găsit
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// parcurge arborele Huffman și decodifică șirul codificat
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// nod de frunză găsit
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Construiește arborele Huffman și codurile Huffman și decodifică textul de intrare dat
public static void buildHuffmanTree(String text)
{
// numără frecvența apariției fiecărui caracter
// și o stochează într-o hartă
Map<Character, Integer> freq = new HashMap<>();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Crează o coadă de prioritate pentru a stoca nodurile active ale arborelui Huffman
// Observați că elementul de cea mai mare prioritate are cea mai mică frecvență
PriorityQueue<Node> pq = new PriorityQueue<>(
(l, r) -> l.freq - r.freq);
// Crează un nod de frunză pentru fiecare caracter și îl adaugă
// în coada de prioritate.
for (Map.Entry<Character, Integer> entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// continuă până când există mai mult de un nod în coadă
while (pq.size() != 1)
{
// Elimină cele două noduri cu cea mai mare prioritate
// (cea mai mică frecvență) din coadă
Node left = pq.poll();
Node right = pq.poll();
// Crează un nou nod intern cu aceste două noduri ca copii
// și cu frecvența egală cu suma frecvențelor celor două noduri.
// Adăugați noul nod în coada de prioritate.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root stochează pointerul către rădăcina arborelui Huffman
Node root = pq.peek();
// parcurge arborele Huffman și stochează codurile Huffman într-o hartă
Map<Character, String> huffmanCode = new HashMap<>();
encode(root, "", huffmanCode);
// afișează codurile Huffman
System.out.println("Codurile Huffman sunt :n");
for (Map.Entry<Character, String> entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("nȘirul original a fost :n" + text);
// afișează șirul codificat
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("nȘirul codificat este :n" + sb);
// parcurge din nou arborele Huffman și de această dată
// decodifică șirul codificat
int index = -1;
System.out.println("nȘirul decodat este: n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Codificarea Huffman este un algoritm de compresie a datelor.";
buildHuffmanTree(text);
}
}Notă: memoria folosită de șirul de intrare este de 47 * 8 = 376 biți, iar șirul codificat ocupă doar 194 de biți, adică datele sunt comprimate cu aproximativ 48%. În programul C++ de mai sus, folosim clasa string pentru a stoca șirul codificat, pentru a face programul mai ușor de citit.
Deoarece structurile eficiente de date pentru cozi de prioritate necesită timp O(log(N)) pentru inserare, timpul O(log(N)) iar într-un arbore binar complet cu N frunze sunt 2N-1 noduri, iar arborele Huffman este un arbore binar complet, algoritmul funcționează în O(Nlog(N)) timp, unde N – numărul de simboluri.
Surse:
Sursa: habr.com
