

Salut, Habr! Astăzi vom construi un sistem care va procesa fluxuri de mesaje Apache Kafka cu ajutorul Spark Streaming și va salva rezultatul prelucrării într-o bază de date cloud AWS RDS.
Să presupunem că o anumită organizație de credit ne dă sarcina de a procesa tranzacțiile de intrare „în timp real” pentru toate filialele sale. Acest lucru poate fi realizat cu scopul de a calcula rapid poziția valutară deschisă pentru trezorerie, limitele sau rezultatul financiar al tranzacțiilor etc.
Cum să implementăm acest caz fără a aplica magie și vrăji - citiți mai departe! Haideți să începem!
Introducere
Desigur, procesarea unui volum mare de date în timp real oferă oportunități largi pentru utilizare în sistemele moderne. Una dintre cele mai populare combinații pentru aceasta este tandemul Apache Kafka și Spark Streaming, unde Kafka creează un flux de pachete de mesaje de intrare, iar Spark Streaming procesează aceste pachete la intervale de timp definite.
Pentru a îmbunătăți reziliența aplicației, vom folosi puncte de control - checkpoint-uri. Prin acest mecanism, atunci când modulul Spark Streaming trebuie să recupereze datele pierdute, va trebui să revină doar la ultimul punct de control și să continue calculele de la acesta.
Arhitectura sistemului dezvoltat
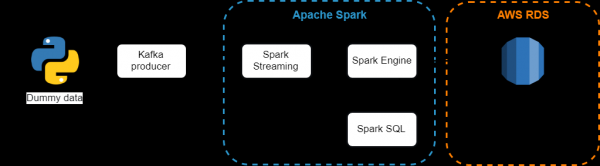
Componentele utilizate:
- — este un sistem distribuit de schimb de mesaje cu publicare și abonare. Se potrivește atât pentru consumul autonom, cât și pentru consumul online al mesajelor. Pentru a preveni pierderea datelor, mesajele Kafka sunt stocate pe disc și replicate în cadrul cluster-ului. Sistemul Kafka este construit pe baza serviciului de sincronizare ZooKeeper;
- — componenta Spark pentru procesarea fluxurilor de date. Modulul Spark Streaming este construit pe baza arhitecturii „micro-batch”, când un flux de date este interpretat ca o succesiune continuă de mici pachete de date. Spark Streaming primește date din diferite surse și le grupează în pachete mici. Pachetele noi sunt create la intervale regulate de timp. La începutul fiecărui interval de timp, se creează un nou pachet, iar toate datele primite în cursul acestui interval sunt incluse în acel pachet. La sfârșitul intervalului, creșterea pachetului se oprește. Dimensiunea intervalului este definită de un parametru numit interval de pachetare.
- — combină procesarea relațională cu programarea funcțională în Spark. Prin date structurate se înțeleg datele care au o schemă, adică un set unic de câmpuri pentru toate înregistrările. Spark SQL suportă introducerea din mai multe surse de date structurate și, datorită prezenței informațiilor despre schemă, acesta poate extrage eficient doar câmpurile necesare din înregistrări, oferind de asemenea interfețe API pentru DataFrame.
- — este o bază de date relațională cloud relativ ieftină, un serviciu web care simplifică configurarea, operarea și scalarea, fiind administrată direct de Amazon.
Instalarea și lansarea serverului Kafka
Înainte de a utiliza Kafka, trebuie să ne asigurăm că avem Java disponibil, deoarece pentru funcționare se utilizează JVM:
sudo apt-get update
sudo apt-get install default-jre
java -version
Hai să creăm un nou utilizator pentru a lucra cu Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Apoi descărcăm pachetul de la site-ul oficial Apache Kafka:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Dezarhivăm arhiva descărcată:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
Următorul pas este opțional. Datorită faptului că setările implicite nu permit utilizarea completă a tuturor funcționalităților Apache Kafka. De exemplu, pentru a șterge un subiect, o categorie, un grup pe care pot fi publicate mesaje. Pentru a modifica acest lucru, vom edita fișierul de configurare:
vim ~/kafka/config/server.propertiesAdăugați la sfârșitul fișierului următoarele:
delete.topic.enable = trueÎnainte de a lansa serverul Kafka, trebuie să pornim serverul ZooKeeper, vom utiliza un script auxiliar care vine împreună cu distribuția Kafka:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
După ce ZooKeeper a pornit cu succes, în terminalul separat lansăm serverul Kafka:
bin/kafka-server-start.sh config/server.propertiesSă creăm un nou subiect numit Transaction:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionSă ne asigurăm că subiectul cu numărul corect de partiții și replicare a fost creat:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 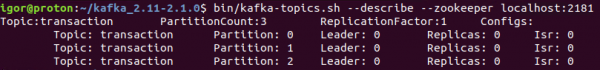
Să omitem momentele de testare a producătorului și consumatorului pentru noul subiect. Mai multe detalii despre cum se pot testa trimiterea și primirea mesajelor sunt scrise în documentația oficială — . Acum trecem la scrierea unui producător în Python folosind API-ul KafkaProducer.
Scrierea unui producător
Producătorul va genera date aleatorii — câte 100 de mesaje în fiecare secundă. Prin date aleatorii, ne referim la un dicționar format din trei câmpuri:
- Filială — denumirea punctului de vânzare al instituției financiare;
- Currency — moneda tranzacției;
- Amount — suma tranzacției. Suma va fi un număr pozitiv dacă este o achiziție de valută de către Bancă și negativ dacă este o vânzare.
Codul pentru producător arată astfel:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Apoi, folosind metoda send, trimitem mesajul pe server, în subiectul dorit, în format JSON:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Mesajul a fost trimis către un subiect:
            {}, partiție: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Se pare că a apărut o eroare: {}'.format(e))

finally:
    producer.flush()
La lansarea scriptului, primim următoarele mesaje în terminal:
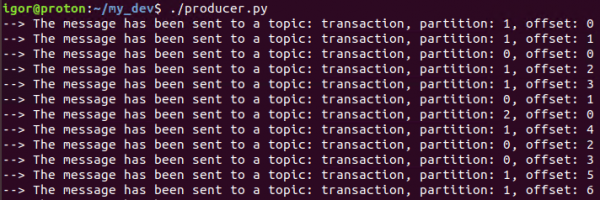
Acest lucru înseamnă că totul funcționează așa cum ne-am dorit — producătorul generează și trimite mesaje în subiectul dorit.
Pasul următor va fi instalarea Spark și procesarea acestui flux de mesaje.
Instalarea Apache Spark
Apache Spark este o platformă de calcul distribuită universală și performantă.
În performanță, Spark depășește implementările populare ale modelului MapReduce, oferind în același timp suport pentru un spectru mai larg de tipuri de calcul, inclusiv interogări interactive și procesare în flux. Viteza joacă un rol crucial în procesarea volumelor mari de date, deoarece doar viteza permite operarea în mod interactiv, fără a aștepta minute sau ore. Unul dintre cele mai importante avantaje ale Spark, care asigură această viteză ridicată, este capacitatea de a efectua calcule în memorie.
Acest cadru este scris în Scala, așa că trebuie să o instalăm mai întâi:
sudo apt-get install scalaDescărcăm distribuția Spark de pe site-ul oficial:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Dezarhivăm arhiva:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkAdăugăm calea către Spark în fișierul bash:
vim ~/bashrcIntroducem în editor următoarele linii:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Executăm comanda de mai jos după ce am făcut modificările în bashrc:
source ~/bashrcDezvoltarea AWS PostgreSQL
Rămâne să dezvoltăm baza de date în care vom încărca informațiile procesate din fluxuri. Pentru aceasta, vom folosi serviciul AWS RDS.
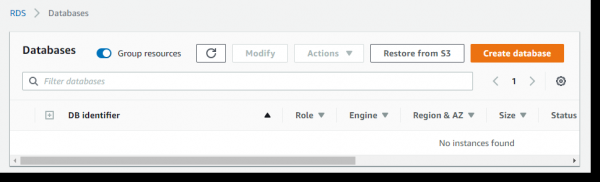
Accesăm consola AWS —> AWS RDS —> Databases —> Create database:
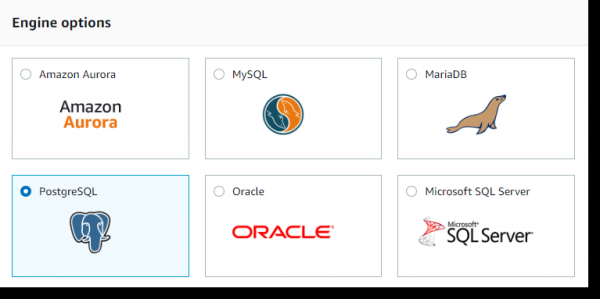
Alegem PostgreSQL și dăm clic pe butonul Next:
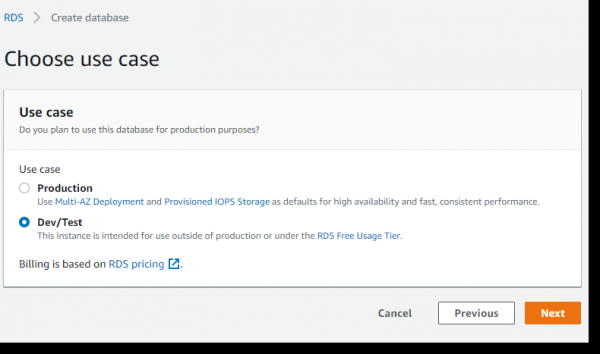
Deoarece acest exemplu este examinat exclusiv în scopuri educaționale, vom utiliza un server gratuit "minimal" (Free Tier):
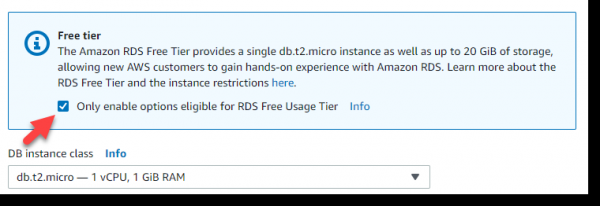
Apoi, bifăm caseta din blocul Free Tier, iar după aceasta ne va fi oferit automat un instanț t2.micro — deși slab, este gratuit și se potrivește perfect pentru sarcina noastră:
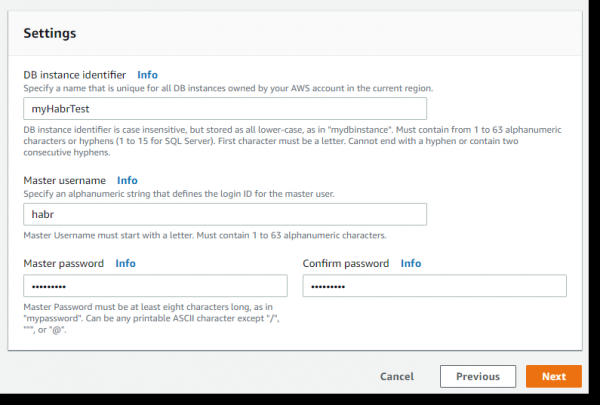
Următoarele sunt foarte importante: numele instanței Bazei de Date, numele utilizatorului principal și parola acestuia. Vom numi instanța: myHabrTest, utilizatorul principal: habr, parola: habr12345 și dăm clic pe butonul Next:
Pe pagina următoare se află parametrii care răspund de accesibilitatea serverului nostru de baze de date din exterior (Public accessibility) și accesibilitatea porturilor:
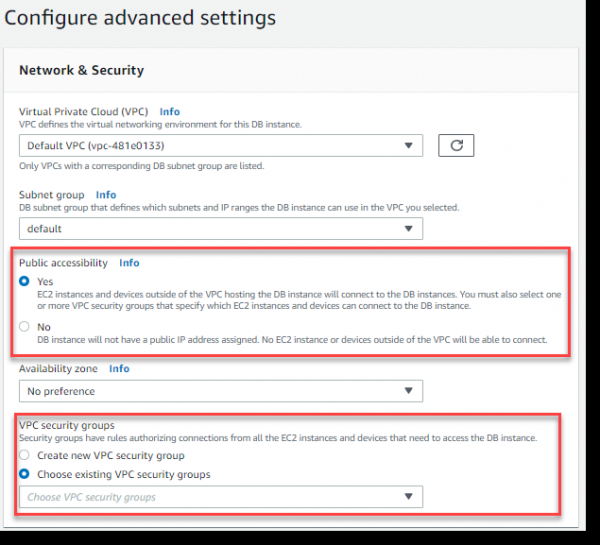
Să creăm o nouă setare pentru grupul de securitate VPC, care va permite accesarea serverului nostru de baze de date din exterior prin portul 5432 (PostgreSQL).
Trecem într-o fereastră separată a browserului la consola AWS în secțiunea VPC Dashboard —> Security Groups —> Create security group:
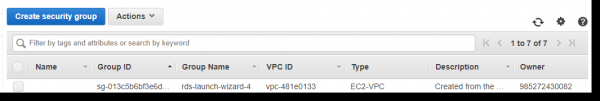
Setăm un nume pentru grupul de securitate — PostgreSQL, descrierea, specificăm cu care VPC acest grup ar trebui să fie asociat și dăm clic pe butonul Create:

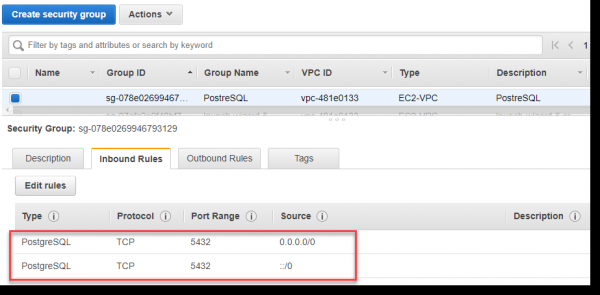
Completăm pentru grupul nou creat regulile Inbound pentru portul 5432, așa cum este prezentat în imaginea de mai jos. Nu este necesar să specificați manual portul, ci să selectați PostgreSQL din lista derulantă Type.
Strict vorbind, valoarea ::/0 semnifică accesibilitatea traficului de intrare pentru server din întreaga lume, ceea ce, canonically, nu este complet corect, dar pentru exemplu, ne permitem să folosim această abordare:
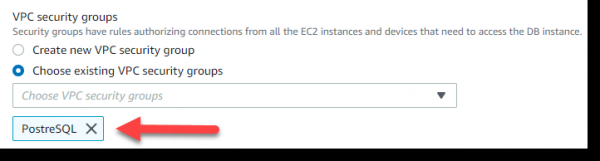
Ne întoarcem la pagina browserului, unde avem deschis „Configure advanced settings” și alegem în secțiunea VPC security groups —> Choose existing VPC security groups —> PostgreSQL:
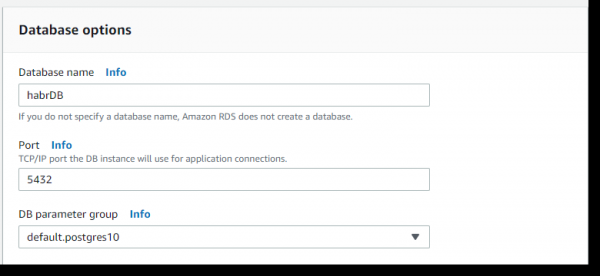
Apoi, în secțiunea Database options —> Database name —> setăm numele — habrDB.
Ceilalți parametri, cu excepția poate a dezactivării backup-ului (backup retention period — 0 days), monitorizării și Performance Insights, pot fi lăsați pe setările implicite. Dăm clic pe butonul Create database:
Handler de fluxuri
Ultima etapă va fi dezvoltarea unei lucrări Spark care va procesa datele noi primite de la Kafka la fiecare două secunde și va introduce rezultatul în baza de date.
Așa cum s-a menționat mai sus, punctele de control (checkpoints) sunt principalul mecanism în Spark Streaming, care trebuie să fie configurat pentru a asigura toleranța la defecte. Vom utiliza punctele de control și, în caz de cădere a procedurii, modulul Spark Streaming pentru recuperarea datelor pierdute va trebui doar să revină la ultimul punct de control și să continue calculul de la acesta.
Punctul de control poate fi activat prin setarea unui director într-un sistem de fișiere tolerat la defecte și de încredere (de exemplu, HDFS, S3 etc.), în care va fi salvată informația despre punctul de control. Acest lucru se face, de exemplu, prin:
streamingContext.checkpoint(checkpointDirectory)În exemplul nostru, vom folosi următoarea abordare, și anume, dacă checkpointDirectory există, contextul va fi recreat din datele punctului de control. Dacă directorul nu există (adică, este executat pentru prima dată), se apelează funcția functionToCreateContext pentru a crea un nou context și a configura DStreams:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Creăm un obiect DirectStream cu scopul de a ne conecta la topicul „transaction” folosind metoda createDirectStream a bibliotecii KafkaUtils:
din pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Analizăm datele de intrare în format JSON:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Folosind Spark SQL, efectuam un grup simplu și afișăm rezultatul în consolă:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Obținem textul interogării și îl executăm prin Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Apoi, salvăm datele agregate obținute într-un tabel în AWS RDS. Pentru a salva rezultatele agregării într-un tabel de baze de date, vom folosi metoda write a obiectului DataFrame:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
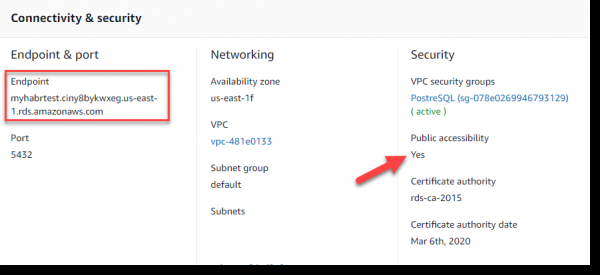
Câteva cuvinte despre configurarea conexiunii cu AWS RDS. Utilizatorul și parola au fost create la pasul „Dezvoltare AWS PostgreSQL”. Ca url pentru serverul de baze de date, ar trebui să folosiți Endpoint-ul, care apare în secțiunea Connectivity & security:
Pentru a asigura o legătură corectă între Spark și Kafka, trebuie să rulați job-ul prin spark-submit, utilizând artefactul spark-streaming-kafka-0-8_2.11. De asemenea, vom aplica și artefactul pentru interacțiunea cu baza de date PostgreSQL, pe care le vom transmite prin —packages.
Pentru flexibilitatea scriptului, vom extrage ca parametri de intrare și denumirea serverului de mesaje și topicul din care dorim să primim date.
Așadar, a venit timpul să rulăm și să verificăm funcționarea sistemului:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
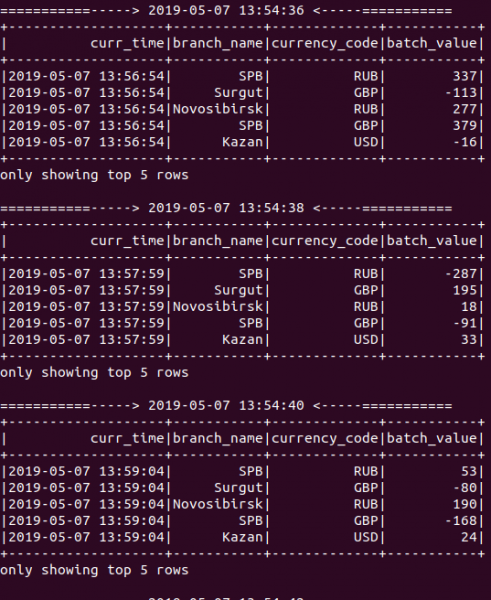
Totul a funcționat! Așa cum se vede în imaginea de mai jos — în timpul funcționării aplicației, noile rezultate de agregare sunt afișate la fiecare 2 secunde, deoarece am setat intervalul de grupare la 2 secunde, atunci când am creat obiectul StreamingContext:
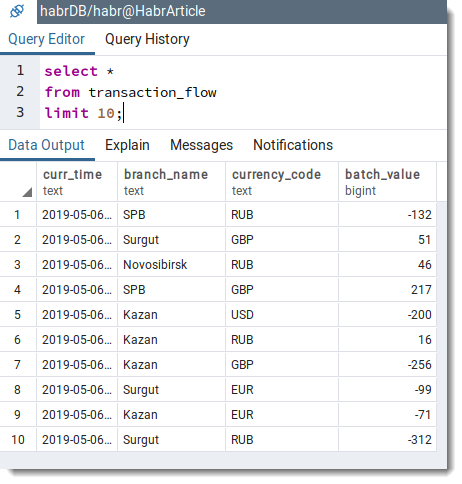
Apoi, facem o interogare simplă pe baza de date pentru a verifica existența înregistrărilor în tabelul transaction_flow:
Concluzie
În acest articol a fost prezentat un exemplu de procesare a informațiilor în flux utilizând Spark Streaming împreună cu Apache Kafka și PostgreSQL. Odată cu creșterea volumului de date din diverse surse, valoarea practică a Spark Streaming pentru crearea de aplicații de streaming și aplicații care funcționează în timp real este greu de supraevaluat.
Codul sursă complet îl puteți găsi în repositoarele mele pe .
Sunt bucuros să discut despre acest articol, aștept comentariile dumneavoastră și sper la o critică constructivă din partea tuturor cititorilor interesați.
Vă doresc mult succes!
Ps. Inițial, s-a planificat utilizarea unei baze de date PostgreSQL locale, dar având în vedere dragostea mea pentru AWS, am decis să mut baza de date în cloud. În următorul articol pe această temă, voi arăta cum să implementăm în întregime sistemul descris mai sus în AWS folosind AWS Kinesis și AWS EMR. Rămâneți pe fază!
Sursa: habr.com
