

de la St-Pete
Salut tuturor! Eu sunt Mons Anderson, arhitectul platformei , voi povesti cum am construit stocarea noastră S3, cum funcționează, ce soluții s-au dovedit a fi reușite și ce ar fi trebuit să schimbăm dacă am începe un astfel de proiect de la zero acum.
Articolul este pregătit pe baza unei prezentări la de la Mail.ru Cloud Solutions & Tarantool. În acest articol vom discuta:
- cum a fost organizat stocarea Mail.ru, pe care am construit stocarea S3;
- ce am adăugat pentru a crea Mail.ru Cloud Storage;
- cum funcționează modelul de stocare a obiectelor și ce pași au fost făcuți pentru a ajunge în producție;
- despre îmbunătățirile sistemului de producție: failover și scalare;
- cum am implementat sharding și resharding;
- și, de asemenea, despre lucrul cu certificatele SSL.
Dacă nu doriți să citiți, puteți .
Cum a fost organizat stocarea Mail.ru, pe care am construit stocarea S3
Dezvoltarea S3-ului nostru a început pe stocarea Cloud Mail.ru, deci este important să discutăm mai întâi cum este organizată și ce poate face.
Stocarea cloud Mail.ru este formată din servere cu discuri. În medie, un server de stocare modern are 36 de discuri de 12–14 terabytes. Anterior, discurile erau mai mici, dar în trei ani, capacitățile discurilor au crescut și astăzi avem aproape o jumătate de petabyte de date brute.
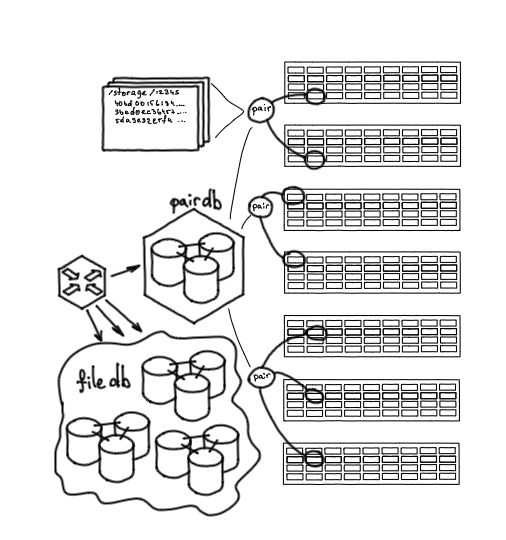
Discurile din diferite servere de stocare sunt unite în așa-numitele „pere” (pair). O pere este un unitate unică de stocare a fișierelor. Practic, este un disc montat într-o anumită partiție pe un anumit drum, unde pot fi stocate fișiere identificate prin hash-uri.
Pere este un nume istoric, a rămas până în zilele noastre, deși acum nu sunt obligate să fie doar două discuri. Pot exista trei discuri, iar de asemenea pot exista stocări hibride, cum ar fi 3/2.
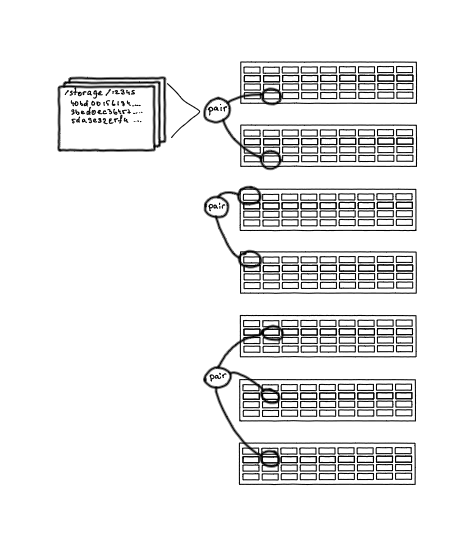
Pere (pair) – unități de stocare a obiectelor
Toate perele sunt stocate în PairDB – o aplicație bazată pe Tarantool. Toate bazele din stocarea noastră, începând cu cele mai vechi, sunt Tarantool, nu folosim alte baze.
PairDB stochează toate perele, stările lor, spațiul liber, posibilitățile de rezervă, ultimele erori. De asemenea, poate să se conecteze la pere, să actualizeze starea lor, să verifice dacă funcționează sau nu. Deci, PairDB este o imagine generală a stării tuturor discurilor sistemului nostru.
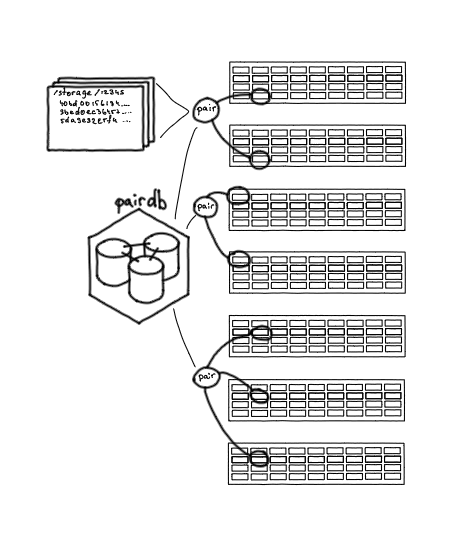
Pair DB: baza de date cu starea perechilor
Pe pereți sunt stocate fișiere, iar pentru a ști pe care pereți se află fiecare fișier, este nevoie de o altă bază de date — FileDB. Aceasta păstrează mapping-ul, definiția corespondenței: fișierul respectiv se află pe pereții respectivi, precum și un număr mic de atribute necesare.
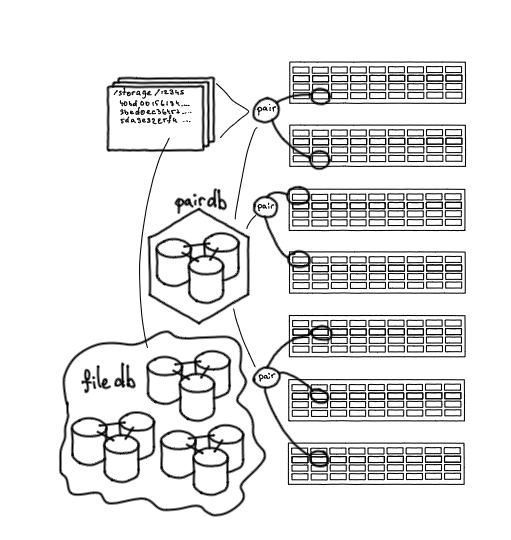 File DB: locul unde este stocat fișierul
Un alt element important — serviciul Nylon, un router pentru lucrul cu bazele de date. Acesta este un punct de acces unic, care permite lucrul printr-o interfață unificată atât cu PairDB, cât și cu FileDB. Este un serviciu stateless, efectuează balansarea cererilor, înțelege pe ce shard trebuie să meargă FileDB, știe care pereți sunt activi și care nu.
Nylon: router pentru lucrul cu bazele de date
De asemenea, trebuie să plasăm conținut în depozit într-un anumit mod. Pentru aceasta, există serviciul — Streamer. Acesta oferă două metode HTTP: metoda PUT, pentru a încărca conținut în depozit, și metoda GET, pentru a-l recupera. HTTP este un protocol destul de popular și convenabil pentru transferul de date.
Atunci când ne adresăm lui Streamer, acesta, prin Nylon, face apel la PairDB, stabilește pe ce pereți poate fi încărcat fișierul, după care transmite datele prin WebDAV pe acești pereți.
În esență, orice server de stocare este un nginx plus discuri montate la căile specificate. Putem încărca fișiere în depozit din Streamer, le putem șterge, redenumi sau verifica integritatea. Aceasta este o interfață convenabilă pentru interacțiunea la nivel de bază cu depozitul.
Streamer: punct de acces în depozit
Ce am adăugat pentru a crea un depozit S3
Așadar, am examinat structura de bază a depozitului în momentul în care ne-am propus să lansăm depozitul S3. Cu ajutorul metodei PUT, am putea plasa acolo conținut arbitrar și obține ca identificator al acestor date un hash. Cu acest identificator, ulterior, puteam veni și recupera fișierul inițial. Dar acest lucru nu este suficient pentru implementarea S3. În protocolul S3, pe lângă stocarea efectivă a obiectelor, există și:
- stocarea metadatelor — proprietăți suplimentare ale obiectelor;
- organizarea accesului la obiecte prin intermediul HTTP;
- gruparea obiectelor în colecții — bucăți;
- Endpoint HTTP-S3. S3 organizează datele în structuri specifice — bucăți, fiecare dintre acestea oferind un punct de acces pentru stocarea fișierelor.
Pentru implementarea acestei logici a fost necesar un serviciu separatat. De asemenea, am dorit să preconizăm de la început arhitectura pentru o creștere ulterioară a serviciului cu scalabilitate liniară.
Primele componente
Demonul care implementează S3 API. Acesta este standardul S3 API Amazon, care suportă lucrul cu XML pentru metadate și permite transferul direct de conținut. Nu a fost nevoie să inventăm nimic, totul este descris și documentat.
De asemenea, înaintea serviciului am plasat Nginx. L-am folosit pentru terminarea SSL, balansarea încărcării, precum și pentru anumite logici în Lua (metrice, logare și tracing).
Pentru stocarea metadatelor S3 am ales de asemenea Tarantool. În prima versiune, demonul S3 accesa această bază pentru metadate, în timp ce conținutul era stocat într-un mare depozit prin intermediul Streamer.
Nginx + S3 API + metadate
Modelul obiectelor de stocare
Să vedem cum funcționează S3. Utilizatorul poate crea un bucket - o colecție de obiecte. Bucket-ul este adresat prin numele gazdei și reprezintă un subdomeniu al serviciului. În cadrul bucket-ului, utilizatorul poate crea obiecte. Identificatorul obiectului va fi URL-ul. Conținutul obiectului este un blob, un array de date binare pe care le vom păstra în depozit. De asemenea, obiectul are atribute: numele - acel URL, ACL (lista de control al accesului), alte atribute suplimentare sau arbitrare - toate acestea sunt păstrate în metadate.
Schema normalizată a acestor date poate arăta astfel: există proiecte care dețin bucket-uri, care dețin obiecte, iar obiectele pot fi compuse. Deoarece unul dintre moduri pentru a încărca un obiect este pe părți, există două tabele auxiliare pentru încărcare: uploads și chunks. De asemenea, proiectele au acreditive pentru acces și facturare.
Schema de date
Deoarece am realizat un serviciu B2B cu acces pe bază de plată, era necesară o schemă de facturare în acest sistem.
Serviciul de facturare l-am implementat de asemenea pe Tarantool.
Îmbunătățiri ale stocării S3: pași către producție
Am realizat deja un model funcțional care poate fi utilizat: obiectele și metadatele erau stocate, dar pentru a ieși în producție lipseau câteva aspecte.
În primul rând, avem un sistem de limitare a ratei. Dacă pornim serviciul fără acesta, la o încărcare maximă, am putea suprasolicita imprevizibil o parte a sistemului. Limitarea ratei ar trebui să funcționeze astfel: orice solicitare S3 ajunge pe un anumit gazduitor, acest gazduitor este identificatorul bucket-ului, iar bucket-ul aparține unui anumit client. Trebuie să definim o funcție legată de bucket care să permită calcularea limitării ratei.
În plus, sistemul de limitare a ratei trebuie să fie destul de performant pentru a face față încărcării care vine pe S3.
Aici am folosit din nou Tarantool. Limitările ratei constituie un cluster format din 21 de instanțe, instanțele sunt grupate, distribuite pe trei noduri fizice și unite într-un mare cluster topologic. Schimbările de configurare sunt propagate automat prin acesta: se stabilesc limitările ratei, valorile implicite și configurația. Fiecare bucket este servit de strict o singură instanță. Atunci când o solicitare ajunge la un anumit bucket, se calculează instanța responsabilă pentru acel bucket. În cadrul acestui nod se efectuează calcularea ratei curente de solicitări folosind un algoritm similar cu Token Bucket. Ulterior, sistemul de limitare a ratei, pe baza indicatorilor curenți de încărcare și a proprietăților stabilite pentru bucketul specific, decide dacă solicitarea poate fi executată sau nu. Verificarea limitelor se efectuează în cea mai timpurie etapă a executării solicitării S3, protejând celelalte componente ale sistemului de o suprasolicitare excesivă.
De asemenea, sub încărcare este destul de dificil să ne descurcăm fără cache. În S3 se presupune o accesare repetată a acelorași obiecte, adică acesta este un depozit fierbinte. În condiții normale, accesul la un singur fișier este gestionat de întreaga este: Streamer, FileDB, PairDB, Storage. Dar la accesarea repetată a unui fișier, optimizăm accesul la acest conținut printr-un cache local.
Cache-ul este multi-strat și este implementat prin nginx, unități de SSD și RAM. Aici nu am folosit Tarantool, deoarece este mai convenabil să livrăm obiectele din sistemul de fișiere, astfel putând realiza o stratificare a cache-ului. În plus, avem obiecte mari cu o dimensiune maximă de 32 de gigaocteți, iar în Tarantool se pot cache-ui doar obiecte mici.
Acesta este primul sistem cu care am început, având o capacitate calculată, suficientă pentru a explora și a înțelege produsul, asigurându-ne că funcționează.
Îmbunătățiri pentru sistemul de producție: failover și scalabilitate
Sistemul era deja în producție, însă la început am omis unele aspecte - era necesară adăugarea failover-ului și scalabilității.
Demonul nostru S3 prelua metadate prin protocolul Tarantool. Am înlocuit baza originală cu Tarantool, care funcționa ca un router proxy pentru cererile de metadate. Din perspectiva aplicației care implementa API-ul, nimic nu s-a schimbat - aceasta a continuat să acceseze baza de date prin protocolul Tarantool, dar router-ul a putut asigura failover activ. Asta înseamnă că am putut verifica disponibilitatea nodului, să avem pauze în timpul comutărilor și defecțiunilor, și așa mai departe. În plus, aplicația însăși nu a fost modificată.
Mai multe informații despre cum am implementat sharding-ul
Următoarea problemă care a trebuit abordată a fost sharding-ul. Sistemul creștea, numărul de obiecte creștea și a trebuit să asigurăm capacități pentru o expansiune ulterioară.
Să ne întoarcem la schema de date: există proiecte, bucket-uri, credențiale și facturare. Acestea sunt obiecte care, cu o mare probabilitate, în viitorul apropiat nu vor depăși limitele unui singur instanț în ceea ce privește dimensiunea sau cererile. Asta înseamnă că nu are sens să le shard-uim, așa că le-am mutat într-o instanță separată, care va rămâne nesharduită. Aceasta permite o gestionare mai consistentă a proiectelor și bucket-urilor, deoarece există un singur punct nesharduit.
De asemenea, în schemă există obiecte care cresc linear - la început erau sute de mii, acum numărul lor se măsoară în miliarde. Aceste obiecte, împreună cu părțile lor, au trebuit mutate într-un cluster sharded.
Am împărțit schema, dar obiectele trebuie să interacționeze cu bucket-urile: fiecare obiect aparține întotdeauna unui bucket specific, plus că pe bucket există ACL. De aceea, pentru fiecare shard cu obiecte păstrăm o copie de rezervă a fiecărui bucket. În plus, în timpul modificării obiectelor și executării cererilor, trebuie să calculăm volumele pentru facturare, așa că fiecare shard are contori pentru facturare.
De asemenea, am adăugat câteva tabele și componente suplimentare:
- coșul de reciclare, pentru distrugerea vechilor proiecte care sunt șterse sau suspendate;
- o coadă pentru sarcini de fundal, adică stocarea principală poate executa sarcini de fundal care trebuie realizate în cluster;
- suport pentru lifecycle — un mecanism care permite gestionarea obiectelor și administrarea ciclului lor de viață.
Fiindcă o parte din date le-am mutat pe shard-uri, a fost necesară o proxy de shard-ing. Ar fi fost posibil să reutilizăm router-ul pentru acest rol, însă o proxy de shard-ing separată, care se ocupă doar de shard-ing-ul datelor, permite router-ului să acceseze datele în întregime, fără a se gândi la shard-ing.
Voi explica separat de ce nu am ales o soluție gata făcută, ci am dorit să facem o funcție de shard-ing personalizată.
Să vedem cum este construită. Avem 256 de shard-uri disponibile. Pentru fiecare bucket, alocăm un interval folosind o funcție de consistență. Este simplu — la fel cum folosiți o funcție de consistență pentru a determina apartenența la un shard, determinați shard-ul de început și alocați intervalul:
f(bucket, shards) = subset
Așadar, dacă luăm un bucket, putem spune că acesta și datele sale vor fi întotdeauna stocate într-un subset specific din toate shard-urile. Acest lucru reduce influența unora dintre bucket-uri asupra altora și simplifică procesarea interogărilor map-reduce, când este necesar, de exemplu, să faceți o listă a obiectelor din bucket. Pentru aceasta, trebuie să interogați toate shard-urile unde aceste obiecte sunt stocate. Dacă obiectele ar fi stocate pe toate shard-urile, orice listare ar afecta întreaga sistemă, iar aici afectează doar un subset specific.
În continuare — fiecare obiect aparține unui anumit bucket, așa că atunci când ne adresăm pentru un obiect, ne adresăm pentru un obiect după nume în bucket-ul specific. Asta înseamnă că putem defini o funcție pentru un obiect nu din întregul interval disponibil de shard-uri, ci doar din subsetul bucket-ului său:
f(object, subset) = shard
Luăm un obiect specific, și ca argumente ale funcției transmitem nu toate shard-urile, ci subsetul bucket-ului său — și obținem un shard specific.
Așadar, shard-ingul este implementat, există o proxy de shard-ing. Rămâne doar să obținem din router și din baza de metadate în proxy-ul de shard-ing. De exemplu, pentru a crea obiecte de copii shadow — atunci când creăm un bucket, stocarea principală trebuie să creeze un reprezentant al acestui bucket pe toate shard-urile unde trebuie să fie prezent.
Cum am implementat resharding
Cea mai mare problemă a shardingului este resharingul. A fost important pentru noi să-l facem fără downtime, deoarece sistemul era deja în producție. Voi arăta cum am rezolvat problema printr-un exemplu similar de migrarea în direct a datelor dintr-un proiect în altul.
Mai jos este schema clusterului nostru, care a rezultat după implementarea shardingului. Avem nginx, API S3, un router, baza principală cu proiectele, un proxy de sharding și efectiv shardurile.
Mai sus am omis să menționez că într-un anumit moment al proiectului a existat o cerință de produs: „Lansați un alt stoc, Icebox, - ca Hotbox, doar pentru datele reci”. Practic, același tip de stocare, dar pe alte URL-uri și fără cache.
Icebox a fost utilizat mai puțin decât Hotbox, așadar, a funcționat destul de mult fără vreo sharding. În final, am decis să renunțăm la el și să combinăm Hotbox și Icebox într-un singur serviciu, împărțind doar clasele de stocare.
Buclele din stocare nu se suprapuneau, era ușor să le unim și să le mutăm, dar clienții foloseau ambele stocuri, ceea ce însemna că trebuia să rezolvăm problema absenței downtime-ului. Nu puteam pur și simplu să oprim și să copiem. Am realizat migrarea în mai multe etape.
Pentru început, am sincronizat stocările primare. Aveam Tarantool, iar când se crea un obiect, puteam face așa:
- o cerere de creare a unei bucăți ajunge la baza de date, de exemplu, în Hotbox;
- Tarantool verifică în cealaltă bază (în acest caz - în Icebox), că nu există o astfel de bucată;
- dacă bucata există, baza spune că nu poate fi creată, iar aceasta s-a sincronizat ca existentă.

Sincronizarea bucatelor
În stocarea care urma să primească toate datele, am introdus pentru proiecte și bucăți un atribut care să indice unde este stocat acest obiect. Acesta putea fi stocat local, adică în Hotbox, în Icebox - atunci nu există date de la el în noul stoc, sau putea fi în starea de migrare.
Dacă un proiect sau o bucată avea atributul Migrating, atunci în timpul migrației cererea a fost realizată mai întâi în noul stoc, în care datele ar trebui să fie, iar dacă acestea nu erau acolo, cererile erau redirecționate către stocarea alternativă.
Apoi am transferat traficul. Deoarece API-ul putea deservi atât cererile Icebox, cât și cererile Hotbox, am reușit să transferăm traficul fără downtime, mutând pur și simplu gazdele și adăugând înregistrările corespunzătoare în Nginx.
După ce traficul a fost redirecționat, Nginx și API-ul de la Icebox au putut fi eliminate.
Apoi am eliminat Nginx-ul Icebox și API-ul S3 — și totul a început să funcționeze:
Apoi am lansat un proces de migrare în fundal, care funcționează în cadrul bazei de date — parcurge toate proiectele și bucket-urile acestora, le marchează cu statusul Migrating, transferă datele și, la finalizarea transferului, le marchează ca Local.
După transferul datelor, nu mai avem nevoie de vechiul storage, așa că eliminăm părțile rămase ale vechii sisteme și eliminăm suportul pentru statusul migrației din cod.
Aceleași principii au fost aplicate și pentru resharding-ul din vechiul storage în cel shardat:
- Am marcat toate bucket-urile ca
Non-sharded. Toate cererile către ele erau direcționate către vechea storage, ne-shardată. - Noile bucket-uri erau create direct cu statusul
Sharded. - Am luat bucket-urile pe rând, le-am setat statusul
Migratingși am transferat datele.
În acest timp, cererile erau gestionate după principiul:
- Citire din noul, apoi din vechiul.
- Creăm doar în noul.
- Actualizăm în două faze: dacă nu este în nou, transferăm din vechi în nou, apoi actualizăm.
Lucrul cu certificatele SSL
Pe frontend folosim Nginx. În cazul nostru, nu este un Nginx obișnuit, ci OpenResty, Nginx cu suport pentru LuaJIT.
O altă componentă a sistemului este gestionarea certificatelor SSL. În storage-ul S3, puteți seta un domeniu propriu pentru a accesa un anumit bucket, pur și simplu folosind CNAME. Dar fără HTTPS în ziua de azi nu se poate: un domeniu propriu implică un certificat SSL propriu.
După cum am spus, echilibrarea și terminarea SSL sunt gestionate de Nginx. În cazul nostru, nu este un Nginx obișnuit, ci OpenResty, Nginx cu suport pentru LuaJIT.
Acest lucru ne-a permis să învățăm destul de ușor Nginx-ul nostru să returneze certificate arbitrare. De asemenea, era necesar să returnăm certificatele dinamic (fără a fi nevoie să le configurăm în fișierul de configurare). Am folosit extensia ssl_certificate_by_lua, care permite citirea certificatului dintr-o sursă arbitrară în timpul procesului de handshaking TLS. Ca stocare a certificatelor, am folosit și Tarantool: acest lucru permite gestionarea certificatelor din exterior și asigură o returnare extrem de rapidă.
A fost implementat, de asemenea, un demn separat, care are sarcina de a actualiza regulat certificatele emise prin Let’s Encrypt.
Ce aș salva și ce aș face diferit dacă aș dezvolta stocarea din nou
Ce ar fi trebuit să folosesc de la început
Sharding de la început. A cauzat destul de multe probleme re-shardingul. Se face ușor, însă, dacă începi proiecte care trebuie să se scaleze, este mai bine să iei direct un cluster sharding, chiar și cu un număr minim de noduri. Implementarea shardingului de la început este aproape gratuită comparativ cu integrarea acestuia într-un sistem în producție.
Lucrul cu Tarantool prin load balancers. Acum toate noile baze sunt imediat conectate la lucru prin load balancers. Acest lucru permite extinderea funcționalității, obținând o disponibilitate mai mare.
Auto-failover. Aș instala toate instrumentele necesare pentru auto-failover, deoarece primele eșecuri după lansare au fost legate de lipsa acestuia. După experiența cu S3, toate produsele ulterioare au fost lansate având în vedere acest lucru.
Funcția S3 "Versionare". Inițial părea că aceasta nu este o funcționalitate foarte cerută. Integrarea acestei opțiuni în arhitectura unui sistem funcțional este extrem de complicată.
Facturare separată. Modul în care am integrat facturarea în sistemul nostru și-a dovedit eficiența la început, dar ulterior a început să deranjeze, ar fi fost mai bine să o implementăm ca un serviciu complet separată.
Ce a fost o soluție bună
Modelul de date. Istoria a arătat că pe măsură ce serviciul s-a dezvoltat, ne-am potrivit destul de bine cu modelul de date Amazon, așa că putem implementa acele funcții care sunt acolo.
Schema de sharding. Aș susține aceleași shardinguri pe intervale pe bachete, deoarece asta permite o bună distribuție a cererilor din diferite bachete pe un cluster mare.
Utilizarea Tarantool. Tarantool a ajutat foarte mult la dezvoltarea serviciului și la modificările acestuia, am lucrat ușor cu datele, transformând și sharding stocarea, fără a fi nevoie să urcăm pe stratul aplicației.
Această prezentare a avut loc pentru prima dată la by Mail.ru Cloud Solutions&Tarantool. Vezi alte prezentări și abonează-te la anunțurile evenimentelor în Telegram .
De asemenea, poți viziona vechiul meu raport despre S3 sau să citești articolul colegului meu despre stocarea pe bloc.
- .
- .
Sursa: habr.com
