

În primele două articole am abordat problema automatizării și am schițat cadrul acesteia; în al doilea am făcut o digresiune asupra virtualizării rețelei, ca primă abordare pentru automatizarea configurării serviciilor.
Acum a venit timpul să desenăm schema rețelei fizice.
Dacă nu ești familiarizat cu echipamentele rețelelor de centre de date, îți recomand cu căldură să începi cu .
Toate episoadele:
Practici descrise în această serie ar trebui să fie aplicabile oricărui tip de rețea, indiferent de dimensiune și diversitate a furnizorilor. Cu toate acestea, nu poate fi descris un exemplu universal de aplicare a acestor abordări. De aceea, voi rămâne la arhitectura actuală a rețelei DC: .
DCI se va face pe MPLS L3VPN.
Peste rețeaua fizică funcționează rețeaua Overlay de la gazdă (poate fi VXLAN din OpenStack sau Tungsten Fabric sau orice altceva care necesită doar conectivitate IP de bază).
În acest caz, va rezulta un scenariu relativ simplu pentru automatizare, deoarece avem multe echipamente configurabile în mod similar.
Vom alege un DC sferic în vid:
- O versiune a designului pretutindeni.
- Două furnizori, formând două planuri de rețea.
- Un DC seamănă cu altul ca două picături de apă.
Cuprins
- Topologia fizică
- Rutare
- Plan IP
- Laborator
- Concluzie
- Linkuri utile
Să spunem că furnizorul nostru de servicii LAN_DC va găzdui, de exemplu, videoclipuri de instruire despre supraviețuirea în lifturi blocate.
În marile orașe, acest lucru este extrem de popular, de aceea sunt necesare multe mașini fizice.
Mai întâi voi descrie rețeaua aproximativ așa cum ar dori să o vadă. Apoi o voi simplifica pentru laborator.
Topologia fizică
Locații
LAN_DC va avea 6 DC-uri:
- Rusia (RO):
- Moscova (msk)
- Kazan (kzn)
- Spania (SP):
- Barcelona (bcn)
- Malaga (mlg)
- China (CN):
- Shanghai (sha)
- Xi'an (sia)

În interiorul DC-ului (Intra-DC)
În toate DC-urile există rețele identice de interconectare, bazate pe topologia Clos.
Ce sunt rețelele Clos și de ce anume sunt ele - într-un articol separat .
Fiecare DC are 10 rackuri cu mașini, acestea vor fi numerotate ca A, B, C Și așa mai departe.
În fiecare rack sunt 30 de mașini. Acestea nu ne vor interesa.
De asemenea, în fiecare rack există un switch la care sunt conectate toate mașinile - acesta este Switch de vârf de rack - ToR sau altfel, în termenii fabricii Cloza, o vom numi Leaf.

Schema generală a fabricii.
Îi vom numi XXX-leafY, unde XXX — abrevierea formată din trei litere pentru ToR, iar Y — numărul ordonat. De exemplu, kzn-leaf11.
În articolele mele, îmi voi permite să mă refer la termenii Leaf și ToR ca la sinonime. Totuși, trebuie să ne amintim că nu este așa.
ToR — este un comutator montat în rack, la care se conectează mașinile.
Leaf — este rolul unui dispozitiv în rețeaua fizică sau un switch de nivelul întâi în termenii topologiei Cloza.
Adică Leaf != ToR.
Astfel, un comutator de tip Leaf poate fi un comutator EndofRaw, de exemplu.
Cu toate acestea, în cadrul acestui articol, ne vom referi totuși la ele ca la sinonime.
Fiecare comutator ToR, la rândul său, este conectat la patru comutatoare agregatoare superioare — Spine. Pentru Spine s-au alocat câte un rack în DC. Îi vom numi similar: XXX-spineY.
În același rack va fi echipamentul de rețea pentru conectivitatea între DC — 2 routere cu MPLS la bord. Dar, în mare parte, sunt tot aceleași ToR. Adică, din perspectiva comutatoarelor Spine, nu contează un ToR obișnuit cu mașini conectate sau un router pentru DCI — este un lucru de a duce mai departe.
Aceste ToR speciale se numesc Edge-leaf. Le vom numi XXX-edgeY.
Asta va arăta astfel.
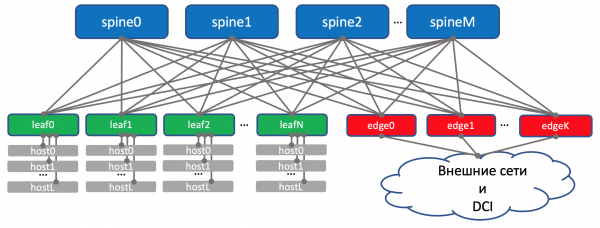
În schema de mai sus, eu am plasat edge și leaf efectiv pe același nivel. ne-au obișnuit să considerăm uplink-ul (de fapt de aici și termenul) ca legături în sus. Iar aici, se pare că «uplink»-ul DCI merge înapoi în jos, ceea ce îi derutează puțin pe unii. În cazul rețelelor mari, când centrele de date sunt împărțite în unități și mai mici — POD‘uri (Point Of Delivery), se alocă separate Edge-POD‘uri pentru DCI și pentru ieșirea în rețele externe.
Pentru a facilita înțelegerea ulterioară, voi desena de fapt Edge deasupra Spine, având totuși în minte că nu există niciun tip de inteligență pe Spine și diferențe în funcționarea cu Leaf-uri obișnuite și cu Edge-leaf (deși aici pot exista nuanțe, dar în general, așa este).
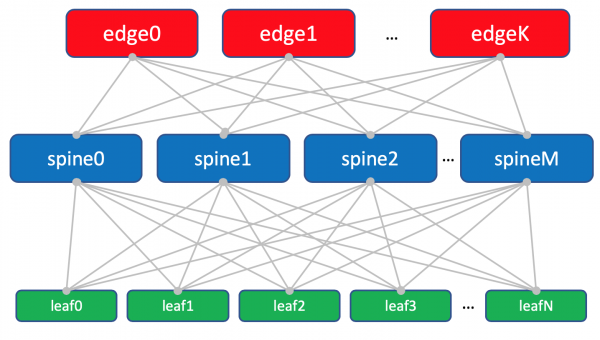
Schema fabricii cu Edge-leaf-uri.
Trio-ul Leaf, Spine și Edge formează rețeaua Underlay sau fabrica.
Sarcina fabricii de rețea (citiți Underlay), așa cum am stabilit deja în , este foarte și foarte simplă — a asigura conectivitatea IP între mașini atât în cadrul unui DC, cât și între ele.
De aceea, rețeaua se numește fabrică, la fel cum, de exemplu, se numește fabrica de comutare din interiorul cutiilor de rețea modulare, despre care se poate citi mai multe în .
În general, această topologie se numește fabrică, deoarece fabric în traducere înseamnă țesătură. Și este greu să nu fii de acord:
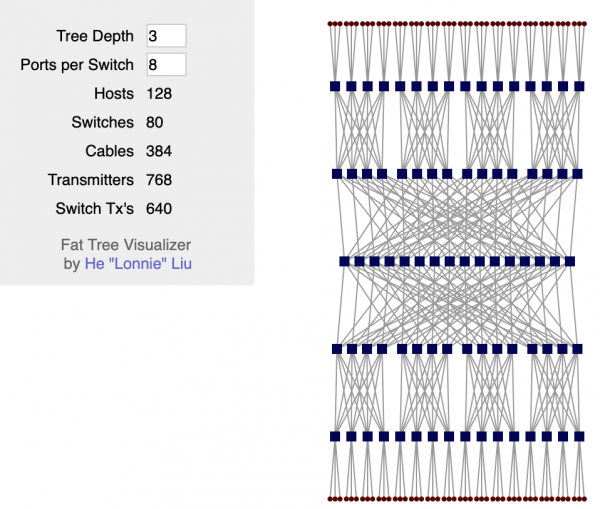
Fabrică complet L3. Fără VLAN, fără Broadcast — astfel de programatori minunați avem în LAN_DC, care știu să scrie aplicații ce trăiesc în paradigma L3, iar mașinile virtuale nu necesită migrare live cu păstrarea adresei IP.
Și încă o dată: răspunsul la întrebarea de ce fabrică și de ce L3 — este într-un articol separat .
DCI — Data Center Interconnect (Inter-DC)
DCI va fi organizat prin Edge-Leaf, adică acestea sunt punctul nostru de ieșire în magistrală.
Pentru simplificare, să presupunem că centrele de date sunt conectate între ele prin linii directe.
Vom exclude din discuție conectivitatea externă.
Îmi dau seama că de fiecare dată când elimin un anumit component, simplific semnificativ rețeaua. Și la automatizarea rețelei noastre abstracte totul va fi bine, iar în realitate vor apărea soluții improvizate.
Așa este. Și totuși, scopul acestei serii este să gândim și să lucrăm asupra abordărilor, nu să rezolvăm probleme inventate în mod eroic.
Pe Edge-Leaf-uri, underlay-ul este plasat în VPN și transmis prin magistrala MPLS (această linie directă).
Astfel, se obține o diagramă de nivel înalt.

Rutare
Pentru rutare în interiorul centrului de date, vom folosi BGP.
Pe magistrala MPLS OSPF+LDP.
Pentru DCI, adică organizarea conectivității în underlay — BGP L3VPN pe MPLS.
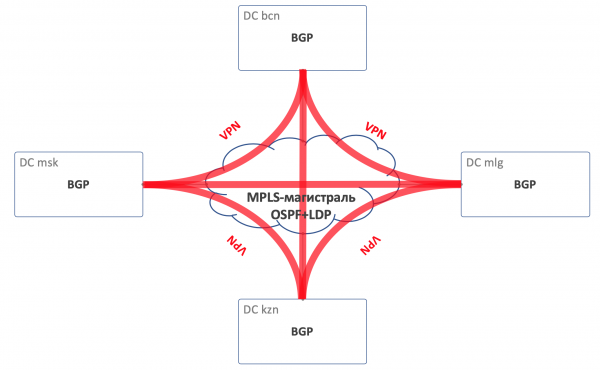
Diagrama generală de rutare
În fabrică nu există OSPF și ISIS (protocol de rutare interzis în Federația Rusă).
Și asta înseamnă că nu va exista Auto-discovery și calcularea celor mai scurte căi — doar configurarea manuală (de fapt automată — suntem aici despre automatizare) a protocolului, vecinătăților și politicilor.
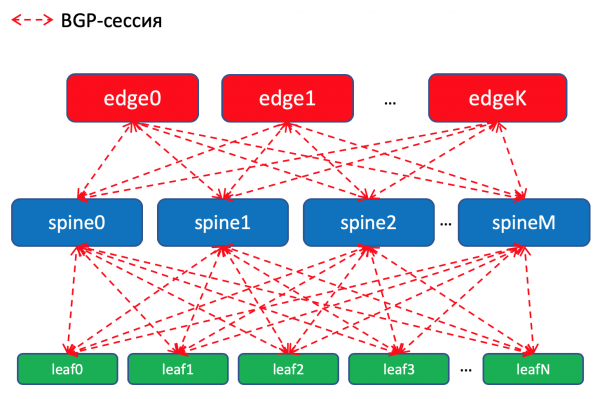
Schema de rutare BGP în interiorul centrului de date
De ce BGP?
Pe această temă există de la Facebook și Arista, unde se explică cum să construiești rețele foarte mari de centre de date, folosind BGP. Se citește aproape ca o lucrare de artă, foarte recomandat pentru o seară leneșă.
De asemenea, există o întreagă secțiune în articolul meu dedicată acestuia. Acolo vă și .
Dar dacă ar fi să rezumăm, niciun IGP nu este potrivit pentru rețelele mari de centre de date, unde numărul de dispozitive de rețea se ridică la mii.
În plus, utilizarea BGP în toate locurile va permite evitarea dispersării în suportul mai multor protocoale diferite și sincronizarea între ele.
Să fim sinceri, la fabrica noastră, care cu mare probabilitate nu va crește rapid, OSPF ar fi fost suficient. Acesta este cu adevărat o problemă pentru megascaleri și titani ai cloud-ului. Dar hai să ne imaginăm pentru câteva emisiuni că este necesar și vom folosi BGP, așa cum a spus Peter Lapukhov.
Politici de rutare
Pe comutatoarele Leaf, vom importa în BGP prefixele de la interfețele Underlay cu rețelele.
Vom avea o sesiune BGP între fiecare pereche Leaf-Spine, în care aceste prefixe Underlay vor fi anunțate prin rețea.
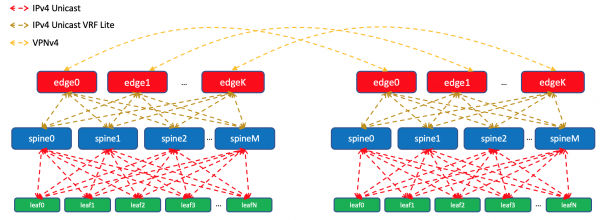
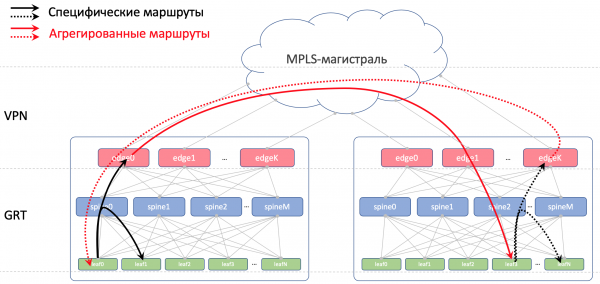
În interiorul unui centru de date, vom răspândi specificitățile pe care le-am importat pe ToR. Pe Edge-Leaf, le vom agrega și anunța în centre de date remote și le vom putea reduce până la ToR. Asta înseamnă că fiecare ToR va ști exact cum să ajungă la alt ToR în același centru de date și unde este punctul de intrare pentru a ajunge la ToR în alt centru de date.
În DCI, rutele vor fi transmise ca VPNv4. Pentru aceasta, pe interfața Edge-Leaf în direcția fabricii va fi plasată într-un VRF, să-l numim UNDERLAY, și vecinătatea cu Spine pe Edge-Leaf va fi ridicată în interiorul VRF-ului, iar între Edge-Leaf-uri în familia VPNv4.
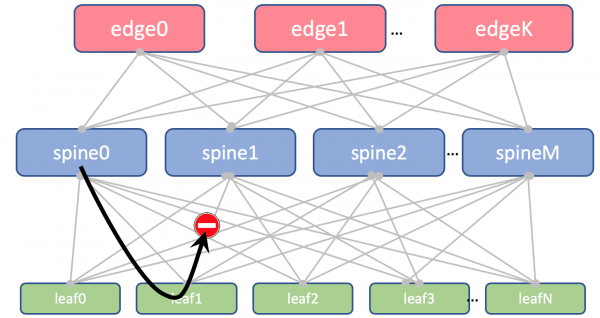
De asemenea, vom interzice reanunțarea rutelor primite de la spine-uri, înapoi la acestea.
Pe Leaf și Spine nu vom importa Loopback-uri. Acestea ne vor fi necesare doar pentru a determina Router ID.
Dar pe Edge-Leaf-uri, le vom importa în BGP Global. Între adresele Loopback, Edge-Leaf-urile vor stabili sesiuni BGP în IPv4 VPN-family între ele.
Între dispozitivele EDGE, vom avea o magistrală extinsă pe OSPF+LDP. Totul într-o singură zonă. Configurare extrem de simplă.
Iată cum arată situația cu rutarea.
BGP ASN
Edge-Leaf ASN
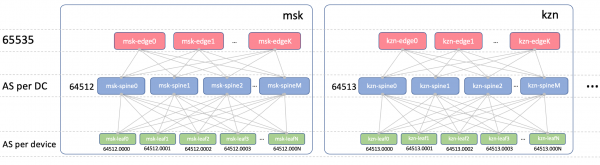
Pe Edge-Leaf-uri va exista un singur ASN în toate centrele de date. Este important ca între Edge-Leaf-uri să existe iBGP, și să nu avem probleme cu nuanțele eBGP. Să fie 65535. În realitate, acesta ar putea fi un număr al AS-ului public.
Spine ASN
Pe Spine, vom avea un singur ASN pentru centrul de date. Vom începe aici cu cel mai mic număr din gama AS-urilor private — 64512, 64513 și așa mai departe.
De ce ASN pe centru de date?
Să descompunem această întrebare în două:
- De ce ASN-uri identice pe toate spine-urile dintr-un singur centru de date?
- De ce diferite în centre de date diferite?
De ce ASN-uri identice pe toate spine-urile dintr-un singur centru de date?
Iată cum va arăta AS-Path-ul rutei Underlay pe Edge-Leaf:
[leafX_ASN, spine_ASN, edge_ASN]
Când încercăm să-l anunțăm înapoi pe Spine, acesta îl va ignora deoarece AS-ul său (Spine_AS) se află deja în listă.
Cu toate acestea, în interiorul DC-ului suntem complet confortabili cu faptul că rutele Underlay, care au ajuns la Edge, nu vor putea coborî. Toată comunicarea între gazde în cadrul DC-ului ar trebui să aibă loc în interiorul nivelului spine.
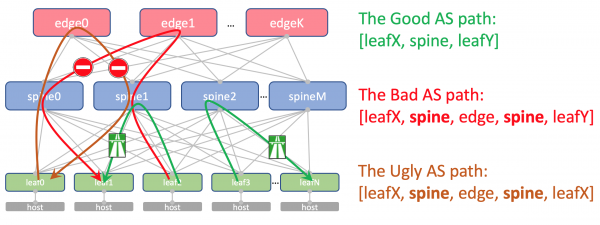
În același timp, rutele aggregate din alte DC-uri vor ajunge fără impedimente la ToR-uri – în AS-Path-ul lor va fi doar ASN 65535 – numărul AS-urilor Edge-Leaf, pentru că exact pe ele au fost create.
De ce sunt diferite în diferite DC-uri
Teoretic, poate fi necesar să trasăm Loopback-uri ale unor mașini virtuale de servicii între DC-uri.
De exemplu, pe gazdă vom lansa un Route Reflector sau (Virtual Network Gateway), care se va conecta prin BGP la ToR și va anunța propriul său loopback, care ar trebui să fie accesibil din toate DC-urile.
Iată cum va arăta AS-Path-ul său:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Și aici nu ar trebui să existe ASN-uri repetate.
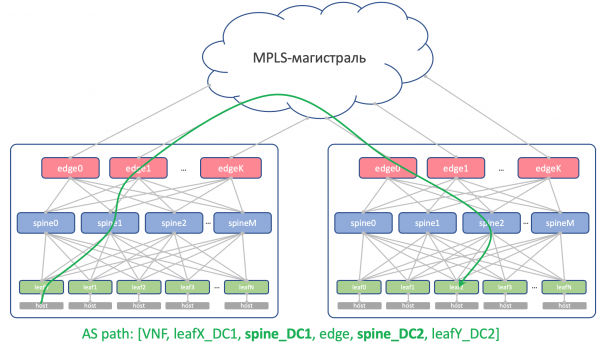
Adică, Spine_DC1 și Spine_DC2 ar trebui să fie diferite, la fel ca leafX_DC1 și leafY_DC2, ceea ce ne aduce exact la subiect.
După cum știți, există hack-uri care permit acceptarea rutelor cu ASN-uri repetitive, în ciuda mecanismului de prevenire a buclelor (allowas-in pe Cisco). Și există chiar aplicații legitime pentru aceasta. Dar aceasta reprezintă o breșă potențială în stabilitatea rețelei. Personal am căzut în această capcană de câteva ori.
Și dacă avem posibilitatea să evităm lucruri periculoase, ne vom folosi de ea.
Leaf ASN
Vom avea un ASN individual pe fiecare switch Leaf în întreaga rețea.
Facem acest lucru din motivele menționate mai sus: un AS-Path fără bucle, configurație BGP fără backdoor-uri.
Pentru ca rutele între Leaf-uri să treacă fără probleme, AS-Path-ul ar trebui să arate astfel:
[leafX_ASN, spine_ASN, leafY_ASN]
unde leafX_ASN și leafY_ASN ar trebui să fie diferite.
Este necesar și pentru situația în care anunțăm loopback-ul VNF între DC-uri:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Vom folosi un ASN de 4 octeți și îl vom genera pe baza ASN-ului Spine-ului și numărului Switch-ului Leaf, adică, astfel: Spine_ASN.0000X.
Iată cum arată situația cu ASN.
Plan IP
În principiu, trebuie să alocăm adrese pentru următoarele conexiuni:
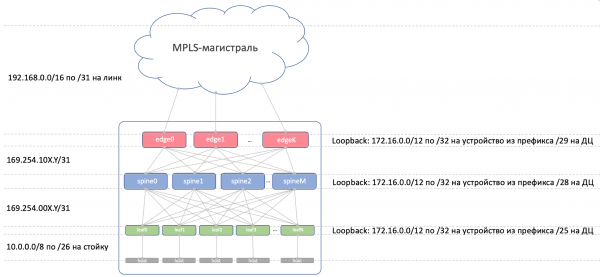
- Adresele rețelei Underlay între ToR și mașină. Acestea trebuie să fie unice în întreaga rețea, pentru ca orice mașină să poată comunica cu orice altă mașină. Se potrivesc perfect 10/8. Pe fiecare rack câte /26 cu rezervă. Vom aloca câte /19 pentru DC și /17 pentru regiune.
- Adresele de legătură între Leaf/Tor și Spine.
Ne dorim să le atribuim algoritmic, adică să le calculăm din numele dispozitivelor care trebuie conectate.
Hai să o numim… 169.254.0.0/16.
Mai exact 169.254.00X.Y/31, unde X — numărul Spine, Y — rețea P2P /31.
Aceasta va permite să pornim până la 128 de rack-uri și până la 10 Spine în DC. Adresele de legătură pot (și vor) să se repete de la DC la DC. - Conectarea Spine – Edge-Leaf o organizăm pe subrețele 169.254.10X.Y/31, unde la fel X — numărul Spine, Y — rețea P2P /31.
- Adresele de legătură din Edge-Leaf în magistrala MPLS. Aici situația este puțin diferită – este locul unde se conectează toate segmentele într-un singur întreg, astfel că reutilizarea acelorași adrese nu va fi posibilă – trebuie să alegem următoarea subrețea liberă. Prin urmare, vom lua ca bază 192.168.0.0/16 și vom extrage adresele libere.
- Adresele Loopback. Le vom aloca întregul interval 172.16.0.0/12.
- Leaf – câte /25 pentru DC – aceleași 128 de rack-uri. Vom aloca câte /23 pentru regiune.
- Spine – câte /28 pentru DC – până la 16 Spine. Vom aloca câte /26 pentru regiune.
- Edge-Leaf – câte /29 pentru DC – până la 8 unități. Vom aloca câte /27 pentru regiune.
Dacă în DC nu ne ajung intervalele alocate (și nu ne vor ajunge – pretindem la scalabilitate hipo), pur și simplu alocăm blocul următor.
Asta este imaginea cu adresarea IP.
Loopback-urile:
Prefix
Rolul dispozitivului
Regiunea
DC
172.16.0.0/23
edge
172.16.0.0/27
ru
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
ru
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
ru
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay:
Prefix
Regiunea
DC
10.0.0.0/17
ru
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Laborator
Două branduri. O rețea. ADMS.
Juniper + Arista. Ubuntu. Vechea bună Eva.
Numărul de resurse pe mașina noastră virtuală din Miran este totuși limitat, așa că pentru practică vom folosi o rețea simplificată.
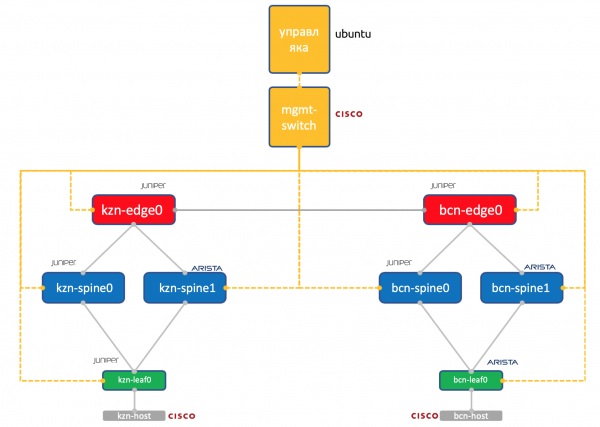
Două centre de date: Kazan și Barcelona.
- Câte două Spine în fiecare: Juniper și Arista.
- Câte un Tor (Leaf) în fiecare — Juniper și Arista, cu un host conectat (să luăm un Cisco IOL ușor pentru asta).
- Câte o nodă Edge-Leaf (deocamdată doar Juniper).
- Un switch Cisco pentru a le controla pe toate.
- Pe lângă cutiile de rețea, a fost lansată o mașină virtuală de management. Sub Ubuntu.
Aceasta are acces la toate dispozitivele, pe ea vor rula sistemele IPAM/DCIM, o serie de scripturi Python, Ansible și orice altceva am putea avea nevoie.
a tuturor dispozitivelor de rețea pe care vom încerca să le reproducem cu ajutorul automatizării.
Concluzie
Este acceptat? Să facem un scurt rezumat sub fiecare articol?
Deci, am ales Kloza în interiorul DC-ului, deoarece ne așteptăm la mult trafic East-West și dorim ECMP.
Am divizat rețeaua în fizică (underlay) și virtuală (overlay). Astfel, overlay-ul începe cu gazda — simplificând astfel cerințele pentru underlay.
Am ales BGP ca protocol de rutare pentru rețelele underlay datorită scalabilității sale și a flexibilității politicilor.
Vom avea noduri separate pentru organizarea DCI — Edge-leaf.
Pe magistrală va fi OSPF+LDP.
DCI va fi implementat pe baza MPLS L3VPN.
Pentru linkurile P2P, adresele IP vor fi calculate algoritmic pe baza numelui dispozitivelor.
Loopback-urile vor fi atribuite în funcție de rolul dispozitivelor și de poziționarea acestora.
Prefixele underlay vor fi doar pe switch-urile Leaf, în funcție de poziționarea acestora.
Să presupunem că în acest moment nu avem echipamente instalate.
Prin urmare, pașii noștri următori vor fi să le introducem în sisteme (IPAM, inventar), să organizăm accesul, să generăm configurația și să o desfășurăm.
În următorul articol, ne vom ocupa de Netbox — sistemul de inventariere și management al spațiului IP în DC.
Mulțumesc
- Mulțumiri lui Andrei Glazkov aka @glazgoo pentru corectură și sugestii.
- Mulțumiri lui Alexandru Klimenko aka @v00lk pentru corectură și sugestii.
- Mulțumiri lui Artiom Cernobai pentru KDPV.
Sursa: habr.com
