

Bună ziua tuturor. Lucrez ca administrator de sistem principal la OK și sunt responsabil pentru funcționarea stabilă a portalului. Vreau să vă povestesc despre cum am construit procesul de înlocuire automată a discurilor și apoi, cum am exclus administratorul din acest proces și l-am înlocuit cu un bot.
Acest articol este o oarecare transliterare de la HighLoad+ 2018
Construirea procesului de înlocuire a discurilor
Mai întâi câteva cifre
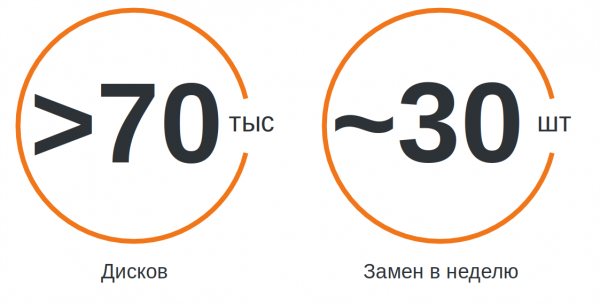
OK este un serviciu uriaș, utilizat de milioane de oameni. Este întreținut de aproximativ 7.000 de servere, situate în 4 centre de date diferite. În servere sunt installate peste 70.000 de discuri. Dacă le așezăm unele peste altele, obținem un turn de peste 1 km înălțime.
Discurile dure sunt componenta serverului care se defectează cel mai des. La un astfel de volum, suntem nevoiți să schimbăm aproximativ 30 de discuri pe săptămână, iar această procedură a devenit o rutină nu foarte plăcută.
Incidente
În compania noastră, avem un management complet al incidentelor. Fiecare incident este înregistrat în Jira, iar apoi este rezolvat și analizat. Dacă incidentul a avut efecte asupra utilizatorilor, ne întâlnim neapărat și discutăm despre cum să reacționăm mai rapid în astfel de cazuri, cum să reducem impactul și, desigur, cum să prevenim repetarea.
Stocările nu fac excepție. Starea acestora este monitorizată de Zabbix. Monitorizăm mesajele în Syslog pentru erori de scriere/lectură, analizăm starea RAID-urilor HW/SW, urmărim SMART-ul, iar pentru SSD-uri calculăm uzura.
Cum se schimbau discurile înainte
Când un trigger se aprinde în Zabbix, un incident este creat în Jira și este atribuit automat inginerilor corespunzători din centrele de date. Facem acest lucru pentru toate incidentele HW, adică cele care necesită o muncă fizică cu echipamentul din centrul de date.
Inginerul din centrul de date este persoana care se ocupă de problemele legate de hardware, răspunzând de instalarea, întreținerea și demontarea serverelor. După ce primește un tichet, inginerul începe lucrul. În rack-urile cu discuri, el schimbă discurile singur. Dar dacă nu are acces la dispozitivul necesar, inginerul se adresează administratorilor de sistem de gardă pentru ajutor. În primul rând, trebuie să scoată discul din rotație. Pentru aceasta, trebuie să facă modificările necesare pe server, să oprească aplicațiile și să de-monteze discul.
Administratorul de sistem de gardă este responsabil pe parcursul turei de muncă pentru funcționarea întregului portal. Acesta investighează incidentele, se ocupă de reparații, ajută dezvoltatorii să îndeplinească sarcini minore. Nu se ocupă însă de hard disk-uri.
Anterior, inginerii din data center comunicau cu administratorul de sistem prin chat. Aceștia trimiteau linkuri la tichetele Jira, iar administratorul le verifica, ținea un jurnal al activităților într-un fel de caiet. Însă pentru astfel de sarcini, chat-ul era incomod: informațiile nu erau structurate și se pierdeau rapid. În plus, administratorul putea să se abată de la calculator, rămânând o perioadă fără a răspunde la cereri, iar inginerul stătea lângă server cu un pachet de discuri și aștepta.
Dar cel mai rău era că administratorii nu vedeau imaginea de ansamblu: ce incidente legate de discuri există, unde ar putea apărea o problemă. Acest lucru se datorează faptului că toate incidentele HW erau încredințate inginerilor. Da, ar fi putut fi afișate toate incidentele pe tabloul de bord al administratorului. Însă acestea erau foarte multe, iar administratorul era implicat doar în unele dintre ele.
În plus, inginerul nu putea stabili corect prioritățile pentru că nu știa nimic despre destinația serverelor specifice, despre distribuția informațiilor pe unitățile de stocare.
Noua procedură de înlocuire
Primul lucru pe care l-am făcut a fost să scoatem toate incidentele legate de discuri într-un tip separat "HW-disk" și să adăugăm câmpurile "numele dispozitivului de bloc", "dimensiune" și "tip de disc", astfel încât aceste informații să fie păstrate în tichet și să nu mai fie necesar să facem schimburi constante pe chat.
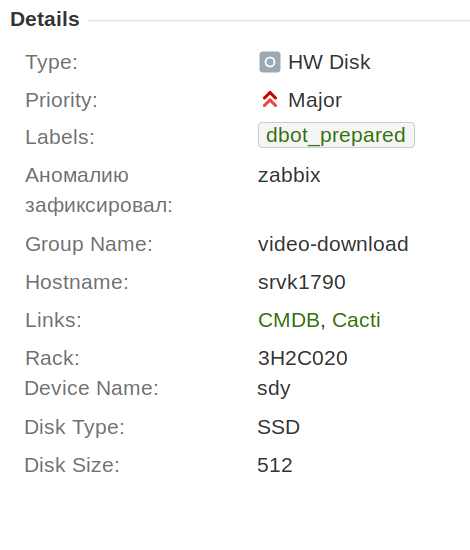
De asemenea, am convenit că în cadrul unui singur incident vom schimba doar un singur disc. Acest lucru a simplificat considerabil procesul de automatizare ulterior, colectarea statisticilor și activitatea.
În plus, am adăugat câmpul "administrator responsabil". Acolo este introdus automat administratorul de sistem de gardă. Acest lucru este foarte convenabil deoarece acum inginerul vede mereu cine este responsabil. Nu trebuie să se uite în calendar și să caute. Exact acest câmp a permis să fie afișate în tabloul de bord al administratorului tichetele în care, poate, va avea nevoie de ajutorul său.
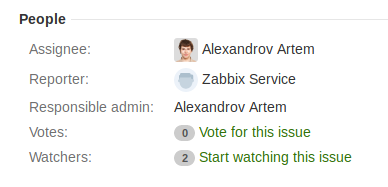
Pentru ca toți participanții să beneficieze la maxim de inovații, am creat filtre și tablouri de bord, pe care le-am explicat echipei. Când oamenii înțeleg schimbările, nu se distanțează de ele, ca și cum ar fi ceva inutil. Inginerul trebuie să știe numărul raftului unde se află serverul, dimensiunea și tipul discului. Administratorul trebuie, în primul rând, să înțeleagă ce grup de servere este, care ar putea fi efectul în cazul înlocuirii discului.
Existenta câmpurilor și modul în care sunt afișate este convenabil, dar acest lucru nu ne-a scutit de necesitatea de a folosi chat-uri. A fost necesară modificarea fluxului de lucru pentru asta.
În trecut, el era așa:
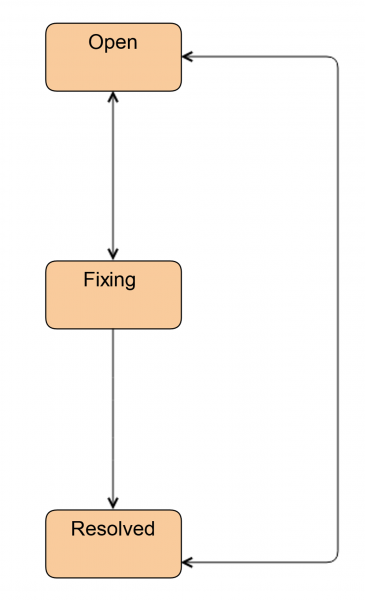
Astăzi, inginerii continuă să lucreze așa, când nu au nevoie de ajutorul administratorului.
Primul lucru pe care l-am făcut a fost să introducem un nou statut Investigate. În acest statut, tichetul se află atunci când inginerul nu a decis încă dacă va avea nevoie de administrator sau nu. Prin acest statut, inginerul poate transfera tichetul către administrator. În plus, prin acest statut, marcăm tichetele atunci când este necesară înlocuirea discului, dar discul nu se află pe platformă. Acest lucru se poate întâmpla în cazul CDN-urilor și platformelor externe.
De asemenea, am adăugat statutul Gata. În acest statut, tichetul este mutat după înlocuirea discului. Adică totul este deja făcut, dar pe server se sincronizează HW/SW RAID. Acest lucru poate dura destul de mult timp.
Dacă este implicat administratorul, schema devine puțin mai complicată.
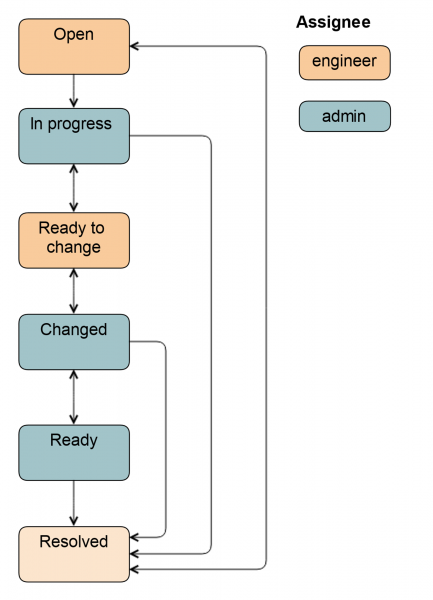
Din statutul Open , tichetul poate fi mutat atât de administratorul de sistem, cât și de inginer. În statutul In progress , administratorul scoate discul din rotație, astfel încât inginerul să-l poată scoate cu ușurință: activează iluminarea, deconectează discul, oprește aplicațiile, în funcție de grupul specific de servere.
Apoi, tichetul este transferat în Ready to change: acesta este un semnal pentru inginer că discul poate fi scos. Toate câmpurile din Jira sunt deja completate, inginerul știe ce tip și dimensiune are discul. Aceste date sunt completate fie automat în statutul anterior, fie de către administrator.
După înlocuirea discului, tichetul este mutat în statutul Changed. Se verifică dacă s-a introdus discul corespunzător, se face cartografierea, se pornește aplicația și unele sarcini de recuperare a datelor. De asemenea, tichetul poate fi mutat în statutul Gata, în acest caz, responsabilul rămâne administratorul, deoarece el a introdus discul în rotație. Schema completă arată astfel.
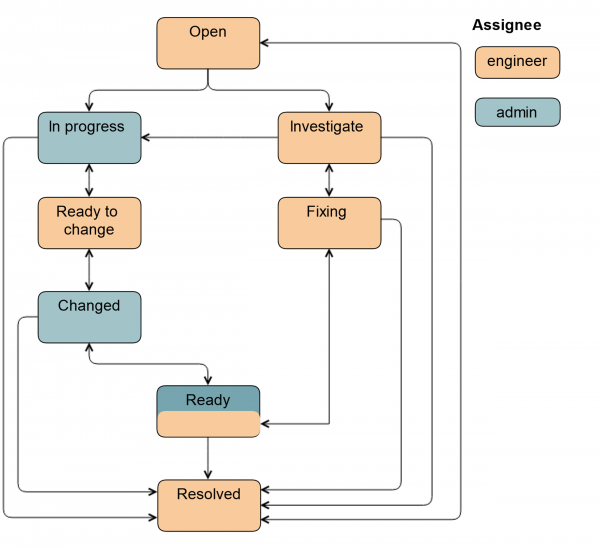
Adăugarea de câmpuri noi ne-a ușurat considerabil munca. Echipa a început să lucreze cu informații structurate, a devenit clar ce trebuie făcut și în ce etapă. Prioritățile au devenit mult mai relevante, deoarece acum sunt stabilite de administrator.
Nu mai este nevoie de chaturi. Desigur, administratorul poate scrie inginerului „aici trebuie să schimbăm mai repede” sau „sunt deja seară, reușești să schimbi?”. Dar nu mai comunicăm zilnic în chaturi despre aceste subiecte.
Discurile au început să fie schimbate în loturi. Dacă administratorul ajunge la muncă puțin mai devreme, are timp liber, și nimic nu s-a întâmplat, poate pregăti mai multe servere pentru înlocuire: poate marca câmpurile, scoate discurile din rotație și transmite sarcina inginerului. Inginerul vine puțin mai târziu la centrul de date, vede sarcina, ia din depozit unitățile necesare și le schimbă imediat. Ca urmare, viteza de înlocuire a crescut.
Experiența acumulată în construirea fluxului de lucru
- În elaborarea procedurii, trebuie să strângi informații din diverse surse.
Unii dintre administratorii noștri nu știau că inginerul schimbă discurile de unul singur. Unii credeau că inginerii monitorizează sincronizarea MD RAID, deși unii dintre ei nu aveau acces pentru aceasta. Unii ingineri principali o făceau, dar nu întotdeauna, deoarece procesul nu era nicăieri descris. - Procedura trebuie să fie simplă și clară.
Este greu pentru o persoană să țină în minte multe etape. Cele mai importante stări adiacente în Jira trebuie scoase pe ecranul principal. Le putem redenumi, de exemplu, In progress le numim Ready to change. Iar celelalte stări pot fi ascunse în meniul derulant, pentru a nu deranja. Dar este mai bine să nu limităm oamenii, să le oferim posibilitatea de a face tranziția.
Explicați valoarea inovațiilor. Când oamenii înțeleg, acceptă mai bine noua procedură. A fost foarte important pentru noi ca oamenii să nu parcurgă întregul proces pe nerăsuflate, ci să-l urmeze. Apoi am început să construim automatizări pe baza acestuia. - Așteaptă, analizează, înțelege.
Ne-a luat aproximativ o lună să construim procedura, realizarea tehnică, întâlnirile și discuțiile. Iar implementarea a durat mai mult de trei luni. Am văzut cum oamenii încep încetul cu încetul să folosească nouătatea. În primele etape a fost mult negativ. Dar acesta nu depindea deloc de procedură sau de realizarea ei tehnică. De exemplu, un administrator folosea nu Jira, ci un plugin Jira în Confluence, și anumiți lucruri nu erau accesibile pentru el. I-am arătat Jira, iar productivitatea administratorului a crescut atât în sarcinile generale, cât și în schimbările de discuri.
Automatizarea schimbărilor de discuri
Am abordat automatizarea schimbărilor de discuri de câteva ori. Aveam deja niște lucruri realizate, scripturi, dar toate funcționau fie în mod interactiv, fie manual, necesitând inițiere. Abia după ce am implementat noua procedură am realizat că tocmai aceasta ne lipsea.
Deoarece acum procesul de schimbare este împărțit în etape, fiecare cu un executor desemnat și o listă de acțiuni, putem activa automatizarea treptat, nu imediat în întregime. De exemplu, cea mai simplă etapă — Ready (verificarea sincronicizării RAID/ datelor) poate fi delegată cu ușurință unui bot. Când botul se va învăța puțin, îl putem însărcina cu o sarcină mai responsabilă — introducerea discului în rotație etc.
Zoologicul configurațiilor
Înainte de a vorbi despre bot, să facem o scurtă excursie în zoologicul nostru de instalări. În primul rând, acesta este determinat de dimensiunea gigantică a infrastructurii noastre. În al doilea rând, încercăm să alegem o configurație optimă a hardware-ului pentru fiecare serviciu. Avem aproximativ 20 de modele de RAID hardware, în principal LSI și Adaptec, dar întâlnim și HP și DELL de diferite versiuni. Fiecare controler RAID are propriul său utilitar de management. Setul de comenzi și ieșirea acestora pot varia de la o versiune la alta pentru fiecare controler RAID. Acolo unde nu se folosesc HW-RAID, poate fi mdraid.
Practic toate noile instalări le facem fără rezervare de disc. Încercăm să nu mai folosim RAID hardware și software, deoarece rezervăm sistemele noastre la nivel de centre de date, nu de servere. Dar, desigur, există multe servere legacy care trebuie susținute.
Undeva, discurile în controlerele RAID sunt conectate ca dispozitive raw, în alte cazuri se folosește JBOD. Există configurații cu un singur disc sistem în server, iar dacă acesta trebuie înlocuit, serverul trebuie reinstalat cu sistemul de operare și aplicațiile, de preferat aceleași versiuni, apoi se adaugă fișierele de configurare și se pornesc aplicațiile. De asemenea, există foarte multe grupuri de servere în care redundanța se face nu la nivelul subsistemului de discuri, ci direct în aplicațiile respective.
În total, avem peste 400 de grupuri unice de servere, pe care rulează aproximativ 100 de aplicații diferite. Pentru a acoperi un astfel de număr uriaș de variante, aveam nevoie de un instrument multifuncțional de automatizare. Ideal cu un DSL simplu, astfel încât să poată fi susținut nu doar de cei care l-au scris.
Am ales Ansible, deoarece este agentless: nu a fost nevoie să pregătim infrastructura, având un start rapid. În plus, este scris în Python, care este acceptat ca standard în echipă.
Schema generală
Să analizăm schema generală de automatizare în exemplul unui incident. Zabbix detectează că discul sdb a ieșit din funcțiune, se activează un trigger, iar un ticket este creat în Jira. Administratorul îl examinează, realizează că nu este un duplicat și nu este un false positive, adică trebuie schimbat discul și îl transferă în In progress.
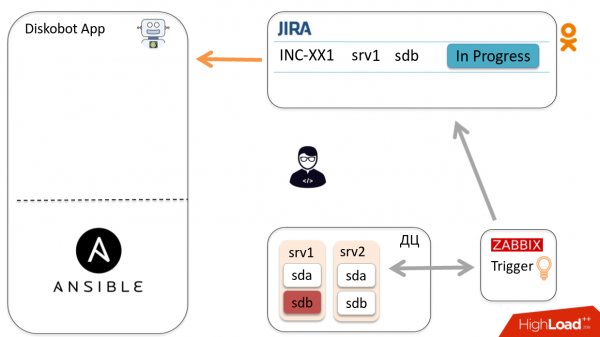
Aplicația DiskoBot, scrisă în Python, interoghează periodic Jira pentru ticheturi noi. Ea observă că a apărut un nou tiche In progress, se activează threadul corespunzător care lansează playbook-ul în Ansible (acest lucru se face pentru fiecare statut din Jira). În acest caz, se lansează Prepare2change.
Ansible se conectează la host, scoate discul din rotație și raportează statusul aplicației prin Callbacks.
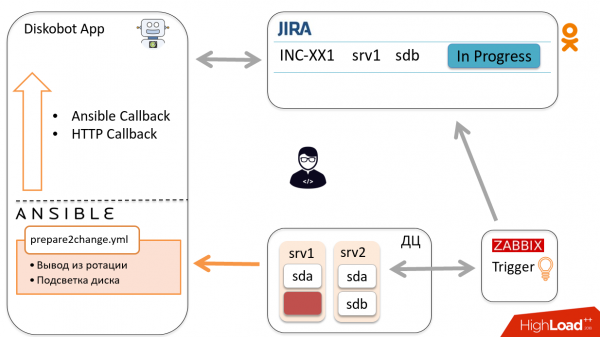
Ca rezultat, botul mută automat ticheta în Ready to change. Inginerul primește o notificare și se îndreaptă să schimbe discul, după care mută ticheta în Changed.
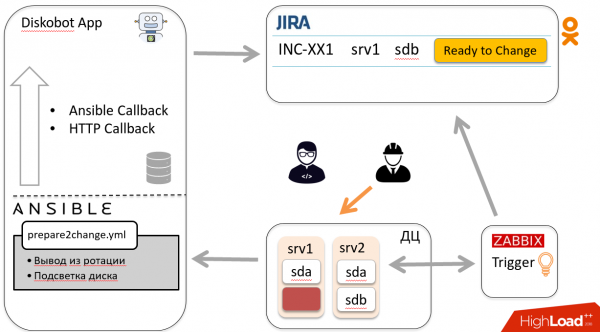
După schema descrisă mai sus, ticheta ajunge înapoi la bot, care lansează un alt playbook, se conectează la host și introduce discul în rotație. Botul închide ticheta. Ura!
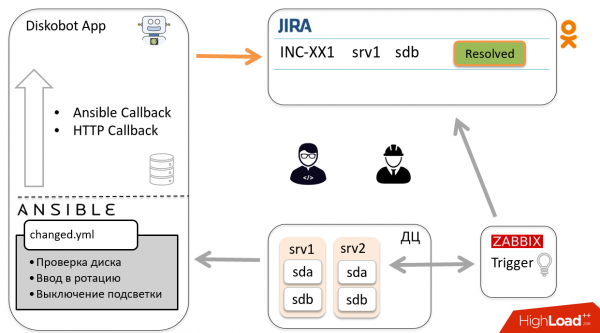
Acum să discutăm despre unele componente ale sistemului.
Diskobot
Această aplicație este scrisă în Python. Ea selectează tichete din Jira conform JQL. În funcție de statusul tichetei, aceasta ajunge la procesorul corespunzător, care de asemenea lansează playbook-ul Ansible corespunzător statutului.
JQL și intervalele de sondare sunt definite în fișierul de configurare al aplicației.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '… and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
De exemplu, printre tichetele în statutul In progress, sunt selectate doar cele ale căror câmpuri Disk size și Device name sunt completate. Device name este numele dispozitivului bloc, necesar pentru a rula playbook-ul. Disk size este necesar pentru ca inginerul să știe ce dimensiune de disc este necesară.
Iar printre tichetele cu statutul Ready, sunt filtrate tichetele cu eticheta dbot_ignore. Apropo, folosim etichetele Jira atât pentru filtrarea de acest tip, cât și pentru marcarea dublurilor de tichete și colectarea de statistici.
În cazul unei erori a playbook-ului, Jira atribuie eticheta dbot_failed, pentru a putea analiza situația ulterior.
Interacțiunea cu Ansible
Aplicația interacționează cu Ansible prin . În playbook_executor, transmitem numele fișierului și un set de variabile. Acest lucru permite păstrarea proiectului Ansible sub formă de fișiere yml obișnuite, fără a-l descrie în cod Python.
De asemenea, în Ansible prin *extra_vars* sunt transmise numele dispozitivului bloc, statutul tichetului, precum și callback_url, în care este inclus issue key — acesta este utilizat pentru callback în HTTP.
Pentru fiecare execuție, se generează un inventory temporar, format dintr-un singur host și un grup, în care se află acest host, pentru a se aplica group_vars.
Iată un exemplu de task, în care este implementat HTTP callback.
Rezultatele execuțiilor playbook-urilor le obținem prin callback-uri. Acestea sunt de două tipuri:
- , acesta oferă date despre rezultatele execuției playbook-ului. Acolo sunt descrise sarcinile care au fost lansate, atât cele executate cu succes, cât și cele eșuate. Acest callback este apelat la finalizarea playbook-ului.
- HTTP callback pentru a obține informații în timpul execuției playbook-ului. În task-ul Ansible, efectuăm o cerere POST/GET către aplicația noastră.
Prin HTTP callback-uri sunt transmise variabilele care au fost definite în timpul execuției playbook-ului și pe care dorim să le păstrăm și să le folosim în execuțiile ulterioare. Aceste date le scriem în sqlite.
De asemenea, prin HTTP callback lăsăm comentarii și modificăm statutul tichetului.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Ca și multe alte sarcini asemănătoare, l-am mutat într-un fișier comun și îl includem atunci când este necesar, pentru a nu-l repeta constant în playbook-uri. Aici apare callback_url, în care sunt codificate cheia issue și numele gazdelor. Atunci când Ansible efectuează această cerere POST, robotul înțelege că a sosit în cadrul acestui incident.
Iată un exemplu din playbook, în care am scos discul din dispozitivul MD:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Această sarcină schimbă statusul tichetului Jira în „Pregătit pentru schimbare” și adaugă un comentariu. De asemenea, în variabila mdam_data este păstrată lista dispozitivelor MD din care a fost eliminat discul, iar în parted_info — un dump al partiției de la parted.
Când inginerul va insera un disc nou, vom putea folosi aceste variabile pentru a restaura dumpul partițiilor, precum și pentru a reintegra discul în dispozitivele MD din care a fost eliminat.
Modul de verificare Ansible
A fost înfricoșător să activăm automatizarea. Așa că am hotărât să rulăm toate playbook-urile în modul
, în care Ansible nu efectuează nicio acțiune pe servere, ci doar le emulează.
Această execuție trece printr-un modul callback separat, iar rezultatul execuției playbook-ului este salvat în Jira sub formă de comentariu.
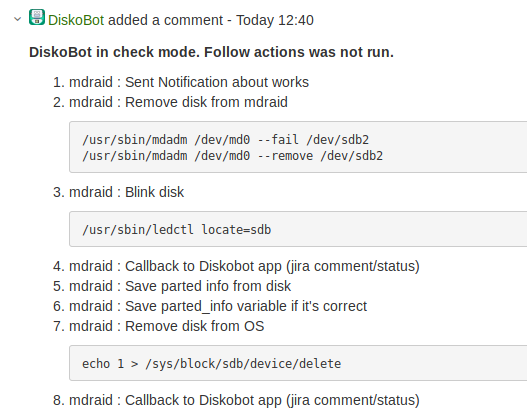
În primul rând, aceasta a permis validarea funcționării robotului și a playbook-urilor. În al doilea rând, a crescut încrederea administratorilor în robot.
Când am trecut de validare și am realizat că putem rula Ansible nu doar în modul dry run, am creat în Jira un buton Run Diskobot pentru a lansa același playbook cu aceleași variabile pe aceeași gazdă, dar în modul obișnuit.
În plus, butonul este folosit pentru a relansa playbook-ul în cazul în care eșuează.
Structura Playbooks
Am menționat deja că, în funcție de statusul tichetului Jira, robotul lansează playbook-uri diferite.
În primul rând, astfel este mult mai ușor să organizăm intrarea.
În al doilea rând, în unele cazuri, aceasta este pur și simplu necesară.
De exemplu, atunci când înlocuim discul sistemului, trebuie să mergem mai întâi în sistemul de desfășurare, să creăm o sarcină, iar după desfășurarea corectă serverul va deveni accesibil prin ssh și putem implementa aplicația. Dacă am fi făcut tot acest lucru într-un singur playbook, Ansible nu ar fi putut să-l execute din cauza inaccesibilității gazdei.
Folosim roluri Ansible pentru fiecare grup de servere. Aici se poate vedea cum sunt organizate playbook-urile într-una dintre ele.
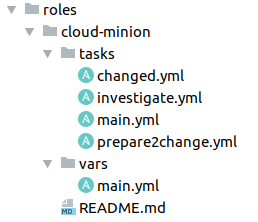
Este lucru este convenabil pentru că este imediat clar unde sunt plasate diferitele sarcini. În main.yml, care este intrarea pentru rolul Ansible, putem avea pur și simplu un include în funcție de starea tichetului sau sarcini generale necesare pentru toți, de exemplu, trecerea prin identificare sau obținerea unui token.
Investigation.yml
Se lansează pentru tichetele cu starea Investigation și Open. Cel mai important pentru acest playbook este numele dispozitivului de blocare. Această informație nu este întotdeauna disponibilă.
Pentru a o obține, analizăm rezumatul Jira, ultimul valoarea de la trigger-ul Zabbix. Acolo poate fi numele dispozitivului de blocare — așa că am avut noroc. Poate fi și un mount point, — atunci trebuie să mergem pe server, să parsăm și să calculăm discul necesar. De asemenea, trigger-ul poate transmite adresa scsi sau alte informații. Dar sunt situații în care nu există indicii și trebuie să analizăm.
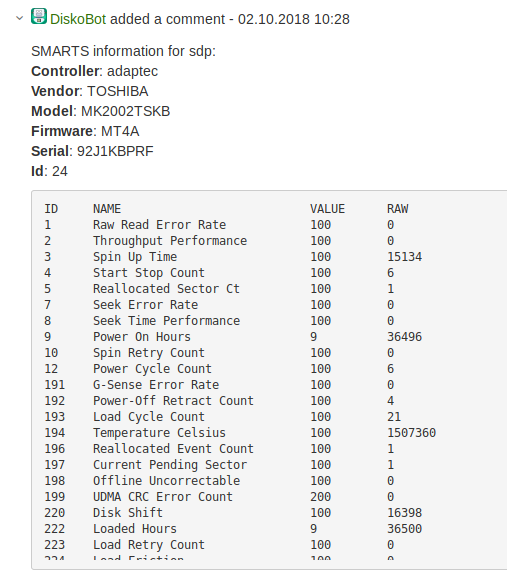
După ce am aflat numele dispozitivului de blocare, strângem informații despre tipul și dimensiunea discului pentru a completa câmpurile în Jira. De asemenea, obținem informații despre furnizor, model, firmware, ID, SMART, și totul acest lucru este inserat în comentariul tichetei Jira. Administratorului și inginerului nu le mai trebuie să caute aceste date. 🙂
prepare2change.yml
Scoate discul din rotație, pregătindu-l pentru înlocuire. Este cea mai complexă și responsabilă etapă. Aici este momentul în care poți opri aplicația când nu ar trebui oprită. Sau poți scoate discul de care lipseau replicile, afectând utilizatorii și pierzând unele date. Aici avem cele mai multe verificări și notificări în chat.
În cel mai simplu caz, este vorba despre eliminarea discului din HW/MD RAID.
În situații mai complexe (în sistemele noastre de stocare), când rezervarea se face la nivelul aplicației, trebuie să accedem la aplicație prin API, să raportăm despre scoaterea discului, să-l deactivăm și să inițiem restaurarea.
Acum migrăm masiv în , și dacă serverul este cloud, atunci Diskobot se adresează API-ului norului, spunând că intenționează să lucreze cu acest minion — serverul pe care sunt lansate containerele — și cere „migrează toate containerele de pe acest minion”. Și de asemenea, activează iluminarea discului, astfel încât inginerul să vadă imediat care trebuie scos.
changed.yml
După înlocuirea discului, în primul rând verificăm disponibilitatea acestuia.
Inginerii nu instalează întotdeauna discuri noi, așa că am adăugat o verificare a valorilor SMART care ne satisfac.
Ce atribute analizămNumărul sectoarelor reallocate (5) < 100
Numărul sectoarelor în așteptare (107) == 0
Dacă discul nu trece testul, inginerul este informat pentru o nouă înlocuire. Dacă totul este în regulă, lumina se stinge, se face marcajul și discul este introdus în rotație.
ready.yml
Cel mai simplu caz: verificarea sincronizării HW/SW raid sau finalizarea sincronizării datelor în aplicație.
API-ul aplicațiilor
Am menționat de câteva ori că botul se conectează adesea la API-ul aplicațiilor. Desigur, nu toate aplicațiile au avut metodele necesare, așa că a trebuit să le dezvoltăm. Iată cele mai importante metode pe care le utilizăm:
- Status. Starea cluster-ului sau discului, pentru a înțelege dacă este posibil să lucrăm cu el;
- Start/stop. Activarea/dezactivarea discului;
- Migrate/restore. Migrarea și restaurarea datelor în timpul și după înlocuire.
Experiență acumulată despre Ansible
Îmi place foarte mult Ansible. Dar adesea, când mă uit la diferite proiecte opensource și văd cum oamenii scriu playbook-uri, mă simt puțin speriat. Complexitatea logică din when/loop, lipsa flexibilității și idempotentității din cauza utilizării frecvente a shell/command.
Am decis să simplificăm totul, profitând de avantajul Ansible - modularitatea. La cel mai înalt nivel se află playbook-urile, care pot fi scrise de orice administrator sau dezvoltator extern care cunoaște puțin Ansible.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Dacă o logică este greu de implementat în playbook-uri, o extragem într-un modul sau filtrul Ansible. Scripturile pot fi scrise în Python sau în orice alt limbaj.
Se scriu ușor și rapid. De exemplu, modulul de iluminare a discului, exemplul de utilizare de mai sus, constă din 265 de linii.
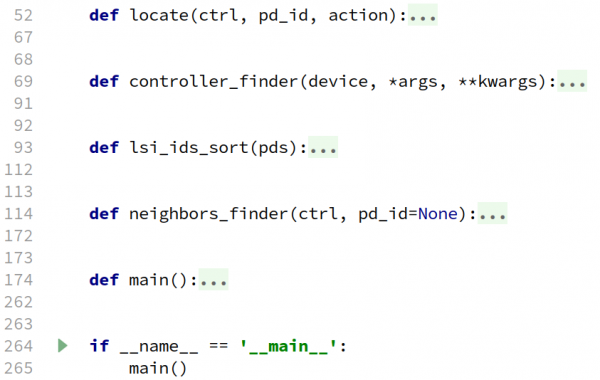
La cel mai de jos nivel se află biblioteca. Pentru acest proiect, am scris o aplicație separată, un fel de abstracție peste hard disk-urile și RAID-urile software, care execută cererile corespunzătoare.
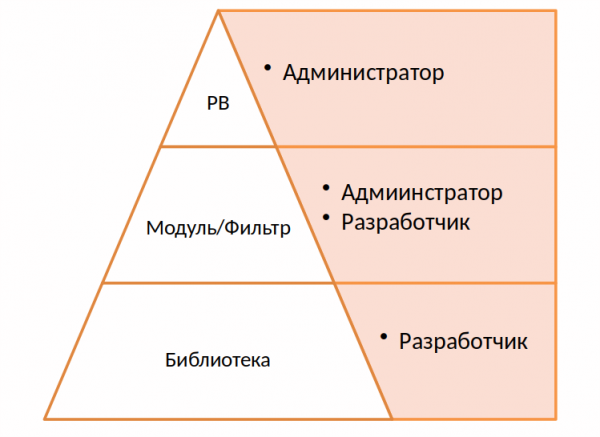
Cele mai puternice părți ale Ansible sunt simplitatea și playbook-urile clare. Cred că ar trebui să profitați de asta și să nu generați fișiere YAML înfricoșătoare și o mulțime de condiții, cod shell și bucle.
Dacă doriți să repetați experiența noastră cu API-ul Ansible, aveți în vedere două lucruri:
- Playbook_executor și, în general, playbook-ul nu poate fi transmis un timeout. Există un timeout pentru sesiunea ssh, dar nu pentru playbook. Dacă încercăm să deconectăm un disk care nu mai există în sistem, playbook-ul se va executa indefinit, de aceea a trebuit să învăluim execuția acestuia într-un wrapper separat și să îl oprim după un timeout.
- Ansible funcționează pe baza proceselor fork, așa că API-ul său nu este thread-safe. Executăm toate playbook-urile noastre într-un singur fir.
În final, am reușit să automatizăm înlocuirea a aproximativ 80 % dintre discuri. În general, viteza de înlocuire a crescut de două ori. Astăzi, administratorul doar se uită la incident și decide dacă trebuie să schimbe diskul sau nu, apoi face un singur clic.
Dar acum începem să ne confruntăm cu o altă problemă: unii administratori noi nu știu cum să schimbe discurile. 🙂
Sursa: habr.com
