

În sistemele mari de cloud, problema echilibrării automate sau a distribuirii sarcinii pe resursele computaționale este deosebit de acută. Această problemă a fost abordată și de Tionix (dezvoltator și operator de servicii cloud, parte a grupului de companii Rostelecom).
Și, având în vedere că platforma noastră principală de dezvoltare este Openstack, iar noi, ca toți oamenii, suntem lenți, s-a decis să alegem un modul gata făcut, care este deja inclus în platformă. Alegerea noastră a căzut pe Watcher, pe care am decis să-l folosim pentru nevoile noastre.
Pentru început, să ne clarificăm termenii și definițiile.
Termeni și definiții
Scop — este un rezultat final, vizibil și măsurabil, care trebuie atins. Pentru fiecare obiectiv există o sau mai multe strategii. O strategie este implementarea unui algoritm care poate găsi o soluție pentru acest obiectiv.
Acțiune (Action) — este o sarcină elementară care modifică starea curentă a resursei gestionate a clusterului OpenStack, precum: migrarea unei mașini virtuale (migration), modificarea stării de alimentare a nodului (change_node_power_state), modificarea stării serviciului nova (change_nova_service_state), modificarea flavor-ului (resize), înregistrarea unui mesaj NOP (nop), lipsa acțiunilor pe o anumită perioadă de timp — pauză (sleep), migrarea volumului (volume_migrate).
Plan de acțiune (Action Plan) — este un flux specific de acțiuni, desfășurat într-o anumită ordine pentru a atinge un obiectiv specific. Planul de acțiune conține, de asemenea, eficiența globală estimată cu un set de indicatori de performanță. Planul de acțiune este generat de Watcher după ce auditul a avut loc cu succes, iar strategia utilizată găsește o soluție pentru atingerea obiectivului. Planul de acțiune constă într-o listă de acțiuni secvențiale.
Audit (Audit) — este o solicitare pentru optimizarea clusterului. Optimizarea este efectuată pentru a atinge un obiectiv în acest cluster. Pentru fiecare audit de succes, Watcher generează un Plan de acțiune.
Domeniul auditului (Audit Scope) — este un set de resurse, în cadrul căruia se desfășoară auditul (zona(ile) de disponibilitate, agregatoarele de noduri, nodurile de calcul individuale sau nodurile de stocare etc.). Domeniul auditului este definit în fiecare șablon. Dacă domeniul auditului nu este specificat, se efectuează auditul întregului cluster.
Șablon de audit (Audit Template) — un set salvat de configurații pentru a lansa auditul. Șabloanele sunt necesare pentru a efectua repetat audite cu setări identice. Șablonul trebuie să conțină în mod obligatoriu obiectivul auditului; dacă strategiile nu sunt specificate, se aleg cele mai potrivite dintre strategiile existente.
Cluster (Cluster) — este un set de mașini fizice care oferă resurse de calcul, resurse de stocare și resurse de rețea și sunt gestionate de același nod de control OpenStack.
Modelul de date al clusterului (Cluster Data Model, CDM) — este o reprezentare logică a stării curente și a topologiei resurselor gestionate de cluster.
Indicator de eficacitate (Efficacy Indicator) — este un indicator care arată performanța soluției create prin această strategie. Indicatorii de eficacitate sunt specifici unui anumit obiectiv și sunt utilizați în mod obișnuit pentru a calcula eficiența globală a planului de acțiune final.
Specificarea eficacității (Efficacy Specification) — este un set de caracteristici specifice asociate fiecărui Obiectiv, care definește diferitele indicatori de eficacitate pe care strategia, care asigură îndeplinirea obiectivului corespunzător, trebuie să le furnizeze în soluția sa. Într-adevăr, fiecare soluție propusă de strategie va fi verificată în conformitate cu specificația înainte de a calcula eficiența sa globală.
Motorul de scorare (Scoring Engine) — este un fișier executabil, care are date de intrare clar definite, date de ieșire clar definite și execută o sarcină strict matematică. Astfel, calculul nu depinde de mediu în care este executat — va oferi același rezultat oriunde.
Planificatorul Watcher (Watcher Planner) — parte a mecanismului de luare a deciziilor Watcher. Acest modul primește un set de acțiuni, generate de strategie, și creează un plan de lucru care determină cum să planifice în timp aceste acțiuni diverse și, pentru fiecare acțiune, care sunt condițiile prealabile.
Obiectivele și strategiile Watcher
Scop
Strategii
Obiectiv fals
Strategie falsă
Strategie falsă folosind motoare de evaluare exemplare
Strategie falsă cu redimensionare
Economisirea energiei
Strategia de economisire a energiei
Consolidarea serverelor
Consolidarea serverelor offline de bază
Strategia de consolidare a sarcinilor de lucru VM
Echilibrarea sarcinilor de lucru
Strategia de migrare a echilibrului sarcinilor de lucru
Strategia de echilibrare a capacității de stocare
Stabilizarea sarcinilor de lucru
Vecin zgomotos
Vecin zgomotos
Optimizarea termică
Strategia bazată pe temperatura de ieșire
Optimizarea fluxului de aer
Strategia de migrare uniforme a fluxului de aer
Întreținerea hardware-ului
Migrarea zonei
Neclasificat
Actuator
Obiectiv fals — obiectiv rezervat, care este folosit pentru testare (reserved goal that is used for testing purposes).
Strategii conexe: Strategia falsă, Strategia falsă folosind motoare de evaluare exemplare și strategia falsă cu redimensionare. Strategia falsă — o strategie fictivă utilizată pentru testarea de integrare prin Tempest. Această strategie nu oferă vreo optimizare utilă, scopul său unic fiind utilizarea testelor Tempest.
Strategia falsă folosind motoare de evaluare exemplare — strategia este similară cu cea anterioară, diferența constând doar în utilizarea unui „motor de evaluare” exemplar, care face calcule folosind metode de învățare automată.
Strategia falsă cu redimensionare — strategia este similară cu cea anterioară, diferența constând doar în utilizarea schimbării flavor-ului (migrare și redimensionare).
Nu este utilizată în producție.
Economisirea energiei — a minimiza consumul de energie. Strategia obiectivului Saving Energy Strategy, împreună cu strategia VM Workload Consolidation Strategy (Consolidarea serverelor), poate îndeplini funcții de management dinamic al energiei (DPM), economisind electricitate prin consolidarea dinamică a sarcinilor de lucru chiar și în perioadele de încărcare scăzută a resurselor: mașinile virtuale sunt mutate pe un număr mai mic de noduri, iar nodurile neutilizate sunt oprite. După consolidare, strategia oferă o soluție pentru activarea/dezactivarea nodurilor conform parametrilor stabiliți: “min_free_hosts_num” — numărul de noduri libere activate care așteaptă sarcini, și “free_used_percent” — proporția nodurilor libere activate la numărul de noduri ocupate de mașini. Pentru ca strategia să funcționeze, trebuie să fie activat și configurat Ironic pentru a funcționa cu activarea/dezactivarea alimentării la noduri.
Parametrii strategiei
parameter
tipul
implicit
descriere
free_used_percent
Număr
10.0
raportul dintre numărul de noduri de calcul libere și numărul de noduri de calcul cu mașini virtuale
min_free_hosts_num
Int
1
numărul minim de noduri de calcul libere
În nor trebuie să existe cel puțin două noduri. Metoda utilizată este schimbarea stării de alimentare a nodului (change_node_power_state). Colectarea metricilor nu este necesară pentru strategie.
Consolidarea serverelor — minimizarea numărului de noduri de calcul (consolidare). Are două strategii: Basic Offline Server Consolidation și VM Workload Consolidation Strategy.
Strategia Basic Offline Server Consolidation minimizează numărul total de servere utilizate și de asemenea reduce migrarea.
Strategia de bază necesită următoarele metrici:
metrica
serviciu
pluginuri
comentariu
compute.node.cpu.percent
none
cpu_util
none
Parametrii strategiei: migration_attempts — numărul de combinații pentru a căuta potențiali candidați pentru oprire (implicit, 0, fără limite), period — intervalul de timp în secunde pentru a obține o agregare statică din sursa de date a metricii (implicit, 700).
Metodele utilizate: migrarea, schimbarea stării serviciului nova (change_nova_service_state).
Strategia VM Workload Consolidation Strategy se bazează pe un algoritm heuristic de tip first-fit, care se concentrează pe încărcătura măsurată a CPU și încearcă să minimizeze nodurile care au o încărcătură prea mare sau prea mică, având în vedere constrângerile de capacitate a resurselor. Această strategie oferă o soluție care duce la o utilizare mai eficientă a resurselor clusterei, folosind următoarele patru etape:
- Faza de descărcare — gestionarea resurselor excedente;
- Faza de consolidare — gestionarea resurselor insuficient utilizate;
- Optimizarea soluției — reducerea numărului de migrații;
- Dezactivarea nodurilor de calcul neutilizate.
Strategia necesită următoarele metrici:
metrica
serviciu
pluginuri
comentariu
memory
none
disk.root.size
none
Următoarele metrici nu sunt obligatorii, dar îmbunătățesc precizia strategiei, dacă sunt disponibile:
metrica
serviciu
pluginuri
comentariu
memory.resident
none
cpu_util
none
Parametrii strategiei: period — intervalul de timp în secunde pentru a obține o agregare statică din sursa de date a metricii (implicit, 3600).
Utilizează aceleași metode ca și strategia anterior. Detalii .
Echilibrarea sarcinilor de lucru — a echilibra sarcina de lucru între nodurile de calcul. Scopul are trei strategii: Workload Balance Migration Strategy, Workload stabilization, Storage Capacity Balance Strategy.
Strategia de migrare a echilibrului sarcinii de lucru inițiază migrarea mașinilor virtuale pe baza sarcinii de lucru a nodurilor de mașini virtuale. Decizia de transfer se ia de fiecare dată când % utilizarea CPU-ului sau RAM-ului nodului depășește pragul specificat. Mașina virtuală mutată trebuie să apropie nodul de sarcina medie de lucru a tuturor nodurilor.
Cerințe
- Utilizarea procesorilor fizici;
- Minimum două noduri de calcul fizice;
- Componenta Ceilometer instalată și configurată — ceilometer-agent-compute, care funcționează pe fiecare nod de calcul, și API-ul Ceilometer, precum și colectarea următoarelor metrice:
metrica
serviciu
pluginuri
comentariu
cpu_util
none
memory.resident
none
Parametrii strategiei:
parameter
tipul
implicit
descriere
metrics
String
'cpu_util'
Metricile de bază sunt: 'cpu_util', 'memory.resident'.
threshold
Număr
25.0
Pragul de sarcină de lucru pentru migrare.
period
Număr
300
Perioada totală de vreme a Ceilometer.
Metoda utilizată — migrare.
Stabilizarea sarcinii de lucru — strategia care se concentrează pe stabilizarea sarcinii de lucru folosind migrarea live. Strategia se bazează pe un algoritm de abatere standard și determină dacă există supraîncărcare în cluster și reacționează prin inițierea migrației mașinilor pentru a stabiliza clusterul.
Cerințe
- Utilizarea procesorilor fizici;
- Minimum două noduri de calcul fizice;
- Componenta Ceilometer instalată și configurată — ceilometer-agent-compute, care funcționează pe fiecare nod de calcul, și API-ul Ceilometer, precum și colectarea următoarelor metrice:
metrica
serviciu
pluginuri
comentariu
cpu_util
none
memory.resident
none
Strategia de echilibrare a capacității de stocare (strategia implementată începând cu Queens) — strategia mută discurile în funcție de încărcarea pool-urilor Cinder. Decizia de mutare se ia de fiecare dată când coeficientul de utilizare al pool-ului depășește pragul specificat. Discul mutat trebuie să apropie pool-ul de sarcina medie a tuturor pool-urilor Cinder.
Cerințe și restricții
- Minimum două pool-uri Cinder;
- Capacitatea de migrare a discurilor.
- Modelul de date al clusterului — colectorul modelului de date al clusterului Cinder.
Parametrii strategiei:
parameter
tipul
implicit
descriere
volume_threshold
Număr
80.0
Valoarea de prag a discurilor pentru echilibrarea volumelor.
Metoda utilizată — migrarea discului (volume_migrate).
Neighbor zgomotos — identificarea și mutarea 'vecinului zgomotos' — mașina virtuală cu prioritate mică ce afectează negativ performanța mașinii virtuale cu prioritate mare din punct de vedere IPC, utilizând excesiv Last Level Cache. Strategia proprie: Neighbor zgomotos (parametrul utilizat în strategie — cache_threshold (valoarea implicită — 35), când performanța scade la valoarea specificată, se inițiază migrarea. Pentru funcționarea strategiei sunt necesare metricile activate LLC (Last Level Cache), ultimul server Intel cu suport CMT, precum și colectarea următoarelor metrice:
metrica
serviciu
pluginuri
comentariu
cpu_l3_cache
none
Necesită Intel .
Modelul de date al clusterului (implicit): colectorul modelului de date Nova cluster. Metoda utilizată este migrarea.
Lucrul cu acest scop prin Dashboard nu este implementat complet în Queens.
Optimizarea termică — optimizarea regimului de temperatură. Temperatura la ieșire (aerul evacuat) este unul dintre cele mai importante sisteme de telemetrie termică pentru măsurarea stării asupra încărcării termice / de lucru a serverului. Există o strategie pentru acest scop — strategia bazată pe temperatura de ieșire, care ia decizii privind mutarea sarcinilor de lucru pe noduri cu un regim favorabil de temperatură (cea mai joasă temperatură la ieșire), atunci când temperatura la ieșire a gazdelor originale atinge pragul configurabil.
Pentru funcționarea strategiei este necesar un server cu Intel Power Node Manager instalat și configurat. , precum și colectarea următoarelor metrice:
metrica
serviciu
pluginuri
comentariu
hardware.ipmi.node.outlet_temperature
IPMI
Parametrii strategiei:
parameter
tipul
implicit
descriere
threshold
Număr
35.0
Pragul de temperatură pentru migrare.
period
Număr
30
Intervalul de timp în secunde pentru obținerea agregării statistice din sursa de date a metricelor.
Metoda utilizată — migrare.
Optimizarea fluxului de aer — optimizarea modului de ventilație. Strategia proprie — Uniform Airflow utilizând migrarea live. Strategia inițiază migrarea mașinii virtuale ori de câte ori fluxul de aer de la ventilatorul serverului depășește pragul specificat.
Pentru funcționarea strategiei sunt necesare:
- Hardware: noduri de calcul <cu suport pentru NodeManager 3.0;
- Cel puțin două noduri de calcul;
- Componenta ceilometer-agent-compute și Ceilometer API instalate și configurate pe fiecare nod de calcul, care pot raporta cu succes metricile precum fluxul de aer, puterea sistemului, temperatura la intrare:
metrica
serviciu
pluginuri
comentariu
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Pentru funcționarea strategiei este necesar un server cu Intel Power Node Manager 3.0 sau o versiune ulterioară instalat și configurat.
Restricții: Conceptul nu este destinat utilizării în producție.
Se recomandă utilizarea acestui algoritm cu audite continue, deoarece într-o singură iterație este planificată migrarea unei singure mașini virtuale.
Migrarea live este posibilă.
Parametrii strategiei:
parameter
tipul
implicit
descriere
threshold_airflow
Număr
400.0
Pragul de flux de aer pentru migrarea Unit este 0.1CFM
threshold_inlet_t
Număr
28.0
Pragul temperaturii la intrare pentru decizia de migrare
threshold_power
Număr
350.0
Pragul puterii sistemului pentru decizia de migrare
period
Număr
30
Intervalul de timp în secunde pentru obținerea agregării statistice din sursa de date a metricelor.
Metoda utilizată — migrare.
Întreținerea hardware-ului — întreținerea hardware-ului. Strategia asociată acestui obiectiv este migrările zonale. Această strategie este un instrument pentru migrarea eficientă, automată și minimă a mașinilor virtuale și a discurilor în cazul în care este necesară întreținerea hardware-ului. Strategia dezvoltă un plan de acțiune pe baza greutăților: un set de acțiuni cu o greutate mai mare va fi programat mai devreme decât altele. Există doi parametri de configurare: greutățile acțiunilor (action_weights) și paralelizarea (parallelization).
Limitări: este necesară configurarea greutăților acțiunilor și a paralelizării.
Parametrii strategiei:
parameter
tipul
implicit
descriere
noduri_calcul
array
None
Noduri de calcul pentru migrare.
piscine_stocare
array
None
Noduri de stocare pentru migrare.
total_parallel
integer
6
Numărul total de acțiuni care trebuie efectuate în paralel.
parallel_per_node
integer
2
Numărul de acțiuni efectuate simultan pentru fiecare nod de calcul.
parallel_per_pool
integer
2
Numărul de acțiuni efectuate simultan pentru fiecare piscină de stocare.
priority
obiect
None
Lista priorităților pentru mașinile virtuale și discuri.
with_attached_volume
boolean
False
Fals — mașinile virtuale vor fi transferate după ce toate discurile au fost mutate. Adevărat — mașinile virtuale vor fi transferate după migrarea tuturor discurilor atașate.
Elementele array-ului nodurilor de calcul:
parameter
tipul
implicit
descriere
src_node
string
None
Nodul de calcul de la care se transferă mașinile virtuale (obligatoriu).
dst_node
string
None
Nodul de calcul pe care se migrează mașinile virtuale.
Elementele array-ului de noduri de stocare:
parameter
tipul
implicit
descriere
src_pool
string
None
Piscina de stocare din care se transferă discurile (obligatoriu).
dst_pool
string
None
Piscina de stocare pe care se transferă discurile.
src_type
string
None
Tipul inițial al discului (obligatoriu).
dst_type
string
None
Tipul final al discului (obligatoriu).
Elementele de prioritizare a obiectelor:
parameter
tipul
implicit
descriere
project
array
None
Numele proiectelor.
nod_calcul
array
None
Numele nodurilor de calcul.
piscină_stocare
array
None
Numele piscinelor de stocare.
calcul
enum
None
Parametrii mașinii virtuale [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
storage
enum
None
Parametrii discurilor [“size”, “created_at”].
Metodele utilizate — migrarea mașinilor virtuale, migrarea discurilor.
Neclasificat — un obiectiv auxiliar utilizat pentru a facilita procesul de dezvoltare a strategiei. Nu conține specificații și poate fi utilizat ori de câte ori strategia nu este încă legată de un obiectiv existent. Acest obiectiv poate fi folosit și ca un pas intermediar. Strategia asociată acestui obiectiv este Actuator.
Crearea unui nou obiectiv
Watcher Decision Engine are un plugin de interfață "țintă externă", care permite integrarea unei ținte externe, care poate fi atinsă printr-o strategie.
Înainte de a crea un nou obiectiv, asigurați-vă că niciunul dintre obiectivele existente nu se potrivește nevoilor dumneavoastră.
Crearea unui nou plugin
Pentru a crea un nou obiectiv, trebuie să extindeți clasa obiectivului, implementând metoda clasei get_name () pentru a returna identificatorul unic al noului obiectiv pe care doriți să-l creați. Acest identificator unic trebuie să corespundă cu numele punctului de intrare pe care îl declarați mai târziu.
Apoi, trebuie să implementați metoda clasei get_display_name () pentru a returna numele de afișare tradus al obiectivului pe care doriți să-l creați (nu folosiți o variabilă pentru a returna șirul tradus, astfel încât să poată fi construit automat de instrumentul de traducere.).
Implementați metoda clasei get_translatable_display_name (), pentru a returna cheia de traducere (de fapt, numele de afișare în engleză) al noului dumneavoastră obiectiv. Valoarea returnată trebuie să corespundă cu șirul tradus în get_display_name ().
Implementați metoda sa get_efficacy_specification (), pentru a returna specificația de eficacitate pentru obiectivul dumneavoastră. Metoda get_efficacy_specification () returnează o instanță Unclassified (), furnizată de Watcher. Această specificație de eficacitate este utilă în procesul de dezvoltare a obiectivului dumneavoastră, deoarece corespunde unei specificații goale.
→
Arhitectura Watcher (mai multe detalii ).
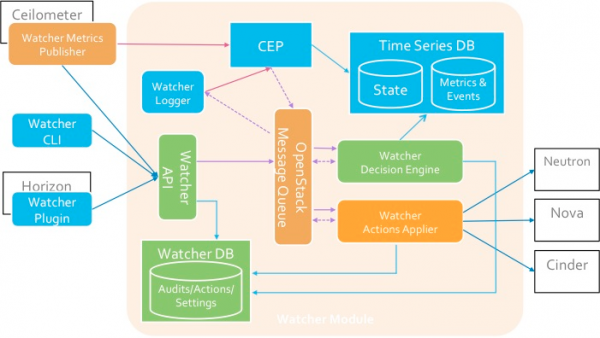
Componente
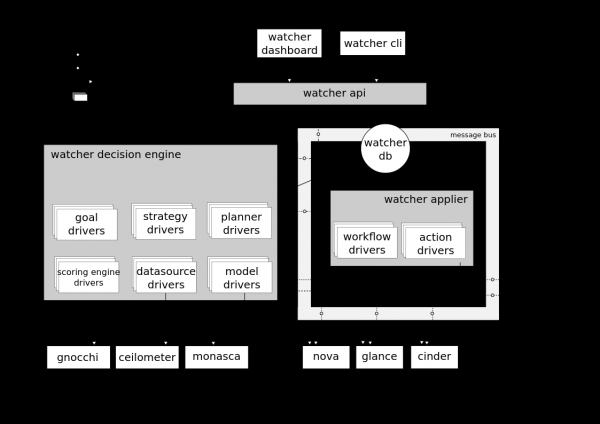
Watcher API — un component care implementează REST API, furnizat de Watcher. Mecanisme de interacțiune: CLI, plugin Horizon, Python SDK.
Watcher DB — baza de date Watcher.
Watcher Applier — un component care implementează execuția planului de acțiune creat de componenta Watcher Decision Engine.
Watcher Decision Engine — un component care se ocupă cu calcularea unui set de acțiuni potențiale de optimizare pentru a îndeplini obiectivul auditului. Dacă strategia nu este specificată, componenta alege cea mai potrivită.
Watcher Metrics Publisher — un component care colectează și calculează anumite metrice sau evenimente și le publică în punctul final CEP. Funcționalitatea componentului poate fi furnizată și de publicatorul Ceilometer.
Complex Event Processing (CEP) Engine — motorul de procesare complexă a evenimentelor. Din motive de performanță, pot exista mai multe instanțe ale CEP Engine care funcționează simultan, fiecare procesând un anumit tip de metrică / evenimente. În sistemul Watcher, CEP declanșează două tipuri de acțiuni: — scrierea evenimentelor / metricilor corespunzătoare în baza de date a seriilor temporale; — trimiterea evenimentelor corespunzătoare către componenta Watcher Decision Engine, atunci când acest eveniment poate influența rezultatul strategiei curente de optimizare, deoarece clusterul Openstack nu este un sistem static.
Interacțiunea componentelor se realizează prin protocolul AMQP.
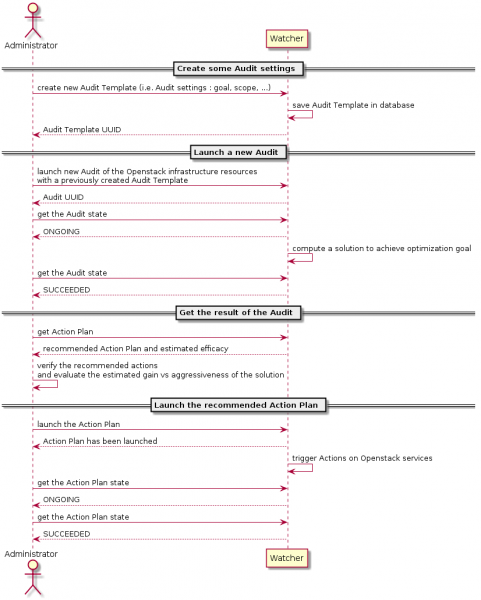
→
Schema de interacțiune cu Watcher
Rezultatele testării Watcher
- Pe pagina Optimization — Action plans apare eroarea 500 (atât pe Queens curat, cât și pe standul cu modulele Tionix), apare doar după ce auditul este pornit și se generează planul de acțiune; deschiderea goală funcționează normal.
- Pe fila Action details apar erori, nu se poate obține ținta și strategia auditului (atât pe Queens curat, cât și pe standul cu modulele Tionix).
- Auditurile cu ținta Dummy (teste) sunt create și lansate normal, planurile de acțiune sunt generate.
- Auditurile cu ținta Unclassified nu sunt create, deoarece ținta nu este funcțională și este destinată configurării intermediare la crearea de noi strategii.
- Auditurile cu ținta Workload Balancing (strategia Storage Capacity balance) sunt create cu succes, însă planul de acțiune nu este generat. Optimizarea pool-urilor de stocare nu este necesară.
- Auditurile cu ținta Workload Balancing (strategia Workload Balance Migration Strategy) sunt create cu succes, însă planul de acțiune nu este generat.
- Auditurile cu ținta Workload Balancing (strategia Workload Stabilization Strategy) se finalizează cu eroare.
- Auditurile cu ținta Noisy Neighbor sunt create cu succes, însă planul de acțiune nu este generat.
- Auditurile cu ținta Hardware maintenance sunt create cu succes, planul de acțiune nu este generat complet (sunt generate metricile de performanță, dar nu este generat lista efectivă de acțiuni).
- Modificările din configurațiile nova.conf (în secțiunea default compute_monitors = cpu.virt_driver) pe nodurile de calcul și de control nu corectează erorile.
- Auditurile cu ținta Server Consolidation (strategia Basic) se finalizează de asemenea cu eroare.
- Auditurile cu ținta Server Consolidation (strategia VM workload consolidation) se finalizează cu eroare. În jurnale apare o eroare la obținerea datelor sursă. Discuția despre eroare, în special, .
Am încercat să modificăm fișierul de configurare Watcher (nu a ajutat — rezultatul fiind erori pe toate paginile de Optimizare, revenirea la conținutul inițial al fișierului de configurare nu repară situația):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Auditurile pentru Saving Energy se finalizează cu o eroare. Conform jurnalelor, problema se află în lipsa Ironic, nu va funcționa fără serviciul baremetal.
- Auditurile pentru Thermal Optimization se finalizează cu o eroare. Traceback-ul este același ca pentru Server Consolidation (strategia VM workload consolidation) (eroare de date de intrare)
- Auditurile pentru Airflow Optimization se finalizează cu o eroare.
De asemenea, se întâlnesc următoarele erori la finalizarea auditului. Traceback-ul din jurnalul decision-engine.log (starea cluster-ului nu este definită).
→ Discuția despre eroare
Concluzie
Rezultatul cercetărilor noastre de două luni este concluzia clară că, pentru a obține un sistem de balansare a încărcării complet funcțional, va trebui să ne ocupăm serios de îmbunătățirea instrumentelor pentru platforma Openstack.
Watcher s-a dovedit a fi un produs serios și în rapidă dezvoltare cu un potențial enorm, pentru a fi utilizat pe deplin necesitând o muncă considerabilă și serioasă.
Dar despre asta — în articolele următoare ale ciclului.
Sursa: habr.com
