

Am proiectat cu succes structura bazei noastre de date PostgreSQL pentru stocarea corespondenței, a trecut un an, utilizatorii o umplu activ, iată că în ea deja sunt milioane de înregistrări, și… ceva începe să deraieze.
- Partea 2: secționăm «în timp real»
Se întâmplă că odată cu creșterea volumului tabelului, «adâncimea» indicilor crește — deși logarithmic. Dar, în timp, acest lucru forțează serverul să proceseze mult mai multe pagini de date decât la început., ceea ce face ca sarcinile de citire/scriere
să necesite din ce în ce mai multă capacitate. Aici intervine.
separarea Voi menționa că nu ne referim la sharding, adică distribuirea datelor între diferite baze de date sau servere. Pentru că, chiar și împărțind datele pe mai multe
servere, nu veți scăpa de problema «creșterii» indicilor în timp. Este clar că, dacă vă puteți permite să adăugați un server nou în fiecare zi, atunci problemele dvs. vor fi deja cu totul diferite față de o bază de date specifică.
Concept
Noi vom analiza nu scripturi specifice pentru implementarea separării «în hardware», ci abordarea în sine — ce și cum ar trebui «tăiat în felii», și la ce duce acest deziderat.
Să ne definim din nou obiectivul: vrem să facem astfel încât astăzi, mâine și peste un an cantitatea de date PostgreSQL citite în timpul oricărei operațiuni de citire/scriere să rămână aproximativ constantă. Pentru orice date acumulate cronologic (mesaje, documente, jurnal, arhive,…) alegerea naturală a cheii de separare estedata/ora evenimentului . În cazul nostru, acest eveniment este.
momentul trimiterii mesajului Să observăm că utilizatorii lucrează aproape întotdeauna doar cu aceste «recente»
date — citesc ultimele mesaje, analizează ultimele jurnale,... Nu, desigur, pot să parcurgă și mai în urmă în timp, dar o fac foarte rar. Dintre aceste restricții, devine evident că soluția optimă pentru mesaje va fi separații «zilnice»
— căci aproape întotdeauna utilizatorul nostru va citi ceea ce a primit «astăzi» sau «ieri». Dacă în decursul zilei scriem și citim aproape exclusiv într-o singură secțiune, aceasta ne oferă și o utilizare mai eficientă a memoriei și discului
— dat fiind că toate indicațiile secțiunii se încadrează cu ușurință în RAM, spre deosebire de «cele mari și greoaie» din întreaga tabelă.
În general, tot ce s-a spus mai sus sună ca un profit constant. Și este realizabil, dar pentru asta va trebui să muncim mult — pentru că decizia de a secționa una dintre entități determină necesitatea de a „tăia” și entitățile asociate.
Mesajul, proprietățile sale și proiecțiile
Dacă am decis să împărțim mesajele pe baza datelor, atunci și entitățile-proprietăți dependente de acestea (fișierele atașate, lista de destinatari) este logic să le împărțim și de asemenea, în funcție de data mesajului.
Deoarece una dintre sarcinile noastre tipice este tocmai vizualizarea registrelor de mesaje (necitite, în curs, toate), este logic să le „încadrăm” și în secționarea pe baza datelor mesajelor.
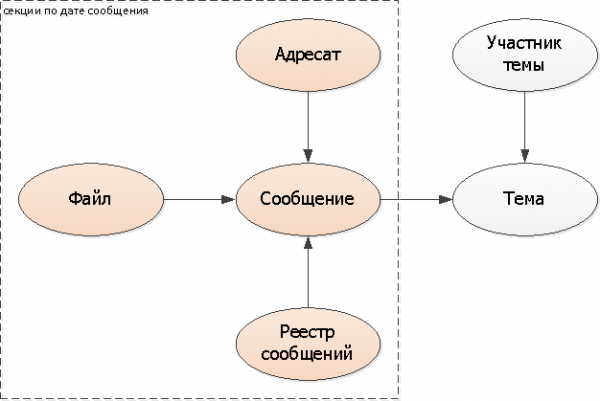
Adăugăm cheia de secționare (data mesajului) în toate tabelele: destinatari, fișier, registre. În mesajul în sine nu este necesar să adăugăm, ci să utilizăm data și ora existentă.
Subiecte
Deoarece subiectul se referă la mai multe mesaje, nu îl putem „tăia” în același model, trebuie să ne bazăm pe altceva. În cazul nostru, data primului mesaj în corespondență este perfectă — adică momentul creării, de fapt, a subiectului. Adăugăm cheia de secționare (data subiectului) în toate tabelele: subiect, participant.
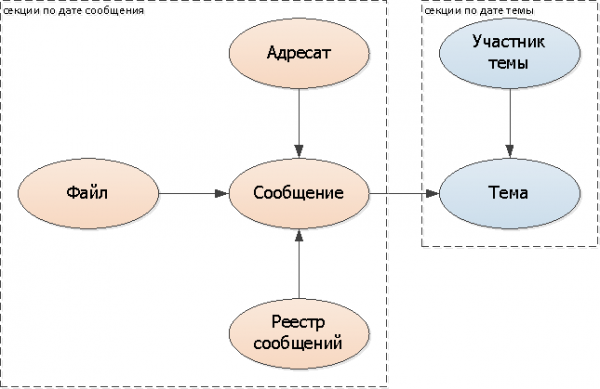
Dar acum avem imediat două probleme:
în ce secțiune căutăm mesajele pe subiect?
- în ce secțiune căutăm subiectul din mesaj?
- Desigur, putem continua să căutăm în toate secțiunile, dar asta va fi foarte trist și va anula toate câștigurile noastre. Prin urmare, pentru a ști exact unde să căutăm, vom face linkuri logice/indicii pe secțiuni:
în mesaj vom adăuga
- un câmp cu data subiectului la subiect vom adăuga
- un set de date ale mesajelor acelei corespondențe (poate fi o tabelă separată sau un array de date) Deoarece modificările listei de date ale mesajelor pentru fiecare corespondență în parte vor fi puține (deoarece aproape toate mesajele apar în 1-2 zile consecutive), mă voi opri exact la această variantă.
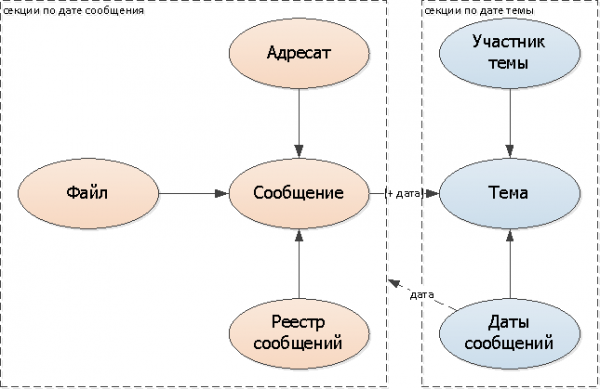
În total, structura bazei noastre a luat următoarea formă având în vedere secționarea:
Tabele: RU, celor care au aversiune față de chirilice în numele tabelurilor/câmpurilor mai bine să nu se uite
Tabele : RO, dacă ai aversiune față de chirilică în denumirile tabelelor/câmpurilor, mai bine să nu te uiți.
-- secțiuni după data mesajului
CREATE TABLE "Mesaj_YYYYMMDD"(
  "Mesaj"
    uuid
      PRIMARY KEY
, "Subiect"
    uuid
, "DataSubiect"
    date
, "Autor"
    uuid
, "DataTimp" -- utilizăm ca dată
    timestamp
, "Text"
    text
);

CREATE TABLE "Destinatar_YYYYMMDD"(
  "DataMesajului"
    date
, "Mesaj"
    uuid
, "Persoană"
    uuid
, PRIMARY KEY("Mesaj", "Persoană")
);

CREATE TABLE "Fișier_YYYYMMDD"(
  "DataMesajului"
    date
, "Fișier"
    uuid
      PRIMARY KEY
, "Mesaj"
    uuid
, "BLOB"
    uuid
, "Nume"
    text
);

CREATE TABLE "RegistruMesaje_YYYYMMDD"(
  "DataMesajului"
    date
, "Proprietar"
    uuid
, "TipRegistru"
    smallint
, "DataTimp"
    timestamp
, "Mesaj"
    uuid
, PRIMARY KEY("Proprietar", "TipRegistru", "Mesaj")
);
CREATE INDEX ON "RegistruMesaje_YYYYMMDD"("Proprietar", "TipRegistru", "DataTimp" DESC);

-- secțiuni după data subiectului
CREATE TABLE "Subiect_YYYYMMDD"(
  "DataSubiect"
    date
, "Subiect"
    uuid
      PRIMARY KEY
, "Document"
    uuid
, "Denumire"
    text
);

CREATE TABLE "ParticipantSubiect_YYYYMMDD"(
  "DataSubiect"
    date
, "Subiect"
    uuid
, "Persoană"
    uuid
, PRIMARY KEY("Subiect", "Persoană")
);

CREATE TABLE "DateMesajeSubiect_YYYYMMDD"(
  "DataSubiect"
    date
, "Subiect"
    uuid
      PRIMARY KEY
, "Data"
    date
);
Economisim o măsură
Ei bine, dacă nu folosim bazată pe distribuția valorilor câmpului (prin trigers și moștenire sau PARTITION BY), ci «manual» la nivel de aplicație, se poate observa că valoarea cheii de secționare este deja păstrată în numele acelei tabele.
De aceea, dacă îți pasă atât de mult de volumul datelor stocate, poți renunța la aceste „câmpuri în plus” și să te adresezi direct unor tabele specifice. Totuși, toate selecțiile din mai multe secțiuni în acest caz vor trebui mutate în cadrul aplicației.
Sursa: habr.com
