

Esenta povestirii despre cel mai popular manager de pachete pentru Kubernetes ar putea fi ilustrată cu ajutorul emoji-ului:
- cutie — acesta este Helm (cea mai potrivită reprezentare din ultima versiune Emoji);
- lacăt — securitate;
- omuleț — soluția problemelor.
În realitate, lucrurile vor fi puțin mai complicate, iar povestea este plină de detalii tehnice despre cum să faci Helm sigur.
- Pe scurt, ce este Helm, dacă nu știai sau ai uitat. Ce probleme rezolvă și unde se află în ecosistem.
- Să analizăm arhitectura Helm. Nicio discuție despre securitate și despre cum să faci un instrument sau o soluție mai sigură nu poate ocoli înțelegerea arhitecturii componentelor.
- Să discutăm despre componentele Helm.
- Cea mai arzătoare întrebare — viitorul — noua versiune Helm 3.
Tot ce este în acest articol se referă la Helm 2. Această versiune este acum în producție și este probabil că exact aceasta o folosești acum, iar în ea există amenințări la adresa securității.
Despre vorbitor: Alexandru Haërov () are 10 ani de experiență în dezvoltare, ajutând la îmbunătățirea conținutului și s-a alăturat comitetului . În prezent lucrează la Chainstack ca lider de dezvoltare — acesta este un hibrid între un șef de dezvoltare și o persoană care se ocupă de livrarea versiunilor finale. Adică se află pe frontul de luptă, unde se întâmplă totul, de la crearea produsului până la exploatarea acestuia.
Chainstack este un start-up mic, în creștere rapidă, cu scopul de a oferi clienților posibilitatea să uite de infrastructură și de dificultățile operării aplicațiilor descentralizate, echipa de dezvoltare fiind în Singapore. Nu cereți Chainstack să vândă sau să cumpere criptovalută, ci propuneți să discutați despre cadrele blockchain pentru întreprinderi, iar vă vor răspunde cu plăcere.
Helm
Acesta este un manager de pachete (charturi) pentru Kubernetes. Cea mai clară și versatilă modalitate de a aduce aplicații în clusterul Kubernetes.
Este vorba, desigur, de o abordare mai structurată și industrială decât crearea propriilor manifesturi YAML și scrierea unor mici utilitare.
Helm este cel mai bun lucru disponibil și popular în prezent.
De ce Helm? În primul rând, pentru că este susținut de CNCF. Cloud Native este o organizație mare, care este compania-mamă pentru proiectele Kubernetes, etcd, Fluentd și altele.
Un alt fapt important este că Helm este un proiect foarte popular. Când în ianuarie 2019 am început să mă gândesc să povestesc despre cum să fac Helm sigur, proiectul avea o mie de stele pe GitHub. Până în mai, numărul lor a ajuns la 12 mii.
Mulți sunt interesați de Helm, așa că, chiar dacă nu îl folosești încă, cunoștințele despre securitatea sa îți vor fi utile. Securitatea este importantă.
Echipa principală a lui Helm este susținută de Microsoft Azure, ceea ce îl face un proiect destul de stabil în comparație cu multe altele. Lansarea Helm 3 Alpha 2 în mijlocul lunii iulie demonstrează că multe persoane lucrează la proiect și au dorința și resursele necesare pentru a dezvolta și îmbunătăți Helm.
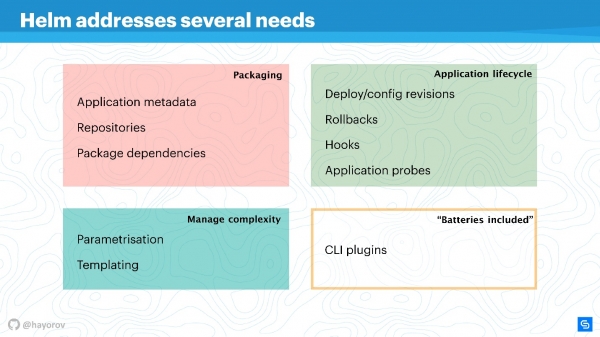
Helm abordează câteva probleme fundamentale în gestionarea aplicațiilor în Kubernetes.
- Împachetarea aplicației. Chiar și un aplicație de tip „Hello, World” pe WordPress reprezintă deja câteva servicii, iar dorința este de a le împacheta împreună.
- Gestionarea complexității care apare cu managementul acestor aplicații.
- Ciclul de viață care nu se încheie după instalarea sau implementarea aplicației. Aceasta continuă să existe, trebuie să fie actualizată, iar Helm ajută la acest lucru și se străduiește să aducă măsurile și politicile corecte pentru gestionarea sa.
Împachetare este organizată într-un mod clar: există metadate conform funcționării unui manager de pachete obișnuit pentru Linux, Windows sau MacOS. Cu alte cuvinte, repository, dependențe de diferite pachete, informații meta pentru aplicații, configurări, particularități de configurare, indexarea informațiilor etc. Toate acestea sunt posibile datorită lui Helm.
Gestionarea complexității. Dacă ai multe aplicații similare, este necesară parametrazarea. Din aceasta rezultă șabloanele, dar pentru a nu inventa o modalitate proprie de a crea șabloane, poți folosi ce oferă Helm din start.
Gestionarea ciclului de viață al aplicației — din punctul meu de vedere, aceasta este cea mai interesantă și nerezolvată problemă. Aceasta este motivul pentru care am venit la Helm în trecut. Trebuia să monitorizăm ciclul de viață al aplicației, voiam să ne transferăm CI/CD-ul și ciclurile aplicațiilor în această paradigmă.
Helm permite:
- gestionarea implementărilor, introduce conceptul de configurație și revizuire;
- executarea rollback-urilor cu succes;
- utilizarea hook-urilor pentru diferite evenimente;
- adăugarea de verificări suplimentare pentru aplicații și reacția la rezultatele acestora.
În plus, Helm are „baterii” — o mulțime de lucruri delicioase care pot fi incluse sub formă de plugin-uri, simplificându-ți viața. Plugin-urile pot fi scrise de tine însuți, sunt destul de izolate și nu necesită o arhitectură complexă. Dacă vrei să realizezi ceva, îți recomand să o faci sub formă de plugin, iar apoi, poate, să-l incluzi în upstream.
Helm se bazează pe trei concepte fundamentale:
- Chart Repo — o descriere și un set de parametrii posibili pentru manifestul tău.
- Configurație — adică valorile care vor fi aplicate (text, valori numerice etc.).
- Release reunește cele două componente de sus, iar împreună acestea devin un Release. Releas-urile pot fi versiune, obținând astfel organizarea ciclului de viață: mic la momentul instalării și mare la momentul upgrade-ului, downgrade-ului sau rollback-ului.
Arhitectura Helm
În schemă este reflectată arhitectura de înalt nivel a Helm.
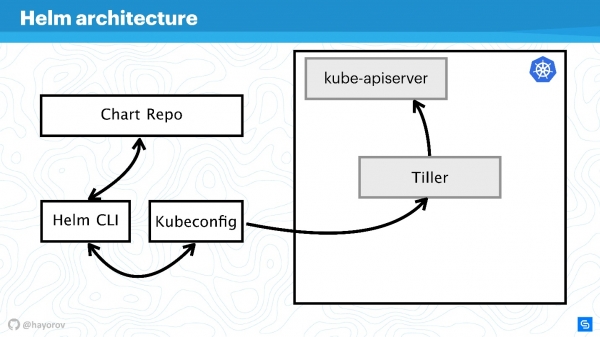
Amintesc că Helm este legat de Kubernetes. De aceea, nu putem să ne descurcăm fără un cluster Kubernetes (dreptunghiul). Componenta kube-apiserver se află pe master. Fără Helm, avem Kubeconfig. Helm aduce un mic binar, dacă pot să-l numesc așa, utilitar Helm CLI, care se instalează pe computer, laptop, mainframe — pe orice.
Dar aceasta nu este suficient. Helm are un component server numit Tiller. El reprezintă interesele Helm în interiorul cluster-ului, fiind o aplicație în interiorul cluster-ului Kubernetes, la fel ca oricare alta.
Următoarea componentă Chart Repo este un repository cu chart-uri. Există un repository oficial, iar poate exista un repository privat al unei companii sau proiect.
Interacțiune
Să examinăm cum interacționează componentele arhitecturii atunci când dorim să instalăm o aplicație folosind Helm.
- Spunem
Helm install, ne adresăm repository-ului (Chart Repo) și primim Helm chart-ul.
- Utilitarul Helm (Helm CLI) interacționează cu Kubeconfig pentru a determina la ce cluster să se adreseze.
- Obținând această informație, utilitarul se adresează lui Tiller, care se află în cluster-ul nostru, ca la o aplicație.
- Tiller se adresează lui Kube-apiserver pentru a efectua acțiuni în Kubernetes, pentru a crea anumite obiecte (servicii, pod-uri, replici, secrete etc.).
Apoi vom complica schema pentru a vedea vectorul de atacuri la care poate fi expusă întreaga arhitectură Helm. Apoi, vom încerca să o protejăm.
Vectorul de atacuri
Prima potențială slăbiciune — API-ul privilegiat—utilizatorÎn cadrul schemei, acesta este un hacker care a obținut acces administrativ la Helm CLI.
Utilizator API neprioritar poate reprezenta, de asemenea, un pericol, dacă se află în apropiere. Acest utilizator va avea un alt context, de exemplu, poate fi fixat într-un anumit namespace al cluster-ului în setările Kubeconfig.
Cea mai interesantă vector de atac poate fi procesul care se află în cluster undeva aproape de Tiller și poate comunica cu acesta. Acesta poate fi un server web sau un microserviciu care vede mediul de rețea al cluster-ului.
O variantă exotică, dar în creștere, a atacului este legată de Chart Repo. Un chart creat de un autor rău intenționat poate conține resurse nesigure, iar tu le vei executa, având încredere în ele. Sau acesta poate înlocui chart-ul pe care îl descarci din depozitul oficial și, de exemplu, poate crea o resursă sub formă de politici și astfel să își escaladeze accesul.
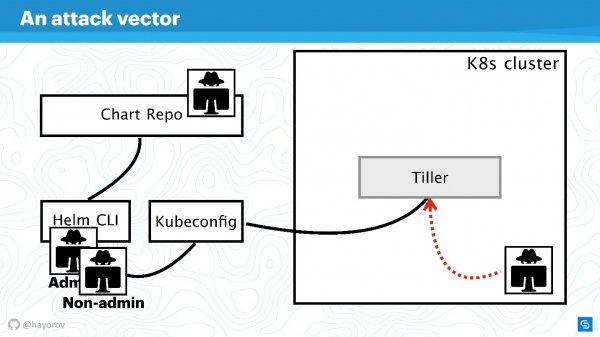
Să încercăm să ne apărăm de atacuri din cele patru părți și să analizăm unde sunt probleme în arhitectura Helm și unde, posibil, nu sunt.
Să extindem schema, să adăugăm mai multe elemente, dar să păstrăm toate componentele de bază.
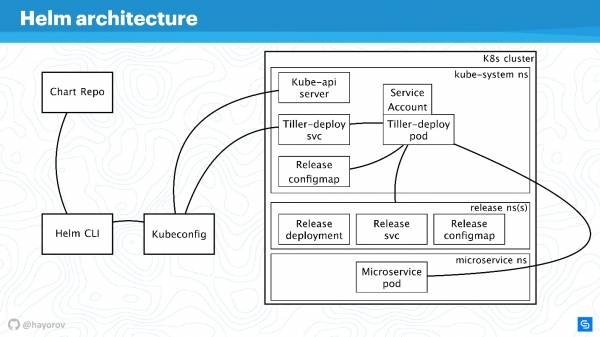
Helm CLI comunică cu Chart Repo, interacționează cu Kubeconfig, iar munca este transmisă în cluster către componenta Tiller.
Tiller este reprezentat de două obiecte:
- Serviciul Tiller-deploy, care expune un anumit serviciu;
- Pod-ul Tiller-deploy (în schema, într-un singur exemplar într-o replică), pe care rulează întreaga sarcină și care comunică cu cluster-ul.
Se folosesc diferite protocoale și scheme pentru interacțiune. Din perspectiva securității, cel mai interesant pentru noi este:
- Mecanismul prin care Helm CLI accesează chart repo: ce protocol, există autentificare și ce se poate face în această privință.
- Protocolul prin care Helm CLI, folosind kubectl, comunică cu Tiller. Acesta este un server RPC, instalat în interiorul cluster-ului.
- Tiller însuși este accesibil pentru microserviciile care se află în cluster și interacționează cu Kube-apiserver.
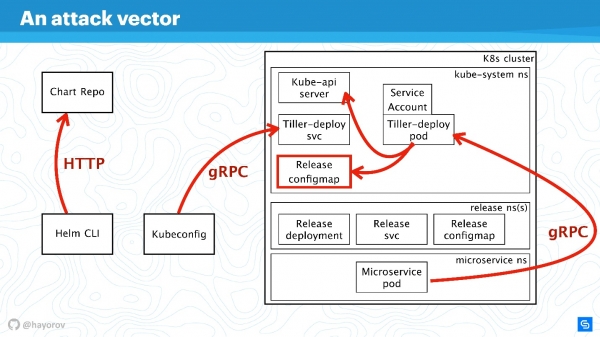
Să discutăm toate aceste direcții în ordine.
RBAC
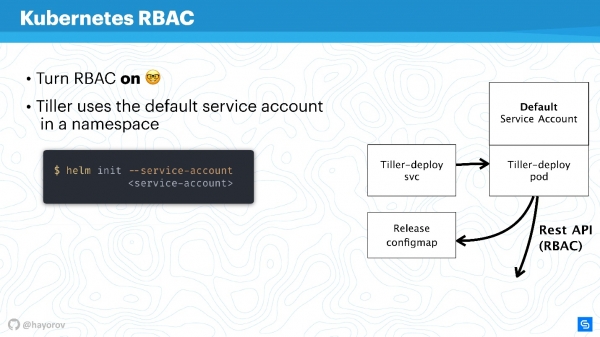
Este inutil să discutăm despre vreo securitate a Helm sau a altui serviciu din cluster, dacă RBAC nu este activat.
Se pare că nu este cea mai nouă recomandare, dar sunt sigur că mulți nu au activat încă RBAC chiar și în producție, deoarece este complicat și necesită multe configurații. Cu toate acestea, vă îndemn să o faceți.
— site avocat pentru RBAC. Aici este adunată o mulțime de materiale interesante care te vor ajuta să configurezi RBAC, îți vor arăta de ce este bun și cum să trăiești cu el în producție.
Voi încerca să explic cum funcționează Tiller și RBAC. Tiller lucrează în interiorul clusterului sub un anumit cont de serviciu. De obicei, dacă RBAC nu este configurat, acesta va fi superutilizator. În configurația de bază, Tiller va fi administrator. De aceea, se spune adesea că Tiller este un tunel SSH către clusterul tău. În realitate, așa este, așa că poți folosi un cont de serviciu specializat în loc de Default Service Account în schema de mai sus.
Când inițializezi Helm, instalându-l pentru prima dată pe server, poți specifica contul de serviciu folosind --service-account. Acest lucru va permite utilizarea unui utilizator cu setul minim necesar de permisiuni. Cu toate acestea, va trebui să creezi o astfel de „ghirlandă”: Role și RoleBinding.
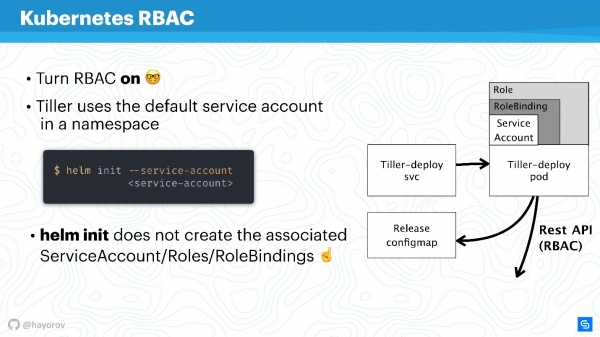
Din păcate, Helm nu va face acest lucru pentru tine. Fie tu, fie administratorul Kubernetes al clusterului trebuie să pregătiți în prealabil un set de Role, RoleBinding pentru contul de serviciu pentru a-l transmite Helm.
Se ridică întrebarea — care este diferența dintre Role și ClusterRole? Diferența este că ClusterRole acționează pentru toate namespace-urile, spre deosebire de rolurile și RoleBinding-urile obișnuite, care funcționează doar pentru un namespace specializat. Poți configura politici atât pentru întregul cluster și toate namespace-urile, cât și personalizate pentru fiecare namespace în parte.
Merită menționat că RBAC rezolvă și o altă problemă majoră. Mulți se plâng că Helm, din păcate, nu este multitenant (nu suportă multi-arendare). Dacă mai multe echipe consumă clusterul și folosesc Helm, este imposibil să configurăm politicile și să delimităm accesul lor în cadrul acestui cluster, deoarece există un anumit cont de serviciu din care funcționează Helm, și acesta creează toate resursele în cluster din acest cont, ceea ce uneori este foarte inconvenient. Așa este — ca fișierul binar în sine, ca proces, Helm Tiller nu are noțiunea de multitenancy..
Cu toate acestea, există o modalitate minunată care permite să lansezi Tiller în cluster de mai multe ori. Cu aceasta nu sunt probleme, Tiller poate fi lansat în fiecare namespace. Astfel, poți profita de RBAC, Kubeconfig ca pe un context și să limitezi accesul la Helm specializat.
Asta va arăta astfel.
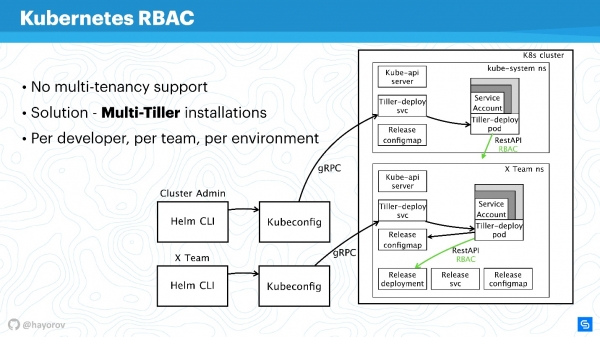
De exemplu, există două Kubeconfig cu context pentru echipe diferite (două namespace): Echipa X pentru echipa de dezvoltare și clusterul de admin. Clusterul de admin are un Tiller mai larg, care se află în spațiul Kube-system namespace, având astfel un service-account avansat. Și un namespace separat pentru echipa de dezvoltare, ei vor putea să își desfășoare serviciile în namespace-ul special.
Aceasta este o abordare viabilă, Tiller nu este atât de consumator pentru a afecta semnificativ bugetul dumneavoastră. Este una dintre soluțiile rapide.
Nu ezitați să configurați separat Tiller și să furnizați Kubeconfig cu context pentru echipă, pentru un anumit dezvoltator sau pentru mediu: Dev, Staging, Production (este puțin probabil ca toate să fie pe un singur cluster, dar se poate face așa).
Continuând povestea noastră, vom schimba subiectul de la RBAC și vom vorbi despre ConfigMaps.
ConfigMaps
Helm folosește ConfigMaps ca depozit de date. Când am vorbit despre arhitectură, nu exista o bază de date în care să fie stocate informațiile despre eliberări, configurații, rollbacks etc. Pentru aceasta se folosesc ConfigMaps.
Problema principală cu ConfigMaps este bine cunoscută — ele sunt nesigure în principiu, în ele nu este posibil să stochezi date sensibile. Este vorba despre tot ce nu ar trebui să iasă din serviciu, de exemplu, parolele. Cea mai nativă metodă pentru Helm acum este trecerea de la utilizarea ConfigMaps la secrete.
Se face foarte simplu. Suprascrieți configurația Tiller și specificați că depozitul va fi secretele. Atunci, pentru fiecare desfășurare veți primi nu ConfigMap, ci un secret.
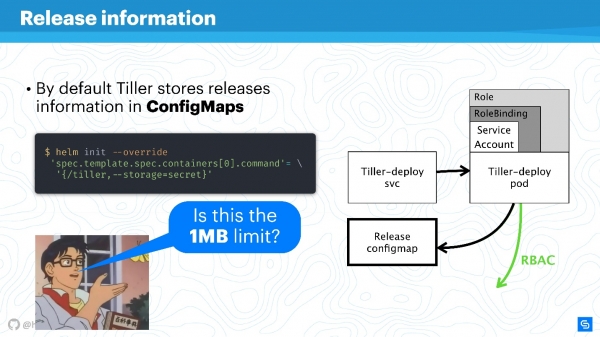
Puteți obiecta că secretele în sine sunt o conceptie ciudată și că nu este foarte sigur. Totuși, trebuie să înțelegeți că acest lucru este gestionat de dezvoltatorii Kubernetes. Începând cu versiunea 1.10, adică de ceva vreme, există posibilitatea, cel puțin în cloudurile publice, de a conecta depozitul corect pentru stocarea secretelor. Acum, echipa lucrează pentru a distribui mai bine accesul la secrete, anumitor poduri sau alte entități.
Storage Helm ar trebui să treacă la secrete, iar acestea, la rândul lor, să fie centralizate în siguranță.
Desigur, va rămâne o limită pentru stocarea datelor de 1 MB. Helm folosește etcd ca stocare distribuită pentru ConfigMaps. Acolo s-a considerat că acesta este un chunk de date potrivit pentru replicare și altele. Există o discuție interesantă pe Reddit despre acest subiect, recomand să găsiți această lectură amuzantă pentru weekend sau să citiți un rezumat. .
Repo-uri Chart
Chardele sunt cele mai vulnerabile social și pot deveni sursă de 'Man in the middle', mai ales dacă se folosește o soluție standard. În primul rând, este vorba despre repozitoarele care sunt expuse prin HTTP.
Cu siguranță, trebuie să expuneți Helm Repo prin HTTPS — aceasta este cea mai bună opțiune și costă puțin.
Rețineți că mecanismul de semnătură pentru charturi. Tehnologia este incredibil de simplă. Este exact ceea ce folosiți pe GitHub, o mașinărie PGP obișnuită cu chei publice și private. Configurați și veți fi siguri, având cheile necesare și semnând tot ceea ce este cu adevărat chartul vostru.
În plus, Clientul Helm suportă TLS (nu în sensul HTTP de pe server, ci TLS mutual). Puteți folosi cheile de server și client pentru a comunica. Voi fi sincer, nu folosesc acest mecanism din cauza neplăcerii mele față de certificatele mutuale. În principiu, — instrumentul principal pentru expunerea Helm Repo pentru Helm 2 — suportă și autentificarea de bază. Poate fi folosită autentificarea de bază, dacă este mai convenabil și mai liniștitor.
Mai este un plugin , care permite plasarea Repo-urilor Chart în Google Cloud Storage. Este foarte convenabil, funcționează excelent și este suficient de sigur, deoarece sunt eliminate toate mecanismele descrise.
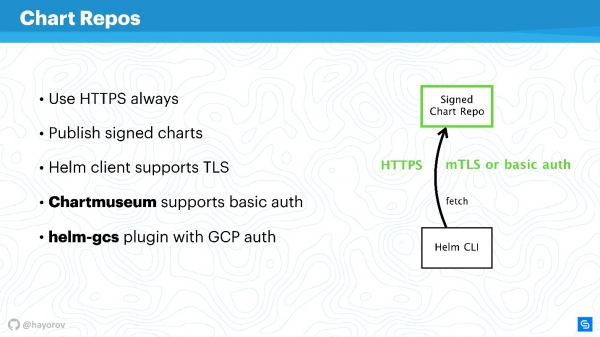
Dacă activați HTTPS sau TLS, folosiți mTLS, activați autentificarea de bază pentru a reduce riscurile, va rezulta un canal sigur de comunicare între Helm CLI și Chart Repo.
API gRPC
Următorul pas este foarte responsabil — securizarea Tiller, care se află în cluster și care, pe de o parte, este server, iar pe de altă parte — se adresează altor componente și încearcă să se prezinte ca altcineva.
Așa cum am spus, Tiller este un serviciu care expune gRPC, clientul Helm se conectează la el prin gRPC. În mod implicit, evident, TLS este dezactivat. De ce este făcut acest lucru — este o întrebare de dezbatere, mi se pare că este pentru a simplifica configurarea la început.
Pentru productie și chiar pentru staging, recomand activarea TLS pe gRPC.
După părerea mea, spre deosebire de mTLS pentru grafice, aici este adecvat și se realizează foarte simplu — generați infrastructura PQI, creați un certificat, porniți Tiller, transmiteți certificatul în timpul inițializării. După aceasta, puteți executa toate comenzile Helm, prezentându-vă cu certificatul generat și cheia privată.
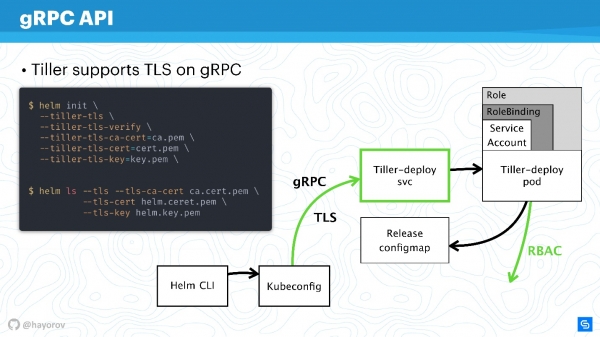
Astfel, vă veți proteja de toate cererile către Tiller din afara cluster-ului.
Deci, am securizat canalul de conectare la Tiller, am discutat deja despre RBAC și am ajustat permisiunile Kubernetes apiserver, reducând domeniul cu care acesta poate interacționa.
Helm securizat
Să ne uităm la schema finală. Aceasta este aceeași arhitectură cu aceleași săgeți.
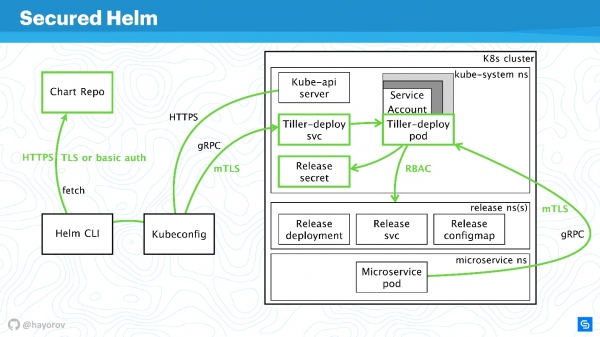
Toate conexiunile pot fi acum desenate în verde:
- pentru Chart Repo folosim TLS sau mTLS și autentificare basic;
- mTLS pentru Tiller, care este expus ca serviciu gRPC cu TLS, folosim certificate;
- în cluster se folosește un cont de serviciu special cu Rol și RoleBinding.
Am securizat considerabil cluster-ul, dar cineva deștept a spus:
„Singura soluție complet sigură poate fi unul — un computer oprit, care se află într-o cutie de beton și este păzit de soldați”.
Există diferite metode de manipulare a datelor și găsirea de noi vectori de atac. Cu toate acestea, sunt sigur că aceste recomandări vor permite implementarea unui standard de bază de securitate industrială.
Bonus
Această parte nu se referă direct la securitate, dar va fi totuși utilă. Voi arăta câteva lucruri interesante despre care puțini știu. De exemplu, cum să căutați grafice — oficiale și neoficiale.
În repository acum sunt aproximativ 300 de grafice și două fluxuri: stable și incubator. Cei care contribuie știu foarte bine cât de greu este să treci din incubator în stable și cât de ușor este să ieși din stable. Cu toate acestea, acesta nu este cel mai bun instrument pentru a căuta grafice pentru Prometheus și tot ce vă place, dintr-un motiv simplu — nu este un portal unde să căutați comod pachete.
Dar există un serviciu , cu ajutorul căruia găsirea graficelor este mult mai comodă. Cel mai important, acolo sunt mult mai multe repozitoare externe și sunt disponibile aproape 800 de grafice. În plus, puteți conecta propriul vostru repozitoriu, dacă din diverse motive nu doriți să trimiteți graficele voastre în stable.
Încercați hub.helm.sh și să-l dezvoltăm împreună. Acest serviciu este sub proiectul Helm, și puteți contribui chiar și la UI-ul său, dacă sunteți frontender și doriți doar să îmbunătățiți aspectul.
Vreau să vă atrag atenția asupra integrarea Open Service Broker API. Pare complicat și neclar, dar rezolvă problemele pe care toți le întâmpină. Voi explica cu un exemplu simplu.
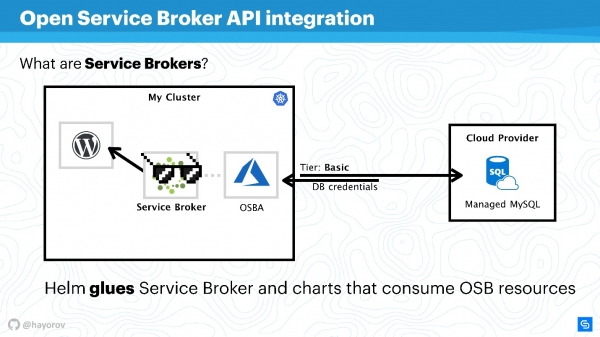
Există un cluster Kubernetes în care dorim să lansăm o aplicație clasică — WordPress. De obicei, pentru o funcționalitate completă, este nevoie de o bază de date. Există multe soluții diferite, de exemplu, poți lansa propriul serviciu stateful. Nu este foarte convenabil, dar mulți fac așa.
Alții, cum ar fi noi la Chainstack, folosesc baze de date gestionate, cum ar fi MySQL sau PostgreSQL, pentru servere. Prin urmare, baza noastră de date se află undeva în cloud.
Dar apare problema: trebuie să conectăm serviciul nostru la baza de date, să creăm flavorul bazei de date, să transmitem credentialele și să le gestionăm. Toate acestea se fac de obicei manual de către un administrator de sistem sau un dezvoltator. Nu este nicio problemă când sunt puține aplicații. Când sunt multe, ai nevoie de un combinaator. Există un astfel de combinaator — acesta este Service Broker. Acesta permite utilizarea unui plugin special pentru clusterul cloud public și comanda resurselor de la provider prin Broker, de parcă ar fi un API. Pentru aceasta, se pot utiliza mijloacele native Kubernetes.
Este foarte simplu. Poți solicita, de exemplu, Managed MySQL în Azure cu un tier de bază (acesta poate fi configurat). Folosind API Azure, baza va fi creată și pregătită pentru utilizare. Nu va trebui să te implici, pluginul se ocupă de asta. De exemplu, OSBA (pluginul Azure) va returna credentialele în serviciu și le va transmite prin Helm. Vei putea folosi WordPress cu MySQL în cloud, fără să te ocupi de baze de date gestionate și fără griji legate de serviciile stateful.
Se poate spune că Helm este lipiciul care, pe de o parte, permite desfășurarea serviciilor, iar pe de altă parte, consumarea resurselor furnizorilor de cloud.
Poți scrie propriul plugin și folosi întreaga istorie on-premise. Atunci vei avea pur și simplu propriul plugin pentru providerul tău de Cloud corporativ. Îți recomand să încerci această abordare, mai ales dacă ai o scala mare și vrei să desfășori rapid dev, staging sau întreaga infrastructură pentru o funcționalitate. Asta va simplifica viața operațiunilor tale sau DevOps.
O altă descoperire, pe care am menționat-o deja — este pluginul helm-gcs, care permite utilizarea Google-buckets (stocare obiect) pentru a stoca graficele Helm.
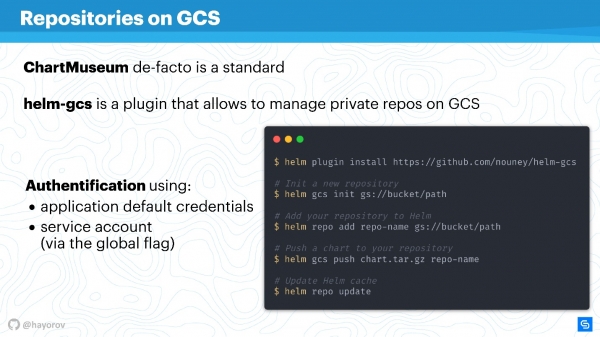
Îți trebuie doar patru comenzi pentru a începe să-l folosești:
- instalează pluginul;
- inițiază-l;
- stabiliți calea către bucket-ul aflat în gcp;
- publicați graficele în mod standard.
Frumusețea este că se va folosi metoda nativă gcp pentru autorizare. Puteți utiliza un cont de serviciu, un cont de dezvoltator — orice doriți. Este foarte convenabil și nu are costuri de operare. Dacă, la fel ca mine, promovați filosofia fără operațiuni, atunci va fi foarte convenabil, mai ales pentru echipe mici.
Alternative
Helm nu este singura soluție pentru gestionarea serviciilor. Există multe întrebări legate de el, probabil de aceea a apărut atât de repede versiunea a treia. Desigur, există alternative.
Acestea pot fi soluții specializate, cum ar fi Ksonnet sau Metaparticle. Puteți folosi instrumentele clasice de gestionare a infrastructurii (Ansible, Terraform, Chef etc.) pentru aceleași scopuri despre care am vorbit.
În final, există o soluție , popularitatea căreia este în creștere.
Operator Framework este principala alternativă la Helm, la care ar trebui să fiți atenți.
Este mai nativ pentru CNCF și Kubernetes, dar pragul de intrare este mult mai mare, trebuie să programați mai mult și să descrieți mai puțin manifestele.
Există diverse addon-uri, cum ar fi Draft, Scaffold. Acestea simplifică foarte mult viața, de exemplu, dezvoltatorilor, facilitând ciclul de trimitere și lansare a Helm pentru desfășurarea unui mediu de testare. Le-aș numi extensii de capacitate.
Iată un grafic ilustrativ despre unde se află fiecare.
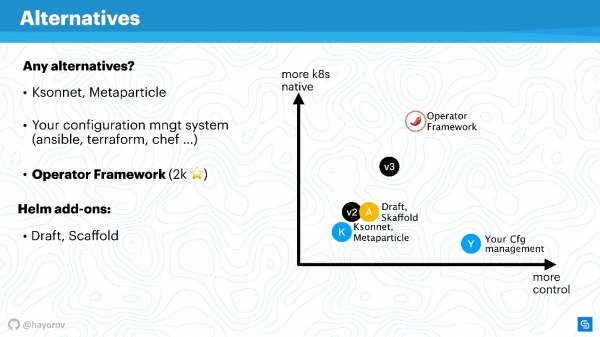
Pe axa orizontală este nivelul controlului personal asupra a ceea ce se întâmplă, pe axa verticală — nivelul de nativitate Kubernetes. Helm versiunea 2 se află undeva la mijloc. În versiunea 3, nu există o diferență colosală, dar atât controlul, cât și nivelul de nativitate au fost îmbunătățite. Soluțiile de nivel Ksonnet totuși nu se ridică la nivelul Helm 2. Cu toate acestea, merită să aruncați o privire asupra lor pentru a ști ce mai există în această lume. Desigur, managerul dumneavoastră de configurație va fi sub controlul dumneavoastră, dar nu este deloc nativ pentru Kubernetes.
Operator Framework este complet nativ pentru Kubernetes și permite gestionarea acestuia mult mai elegant și meticulos (dar să ne amintim de nivelul de intrare). Mai degrabă, acesta este potrivit pentru aplicații specializate și crearea unei gestiuni pentru acestea, decât pentru o mașină masivă de ambalare a unui număr mare de aplicații cu ajutorul Helm.
Extensiile pur și simplu îmbunătățesc puțin controlul, completează fluxul de lucru sau scurtează colțurile pipeline-urilor CI/CD.
Viitorul Helm
Vestea bună este că Helm 3 este aici. A fost lansată versiunea alfa a Helm 3.0.0-alpha.2, care poate fi încercată. Este destul de stabil, dar funcționalitatea este încă limitată.
De ce este necesar Helm 3? În primul rând, este vorba despre dispariția Tiller, așa cum ați înțeles, un pas uriaș înainte, deoarece din punct de vedere al securității arhitecturii, totul devine mai simplu.
Când a fost creat Helm 2, iar asta s-a întâmplat pe vremea Kubernetes 1.8 sau chiar mai devreme, multe concepte erau imature. De exemplu, conceptul CRD este acum activ implementat, iar Helm va utiliza CRD, pentru a stoca structuri. Va fi posibil să utilizați doar clientul și să nu mai aveți o componentă server. În consecință, veți putea utiliza comenzile native Kubernetes pentru a lucra cu structuri și resurse. Acesta este un pas uriaș înainte.
Va apărea suport pentru repositoarele native OCI (Open Container Initiative). Aceasta este o inițiativă imensă, iar Helm este interesat în principal de a găzdui graficele sale. Se ajunge la situația în care, de exemplu, Docker Hub susține multe standarde OCI. Nu vreau să mă grăbesc, dar este posibil ca furnizorii clasici de repositoare Docker să înceapă să ofere opțiunea de a găzdui grafice Helm.
O poveste controversată pentru mine este suportul pentru Lua, ca motor de șablonare pentru scrierea scripturilor. Nu sunt un mare fan al Lua, dar aceasta va fi o opțiune complet opțională. Am verificat de trei ori — utilizarea Lua nu va fi obligatorie. Așadar, cei care doresc pot folosi Lua, iar cei care preferă Go — alăturați-vă taberei noastre mari și folosiți go-tmpl pentru asta.
În sfârșit, ceea ce mi-a lipsit cu adevărat este apariția schemei și validarea tipurilor de date. Nu vor mai exista probleme cu int sau string, nu va mai fi nevoie să înfășurați zero în ghilimele duble. Va apărea o schemă JSONS, care va permite explicit descrierea aceasta pentru values.
Modelul event-driven va fi complet revizuit. A fost deja descris conceptual. Consultați ramura Helm 3 și veți vedea cât de multe evenimente, hook-uri și altele au fost adăugate, ceea ce va simplifica foarte mult și, pe de altă parte, va oferi un control mai bun asupra proceselor de desfășurare și reacțiile acestora.
Helm 3 va fi mai simplu, mai sigur și mai interesant nu pentru că nu ne place Helm 2, ci pentru că Kubernetes devine din ce în ce mai avansat. Prin urmare, Helm poate folosi dezvoltările Kubernetes pentru a crea manageri excelenți pentru Kubernetes.
O altă veste bună este că Alexandr Haïorov va vorbi, Reamintim că conferința privind integrarea proceselor de dezvoltare, testare și exploatare va avea loc la Moscova pe 30 septembrie și 1 octombrie. Până pe 20 august mai puteți și povesti despre experiența dvs. în rezolvarea provocări ale abordării DevOps.
Pentru actualizări despre conferință și știri, urmăriți-ne pe și .
Sursa: habr.com
