

Așadar, adunați metrici. Ca și noi. De asemenea, adunăm metrici. Bineînțeles, cele necesare pentru afaceri. Astăzi vă vom vorbi despre primul link din sistemul nostru de monitorizare — un server de agregare compatibil cu statsd , de ce l-am scris și de ce am renunțat la brubeck.
Din articolele noastre anterioare (, ) puteți afla că, până într-un anumit moment, am adunat etichete folosind . Este scris în C. Din punctul de vedere al codului — simplu ca o dop, ceea ce este important atunci când doriți să contribuiți și, cel mai important, face față fără probleme volumului nostru de 2 milioane de metrici pe secundă (MPS) în vârf. Documentația afirmă suport pentru 4 milioane MPS cu o stea. Aceasta înseamnă că cifra declarată o veți obține dacă configurați corect rețeaua pe Linux. (Câte MPS se pot obține lăsând rețeaua așa cum este, nu știm). În ciuda acestor avantaje, aveam câteva plângeri serioase față de brubeck.
Plângerea 1. Github — dezvoltatorul proiectului — a încetat să-l mai susțină: nu publică patch-uri și corecturi, nu acceptă PR-urile noastre (și nu doar ale noastre). În ultimele câteva luni (undeva din februarie-martie 2018) activitatea a reînceput, dar înainte de acest moment a fost aproape 2 ani de liniște totală. În plus, proiectul este dezvoltat , ceea ce poate deveni un obstacol serios în implementarea de noi funcționalități.
Plângerea 2. Precizia calculelor. Brubeck colectează pentru agregare doar 65536 de valori. În cazul nostru, pentru anumite metrici în perioada de agregare (30 secunde) pot veni mult mai multe valori (1.527.392 în vârf). Ca urmare a acestui eșantion, valorile maximelor și minimelor par inutile. De exemplu, astfel:
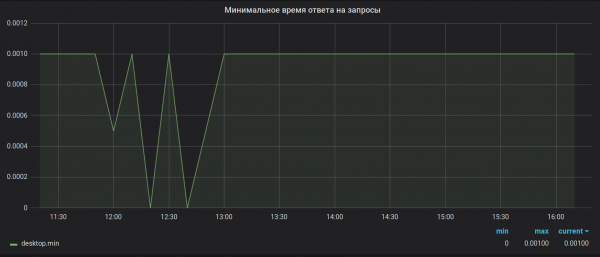
Cum a fost
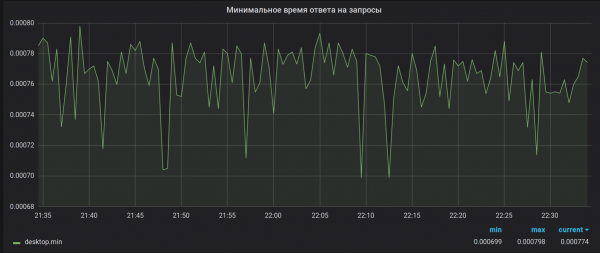
Cum ar fi trebuit să fie
Din același motiv, sumele sunt calculate greșit. Adăugați aici un bug cu depășirea valorii float pe 32 de biți, care trimite serverul în segfault la primirea unei metrici aparent inofensive, și devine cu adevărat excelent. Bug-ul, de altfel, nu a fost corectat.
Și, în sfârșit, Plângerea X. La momentul scrierii acestui articol, suntem pregătiți să-l prezentăm tuturor celor 14 implementări mai mult sau mai puțin funcționale ale statsd, pe care am reușit să le găsim. Să presupunem că o anumită infrastructură a crescut atât de mult încât a primi 4 milioane MPS nu mai este suficient. Sau poate că nu a crescut încă, dar metricele pentru dvs. sunt deja atât de importante încât chiar și scurtcircuitările de 2-3 minute pe grafice pot deveni critice și pot provoca episoade de depresie profundă în rândul managerilor. Deoarece tratamentul depresiei este o sarcină dificilă, sunt necesare soluții tehnice.
În primul rând, fiabilitate, astfel încât o problemă neașteptată pe server să nu provoace un apocalipsă psihiatrică în birou. În al doilea rând, scalabilitate, pentru a avea capacitatea de a primi mai mult de 4 milioane MPS, fără a săpa adânc în stiva de rețea Linux și crescând „în lățime” până la dimensiunile necesare.
Având în vedere că aveam o rezervă pentru scalabilitate, am decis să începem cu fiabilitatea. „O! Fiabilitate! Este simplu, știm cum să facem asta”, ne-am gândit și am pornit 2 servere, ridicând pe fiecare o copie a brubeck. Pentru aceasta, a fost necesar să copiem traficul cu metrice pe ambele servere și chiar să scriem pentru asta . Am rezolvat problema fiabilității cu aceasta, dar… nu foarte bine. La început, totul părea grozav: fiecare brubeck adună propria variantă de agregare, scrie date în Graphite la fiecare 30 de secunde, supraînregistrând intervalul anterior (acest lucru se face pe partea Graphite). Dacă, dintr-o dată, un server se defectează, avem întotdeauna un al doilea cu propria copie de date agregate. Dar problema este: dacă serverul se defectează, pe grafice apare un „dinte de ferăstrău”. Acest lucru este legat de faptul că intervalele de 30 de secunde la brubeck nu sunt sincronizate, iar în momentul picării, unul dintre ele nu se supraînregistrează. Atunci când se porneste al doilea server, se întâmplă același lucru. Este destul de tolerabil, dar vrem mai bine! Problema scalabilității nu a dispărut nici ea. Toate metricele continuă să „zboare” către un server singular, așa că suntem restricționați de aceleași 2-4 milioane MPS, în funcție de capacitatea rețelei.
Dacă te gândești puțin la problemă și sapi zăpada în același timp, poate să-ți vină o idee evidentă: este nevoie de un statsd care să funcționeze în mod distribuit. Adică un statsd care să implementeze sincronizarea între noduri pe baza timpului și a metodelor de măsurare. „Desigur, o astfel de soluție cu siguranță există deja”, ne-am spus și am început să căutăm pe Google... și nu am găsit nimic. Trecând prin documentația diferitelor statsd ( la data de 11.12.2017), nu am găsit nimic. Se pare că nici dezvoltatorii, nici utilizatorii acestor soluții cu un ASEMENEA număr de metode de măsurare nu s-au confruntat încă cu această problemă, altfel cu siguranță ar fi inventat ceva.
Și atunci ne-am amintit de statsd-ul „jucărie” — bioyino, pe care l-am scris la hackathon doar pentru distracție (numele proiectului a fost generat de un script înainte de începerea hackathon-ului) și am realizat că avem nevoie urgentă de propriul nostru statsd. De ce?
- pentru că în lume sunt prea puțini clonați statsd,
- pentru că putem asigura redundanța dorită sau aproape dorită și scalabilitatea (inclusiv sincronizarea metricilor agregate între servere și soluționarea problemelor de conflict la trimitere),
- pentru că putem calcula metricile mai precis decât face brubeck,
- pentru că putem să strângem statistici mai detaliate, pe care brubeck nu ni le-a oferit aproape deloc,
- pentru că ne-a fost oferită ocazia de a programa propria noastră aplicație distribuită de ultimă generație, care să nu replicate complet arhitectura altui astfel de sistem performant.
Pe ce să scriem? Desigur, pe Rust. De ce?
- pentru că exista deja un prototip al soluției,
- pentru că autorul articolului la acel moment știa deja Rust și dorea să scrie ceva pentru producție cu posibilitatea de a face public open-source,
- pentru că limbajele cu GC nu sunt potrivite pentru natura traficului generat (practic în timp real) iar pauzele de GC sunt practic inacceptabile,
- pentru că avem nevoie de un maxim de performanță comparabil cu C
- pentru că Rust ne oferă concurență fără frică, iar dacă am fi început să scriem acest lucru în C/C++, am fi întâmpinat și mai multe probleme decât cu brubeck, cum ar fi vulnerabilități, depășiri de buffer, condiții de cursă și alte cuvinte înfricoșătoare.
A existat și un argument împotriva Rust. Compania nu avea experiență în crearea de proiecte pe Rust și acum nu plănuim să-l folosim nici în proiectul principal. Prin urmare, au fost temeri serioase că nu vom reuși, dar am hotărât să ne asumăm riscul și am încercat.
A trecut timpul…
În cele din urmă, după câteva încercări nereușite, prima versiune funcțională a fost gata. Ce am obținut? Am obținut asta.
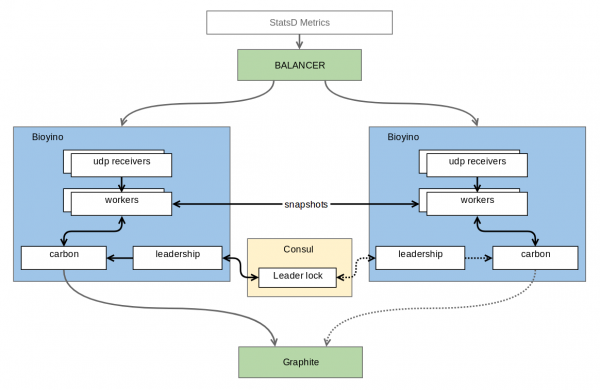
Fiecare nod primește propriul set de metrici și le acumulează, fără a agrega metricile pentru tipurile pentru care pentru agregarea finală este necesar setul complet. Nodurile sunt conectate între ele printr-un protocol de blocare distribuită, care permite selectarea uneia singure (aici am plâns), care este demnă să trimită metricile către Marele. În prezent, această problemă este rezolvată cu ajutorul , dar în viitor ambițiile autorului se întind până la Raft, unde acea nobilă va fi, desigur, nodul lider al consensului. Pe lângă consens, nodurile trimit destul de frecvent (implicit, o dată pe secundă) vecinilor lor părțile pre-agregate ale metricilor pe care au reușit să le acumuleze în acea secundă. Se dovedește că scalabilitatea și reziliența la defecte se păstrează — fiecare nod își păstrează setul complet de metrici, dar metricile sunt trimise deja agregate, prin TCP și codificate în protocol binar, astfel cheltuielile pe duplicare comparativ cu UDP scăzând semnificativ. În ciuda numărului destul de mare de metrici care vin, acumularea necesită foarte puțină memorie și și mai puțin CPU. Pentru metricile noastre comprimate eficient, este vorba doar de câteva zeci de megabytes de date. Un bonus suplimentar este absența scrierilor inutile ale datelor în Graphite, așa cum s-a întâmplat cu burbeck.
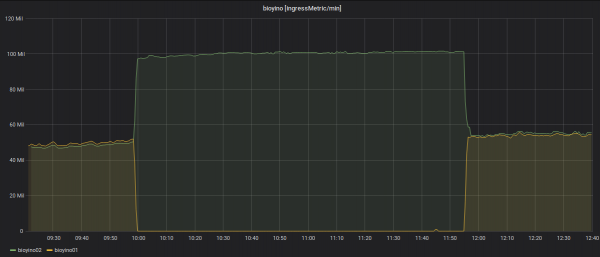
Pachetele UDP cu metrici sunt echilibrate între noduri pe echipamentele de rețea printr-un simplu Round Robin. Evident, echipamentele de rețea nu analizează conținutul pachetelor și, prin urmare, pot gestiona mult mai mult de 4M pachete pe secundă, fără a menționa metricile despre care nu au habar. Având în vedere că metricile sosesc nu câte una în fiecare pachet, nu preconizăm probleme de performanță în acest domeniu. În cazul căderii unui server, echipamentul de rețea detectează rapid (în 1-2 secunde) acest lucru și elimină serverul căzut din rotație. Ca rezultat, nodurile pasive (adică cele care nu sunt lideri) pot fi activate și dezactivate aproape fără a observa scăderi pe grafice. Maximul pe care îl pierdem este o parte a metricilor sosite în ultima secundă. O pierdere/switchizare/schimbare bruscă a liderului va arăta totuși o anomaliere nesemnificativă (intervalul de 30 de secunde rămâne desincronizat), dar în prezența conexiunii între noduri, aceste probleme pot fi minimizate, de exemplu, prin trimiterea pachetelor de sincronizare.
Puțin despre structura internă. Aplicația, desigur, este multi-threaded, dar arhitectura firelor este diferită de cea utilizată în brubeck. Firele în brubeck sunt identice – fiecare dintre ele răspunde simultan pentru colectarea informațiilor și pentru agregare. În bioyino, firele de lucru (workers) sunt împărțite în două grupuri: cele responsabile pentru rețea și cele responsabile pentru agregare. Această împărțire permite gestionarea mai flexibilă a aplicației în funcție de tipul de metrici: acolo unde este necesară o agregare intensivă, se pot adăuga agregatori, iar acolo unde există mult trafic de rețea – se poate crește numărul de fire de rețea. În prezent, pe serverele noastre, lucrăm cu 8 fire de rețea și 4 fire de agregare.
Partea responsabilă pentru agregare este destul de plictisitoare. Bufferele umplute cu fluxuri de rețea sunt distribuite între firele de calcul, unde sunt parsate și agregate. La cerere, metricile sunt returnate pentru a fi trimise către alte noduri. Toate acestea, inclusiv transmiterea datelor între noduri și interacțiunea cu Consul, se execută asynchron. Funcționează pe cadrul .
Mult mai multe probleme în dezvoltare au apărut din partea rețelei, responsabilă pentru primirea metricilor. Principala sarcină de separare a fluxurilor de rețea în entități distincte a fost dorința de a reduce timpul pe care un flux îl petrece nu pentru citirea datelor din socket. Opțiunile cu utilizarea UDP asincron și recvmsg clasic au fost rapid abandonate: prima consumă prea mult CPU în user-space pentru procesarea evenimentelor, iar a doua — prea multe schimbări de context. De aceea, acum se folosește cu buffere mari (iar bufferele, domnilor ofițeri, nu sunt de ici, de colo!). Suportul pentru UDP obișnuit a fost păstrat pentru cazuri neîncărcate, când nu este necesară utilizarea recvmmsg. În modul multimessage, reușim să atingem principalul: majoritatea timpului, fluxul de rețea își desfășoară activitatea de curățare a cozii SO — citește datele din socket și le transferă în buffer-ul din userspace, doar ocazional comutând pentru a livra bufferul plin agregatorilor. Coada din socket aproape că nu se acumulează, iar numărul pachetelor abandonate nu crește semnificativ.
Notă
În setările implicite, dimensiunea bufferului este setată destul de mare. Dacă cumva decideți să testați serverul pe cont propriu, s-ar putea să vă confruntați cu faptul că, după ce trimiteți un număr mic de metrici, acestea nu ajung în Graphite, rămânând în bufferul fluxului de rețea. Pentru a lucra cu un număr mic de metrici, trebuie să ajustați în configurație valorile bufsize și task-queue-size la unele mai mici.
În încheiere — câteva grafice pentru iubitorii de grafice.
Statistica numărului de metrici incoming pentru fiecare server: mai mult de 2 milioane MPS.
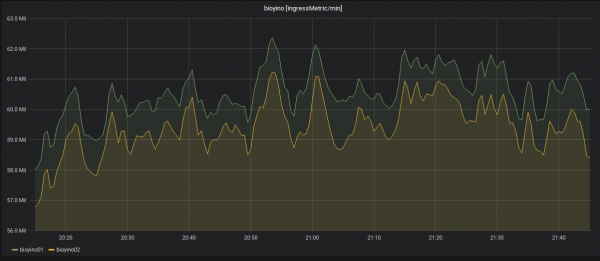
Dezactivarea uneia dintre noduri și redistribuirea metricilor incoming.
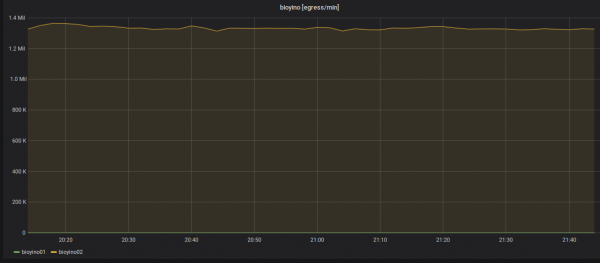
Statistica pentru metricile outgoing: doar un singur nod trimite — raidboss.
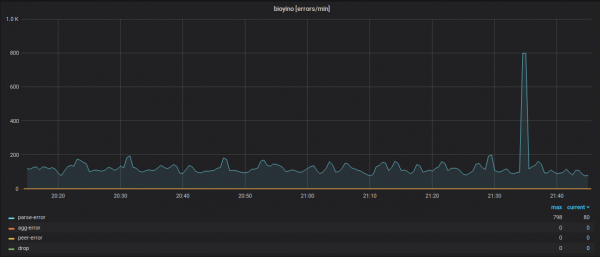
Statistica activității fiecărui nod luând în considerare erorile din diferitele module ale sistemului.
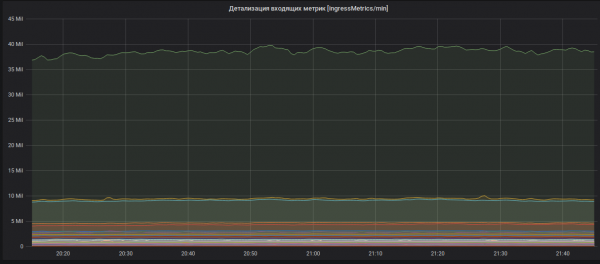
Detalierea metricilor incoming (numele metricelor este ascuns).
Ce plănuim să facem cu toate acestea în continuare? Desigur, să scriem cod, bl…! Proiectul a fost inițial planificat ca open-source și va rămâne astfel pe parcursul vieții sale. În planurile imediate — trecerea la propria versiune Raft, schimbarea protocolului de peer într-unul mai portabil, adăugarea de statistici interne suplimentare, noi tipuri de metrici, corectarea erorilor și alte îmbunătățiri.
Desigur, toți cei interesați de dezvoltarea proiectului sunt bineveniți: creați PR, Issues, vom răspunde și vom îmbunătăți pe cât posibil, etc.
Așadar, cum se spune, đó là tất cả, cumpărați elefanții noștri!
Sursa: habr.com
