

În prezent, serviciul „Bitrix24” nu dispune de sute de gigabiți de trafic și nu are un parc imens de servere (deși există, bineînțeles, și un număr considerabil). Însă pentru mulți clienți, el reprezintă principalul instrument de lucru din companie, fiind o aplicație cu adevărat business-critical. Prin urmare, căderea - nu se poate întâmpla. Și ce dacă, totuși, a avut loc o cădere, dar serviciul a „înviat” atât de repede încât nimeni nu a observat? Și cum se reușește implementarea failover-ului fără a afecta calitatea serviciului și numărul clienților? Alexander Demidov, directorul diviziei de servicii cloud „Bitrix24”, a discutat pentru blogul nostru despre cum sistemul de rezervare a evoluat în cei 7 ani de existență a produsului.
„În format SaaS am lansat „Bitrix24” acum 7 ani. Poate cea mai mare dificultate a fost următoarea: înainte de lansarea publică în acest format, produsul exista doar ca o soluție de tip cutie. Clienții o cumpărau de la noi, o instalau pe serverele lor, creau un portal corporativ - o soluție comună pentru comunicarea angajaților, stocarea fișierelor, gestionarea sarcinilor, CRM, toate acestea. Și până în 2012 am decis că vrem să lansăm asta ca SaaS, administrând în mod autonom, asigurând redundanța și fiabilitatea. Am acumulat experiență în proces, pentru că până atunci nu o aveam - eram doar producători de software, nu furnizori de servicii.
Când am lansat serviciul, înțelegeam că cel mai important este să asigurăm redundanța, fiabilitatea și disponibilitatea constantă a serviciului, pentru că dacă ai un simplu site obișnuit, un magazin, de exemplu, și acesta se blochează timp de o oră - suferi doar tu, pierzi comenzi, pierzi clienți, dar pentru clienții tăi - pentru ei nu este foarte critic. Desigur, se supără, dar merg și cumpără de pe alt site. Dar dacă este o aplicație în care depinde toată activitatea din cadrul companiei, comunicațiile, soluțiile, cel mai important este să câștigi încrederea utilizatorilor, adică să nu-i dezamăgești și să nu cazi. Pentru că întreaga activitate poate fi oprită dacă ceva din interior nu va funcționa.
Bitrix24 ca SaaS
Primul prototip l-am adunat cu un an înainte de lansarea publică, în 2011. L-am reunit în aproximativ o săptămână, l-am privit, l-am rotit — era chiar funcțional. Adică se putea accesa un formular, introduce numele portalului, se desfășura un nou portal, se crea o bază de utilizatori. Ne-am uitat la el, am evaluat produsul în principiu, l-am închis și am continuat să lucrăm la el un întreg an. Pentru că aveam o sarcină mare: nu voiam să facem două baze de cod diferite, nu voiam să suportăm un produs cutie separat, soluții cloud separate — voiam să facem totul în cadrul unui singur cod.
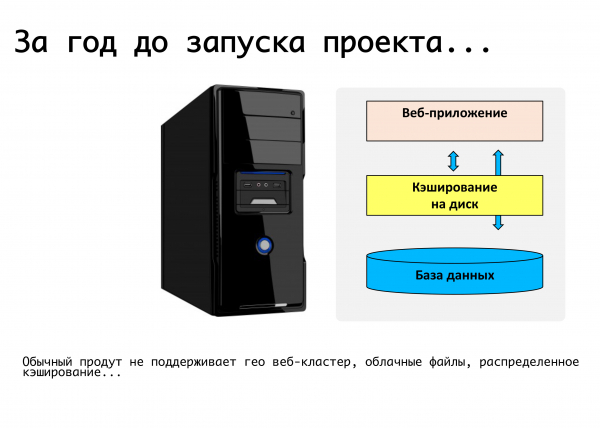
Un aplicație web tipică la acel moment era un server pe care rula un cod php, o bază de date mysql, fișierele se încărcau, documentele, imaginile erau plasate în folderul upload – și asta era tot. Din păcate, nu era posibil să lansăm un serviciu web critic rezistent pe acest lucru. Acolo, cache-ul distribuit nu este suportat, replicarea bazelor de date nu este suportată.
Am formulat cerințele: capacitatea de a fi găzduit în locații diferite, suport pentru replicare, ideal ar fi să fie găzduit în centre de date geografic distribuite. Să separăm logica produsului și, propriu-zis, stocarea datelor. Să putem scala dinamic în funcție de sarcină, să externalizăm complet staticul. Din aceste considerații s-au format, de fapt, cerințele pentru produsul pe care l-am dezvoltat pe parcursul unui an. În acest timp, în platforma care a rezultat unitar — pentru soluții cutie, pentru propriul nostru serviciu — am realizat suportul pentru acele lucruri de care aveam nevoie. Suport pentru replicarea mysql la nivelul produsului: adică dezvoltatorul care scrie cod — nu se gândește la modul în care vor fi distribuite solicitările sale, el folosește api-ul nostru, iar noi știm să distribuim corect solicitările de scriere și citire între mastere și slave.
Am realizat suportul la nivelul produsului pentru diferite stocări de obiecte cloud: google storage, amazon s3, — plus, suport pentru open stack swift. De aceea, a fost convenabil atât pentru noi ca serviciu, cât și pentru dezvoltatorii care lucrează cu soluția cutie: dacă ei folosesc pur și simplu api-ul nostru pentru a lucra, nu se gândesc la unde se va salva fișierul, local pe sistemul de fișiere sau va ajunge în stocarea de obiecte.
În cele din urmă, am decis imediat că ne vom rezerva la nivelul întregului centru de date. În 2012, am început complet în Amazon AWS, deoarece aveam deja experiență cu această platformă - propriul nostru site era găzduit acolo. Ne-a atras faptul că în fiecare regiune din Amazon există mai multe zone de disponibilitate - practic, (în terminologia lor) mai multe centre de date care sunt mai mult sau mai puțin independente unul de celălalt și care ne permit să ne rezervăm la nivelul întregului centru de date: dacă acesta se defectează, bazele sunt replicate master-master, serverele aplicațiilor web sunt rezervate, iar stocarea statică este transferată în stocarea obiectelor s3. Încărcătura este distribuită - la acea vreme cu elb-ul amazonian, dar puțin mai târziu am ajuns la propriile noastre distribuitoare, deoarece aveam nevoie de o logică mai complexă.
Ce am dorit - am obținut...
Toate lucrurile de bază pe care voiam să le asigurăm - toleranța la erori a serverelor, aplicațiilor web, bazelor de date - totul a funcționat bine. Cel mai simplu scenariu: dacă unul dintre aplicațiile noastre web se defectează, atunci aici totul este simplu - ele sunt eliminate din balansare.
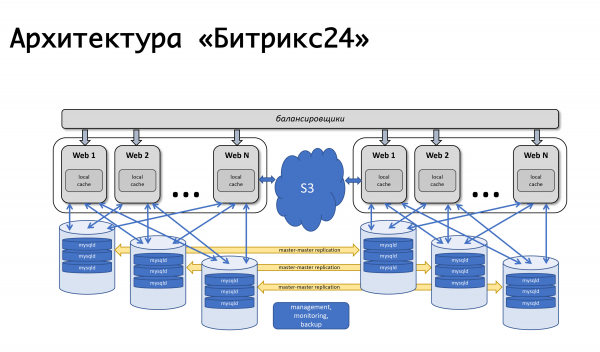
Mașinile defecte erau marcate automat ca unhealthy de către distribuitor (pe atunci era elb-ul amazonian), iar distribuția încărcăturii pe acestea era oprită. Funcționa auto-scaling-ul amazonian: când încărcătura creștea, noi mașini erau adăugate în grupul de auto-scaling, iar încărcătura era distribuită pe noile mașini - totul era în regulă. Cu distribuitoarele noastre, logica este aproximativ aceeași: dacă se întâmplă ceva cu serverul aplicațiilor, eliminăm cererile de pe el, scoatem aceste mașini, pornim altele noi și continuăm să lucrăm. Schema s-a schimbat puțin de-a lungul anilor, dar continuă să funcționeze: este simplă, clară și nu avem nicio dificultate în acest sens.
Lucrăm la nivel mondial, iar vârful de încărcare la clienți este absolut diferit, iar, pe bună dreptate, trebuie să avem posibilitatea de a efectua anumite lucrări de întreținere cu orice componentă a sistemului nostru în orice moment - fără ca clienții să observe. De aceea, avem posibilitatea de a dezactiva baza de date, redistribuind încărcătura pe al doilea centru de date.
Cum funcționează totul? — Direcționăm traficul către centrul de date funcțional — dacă este o avarie la centrul de date, îl direcționăm complet, iar dacă avem lucrări programate pe o anumită bază, redirecționăm o parte din traficul care deservește acei clienți către cel de-al doilea centru de date, în timp ce repicarea este suspendată. Dacă avem nevoie de noi servere pentru aplicații web din cauza creșterii încărcării pe al doilea centru de date, acestea pornesc automat. Terminăm lucrările, repicarea se restabilește și redirecționăm întreaga încărcare înapoi. Dacă trebuie să efectuăm lucrări simultane în al doilea DC, de exemplu, să instalăm actualizări de sistem sau să modificăm setările în a doua bază de date, în general, repetăm exact aceleași pași, doar că în cealaltă direcție. Iar dacă este o avarie, procedăm simplu: în sistemul de monitorizare utilizăm mecanismul event-handlers. Dacă se activează mai multe verificări și statutul trece la critic, se activează acest handler, un proces care poate executa o logică specifică. Avem specificat pentru fiecare bază care server este pentru ea failover și unde trebuie redirecționat traficul în caz de inaccesibilitate. Din motive istorice, utilizăm într-o formă sau alta nagios sau unele dintre fork-urile sale. În principiu, astfel de mecanisme există practic în orice sistem de monitorizare, nu folosim încă ceva mai complex, dar este posibil să o facem cândva. În prezent, monitorizarea reacționează la inaccesibilitate și are capacitatea de a redirecționa ceva.
Am rezervat totul?
Avem mulți clienți din SUA, mulți clienți din Europa, mulți clienți care sunt mai aproape de Est — Japonia, Singapore și așa mai departe. Desigur, o mare parte din clienți se află în Rusia. Asta înseamnă că activitatea nu se desfășoară doar într-o singură regiune. Utilizatorii doresc timpi de răspuns rapizi, există cerințe de conformitate cu diverse legi locale, iar în fiecare regiune rezervăm două centre de date, plus există servicii suplimentare care, din nou, sunt convenabile de plasat în cadrul aceleași regiuni — pentru clienții care operează în acea regiune. Procesorii REST, serverele de autorizare, sunt mai puțin critici pentru funcționarea generală a clientului, prin urmare se poate comuta cu o întârziere acceptabilă, dar nu vrem să inventăm roata, cum să-i monitorizăm și ce să facem cu ei. De aceea, în măsura posibilităților, încercăm să folosim soluțiile existente, nu să ne dezvoltăm competențe în produse suplimentare. Și uneori folosim pur și simplu comutarea la nivel DNS, iar disponibilitatea serviciului o determinăm prin același DNS. În Amazon există serviciul Route 53, dar acesta nu este doar un DNS în care poți introduce înregistrări și atât — este mult mai flexibil și convenabil. Prin intermediul acestuia poți construi servicii geo-distribuite cu geolocații, când cu ajutorul său determini de unde a venit clientul și îi oferi acele înregistrări — cu ajutorul acestuia poți construi arhitecturi de failover. Aceleași verificări de sănătate se configurează în Route 53, setezi endpoint-urile care sunt monitorizate, setezi metricile, stabilești ce protocoale să folosești pentru a determina „disponibilitatea” serviciului — tcp, http, https; setezi frecvența verificărilor care determină dacă serviciul este activ sau nu. Și în registrarul DNS specifici ce va fi principal, ce va fi secundar, unde să comuți dacă se activează verificarea de sănătate în Route 53. Toate acestea pot fi realizate cu alte instrumente, dar avantajul este că, odată configurate, nu mai trebuie să ne gândim la cum se fac verificările, cum se face comutarea: totul funcționează de la sine.
Primul "dar": dar cum și cu ce să rezervăm route 53? Nu se știe niciodată, poate pățește ceva? Din fericire, nu am avut niciodată această problemă, dar, din nou, urmează să povestesc de ce credem că ar trebui să avem o rezervă. Aici ne pregătim din timp. De câteva ori pe zi facem o exportare completă a tuturor zonelor pe care le avem în route 53. API-ul Amazon permite exportarea acestora în JSON, iar noi avem mai multe servere de rezervă unde le convertim, exportăm sub formă de configurații și avem, în esență, o configurație de backup. În caz de ceva, putem să o desfășurăm rapid manual, fără a pierde datele setărilor DNS.
Al doilea „dar”: ce în această imagine nu este încă rezervat? Înclinatorul de sarcină! Distribuția clienților pe regiuni este foarte simplă. Avem domenii bitrix24.ru, bitrix24.com, .de — în prezent sunt vreo 13 diferite, care funcționează pe cele mai variate zone. Am ajuns la următoarea concluzie: în fiecare regiune — propriile înclinate de sarcină. Astfel, este mai convenabil să distribuim pe regiuni, în funcție de încărcătura de vârf din rețea. Dacă este o defecțiune la nivelul unui singur înclinator de sarcină, acesta este pur și simplu scos din funcțiune și eliminat din DNS. Dacă apare o problemă cu un grup de înclinate, acestea sunt rezervate pe alte platforme, iar comutarea între ele se face cu ajutorul aceleași route53, deoarece, datorită unui TTL scurt, comutarea se realizează maxim în 2, 3, 5 minute.
Al treilea „dar”: ce altceva nu este rezervat? S3, corect. Când stocăm fișierele pe care le păstrăm pentru utilizatori în S3, am crezut sincer că este un sistem infailibil și că nu trebuie să facem rezervări. Dar istoria arată că lucrurile se desfășoară altfel. În general, Amazon descrie S3 ca un serviciu fundamental, deoarece Amazon însuși folosește S3 pentru stocarea imaginilor mașinilor, configurațiilor, imaginilor AMI, instantaneelor... Și dacă S3 pică, așa cum s-a întâmplat odată în cei 7 ani în care exploatăm bitrix24, acesta trage după el o mulțime de altele — indisponibilitatea pornirii mașinilor virtuale, defecțiuni în funcționarea API-ului și așa mai departe.
Și S3 poate să cadă — așa s-a întâmplat odată. De aceea am ajuns la următoarea schemă: cu câțiva ani în urmă, nu existau depozite publice de obiecte semnificative în Rusia, și am considerat opțiunea de a face ceva propriu… Din fericire, nu am început să facem acest lucru, pentru că ne-am fi înfundat în expertiza la care nu avem acces și cu siguranță am fi făcut o mulțime de greșeli. Acum, depozitele compatibile cu S3 sunt disponibile de la Mail.ru, de la Yandex și de la un alt număr de furnizori. În cele din urmă, am ajuns la concluzia că vrem să avem, în primul rând, rezervare, iar în al doilea rând, posibilitatea de a lucra cu copii locale. Pentru specificul regiunii rusești, folosim serviciul Mail.ru Hotbox, care este compatibil cu S3 prin API. Nu am avut nevoie de modificări semnificative în codul aplicației și am realizat următorul mecanism: în S3 există trigger-uri care se activează la crearea/ștergerea obiectelor, iar Amazon are un astfel de serviciu, numit Lambda — acesta este un cod serverless care se va executa exact atunci când sunt activate diverse trigger-uri.
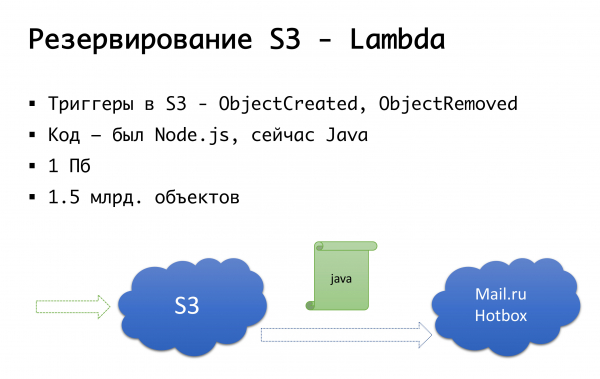
Am procedat foarte simplu: dacă se activează un trigger, executăm codul care va copia obiectul în depozitul Mail.ru. Pentru a putea să activăm în întregime lucrul cu copiile locale de date, avem nevoie și de sincronizare inversă, astfel încât clienții care se află în segmentul rusesc să poată lucra cu depozitul care le este mai aproape. Mail urmează să finalizeze trigger-urile în depozitul său — va fi posibil să executăm sincronizarea inversă la nivel de infrastructură, deocamdată facem acest lucru la nivelul propriului nostru cod. Dacă vedem că un client a încărcat un anumit fișier, atunci noi, la nivel de cod, plasăm un eveniment în coadă, îl procesăm și realizăm replicarea inversă. Problema este că, dacă se desfășoară activități cu obiectele noastre din afara produsului nostru, adică cu anumite mijloace externe, nu vom lua în considerare acest lucru. Prin urmare, așteptăm până la final, când vor apărea trigger-uri la nivelul depozitului, astfel încât, indiferent de locul de unde am executat codul, obiectul care ajunge la noi să fie copiat în cealaltă direcție.
La nivel de cod, pentru fiecare client configurăm ambele stocări: una este considerată principală, iar cealaltă ca backup. Dacă totul merge bine, lucrăm cu stocarea care ne este mai apropiată: adică clienții noștri care sunt pe Amazon, ei lucrează cu S3, iar cei care lucrează în Rusia, ei folosesc Hotbox. Dacă se activează un semnal, atunci trebuie să ne conectăm la failover și să mutăm clienții pe o altă stocare. Putem activa acest semnal independent pe regiuni și putem transfera între ele. Practic, nu am utilizat încă asta, dar am preconizat acest mecanism și credem că, la un moment dat, ne va fi necesar să efectuăm această schimbare. A avut deja loc o dată.
Oh, dar Amazonul v-a părăsit...
În aprilie acesta se împlinesc aniversarea începutului blocărilor Telegram în Rusia. Cel mai afectat provider de acest lucru este Amazon. Și, din păcate, companiile rusești care au lucrat la nivel global au avut mult de suferit.
Dacă compania este globală și Rusia reprezintă pentru ea un segment foarte mic, 3-5% — într-un fel sau altul, se pot sacrifica.
Dacă este o companie pur rusească — sunt sigur că trebuie să opereze local — pur și simplu utilizatorilor le va fi mai convenabil, mai confortabil, riscurile vor fi mai mici.
Și dacă este o companie care operează la nivel global, și are aproximativ la fel de mulți clienți din Rusia cât și din alte colțuri ale lumii? Conectivitatea segmentelor este importantă, și ele trebuie să colaboreze într-un fel sau altul.
De asemenea, la sfârșitul lunii martie 2018, Roskomnadzor a trimis celor mai mari operatori o scrisoare, în care anunțau că intenționează să blocheze câteva milioane de ip-uri Amazon, pentru a bloca… aplicația de mesagerie Zello. Mulțumim acestor provider-i — ei au distribuit cu succes scrisoarea, și a apărut înțelegerea că conectivitatea cu Amazon ar putea fi afectată. A fost o vineri, am alergat în panică la colegii de la servers.ru, spunând: „Prieteni, avem nevoie de câteva servere care să nu fie în Rusia, nu în Amazon, ci, de exemplu, undeva în Amsterdam”, pentru a avea posibilitatea de a pune acolo cel puțin cumva propriile vpn iar proxy pentru anumite endpoint-uri, asupra cărora nu putem influența, de exemplu, endpoint-urile aceluiași s3 — nu putem încerca să înființăm un nou serviciu și să obținem o altă ip, este necesar să ajungem acolo. În câteva zile, am configurat aceste servere, le-am pornit și, în general, la momentul începerii blocajelor, ne-am pregătit. Este curios că, după ce a observat agitația și panică, RKN a spus: „Nu, nu vom bloca nimic acum”. (Dar asta a fost exact până în momentul în care au început să blocheze Telegram.) După ce am configurat opțiunile de ocolire și am înțeles că blocajul nu a fost impus, totuși, nu am început să analizăm asta. Așa, de precauție.
Și astfel, în 2019, trăim în condiții de blocaje. Ieri noapte, am observat: aproape un milion de ip-uri continuă să fie blocate. Adevărul este că Amazon a fost deblocat aproape în întregime, iar la vârf s-au ajuns până la 20 de milioane de adrese... În general, realitatea este că conectivitatea, o conectivitate bună — poate să nu existe. Dintr-o dată. Poate să nu existe din motive tehnice — incendii, excavatoare, toate cele. Sau, cum am văzut, din motive mai puțin tehnice. De aceea, cineva mare și puternic, cu propriile AS-uri, probabil, poate să gestioneze acest proces prin alte metode, — direct connect și alte lucruri deja la nivel de l2. Dar în varianta simplă, cum suntem noi sau alții mai mici, este bine să avem, de precauție, rezervări la nivelul serverelor, înființate undeva altundeva, configurate dinainte cu vpn, proxy, cu posibilitatea de a schimba rapid configurația în segmentele care sunt critice pentru conectivitate. Acest lucru ne-a fost de ajutor de mai multe ori, când au început blocajele Amazon, am folosit prin ele exact traficul S3 în cea mai proastă situație, dar treptat totul s-a rezolvat.
Și cum se poate rezerva… un întreg furnizor?
În prezent, nu avem un scenariu pentru eșecul complet al Amazon. Avem un scenariu similar pentru Rusia. Ne-am găzduit în Rusia la un furnizor care avea mai multe locații. Acum un an, ne-am confruntat cu o problemă: chiar dacă sunt două centre de date, pot exista probleme la nivelul configurației rețelei furnizorului care afectează totuși ambele centre. Astfel, putem avea indisponibilitate în ambele locații. Desigur, așa s-a întâmplat. În cele din urmă, am revizuit arhitectura internă. Nu s-a schimbat foarte mult, dar pentru Rusia avem acum două locații, nu la un singur furnizor, ci la doi diferiți. Dacă unul dintre ei are o defecțiune, putem comuta pe celălalt.
Ipotezând, pentru Amazon, luăm în considerare posibilitatea de a rezerva la un alt furnizor; poate Google, poate altcineva... Dar, până acum, am observat în practică că, dacă au loc incidente la nivelul unei zone de disponibilitate Amazon, incidentele la nivel de întreaga regiune sunt destul de rare. Prin urmare, teoretic avem o idee despre ce am putea face cu rezervarea „Amazon - nu Amazon”, dar în practică, deocamdată, nu există.
Câteva cuvinte despre automatizare
Este întotdeauna necesară automatizarea? Aici este pertinent să ne amintim de efectul Dunning-Kruger. Pe axa „x” avem cunoștințele și experiența pe care le acumulăm, iar pe axa „y” — încrederea în acțiunile noastre. La început, nu știm nimic și nu suntem deloc încrezători. Apoi, știm puțin și devenim mega-încrezători — acesta este așa-zisul „vârf al prostiei”, bine ilustrat de imaginea „neputință și curaj”. Apoi, deja am învățat puțin și suntem pregătiți să luptăm. Apoi, călcăm pe câteva capcane serioase, ajungem în valea disperării, când deși știm ceva, de fapt nu știm multe. Apoi, pe măsură ce acumulăm experiență, devenim mai încrezători.
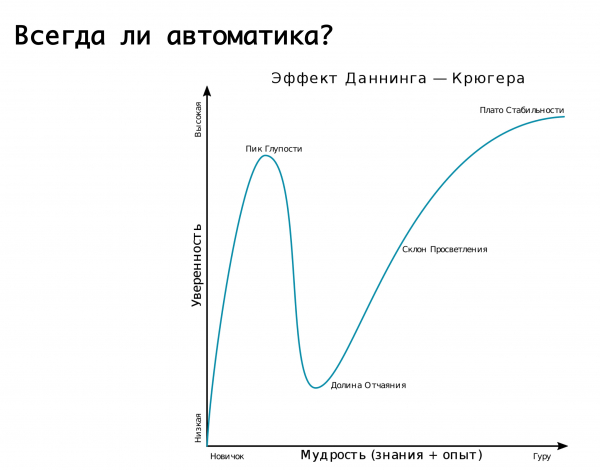
Logica noastră cu privire la diversele comutări automate în cazul unor incidente este bine descrisă prin acest grafic. Am început fără să știm nimic, aproape toate lucrările erau efectuate manual. Apoi, am realizat că putem să automatizăm totul și să dormim liniștiți. Și apoi dăm peste o mare problemă: se activează un false positive și comutăm traficul dintr-o parte în alta, când, de fapt, nu ar fi trebuit să facem asta. Drept urmare, se strică replicarea sau altceva — iată acea vale a disperării. Apoi ajungem la concluzia că trebuie să ne raportăm la toate cu înțelepciune. Adică are sens să ne bazăm pe automatizare, prevăzând posibilitatea unui fals alarmă. Dar! dacă consecințele pot fi devastatoare, atunci e mai bine să lăsăm asta pe seama echipelor de urgență, inginerilor de serviciu, care se vor asigura, verificând că există într-adevăr o avarie, și vor executa acțiunile necesare manual…
Concluzie
În cei 7 ani, am parcurs drumul de la panică, atunci când ceva pica, la înțelegerea că nu există probleme, ci doar sarcini care trebuie — și pot — fi rezolvate. Când construiești un serviciu, privește-l dintr-o perspectivă de ansamblu, evaluează toate riscurile care pot apărea. Dacă le vezi de la început, preconizează în avans redundanța și posibilitatea de a construi o infrastructură rezistentă la defecțiuni, pentru că orice punct care poate ieși din funcțiune și poate duce la nefuncționalitatea serviciului — cu siguranță se va întâmpla. Chiar dacă ți se pare că anumite elemente ale infrastructurii nu se vor strica — precum s3 — ține minte că ele pot face acest lucru. Și, măcar teoretic, să ai o idee despre ce vei face cu ele dacă ceva se va întâmpla. Fă-ți un plan pentru gestionarea riscurilor. Când te gândești să automatizezi totul sau să faci manual — evaluează riscurile: ce se va întâmpla dacă automatizarea începe să comute totul — va duce la o situație și mai proastă comparativ cu o avarie? Poate că trebuie să existe un compromis rezonabil între utilizarea automatizării și reacția inginerului de serviciu, care va evalua situația reală și va decide dacă trebuie să comute ceva imediat sau „da, dar nu acum”.
Un compromis rațional între perfecționism și resursele reale, timpul, banii pe care îi puteți cheltui pentru schema pe care o veți avea în final.
Acest text este o versiune extinsă și îmbunătățită a raportului lui Alexandr Demidov de la conferință. .
Sursa: habr.com
