

Adesea, cei care intră în domeniul Data Science au o viziune mai puțin realistă despre ceea ce îi așteaptă. Mulți cred că acum vor crea cu ușurință rețele neuronale, vor dezvolta un asistent vocal similar cu Iron Man sau vor înfrunta tuturor pe piețele financiare.
Dar munca Data Scientist-ului este legată de date, iar unul dintre cele mai importante și consumatoare de timp aspecte este prelucrarea datelor înainte de a le introduce într-o rețea neuronală sau de a le analiza într-un mod specific.
În acest articol, echipa noastră va descrie cum putem prelucra datele rapid și eficient, oferind un ghid pas cu pas și cod. Am încercat să facem codul destul de flexibil, pentru a fi aplicabil la diferite seturi de date.
Mulți profesioniști ar putea să nu găsească nimic extraordinar în acest articol, dar începătorii vor putea învăța ceva nou, iar oricine a visat să realizeze un notebook dedicat pentru prelucrarea rapidă și structurată a datelor poate copia codul și să-l formateze după cum îi dorim, sau
Am obținut un set de date. Ce facem mai departe?
Așadar, standardul este: trebuie să înțelegem cu ce avem de-a face, imaginea de ansamblu. Pentru aceasta, folosim pandas pentru a determina diferitele tipuri de date.
import pandas as pd #importăm pandas
import numpy as np  #importăm numpy
df = pd.read_csv("AB_NYC_2019.csv") #citind setul de date și salvându-l în variabila df
df.head(3) #privim primele 3 rânduri pentru a înțelege cum arată valorile 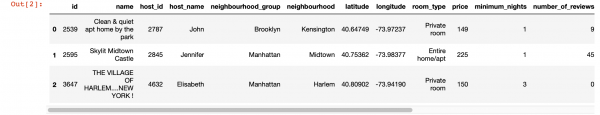
df.info() #Demonstrăm informațiile despre coloane 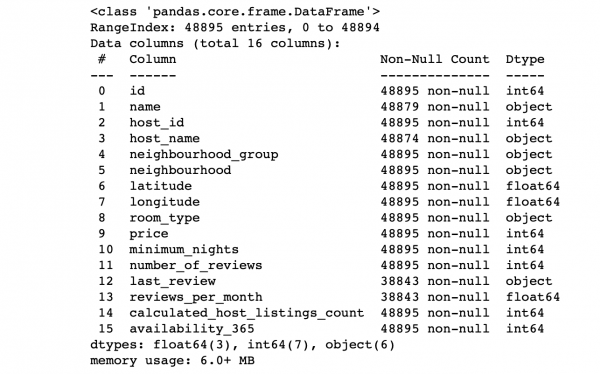
Ne uităm la valorile coloanelor:
- Se potrivesc numărul de rânduri din fiecare coloană cu numărul total de rânduri?
- Care este esența datelor din fiecare coloană?
- Ce coloană dorim să facem obiectiv, astfel încât să facem predicții pentru ea?
Răspunsurile la aceste întrebări ne vor permite să analizăm setul de date și să schițăm un plan pentru acțiunile viitoare.
De asemenea, pentru o privire mai profundă asupra valorilor din fiecare coloană, putem utiliza funcția pandas describe(). Totuși, dezavantajul acestei funcții este că nu oferă informații despre coloanele cu valori string. Ne vom ocupa de acestea mai târziu.
df.describe() 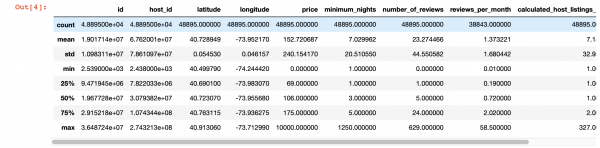
Vizualizarea magică
Să ne uităm la locurile unde avem valori lipsă:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 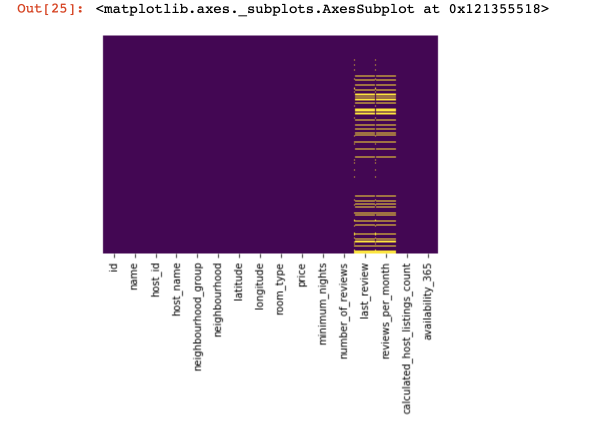
A fost o mică privire de ansamblu, acum vom trece la lucruri mai interesante.
Să încercăm să găsim și, dacă este posibil, să eliminăm coloanele care au o singură valoare în toate rândurile (acestea nu vor afecta rezultatul):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Rescriem datasetul, păstrând doar coloanele cu mai mult de o valoare unică
Acum ne protejăm și succesul proiectului nostru de rândurile duplicat (rânduri care conțin aceeași informație în aceeași ordine ca și unul dintre rândurile existente):
df.drop_duplicates(inplace=True) #Facem asta, dacă considerăm necesar.
                                 #În unele proiecte, nu este bine să eliminăm astfel de date de la început.
Împărțim datasetul în două: unul cu valori calitative și altul – cu valori cantitative
Aici trebuie să facem o mică precizare: dacă rândurile cu date lipsă din datele calitative și cantitative nu se corelează foarte bine între ele, va trebui să luăm o decizie cu ce sacrificăm – toate rândurile cu date lipsă, doar o parte din ele sau anumite coloane. Dacă rândurile se corelează, avem tot dreptul să împărțim datasetul în două. În caz contrar, va trebui să ne ocupăm mai întâi de rândurile în care datele lipsă nu se corelează între datele calitative și cantitative și abia apoi să împărțim datasetul în două.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
Facem asta pentru a ne ușura procesarea acestor două tipuri diferite de date – ulterior, vom realiza cât de mult ne simplifică viața.
Lucrăm cu date cantitative
Primul lucru pe care ar trebui să-l facem este să determinăm dacă există „coloane-spioni” în datele cantitative. Le numim astfel pentru că se deghizează ca date cantitative, dar funcționează ca date calitative.
Cum le putem identifica? Desigur, totul depinde de natura datelor pe care le analizați, dar în general, aceste coloane pot avea puține date unice (în jur de 3-10 valori unice).
print(df_numerical.nunique())După ce stabilim coloanele-spioni, le vom muta din datele cantitative în cele calitative:
spy_columns = df_numerical[['coloana1', 'coloana2', 'coloana3']]#extragerea coloanelor-spion și salvarea într-un dataframe separat
df_numerical.drop(labels=['coloana1', 'coloana2', 'coloana3'], axis=1, inplace = True)#eliminăm aceste coloane din datele numerice
df_categorical.insert(1, 'coloana1', spy_columns['coloana1']) #adăugăm prima coloană-spion în datele calitative
df_categorical.insert(1, 'coloana2', spy_columns['coloana2']) #adăugăm a doua coloană-spion în datele calitative
df_categorical.insert(1, 'coloana3', spy_columns['coloana3']) #adăugăm a treia coloană-spion în datele calitative
În sfârșit, am separat complet datele numerice de cele calitative și acum putem lucra cu ele. Primul pas este să înțelegem unde avem valori lipsă (NaN și, în unele cazuri, 0 vor fi considerate valori lipsă).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
În această etapă este important să înțelegem în ce coloane poate că zero-urile pot însemna valori lipsă: este legat de modul în care au fost colectate datele? Sau poate fi legat de valorile datelor? Trebuie să răspundem la aceste întrebări în fiecare caz în parte.
Deci, dacă am decis că datele pot lipsi acolo unde sunt zero-uri, trebuie să înlocuim zero-urile cu NaN, pentru a fi mai ușor să lucrăm ulterior cu aceste date pierdute:
df_numerical[["coloana 1", "coloana 2"]] = df_numerical[["coloana 1", "coloana 2"]].replace(0, nan)Acum să vedem unde avem date lipsă:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Se poate folosi și df_numerical.info() 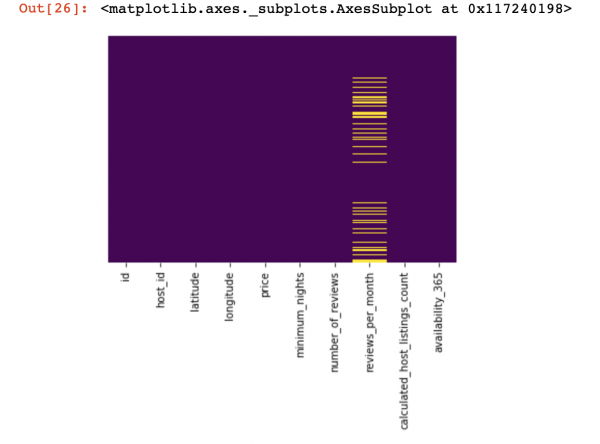
Aici ar trebui să fie marcate cu galben acele valori din coloane care lipsesc. Și cel mai interesant începe acum — cum să procedăm cu aceste valori? Să eliminăm rândurile cu aceste valori sau coloanele? Sau să completăm aceste valori lipsă cu altele?
Iată un schelet aproximativ care te poate ajuta să decizi ce poți face cu valorile lipsă:
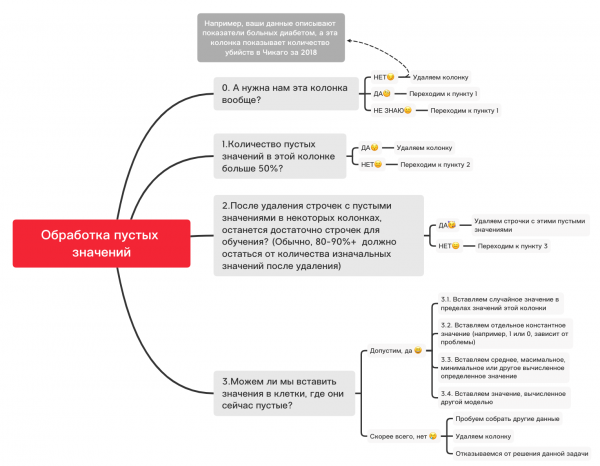
0. Eliminăm coloanele inutile
df_numerical.drop(labels=["coloana1","coloana2"], axis=1, inplace=True)1. Numărul valorilor lipsă în această coloană este mai mare de 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["coloana1","coloana2"], axis=1, inplace=True)#Eliminăm dacă vreo coloană are mai mult de 50 de valori lipsă2. Eliminăm rândurile cu valori lipsă
df_numerical.dropna(inplace=True)#Eliminăm rândurile cu valori nule, dacă rămân suficient de multe date pentru învățare3.1. Inserăm o valoare aleatorie
import random #importăm random
df_numerical["coloană"].fillna(lambda x: random.choice(df[df[column] != np.nan]["coloană"]), inplace=True) #inserăm valori aleatorii în celulele goale ale tabelului
3.2. Inserăm o valoare constantă
from sklearn.impute import SimpleImputer #importăm SimpleImputer, care va ajuta la inserarea valorilor
imputer = SimpleImputer(strategy='constant', fill_value="") #inserăm o valoare specifică cu ajutorul SimpleImputer
df_numerical[["coloană_nouă1","coloană_nouă2","coloană_nouă3"]]=imputer.fit_transform(df_numerical[['coloană1', 'coloană2', 'coloană3']]) #Aplicăm asta pentru tabelul nostru
df_numerical.drop(labels = ["coloană1","coloană2","coloană3"], axis = 1, inplace = True) #Îndepărtăm coloanele cu valorile vechi
3.3. Inserăm media sau cel mai frecvent valoare
from sklearn.impute import SimpleImputer #importăm SimpleImputer, care va ajuta la inserarea valorilor
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #în loc de mean, putem folosi și most_frequent
df_numerical[["coloană_nouă1","coloană_nouă2","coloană_nouă3"]]=imputer.fit_transform(df_numerical[['coloană1', 'coloană2', 'coloană3']]) #Aplicăm asta pentru tabelul nostru
df_numerical.drop(labels = ["coloană1","coloană2","coloană3"], axis = 1, inplace = True) #Îndepărtăm coloanele cu valorile vechi
3.4. Inserăm o valoare calculată de un alt model
Uneori, valorile pot fi calculate folosind modele de regresie, folosind modele din biblioteca sklearn sau alte biblioteci similare. Echipa noastră va dedica un articol separat despre cum se poate face acest lucru în viitorul apropiat.
Așadar, deocamdată povestea despre datele cantitative se va întrerupe, deoarece există multe alte nuanțe despre cum este mai bine să se facă pregătirea datelor și preprocesarea pentru diverse sarcini, iar elementele de bază pentru datele cantitative au fost luate în considerare în acest articol, iar acum este momentul să ne întoarcem la datele calitative, pe care le-am separat cu câțiva pași în urmă de cele cantitative. Puteți modifica acest notebook așa cum doriți, adaptându-l la diverse sarcini, pentru a face preprocesarea datelor foarte rapid!
Date calitative
De obicei, pentru datele calitative se folosește metoda One-hot-encoding, pentru a le formata din string (sau object) în numere. Înainte de a trece la acest punct, să folosim schema și codul de mai sus pentru a clarifica valorile lipsă.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 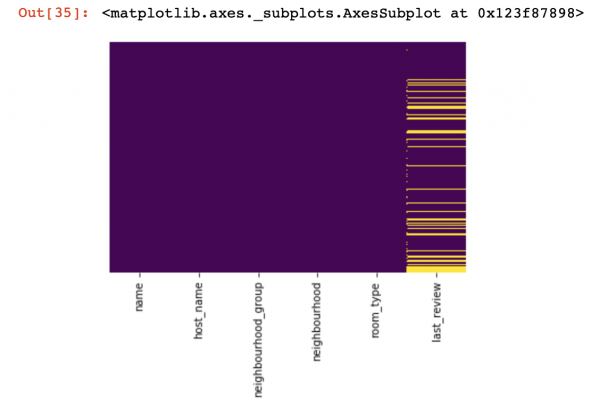
0. Eliminăm coloanele inutile
df_categorical.drop(labels=["colona1", "colona2"], axis=1, inplace=True)1. Numărul valorilor lipsă în această coloană este mai mare de 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["colona1", "colona2"], axis=1, inplace=True) # Ștergem dacă vreo coloană
# are mai mult de 50% din valori lipsă2. Eliminăm rândurile cu valori lipsă
df_categorical.dropna(inplace=True) # Ștergem rândurile cu valori lipsă,
  # dacă mai rămân suficiente date pentru antrenament
3.1. Inserăm o valoare aleatorie
import random
df_categorical["colona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["colona"]), inplace=True)
3.2. Inserăm o valoare constantă
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["noua_colona1", 'noua_colona2', 'noua_colona3']] = imputer.fit_transform(df_categorical[['colona1', 'colona2', 'colona3']])
df_categorical.drop(labels=["colona1", "colona2", "colona3"], axis=1, inplace=True)
Așadar, în sfârșit am făcut ordine în valorile lipsă din datele calitative. Acum este timpul să efectuăm one-hot-encoding pentru valorile din baza dumneavoastră de date. Această metodă este folosită foarte frecvent pentru ca algoritmul dumneavoastră să poată învăța având în vedere datele calitative.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["colona1", "colona2", "colona3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Așadar, în sfârșit am terminat de procesat separat datele calitative și cantitative — este timpul să le unim din nou.
new_df = pd.concat([df_numerical, df_categorical], axis=1)După ce am combinat seturile de date într-un singur set, putem folosi transformarea datelor prin MinMaxScaler din biblioteca sklearn. Acest lucru va aduce valorile între 0 și 1, ceea ce va ajuta la antrenamentul modelului în viitor.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Aceste date sunt acum gata pentru orice — rețele neuronale, algoritmi standard de ML etc.!
În acest articol nu am luat în considerare lucrul cu datele legate de serii temporale, deoarece pentru aceste date ar trebui să folosiți tehnici de procesare puțin diferite în funcție de sarcina dvs. În viitor, echipa noastră va dedica un articol separat acestei teme și sperăm că acesta va putea aduce în viața dvs. ceva interesant, nou și util, la fel ca și acesta.
Sursa: habr.com
