

Salut tuturor! Numele meu este Dmitrii Samsonov și lucrez ca administrator de sistem principal la „Odnoklassniki”. Avem peste 7.000 de servere fizice, 11.000 de containere în cloud-ul nostru și 200 de aplicații care în diverse configurații formează 700 de clustere diferite. Majoritatea serverelor funcționează sub CentOS 7.
Pe 14 august 2018 a fost publicată informația despre vulnerabilitatea FragmentSmack.
() și SegmentSmack (). Acestea sunt vulnerabilități cu vector de atac de rețea și cu o evaluare destul de înaltă (7.5), care amenință cu un atac de tip Denial of Service (DoS) din cauza epuizării resurselor (CPU). La acel moment, nu a fost propus un fix pentru FragmentSmack în nucleu, iar acesta a fost publicat semnificativ mai târziu după divulgarea informațiilor despre vulnerabilitate. Pentru a remedia SegmentSmack, s-a recomandat actualizarea nucleului. Pachetul de actualizare a fost lansat în acea zi, rămânea doar să fie instalat.
Nu, nu suntem deloc împotriva actualizării nucleului! Totuși, există niște nuanțe…
Cum actualizăm nucleul în producție
În general, nu este nimic complicat:
- Descărcați pachetele;
- Instalați-le pe un anumit număr de servere (inclusiv serverele care găzduiesc cloud-ul nostru);
- Asigurați-vă că nimic nu s-a stricat;
- Verificați că toate configurațiile standard ale nucleului s-au aplicat fără erori;
- Așteptați câteva zile;
- Verificați indicatorii serverelor;
- Schimbați desfășurarea noilor servere pe nucleul nou;
- Actualizați toate serverele din centrele de date (câte un centru de date pe rând, pentru a minimiza impactul asupra utilizatorilor în caz de probleme);
- Reporniți toate serverele.
Repetați pentru toate ramurile nucleelor pe care le avem. În prezent, acestea sunt:
- CentOS 7 stock 3.10 — pentru majoritatea serverelor obișnuite;
- Vanilla 4.19 — pentru cloud-ul nostru , deoarece avem nevoie de BFQ, BBR etc.;
- Elrepo kernel-ml 5.2 — pentru , deoarece 4.19 se comporta instabil anterior, iar caracteristicile necesare sunt aceleași.
Așa cum ați putea ghici, cel mai mult timp este consumat de repornirea a mii de servere. Deoarece nu toate vulnerabilitățile sunt critice pentru toate serverele, repornim doar cele care sunt direct accesibile de pe internet. În cloud, pentru a nu limita flexibilitatea, nu legăm containerele accesibile de la exterior la servere separate cu un nou nucleu, ci repornim toate gazdele fără excepție. Din fericire, procedura acolo este mai simplă decât în cazul serverelor obișnuite. De exemplu, containerele stateless pot pur și simplu să se mute pe un alt server în timpul repornirii.
Cu toate acestea, volumul de muncă este totuși mare, iar acesta poate dura câteva săptămâni, iar în cazul apariției unor probleme cu noua versiune — până la câteva luni. Atacatorii înțeleg bine acest lucru, așa că avem nevoie de un plan „B”.
FragmentSmack/SemaphoreSmack. Soluție alternativă
Din fericire, pentru unele vulnerabilități, acest plan „B” există și se numește soluție alternativă. Cel mai frecvent, este vorba despre modificarea setărilor nucleului/aplicațiilor, care permit minimizarea efectului posibil sau eliminarea completă a exploatării vulnerabilităților.
În cazul FragmentSmack/SemaphoreSmack o astfel de soluție alternativă:
«Se pot modifica valorile implicite de 4MB și 3MB în net.ipv4.ipfrag_high_thresh și net.ipv4.ipfrag_low_thresh (și echivalentele lor pentru ipv6 net.ipv6.ipfrag_high_thresh și net.ipv6.ipfrag_low_thresh) la 256 kB și 192 kB, respectiv, sau mai puțin. Testele arată o scădere de la mică la semnificativă a utilizării CPU în timpul atacului, în funcție de echipament, setări și condiții. Totuși, poate exista o oarecare influență asupra performanței din cauza ipfrag_high_thresh=262144 bytes, deoarece doar două fragmente de 64K pot încăpea simultan în coada de reasamblare. De exemplu, există riscul ca aplicațiile care lucrează cu pachete UDP mari să fie afectate.».
Parametrii înșiși sunt descriși astfel:
ipfrag_high_thresh - NUMĂR ÎNTOARCE LONG
     Memoria maximă utilizată pentru a reasambla fragmentele IP.
ipfrag_low_thresh - NUMĂR ÎN ÎNDRĂGOSTIT
     Memoria maximă utilizată pentru a reconstitui fragmentele IP înainte ca nucleul
     să înceapă să elimine coctele de fragmente incomplete pentru a elibera resurse.
     Nucleul acceptă în continuare fragmente noi pentru defragmentare.
Pe serviciile de producție nu avem UDP mari. În LAN, traficul fragmentat este absent, în WAN există, dar nu semnificativ. Nimic nu preconizează — putem aplica soluția alternativă!
FragmentSmack/SemaphoreSmack. Prima victorie
Prima problemă cu care ne-am confruntat a fost că containerele cloud, uneori, aplicau noile setări doar parțial (numai ipfrag_low_thresh) și, uneori, nu le aplicau deloc — pur și simplu se prăbușeau la pornire. Nu am reușit să reproducem problema în mod constant (toate setările se aplicau manual fără niciun fel de dificultăți). De asemenea, nu a fost atât de simplu să înțelegem de ce containerul se prăbușește la pornire: nu au fost descoperite erori. Un lucru era clar: revenirea la setările anterioare rezolvă problema prăbușirii containerelor.
De ce nu este suficient să aplici Sysctl pe gazdă? Containerul trăiește în propriul său Namespace de rețea dedicat, așa că cel puțin din container poate fi diferită de cea a gazdei.
Cum se aplică setările Sysctl în container? Deoarece containerele noastre sunt neprivilegiate, nu putem modifica nicio setare Sysctl intrând în container — pur și simplu nu avem suficiente drepturi. La acea vreme, pentru a rula containere, cloudul nostru folosea Docker (acum deja ). Parametrii noului container erau transmiși lui Docker prin API, inclusiv setările Sysctl necesare.
În timpul verificării versiunilor, s-a descoperit că API-ul Docker nu returna toate erorile (cel puțin în versiunea 1.10). Când am încercat să pornim containerul prin „docker run”, am văzut în sfârșit ceva:
write /proc/sys/net/ipv4/ipfrag_high_thresh: argument invalid docker: Răspuns de eroare de la daemon: Nu se poate porni containerul : [9] Eroare de sistem: nu s-a putut sincroniza cu procesul containerului.
Valoarea parametrului nu este validă. Dar de ce? Și de ce nu este validă doar uneori? S-a descoperit că Docker nu garantează ordinea aplicării parametrilor Sysctl (cea mai recentă versiune verificată — 1.13.1), de aceea, uneori, ipfrag_high_thresh încerca să fie setat la 256K, în timp ce ipfrag_low_thresh era încă 3M, deci limita superioară era mai mică decât limita inferioară, ceea ce ducea la eroare.
La acel moment, deja foloseam propriul nostru mecanism de reconfigurare a containerului după pornire (înghețarea containerului prin și executarea comenzilor în namespace-ul containerului prin ), și am adăugat în această parte și scrierea parametrilor Sysctl. Problema a fost rezolvată.
FragmentSmack/SegmentSmack. Prima sânge 2
Nu am avut timp să ne ocupăm de aplicarea Workaround-ului în cloud, când au început să vină primele plângeri rare de la utilizatori. La acel moment, trecuseră câteva săptămâni de la începutul aplicării Workaround-ului pe primele servere. Investigarea inițială a arătat că plângerile proveneau de la servicii specifice, și nu de la toate serverele acelor servicii. Problema a dobândit din nou un caracter extrem de nedeterminat.
În primul rând, bineînțeles, am încercat să revenim la setările Sysctl, dar aceasta nu a avut niciun efect. Diferite manipulări ale setărilor serverului și aplicației nu au ajutat de asemenea. A ajutat reboot-ul. Reboot-ul pentru Linux este la fel de împotriva naturii, cum era o condiție normală pentru lucrul cu Windows în zilele de altădată. Cu toate acestea, a ajutat, și am pus totul pe seama «problemelor în nucleu» la aplicarea unor noi setări în Sysctl. Cât de ușor am fost dezinformați...
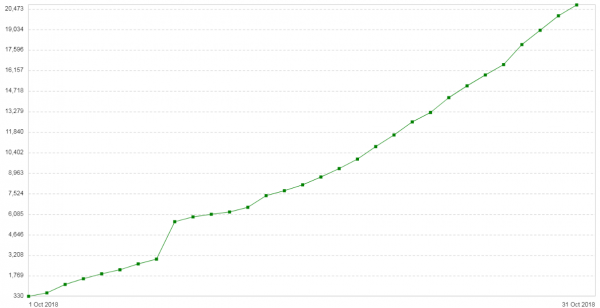
După trei săptămâni, problema s-a repetat. Configurația acestor servere a fost destul de simplă: Nginx în modul proxy / balance. Traficul era mic. O nouă informație: la clienți, numărul de erori 504 crește cu fiecare zi (). Grafica arată numărul de erori 504 pe zi pentru acest serviciu:
Toate erorile se referă la același backend - cel care se află în cloud. Graficul consumului de memorie pentru fragmentele de pachete pe acest backend arăta astfel:
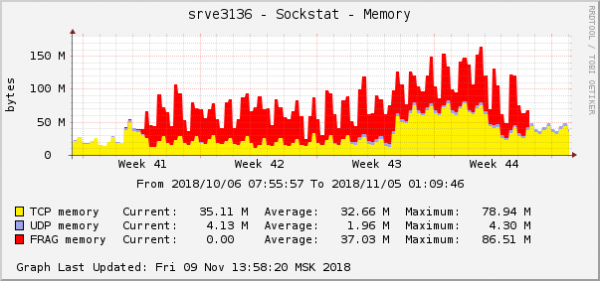
Aceasta este una dintre cele mai evidente manifestări ale problemei pe graficele sistemului de operare. În cloud, tocmai în acel moment a fost reparată o altă problemă de rețea cu setările QoS (Traffic Control). Graficul consumului de memorie pentru fragmentele de pachete arăta exact la fel:
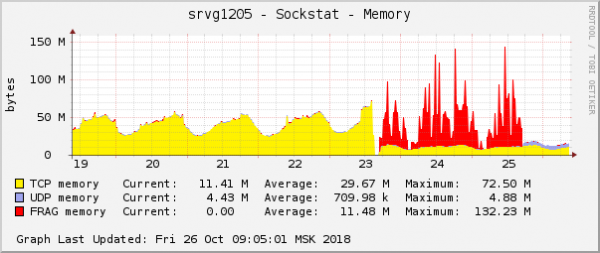
Presupunerea a fost simplă: dacă pe grafice arată la fel, atunci și cauza este aceeași. Cu atât mai mult, că problemele cu acest tip de memorie apar extrem de rar.
Problema reparată consta în faptul că am folosit în QoS scheduler-ul de pachete fq cu setările implicite. În mod implicit, pentru o conexiune, acesta permite adăugarea în coadă a 100 de pachete, iar unele conexiuni, în situații de deficit de bandă, au început să blocheze coada până la refuz. În acest caz, pachetele sunt dropate. În statisticile tc (tc -s qdisc), aceasta este vizibil astfel:
qdisc fq 2c6c: părinte 1:2c6c limită 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Trimis 454701676345 bytes 491683359 pkt (drop 464545, depășiri 0 requeues 0)
  backlog 0b 0p requeues 0
   1024 fluxuri (1021 inactive, 0 throttled)
   0 gc, 0 highprio, 0 throttled, 464545 flows_plimit
„464545 flows_plimit” se referă la pachetele abandonate din cauza depășirii limitei cozii unei conexiuni, iar „dropped 464545” reprezintă suma tuturor pachetelor abandonate de acest scheduler. După ce am mărit lungimea cozii la 1.000 și am repornit containerele, problema a încetat să mai apară. Poți să te așezi confortabil în fotoliu și să bei un smoothie.
FragmentSmack/SementSmack. Ultima rană
În primul rând, după câteva luni de la anunțarea vulnrabilităților din nucleu, a apărut în sfârșit un patch pentru FragmentSmack (amintesc că odată cu anunțul din august a fost lansat un patch doar pentru SegmentSmack), ceea ce ne-a dat ocazia să renunțăm la workaround-ul care ne-a cauzat destule neplăceri. O parte dintre servere au fost deja migrate la un nucleu nou în acest timp, iar acum trebuia să începem de la început. De ce am actualizat nucleul fără să așteptăm patch-ul pentru FragmentSmack? Problema este că procesul de protecție împotriva acestor vulnerabilități s-a suprapus (și s-a amestecat) cu procesul de actualizare a CentOS-ului (ceea ce durează și mai mult decât actualizarea nucleului). În plus, SegmentSmack este o vulnerabilitate mai gravă, iar patch-ul pentru aceasta a apărut imediat, așa că era de sens să facem actualizarea în orice caz. Totuși, simpla actualizare a nucleului pe CentOS nu a fost posibilă, deoarece vulnerabilitatea FragmentSmack, care a apărut pe CentOS 7.5, a fost corectată abia în versiunea 7.6, așa că a trebuit să suspendem actualizarea la 7.5 și să începem totul de la zero cu actualizarea la 7.6. Și așa se mai întâmplă.
În al doilea rând, am început să primim plângeri rare de la utilizatori legate de probleme. Acum știm cu siguranță că toate acestea sunt legate de încărcarea fișierelor de către clienți pe anumite servere ale noastre. Și, de fapt, prin aceste servere a avut loc un număr foarte mic de încărcări din total.
Așa cum ne amintim din relatarea de mai sus, revenirea la Sysctl nu a ajutat. Reboot-ul a ajutat, dar temporar.
Suspicile legate de Sysctl nu fuseseră îndepărtate, dar de data aceasta era necesar să colectăm cât mai multe informații. De asemenea, ne-a lipsit foarte mult capacitatea de a reproduce problema cu încărcarea de la client, pentru a studia mai precis ce se întâmplă.
Analiza tuturor statisticilor și jurnalelor disponibile nu ne-a adus mai aproape de înțelegerea a ce se întâmplă. A fost o lipsă acută a posibilității de a reproduce problema pentru a "tactila" o conexiune specifică. În cele din urmă, dezvoltatorii au reușit să reproducă stabil problemele pe un dispozitiv de testare atunci când s-au conectat prin Wi-Fi, folosind o versiune specială a aplicației. Acesta a fost un pas important în anchetă. Clientul se conecta la Nginx, care proxyuia către backend-ul format din aplicația noastră pe Java.
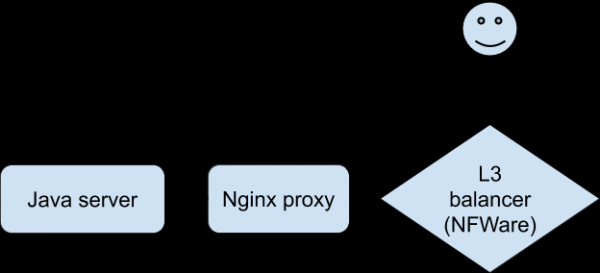
Dialogul în cazul problemelor a fost astfel (înregistrat pe partea Nginx-proxy):
- Client: solicitare de informații despre descărcarea fișierului.
- Server Java: răspuns.
- Client: POST cu fișier.
- Server Java: eroare.
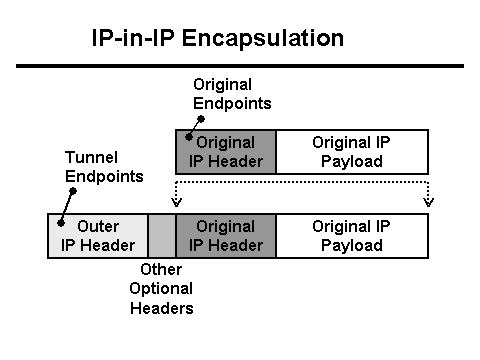
Serverul Java scrie în jurnal că a primit 0 octeți de la client, iar Nginx-proxy raportează că solicitarea a durat mai mult de 30 de secunde (30 de secunde este timpul limită pentru aplicația client). De ce apare acest timeout și de ce 0 octeți? Din perspectiva HTTP, totul funcționează așa cum ar trebui, dar POST-ul cu fișierul pare să dispară din rețea. Și dispare între client și Nginx. A sosit momentul să ne dotăm cu Tcpdump! Dar, mai întâi, trebuie să înțelegem configurația rețelei. Nginx-proxy se află în spatele unui balansor de încărcare L3. . Se folosește tunelarea pentru a livra pachete de la balansorul L3 la server, care adaugă propriile antete în pachete:
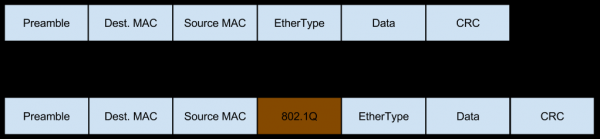
În acest moment, rețeaua pentru acest server vine sub formă de trafic etichetat Vlan, care adaugă și el propriile câmpuri în pachete:
Și acest trafic poate fi fragmentat (acel mic procent din traficul fragmentat care a fost menționat la evaluarea riscurilor din Workaround), ceea ce alterează și antetele:
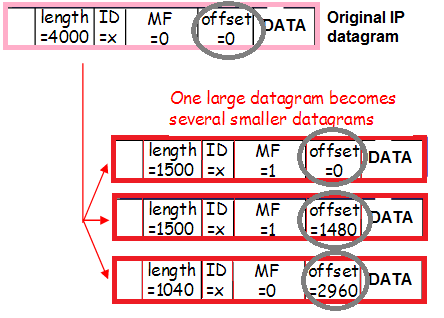
Încă o dată: pachetele sunt încapsulate cu eticheta Vlan, sunt încapsulate în tunel, sunt fragmentate. Pentru a înțelege mai bine cum se întâmplă acest lucru, să urmărim traseul unui pachet de la client la Nginx-proxy.
- Pachetul ajunge la balansorul L3. Pentru o rutare corectă în interiorul centrului de date, pachetul este încapsulat într-un tunel și trimis la placa de rețea.
- Pentru că pachetul + antetele tunelului nu încap în MTU, pachetul este tăiat în fragmente și trimis în rețea.
- Switch-ul după balansorul L3, la primirea pachetului, adaugă un etichetă Vlan și-l trimite mai departe.
- Switcher-ul din fața proxy-ului Nginx observă (conform setărilor de port) că serverul așteaptă un pachet încastrat în VLAN, așa că îl trimite așa cum este, fără a elimina eticheta VLAN.
- Linux primește fragmentele de pachete separate și le combină într-un singur pachet mare.
- Apoi, pachetul ajunge pe interfața VLAN, unde se elimină primul strat - încastrarea VLAN.
- Apoi, Linux îl trimite pe interfața Tunnel, unde se elimină un alt strat - încastrarea Tunnel.
Dificultatea constă în a transmite toate acestea sub formă de parametri în tcpdump.
Să începem cu sfârșitul: există pachete IP curate (fără antete suplimentare) de la clienți, fără încastrarea VLAN și Tunnel?
tcpdump host
Nu, astfel de pachete nu au fost găsite pe server. Prin urmare, problema trebuie să fie mai devreme. Există pachete fără doar încastrarea VLAN?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx este adresa IP a clientului în format hex.
32:4 este adresa și lungimea câmpului în care este înregistrată adresa IP SCR în pachetul Tunnel.
Adresa câmpului a trebuit să fie ajustată prin încercare, deoarece pe internet se scrie despre 40, 44, 50, 54, dar acolo nu era nicio adresă IP. De asemenea, se poate verifica unul dintre pachete în hex (parametrul -xx sau -XX în tcpdump) și putea fi calculată adresa la care se află IP-ul cunoscut.
Există fragmente de pachete fără încastrarea VLAN și Tunnel?
tcpdump ((ip[6:2] > 0) si (nu ip[6] = 64))
Această magie ne va arăta toate fragmentele, inclusiv ultimul. Probabil că se poate filtra după IP, dar nu am încercat, deoarece astfel de pachete nu sunt foarte multe și s-au găsit ușor în fluxul general. Iată-le:
14:02:58.471063 În 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lungime 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), lungime 1500)
     11.11.11.11 > 22.22.22.22: IP trunchiat - 20 bytes lipsă! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), lungime 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], lungime 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lungime 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), lungime 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ......
Acestea sunt două fragmente ale unui pachet (ID identic 53652) cu o fotografie (se vede cuvântul Exif în primul pachet). Din cauza faptului că la acest nivel pachetele există, dar în formă combinată în dump-uri nu, problema este clar cu asamblarea. În sfârșit, acest lucru are o confirmare documentară!
Decodorul de pachete nu a identificat nicio problemă care să împiedice asamblarea. Am încercat aici: . La început, când încercam să introduc ceva acolo, decoderului nu-i plăcea formatul pachetului. S-a dovedit că existau două octeți suplimentari între Srcmac și Ethertype (care nu erau legați de informațiile despre fragmente). După ce i-am eliminat, decoderul a funcționat. Cu toate acestea, nu a arătat nicio problemă.
Oricum ar fi, în afară de acele Sysctl, nu s-a găsit nimic altceva. Rămânea să găsim o modalitate de a identifica serverele problematice, pentru a înțelege amploarea și a lua o decizie privind acțiunile ulterioare. Destul de repede am găsit contorul necesar:
netstat -s | grep "packet reassembles failed”
Acesta este disponibil în snmpd sub OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
„Numărul de eșecuri detectate de algoritmul de reconstituire IP (din diverse motive: a expirat, erori etc.)”.
Printre grupul de servere pe care a fost studiată problema, pe două contorul acesta creștea mai repede, pe două — mai încet, iar pe alte două nu creștea deloc. Compararea dinamicii acestui contor cu dinamica erorilor HTTP de pe serverul Java a evidențiat o corelație. Așadar, contorul putea fi pus în monitorizare.
Prezența unui indicator de probleme fiabil este foarte importantă, astfel încât să putem determina exact dacă revenirea la setările anterioare Sysctl ajută, având în vedere că din povestea anterioară știm că nu se poate înțelege imediat din aplicație. Acest indicator ar permite identificarea tuturor locurilor problematice din producție înainte ca utilizatorii să le constate.
După revenirea la setările anterioare Sysctl, erorile de monitorizare au încetat, demonstrând astfel cauza problemelor, precum și faptul că revenirea ajută.
Am revenit la setările de fragmentare pe alte servere, unde a apărut un nou sistem de monitorizare, iar undeva am alocat chiar mai multă memorie pentru fragmente decât era implicit înainte (acesta era un statistic UDP, pierderile parțiale ale cărora nu erau vizibile în ansamblu).
Cele mai importante întrebări
De ce pachetele sunt fragmentate pe balansoarele L3? Majoritatea pachetelor care vin de la utilizatori la balansoare sunt SYN și ACK. Dimensiunile acestor pachete sunt mici. Cu toate acestea, deoarece această proporție a pachetelor este foarte mare, nu am observat prezența pachetelor mari care au început să fie fragmentate.
Cauza a fost un script de configurare care s-a stricat pe servere cu interfețe Vlan (servere cu trafic etichetat erau foarte puține în producție la acea vreme). Advmss permite transmiterea către client a informației că pachetele în direcția noastră trebuie să fie de dimensiuni mai mici, astfel încât după atașarea antetelor tunelului să nu fie necesară fragmentarea acestora.
De ce rollback-ul Sysctl nu a ajutat, iar reboot-ul a ajutat? Rollback-ul Sysctl schimba volumul de memorie disponibil pentru îmbinarea pachetelor. În același timp, se pare că însuși faptul că memoria pentru fragmente era plină provoca întârzieri în conexiuni, ceea ce ducea la o întârziere semnificativă a fragmentelor în coadă. Adică procesul se bloca.
Reboot-ul reseta memoria și totul revenea la normal.
Se putea evita Workaround-ul? Da, dar riscul de a lăsa utilizatorii fără suport în caz de atac era mare. Desigur, utilizarea Workaround-ului a dus la diverse probleme, inclusiv încetinirea unuia dintre servicii pentru utilizatori, dar totuși considerăm că acțiunile au fost justificate.
Mulțumesc mult lui Andrei Timofeyev () pentru ajutorul în desfășurarea investigației, precum și lui Alexei Krenev () — pentru munca titanică de actualizare a CentOS și a kernel-urilor pe servere. Un proces care, în acest caz, a fost necesar să fie reluat de mai multe ori, ceea ce a dus la întârzieri de multe luni.
Sursa: habr.com
