

Filtrele de Pachete Berkeley (BPF) sunt o tehnologie a nucleului Linux care ocupă primele pagini ale revistelor tehnice în limba engleză de câțiva ani. Conferințele sunt pline de prezentări despre utilizarea și dezvoltarea BPF. David Miller, întreținătorul subsistemului de rețea Linux, își intitulează prezentarea de la Linux Plumbers 2018 (XDP este una dintre variantele de utilizare a BPF). Brendan Gregg susține prezentări cu titlul . Toke Høiland-Jørgensen , spunând că nucleul este acum un microkernel. Thomas Graf promovează ideea că .
Pe Habr încă nu există o descriere sistematică a BPF, așa că, într-o serie de articole, voi încerca să povestesc despre istoria tehnologiei, să descriu arhitectura și instrumentele de dezvoltare, să conturez domeniile de utilizare și practicile de aplicare a BPF. În acest prim articol, voi povesti despre istoria și arhitectura BPF clasic, precum și despre principiile de funcționare tcpdump, seccomp, strace, și multe altele.
Dezvoltarea BPF este controlată de comunitatea de rețea Linux, iar principalele aplicații existente ale BPF sunt legate de rețele și, cu permisiunea , am denumit seria "BPF pentru cei mai mici", în onoarea unei mari serii .
Un curs scurt de istorie a BPF (c)
Tehnologia BPF modernă este o versiune îmbunătățită și extinsă a vechii tehnologii cu același nume, acum denumită, pentru a evita confuzia, BPF clasic. Pe baza BPF clasic a fost creat binecunoscuta unealtă tcpdump, mecanismul seccomp, precum și modul mai puțin cunoscut xt_bpf pentru iptables și clasificatorul cls_bpf. În Linux-ul modern, programele BPF clasice sunt traduse automat în noua formă, totuși, din perspectiva utilizatorului, API-ul a rămas același, iar noile aplicații ale BPF clasice, așa cum vom observa în acest articol, sunt încă prezente. Din acest motiv, precum și pentru că urmărind istoria evoluției BPF clasice în Linux, devine mai clar cum și de ce a evoluat în forma modernă, am decis să încep în mod special cu un articol despre BPF clasic.
La sfârșitul anilor ’80, inginerii de la renumitul Lawrence Berkeley Laboratory s-au arătat interesați de modul în care se pot filtra corect pachetele de rețea pe hardware-ul modern pentru acea perioadă. Ideea de bază a filtrării, realizată inițial în tehnologia CSPF (CMU/Stanford Packet Filter), a constat în filtrarea pachetelor necorespunzătoare cât mai devreme, adică în spațiul nucleului, deoarece acest lucru permite să nu se copieze datele inutile în spațiul utilizatorului. Pentru a asigura securitatea execuției codului utilizatorului în spațiul nucleului, s-a folosit o mașină virtuală – o „sandbox”.
Cu toate acestea, mașinile virtuale pentru filtrele existente au fost proiectate pentru a rula pe mașini cu arhitectură pe stivă și nu au funcționat la fel de eficient pe noile mașini RISC. Ca urmare, inginerii de la Berkeley Labs au dezvoltat o nouă tehnologie BPF (Berkeley Packet Filters), a cărei arhitectură a mașinii virtuale a fost proiectată pe baza procesorului Motorola 6502 – „munca” unor produse cunoscute precum sau . Noua mașină virtuală a crescut performanța filtrelor de zeci de ori în comparație cu soluțiile existente.
Arhitectura mașinii BPF
Ne vom familiariza cu arhitectura „la lucru”, analizând exemple. Cu toate acestea, pentru început, să spunem că mașina avea două registre de 32 de biți disponibile pentru utilizator, un accumulator A și un registru de index X, 64 de octeți de memorie (16 cuvinte), disponibile pentru scriere și citire ulterioară, și un set mic de instrucțiuni pentru a lucra cu aceste obiecte. În programe erau disponibile instrucțiuni de salt pentru a implementa expresii condiționale, însă pentru a asigura finalizarea la timp a programului, se putea sărit doar înainte, adică, în special, era interzis să se creeze bucle.
Schema generală a execuției mașinii este următoarea. Utilizatorul creează un program pentru arhitectura BPF și, prin intermediul unei mecanisme din nucleu (de exemplu, un apel de sistem), încarcă și conectează programul la un generator de evenimente din nucleu (de exemplu, un eveniment este primirea unui nou pachet pe placa de rețea). La apariția unui eveniment, nucleul pornește programul (de exemplu, în interpretator), iar memoria mașinii corespunde un regiunea memoriei nucleului (de exemplu, datele din pachetul venit).
Ceea ce am spus mai sus este suficient pentru a începe să analizăm exemplele: ne vom familiariza cu sistemul și formatul comenzilor după necesitate. Dacă doriți să studiați imediat sistemul de comenzi al mașinii virtuale și să aflați despre toate capacitățile sale, puteți citi articolul original. și/sau prima jumătate a fișierului din documentația nucleului. În plus, puteți studia prezentarea , în care McCanne, unul dintre autorii BPF, vorbește despre istoria creării libpcap.
Noi trecem acum la examinarea tuturor exemplelor semnificative de utilizare a lui BPF clasic în Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Dezvoltarea BPF a fost realizată paralele cu dezvoltarea frontend-ului pentru filtrarea pachetelor — binecunoscuta utilitară tcpdump. Și, fiind cel mai vechi și cel mai cunoscut exemplu de utilizare a BPF-ului clasic, disponibil pe numeroase sisteme de operare, de aici ne vom începe studiul tehnologiei.
(Toate exemplele din acest articol le-am rulat pe Linux 5.6.0-rc6. Ieșirea anumitor comenzi a fost editată pentru o mai bună lizibilitate.)
Exemplu: observăm pachete IPv6
Să presupunem că dorim să monitorizăm toate pachetele IPv6 pe interfața eth0. Pentru aceasta, putem lansa programul tcpdump cu un filtru simplu ip6:
$ sudo tcpdump -i eth0 ip6În plus, tcpdump compilează filtrul ip6 în codul byte al arhitecturii BPF și îl trimite în nucleu (vedeți detalii în secțiunea ). Filtrul încărcat va fi rulat pentru fiecare pachet care trece prin interfața eth0. Dacă filtrul returnează o valoare non-zero n, atunci până la n byte-urile pachetului vor fi copiate în spațiul utilizatorului și le vom vedea în ieșire tcpdump.
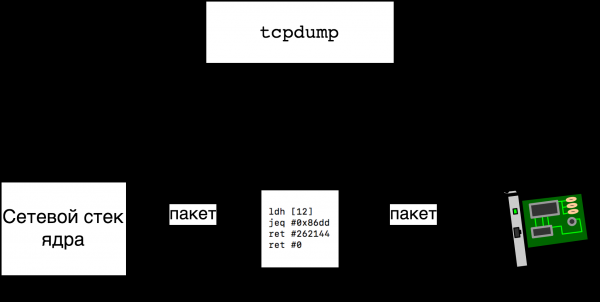
Se pare că putem afla cu ușurință ce fel de cod byte a trimis nucleului tcpdump prin intermediul propriei tcpdump, dacă îl lansăm cu opțiunea -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Pe prima linie, lansăm comanda ldh [12], care se decodează ca „încarcă în registru A jumătate de cuvânt (16 biți) la adresa 12” și singura întrebare — ce fel de memorie adresăm? Răspunsul este că la adresa x începe (x+1)-lea byte al pachetului de rețea analizat. Citim pachetele de pe interfața Ethernet eth0, și asta , că pachetul arată astfel (pentru simplificare, presupunem că în pachet nu există etichete VLAN):
       6              6          2
|MAC destinație|MAC sursă|Tip Ethernet|...|
Asta înseamnă că după executarea comenzii ldh [12] în registru A va apărea câmpul Tip Ethernet — tipul pachetului transmis în acest cadru Ethernet. Pe linia 1 comparăm conținutul registrului A (tipul pachetului) cu 0x86dd, și asta tipul de IPv6 care ne interesează. Pe linia 1, pe lângă comanda de comparare, mai sunt două coloane — jt 2 și jf 3 — etichete către care trebuie să trecem în cazul unei comparații reușite (A == 0x86dd) și în cazul unei eșecuri. Așadar, în cazul reușit (IPv6) trecem la linia 2, iar în cazul unui eșec — la linia 3. Pe linia 3, programul se termină cu codul 0 (nu copia pachetul), iar pe linia 2 programul se termină cu codul 262144 (copiează-mi maximum 256 kilobytes din pachet).
Un exemplu mai complex: ne uităm la pachetele TCP pe portul de destinație
Să vedem cum arată filtrul care copiază toate pachetele TCP cu portul de destinație 666. Vom considera cazul IPv4, deoarece cazul IPv6 este mai simplu. După studierea acestui exemplu, puteți ca exercițiu să studiați singuri filtrul pentru IPv6 (ip6 and tcp dst port 666) și filtrul pentru cazul general (tcp dst port 666). Așadar, filtrul care ne interesează arată astfel:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Ce fac liniile 0 și 1 știm deja. Pe linia 2 deja am verificat că acesta este un pachet IPv4 (Tip Ethernet = 0x800) și încărcăm în registru A bajtul 24 al pachetului. Pachetul nostru arată ca
       14            8      1     1
|antet ethernet|câmpuri ip|ttl|protocol|...|
prin urmare, încărcăm în registru A câmpul Protocol al antetului IP, ceea ce este logic, deoarece dorim să copiem doar pachetele TCP. Comparăm Protocol cu 0x6 () pe linia 3.
Pe liniile 4 și 5 încărcăm jumătățile de cuvânt aflate la adresa 20 și cu ajutorul comenzii jset verificăm dacă unul dintre cele trei — în masca emisă jset sunt curățate cele trei biți superiori. Doi biți din trei ne spun dacă pachetul face parte dintr-un pachet IP fragmentat, și dacă da, dacă este ultimul fragment. Al treilea bit este rezervat și trebuie să fie egal cu zero. Nu vrem să verificăm pachete incomplete sau corupte, de aceea verificăm toate cele trei biți.
Linia 6 este cea mai interesantă din această listă. Expresia ldxb 4*([14]&0xf) înseamnă că încărcăm în registru X cei patru biți de jos ai celui de-al cincisprezecelea octet din pachet, înmulțiți cu 4. Cei patru biți de jos ai celui de-al cincisprezecelea octet reprezintă câmpul al antetului IPv4, în care se stochează lungimea antetului în cuvinte, de aceea trebuie să înmulțim apoi cu 4. Interesant este că expresia 4*([14]&0xf) este o denumire a unei scheme speciale de adresare, care poate fi utilizată doar în această formă și doar pentru registru X, adică nu putem spune nici ldb 4*([14]&0xf) nici ldxb 5*([14]&0xf) (putem să specificăm doar alt offset, de exemplu, ldxb 4*([16]&0xf)). Este evident că această schemă de adresare a fost adăugată în BPF exact pentru a obține în X (registru indexat) lungimea antetului IPv4.
Astfel, pe linia 7 încercăm să încărcăm jumătate de cuvânt, la adresa (X+16). Amintindu-ne că 14 octeți ocupă antetul Ethernet și X conține lungimea antetului IPv4, înțelegem că în A se încarcă portul de destinație TCP:
       14           X           2             2
|antet ethernet|antet ip|port sursă|port destinație|
În cele din urmă, pe linia 8 comparăm portul de destinație cu valoarea căutată și pe liniile 9 sau 10 returnăm rezultatul - copiem pachetul sau nu.
Tcpdump: încărcare
În exemplele anterioare, am ales să nu ne oprim detaliat la modul în care încărcăm codul BPF în kernel pentru filtrarea pachetelor. În general, tcpdump a fost portat pe multe sisteme și pentru lucrul cu filtre folosește biblioteca . Pe scurt, pentru a aplica un filtru pe interfață folosind libpcap, trebuie să facem următoarele:
- să creăm un descriptor de tip
pcap_tdin numele interfeței: , - să activăm interfața: ,
- să compilăm filtru: ,
- să conectăm filtrul: .
Pentru a vedea cum este implementată funcția pcap_setfilter în Linux, folosim strace (câteva linii au fost șterse):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Pe primele două linii ale ieșirii, creăm pentru a citi toate cadrele Ethernet și le legăm la interfață eth0. Din știm că filtrul ip va consta din patru instrucțiuni BPF, iar pe a treia linie vedem cum, folosind opțiunea a apelului sistemic setsockopt Încărcăm și conectăm un filtru de lungime 4. Acesta este filtrul nostru.
Este important de menționat că, în BPF-ul clasic, încărcarea și conectarea filtrului se desfășoară întotdeauna ca o operațiune atomică, iar în noua versiune BPF, încărcarea programului și atașarea acestuia la generatorul de evenimente sunt separate în timp.
Adevărul ascuns
O versiune puțin mai completă a ieșirii arată astfel:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Resource temporarily unavailable)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Așa cum am spus mai sus, încărcăm și conectăm filtrul nostru la socket pe linia 5, dar ce se întâmplă pe liniile 3 și 4? Se pare că aceasta libpcap îngrijește de noi — pentru ca în ieșirea filtrului nostru să nu ajungă pachete care nu îi satisfac cerințele, biblioteca un filtru fals ret #0 (să drop toate pachetele), pune socket-ul în modul non-blocant și încearcă să citească toate pachetele care ar fi putut rămâne de la filtrele anterioare.
Prin urmare, pentru a filtra pachetele pe Linux folosind BPF clasic, este necesar să aveți un filtru sub formă de structură de tip struct sock_fprog și un socket deschis, după care filtrul poate fi atașat la socket folosind un apel de sistem setsockopt.
Este interesant că filtrul poate fi atașat la orice socket, nu doar la raw. Iată un program care taie totul, cu excepția primelor două bytes ale tuturor datagramelor UDP primite. (Comentariile le-am adăugat în cod pentru a nu aglomera articolul.)
Mai multe detalii despre utilizarea setsockopt pentru atașarea filterelor pot fi găsite în , iar despre scrierea propriilor filtre de tip struct sock_fprog fără ajutorul tcpdump vom discuta în secțiunea .
BPF clasic și secolul XXI
BPF a fost inclus în Linux în 1997 și a rămas mult timp un cal de muncă libpcap fără modificări semnificative (modificările specifice Linux, desigur, , dar acestea nu au schimbat imaginea globală). Primele semne serioase că BPF va evolua au apărut în 2011, când Eric Dumazet a propus , adăugând în nucleu Just In Time Compiler — un translator pentru a traduce bytecode-ul BPF în cod nativ. x86_64 JIT compiler a fost primul în lanțul de modificări: în 2012
posibilitatea de a scrie filtre pentru , folosind BPF, în ianuarie 2013 a fost , folosind BPF, în ianuarie 2013 a fost modul xt_bpf, care permite scrierea regulilor pentru iptables cu ajutorul BPF, iar în octombrie 2013 a fost de asemenea și un modul cls_bpf, care permite scrierea cu ajutorul BPF a clasificatoarelor de trafic.
Să analizăm mai în detaliu toate aceste exemple mai târziu, dar mai întâi ne va fi util să învățăm cum să scriem și să compilăm programe arbitrare pentru BPF, deoarece posibilitățile oferite de bibliotecă libpcap sunt limitate (un exemplu simplu: un filtru generat libpcap poate returna doar două valori - 0 sau 0x40000) sau, în cazul seccomp, sunt complet inaplicabile.
Programarea BPF cu ajutorul propriilor mâini
Să ne familiarizăm cu formatul binar al instrucțiunilor BPF, care este foarte simplu:
   16    8    8     32
| code | jt | jf |  k  |
Fiecare instrucțiune ocupă 64 de biți, din care primii 16 biți sunt codul opțiunii, apoi urmează două indentări de 8 biți, jt și jf, și 32 de biți pentru argument K, a cărui destinație variază de la o instrucțiune la alta. De exemplu, instrucțiunea ret, care încheie execuția programului are codul 6, iar valoarea returnată este preluată din constantă K. În limbajul C, o instrucțiune BPF este reprezentată sub forma unei structuri
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
iar un întreg program este reprezentată sub forma unei structuri
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Astfel, deja putem scrie programe (codurile instrucțiunilor, să presupunem, le știm din ). Așa ar arăta filtrul ip6 din :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
Programul prog îl putem folosi legal în apelul
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Scrierea programelor sub formă de coduri mașină nu este foarte convenabilă, dar uneori este necesară (de exemplu, pentru depanare, crearea de teste unitare, scrierea articolelor pe Habr etc.). Pentru comoditate, în fișierul <linux/filter.h> sunt definite macro-uri ajutătoare - același exemplu ca și mai sus ar putea fi rescris ca
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Cu toate acestea, această variantă nu este foarte convenabilă. Aceasta au gândit și programatorii nucleului Linux și, prin urmare, în directorul al nucleului se poate găsi un asamblor și un debugger pentru a lucra cu BPF clasic.
Limbajul asamblor este foarte similar cu ieșirea de depanare tcpdump, dar, în plus, putem specifica etichete simbolice. De exemplu, iată un program care elimină toate pachetele, cu excepția TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
În mod implicit, asamblorul generează cod în formatul , ,..., pentru exemplul nostru cu TCP, va rezulta
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Pentru confortul programatorilor C, se poate folosi un alt format de ieșire:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Acest text poate fi copiat în definiția structurii de tipul struct sock_filter, așa cum am făcut la începutul acestei secțiuni.
Extensiile Linux și netsniff-ng
În afară de instrucțiunile standard BPF, Linux și tools/bpf/bpf_asm susțin și . În principal, instrucțiunile servesc pentru accesul la câmpurile structurii struct sk_buff, care descrie un pachet de rețea în kernel. Totuși, există și instrucțiuni ajutătoare de alt tip, de exemplu ldw cpu va încărca în registru A rezultatul executării funcției kernel raw_smp_processor_id(). (În noua versiune BPF aceste extensii non-standard au fost extinse prin furnizarea către programe a unui set de kernel helpers pentru acces la memorie, structuri și generarea de evenimente.) Iată un exemplu interesant de filtru, în care copiem în spațiul utilizatorului doar anteturile pachetelor, folosind extensia poff, offset-ul payload-ului:
ld poff
ret a
Extensiile BPF nu pot fi utilizate în tcpdump, dar acesta este un motiv bun pentru a cunoaște pachetul de utilitare , care, printre altele, conține un program avansat netsniff-ng, care, pe lângă filtrarea cu BPF, are de asemenea un generator de trafic eficient și un asamblor BPF mai avansat numit tools/bpf/bpf_asmbpfc . Pachetul conține documentație destul de detaliată, consultați de asemenea linkurile de la sfârșitul articolului.Așadar, deja știm să scriem programe BPF de complexitate arbitrară și suntem pregătiți să vedem exemple noi, primul dintre ele fiind tehnologia seccomp, care permite, prin intermediul filtrelor BPF, gestionarea unui număr mare și a seturilor de argumente ale apelurilor de sistem disponibile acestui proces și urmașilor săi.
seccomp
Prima versiune seccomp a fost adăugată în kernel în 2005 și nu a fost populară, deoarece oferea doar o singură capacitate — limitarea numărului de apeluri de sistem disponibile procesului la următoarele:
sigreturn read, write, exit și , iar procesul care a încălcat regulile era distrus prin, iar procesul care a încălcat regulile a fost oprit prin SIGKILL. Cu toate acestea, în 2012, seccomp a fost extins cu posibilitatea de a utiliza filtre BPF, permițând definiția unui număr mare de apeluri de sistem permise și chiar efectuarea de verificări asupra argumentelor acestora. (Interesant este că unul dintre primii utilizatori ai acestei funcționalități a fost Chrome, iar în prezent, echipa Chrome dezvoltă mecanismul KRSI, bazat pe o nouă versiune BPF, care permite personalizarea modulelor de securitate Linux.) Linkuri către documentația suplimentară pot fi găsite la sfârșitul articolului.
Aș dori să menționez că pe Habr au mai fost articole despre utilizarea seccomp, poate că unii ar dori să le citească înainte (sau în locul) secțiunilor următoare. În articolul sunt oferite exemple de utilizare a seccomp, atât din versiunea din 2007, cât și din versiunea care folosește BPF (filtrele sunt generate folosind libseccomp), se discută despre legătura dintre seccomp și Docker, precum și oferite multe linkuri utile. În articolul se discută, în special, despre cum să adăugăm liste negre sau albe de apeluri de sistem pentru demonii care rulează sub systemd.
Mai departe, ne vom uita la cum să scriem și să încărcăm filtre pentru seccomp în C brut și folosind biblioteca libseccomp și ce avantaje și dezavantaje are fiecare variantă, iar la final vom vedea cum este utilizat seccomp de către programul strace.
Scrierea și încărcarea filtrelor pentru seccomp
Deja știm să scriem programe BPF și, prin urmare, ne vom uita mai întâi la interfața de programare seccomp. Un filtru poate fi setat la nivel de proces, aceasta însemnând că toate procesele copil vor moșteni restricțiile. Acest lucru se face prin apelul de sistem :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)unde &filter — este un pointer către structura pe care o cunoaștem deja struct sock_fprog, adică programul BPF.
Cu ce se deosebesc programele pentru seccomp de programele pentru socket-uri? Prin contextul transmis. În cazul socket-urilor, ne era transmis un spațiu de memorie care conținea un pachet, iar în cazul seccomp, ne este transmis o structură de tip
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Aici nr — este numărul apelului de sistem apelat, arch — arhitectura curentă (despre aceasta în continuare), args — până la șase argumente ale apelului de sistem, iar instruction_pointer — este un indicator al instrucțiunii în spațiul utilizatorului care a efectuat această apel de sistem. Așadar, de exemplu, pentru a încărca numărul apelului de sistem în registru A trebuie să spunem
ldw [0]Pentru programele seccomp există și alte particularități, de exemplu, accesul la context este posibil doar pe aliniere de 32 de biți și nu se pot încărca jumătate de cuvânt sau byte — în cazul încercării de a încărca filtrul ldh [0] apelul de sistem seccomp va returna EINVAL. Verificarea filtrelor încărcate este efectuată de funcția a nucleului. (Din păcate, în commit-ul original care adăuga funcționalitatea seccomp, au uitat să adauge permisiunea de a folosi instrucția mod (restul împărțirii) și acum aceasta nu este disponibilă pentru programele BPF seccomp, deoarece adăugarea ei ABI.)
În principiu, deja știm tot ce trebuie pentru a scrie și a citi programele seccomp. În mod normal, logica programului este organizată ca o listă albă sau neagră de apeluri de sistem, de exemplu programul
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
verifică lista neagră de patru apeluri de sistem cu numerele 304, 176, 239, 279. Ce fel de apeluri de sistem sunt acestea? Nu putem spune exact, deoarece nu știm pentru ce arhitectură a fost scris programul. Prin urmare, autorii seccomp să începem toate programele cu verificarea arhitecturii (arhitectura curentă este indicată în context ca un câmp arch al structurii struct seccomp_data). Cu verificarea arhitecturii, începutul exemplului ar arăta astfel:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
și atunci numerele noastre de apeluri de sistem ar obține valori definite.
Scriem și încărcăm filtre pentru seccomp folosind libseccomp
Scrierea filtrelor în coduri mașină sau pentru asamblare BPF permite obținerea unui control total asupra rezultatului, dar în același timp, uneori, este preferabil să avem cod portabil și/sau lizibil. În acest sens, ne va ajuta biblioteca , care oferă o interfață standard pentru scrierea filtrelor negre sau albe.
Hai să scriem, de exemplu, un program care execută un fișier binar la alegerea utilizatorului, stabilind, anterior, o listă neagră de apeluri de sistem din (programul este simplificat pentru o mai bună citire, varianta completă poate fi găsită ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
La început, definim un array sys_numbers din peste 40 de numere ale apelurilor de sistem pentru blocare. Apoi, inițializăm contextul ctx și spunem bibliotecii că dorim să permitem (SCMP_ACT_ALLOW) toate apelurile de sistem în mod implicit (să construiești liste negre este mai simplu). Apoi, unul câte unul, adăugăm toate apelurile de sistem din lista neagră. Ca reacție la apelul de sistem din listă, cerem SCMP_ACT_TRAP, în acest caz seccomp va trimite procesului un semnal SIGSYS cu o descriere a apelului de sistem care a încălcat regulile. În cele din urmă, încărcăm programul în nucleu folosind seccomp_load, care va compila programul și îl va conecta la proces prin apelul de sistem seccomp(2).
Pentru a compila cu succes, programul trebuie legat cu biblioteca libseccomp, de exemplu:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Exemplu de rulare reușită:
$ .\/seccomp_lib echo ok
ok
Exemplu de apel de sistem blocat:
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Apel de sistem greșit
Vom folosi strace, pentru a afla detalii:
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ omorât de SIGSYS (dump core) +++
Apel de sistem greșit
de unde putem înțelege că programul a fost oprit din cauza utilizării unui apel de sistem interzis mount(2).
În concluzie, am scris un filtru folosind biblioteca libseccomp, comprimând codul non-trivial în patru linii. În exemplul de mai sus, în prezența unui număr mare de apeluri de sistem, timpul de execuție poate scădea semnificativ, deoarece verificarea este pur și simplu o listă de comparații. Pentru optimizare, recent în libseccomp a fost , care adaugă suport pentru atributul de filtru SCMP_FLTATR_CTL_OPTIMIZE. Dacă acest atribut este setat la 2, filtrul va fi transformat într-un program de căutare binară.
Dacă doriți să vedeți cum sunt construite filtrele cu căutare binară, aruncați o privire la , care generează astfel de programe în asamblare BPF pe baza unui set de numere ale apelurilor de sistem, de exemplu:
$ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Nu se poate scrie nimic semnificativ mai rapid, deoarece programele BPF nu pot face salturi condiționate (nu putem face, de exemplu, jmp A sau jmp [label+X]) și prin urmare toate salturile sunt statice.
seccomp și strace
Toată lumea cunoaște utilitarul strace — un instrument esențial pentru investigarea comportamentului proceselor pe Linux. Cu toate acestea, mulți sunt familiarizați cu când folosesc această utilitate. Problema este că strace este realizat prin intermediul ptrace(2), iar în acest mecanism nu putem specifica pe ce anume set de apeluri de sistem dorim să oprim procesul, adică, de exemplu, comenzile
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
și
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
se execută într-un interval de timp aproximativ identic, deși în cazul celui de-al doilea dorim să urmărim doar un apel de sistem.
O nouă opțiune --seccomp-bpf, adăugat în strace versiunea 5.3, permite accelerarea procesului de mai multe ori, iar timpul de lansare sub urmărire a unui apel de sistem este deja comparabil cu timpul unei lansări obișnuite:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Aici, evident, există o mică înșelăciune în faptul că nu urmărim apelul de sistem principal al acestei comenzi. Dacă am urmări, de exemplu, newfsstat, atunci strace ar încetini la fel de mult ca și fără --seccomp-bpf.)
Cum funcționează această opțiune? Fără ea strace se conectează la proces și îl lansează prin intermediul PTRACE_SYSCALL. Când procesul controlat lansează (orice) apel de sistem, controlul este predat strace, care examinează argumentele apelului de sistem și îl lansează prin intermediul PTRACE_SYSCALL. După un timp, procesul finalizează apelul de sistem și, la ieșirea din acesta, controlul este din nou predat strace, care examinează valorile returnate și rulează procesul prin intermediul PTRACE_SYSCALL, etc.
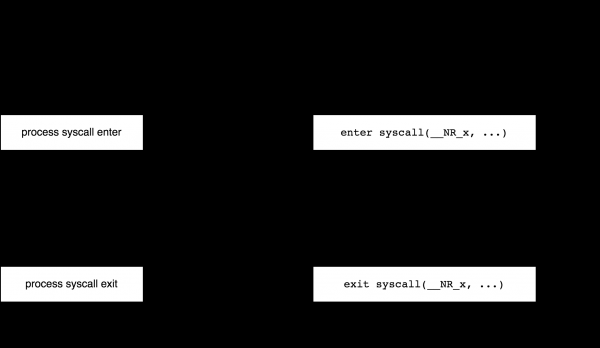
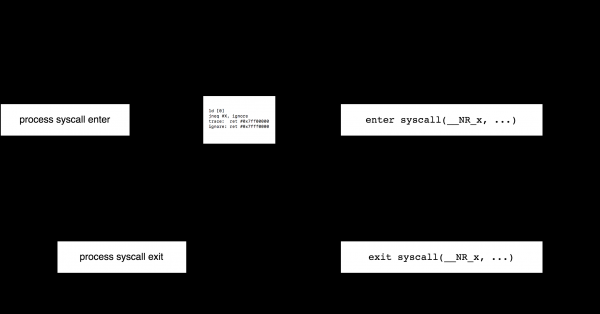
Cu ajutorul seccomp, totuși, acest proces poate fi optimizat exact așa cum ne-ar plăcea. Așadar, dacă dorim să ne concentrăm doar pe apelul de sistem X, putem scrie un filtru BPF care pentru X returnează valoarea SECCOMP_RET_TRACE, iar pentru apelurile care nu ne interesează — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
În acest caz strace inițial lansează procesul ca PTRACE_CONT, pentru fiecare apel de sistem se aplică filtrul nostru, dacă apelul de sistem nu este X, atunci procesul continuă să funcționeze, dar dacă este X, atunci seccomp va preda controlul strace, care va examina argumentele și va lansa procesul ca PTRACE_SYSCALL (deoarece în seccomp nu există posibilitatea de a rula un program la ieșirea dintr-un apel de sistem). Când apelul de sistem se va întoarce, strace va reporni procesul cu ajutorul PTRACE_CONT și va aștepta mesaje noi de la seccomp.
În utilizarea opțiunii --seccomp-bpf există două restricții. În primul rând, nu se poate alătura unui proces deja existent (opțiunea -p programe strace) deoarece acest lucru nu este suportat de seccomp. În al doilea rând, nu există posibilitatea nu de a observa procesele fiice, deoarece filtrele seccomp sunt moștenite de către toate procesele fiice fără capacitatea de a dezactiva aceasta.
Câteva detalii suplimentare despre cum anume strace funcționează cu seccomp poate fi obținut din . Ceea ce este cel mai interesant pentru noi este că BPF clasic în forma seccomp este încă folosit azi.
xt_bpf
Haideți să ne întoarcem acum în lumea rețelelor.
Context: cu mult timp în urmă, în 2007, în nucleu a fost modul xt_u32 pentru netfilter. A fost scris prin analogie cu un clasificator de trafic și mai vechi cls_u32 și permitea scrierea de reguli binare arbitrare pentru iptables prin următoarele operații simple: încărcați 32 de biți din pachet și aplicați-le un set de operații aritmetice. De exemplu,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Încărcați 32 de biți din antetul IP, începând cu offset-ul 6, și aplicați-le masca 0xFF (pentru a lua cel mai puțin semnificativ byte). Acesta este câmpul protocol antetului IP și îl comparăm cu 1 (ICMP). Într-o regulă, se pot combina multe verificări, iar de asemenea, se poate efectua operatorul @ — deplasați-vă cu X biți la dreapta. De exemplu, regula
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"verifică dacă numărul de secvență TCP 0x29. Nu voi intra în detalii, deoarece este deja clar că scrierea acestor reguli manual nu este foarte convenabilă. În articolul , există câteva linkuri cu exemple de utilizare și generare a regulilor pentru xt_u32. Consultați de asemenea linkurile de la finalul acestui articol.
Începând cu 2013, în loc de modulul xt_u32 poate fi folosit un modul bazat pe BPF. xt_bpfPentru toți cei care au citit până aici, principiul său de funcționare ar trebui să fie clar: rulează bytecode BPF ca reguli iptables. O nouă regulă poate fi creată, de exemplu, așa:
iptables -A INPUT -m bpf --bytecode -j LOGaici <байткод> — este codul în format de ieșire a asamblorului bpf_asm în mod implicit, de exemplu,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
În acest exemplu, filtrăm toate pachetele UDP. Contextul pentru programul BPF din modul xt_bpf, desigur, se referă la datele pachetului, în cazul iptables — la începutul antetului IPv4. Valoarea returnată din programul BPF , unde false indică faptul că pachetul nu a corespuns.
Este evident că modulul xt_bpf suportă filtre mai complexe decât în exemplul de mai sus. Să ne uităm la exemple reale de la Cloudflare. Până de curând, ei foloseau modul xt_bpf pentru a se proteja împotriva atacurilor DDoS. În articolul ei explică cum (și de ce) generează filtre BPF și publică linkuri către un set de utilitare pentru a crea astfel de filtre. De exemplu, cu ajutorul utilitarului bpfgen poți crea un program BPF care se potrivește unei cereri DNS pentru numele habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
În program, mai întâi încărcăm în registru X adresa de început a șirului x04habrx03comx00 din interiorul unui datagram UDP și apoi verificăm cererea: 0x04686162 "x04hab" etc.
Puțin mai târziu, Cloudflare a publicat codul compilatorului p0f -> BPF. În articolul ei discută despre ce este p0f și cum să convertești semnăturile p0f în BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
În prezent, Cloudflare nu mai folosește xt_bpf, deoarece au trecut la XDP — una dintre variantele de utilizare a versiunii actualizate a BPF, vezi: .
cls_bpf
Ultimul dintre exemplele de utilizare a BPF clasic în kernel este clasificatorul cls_bpf pentru subsistemul de control al traficului din Linux, adăugat în Linux la sfârșitul anului 2013 și înlocuind conceptual vechiul cls_u32.
Totuși, nu vom descrie acum funcționarea cls_bpf, deoarece din perspectiva cunoștințelor despre BPF clasic nu ne va aduce nimic nou — am învățat deja toată funcționalitatea. În plus, în articolele ulterioare, care vorbesc despre Extended BPF, ne vom întâlni din nou cu acest clasificator.
Un alt motiv pentru a nu discuta despre utilizarea BPF-ului clasic cu cls_bpf constă în faptul că, comparativ cu BPF-ul Extended, în acest caz domeniul de aplicare este drastic restrâns: programele clasice nu pot modifica conținutul pachetelor și nu pot păstra starea între apeluri.
Așadar, a venit vremea să ne luăm rămas bun de la BPF-ul clasic și să privim spre viitor.
Rămas bun de la BPF-ul clasic
Am privit cum tehnologia BPF, dezvoltată la începutul anilor ’90, a supraviețuit cu succes un sfert de secol și a găsit noi aplicații până în prezent. Cu toate acestea, similar cu tranziția de la mașinile pe stivă la RISC, care a dus la dezvoltarea BPF clasic, în anii 2000 a avut loc tranziția de la mașini pe 32 de biți la cele pe 64 de biți, iar BPF clasic a început să devină învechit. În plus, capacitățile BPF-ului clasic sunt extrem de limitate și, pe lângă arhitectura învechită, nu avem posibilitatea de a păstra starea între apelurile programelor BPF, nu putem interacționa direct cu utilizatorul și nu putem interacționa cu nucleul, în afară de a citi un număr limitat de câmpuri din structuri. sk_buff și a rula funcții ajutătoare de bază, nu putem modifica conținutul pachetelor și redirecționa.
De fapt, în prezent, de la BPF clasic în Linux a rămas doar interfața API, iar în interiorul nucleului toate programele clasice, fie că sunt filtre de socket sau filtre seccomp, sunt automat traduse într-un nou format, Extended BPF. (Vom explica cum exact se întâmplă acest lucru în articolul următor.)
Tranziția către noua arhitectură a început în 2013, când Alexey Starovoitov a propus un plan de actualizare a BPF. În 2014, patch-urile corespunzătoare în nucleu. Din câte înțeleg, inițial s-a planificat doar optimizarea arhitecturii și a JIT-compiler-ului pentru o funcționare mai eficientă pe mașinile pe 64 de biți, dar în loc de aceasta, aceste optimizări au pus bazele unei noi etape în dezvoltarea Linux.
Articolele ulterioare din această serie vor relata despre arhitectura și aplicațiile noii tehnologii, cunoscută inițial sub numele de internal BPF, apoi extended BPF, iar acum pur și simplu BPF.
Linkuri
- Steven McCanne și Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — bytecode-ul uitat:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Introducerea instrumentului BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- O prezentare generală seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: o privire sub capotă",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Sursa: habr.com
