

Astăzi există 100500 de cursuri de Data Science și este bine cunoscut că cei mai mulți bani din Data Science pot fi câștigați tocmai din cursurile de Data Science (de ce să te apuci de muncă, când poți vinde lopeți?). Principala problemă a acestor cursuri este că nu au nimic în comun cu munca reală: nimeni nu îți va oferi date curate și prelucrate în formatul dorit. Și când ieși de la cursuri și începi să rezolvi o problemă reală – apar multe nuanțe.
De aceea, începem o serie de articole intitulate „Ce poate merge prost cu Data Science”, bazate pe evenimente reale întâmplate cu mine, colegii și prietenii mei. Vom analiza exemple reale de probleme tipice de Data Science: cum se petrece realmente. Astăzi vom începe cu problema colectării datelor.
Și prima dificultate cu care se confruntă oamenii atunci când încep să lucreze cu date reale este, de fapt, colectarea acelor date relevante pentru noi. Mesajul cheie al acestui articol:
Subestimăm în mod sistematic timpul, resursele și eforturile necesare pentru colectarea, curățarea și pregătirea datelor.
Și, mai presus de toate, vom discuta despre ce să facem pentru a preveni acest lucru.
Potrivit unor estimări, curățarea, transformarea, procesarea datelor, ingineria caracteristicilor etc. ocupă 80-90% din timp, în timp ce analiza durează 10-20%, deși practic tot materialul de studiu se concentrează exclusiv pe analiză.
Să analizăm un exemplu tipic de problemă analitică în trei variante și să vedem cum apar „circumstanțele agravante”.
Și, pentru exemplu, vom analiza asemenea variații ale problemei colectării datelor și comparării comunităților pentru:
- Două subreddit-uri Reddit
- Două secțiuni de pe Habr
- Două grupuri de pe Odnoklassniki
Abordarea teoretică condiționată
Deschide site-ul și citește exemplele; dacă înțelegi, alocă câteva ore pentru lectură, câteva ore pentru codul din exemple și depanare. Adaugă câteva ore pentru colectare. Între timp, adaugă câteva ore ca rezervă (multiplică cu două și adaugă N ore).
Punctul cheie: estimarea timpului se bazează pe presupuneri și conjeturi cu privire la cât timp va dura.
Analiza timpului trebuie să înceapă cu evaluarea următorilor parametri pentru problema condiționată descrisă mai sus:
- Care este dimensiunea datelor și cât trebuie să adunăm fizic (*vezi mai jos*).
- Care este timpul de colectare a unei înregistrări și cât trebuie să aștepți înainte de a putea colecta a doua.
- Implementați un cod care să păstreze starea și să înceapă un restart, când (nu dacă) totul va cădea.
- Determinați dacă avem nevoie de autentificare și alocați timp pentru a obține accesul prin API.
- Includeți numărul de erori ca o funcție a complexității datelor — evaluați în funcție de sarcina specifică: structura, câte transformări, ce și cum extragem.
- Includeți erorile de rețea și problemele cu comportamentele neconvenționale ale proiectului.
- Evaluați dacă funcțiile necesare se află în documentație și, dacă nu, atunci cât și cum este necesar pentru o soluție alternativă.
Cel mai important, pentru a evalua timpul — de fapt, trebuie să investiți timp și efort în «explorarea situației» — doar atunci planificarea dvs. va fi adecvată. Așadar, oricât de mult ați fi împinși să spuneți «cât timp este necesar pentru a colecta datele» — acordați-vă timp pentru o analiză preliminară și argumentați că timpul va varia în funcție de parametrii reali ai sarcinii.
Și acum vă vom demonstra exemple specificate, unde astfel de parametri vor varia.
Punctul cheie: evaluarea este bazată pe analiza factorilor cheie care influențează volumul și complexitatea muncii.
O evaluare bazată pe presupuneri este o abordare bună atunci când elementele funcționale sunt destul de mici și nu sunt atât de multe factori care pot influența semnificativ structura sarcinii. Dar în cazul mai multor sarcini de Data Science, acești factori devin extrem de numeroși și abordarea devine inadecvată.
Compararea comunităților Reddit
Să începem cu cea mai simplă situație (așa cum se va dovedi ulterior). De fapt, dacă suntem complet onești, avem practic un caz ideal, să verificăm lista noastră de verificare a complexității:
- Există un API clar, bine documentat și înțelegător.
- Extrem de simplu și, cel mai important, obținem token-ul automat.
- Există — cu o mulțime de exemple.
- Comunitatea care se ocupă cu analiza și colectarea datelor pe Reddit (inclusiv videoclipuri YouTube explicând cum să utilizați python wrapper) .
- Metodele de care avem nevoie există probabil în API. Mai mult, codul arată compact și curat, mai jos este un exemplu de funcție care colectează comentarii la postare.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Preluat din colecții de utilitare convenabile pentru ambalare.
Deși avem în față cea mai bună situație, trebuie să luăm în considerare o serie de factori importanți din viața reală:
- Limitele API-ului — suntem nevoiți să luăm datele în batch-uri (să așteptăm între cereri etc.).
- Timpul de colectare — pentru o analiză și comparare completă, va trebui să alocăm un timp considerabil doar pentru ca spider-ul să traverseze subreddit-ul.
- Botul trebuie să ruleze pe server — nu poți pur și simplu să-l pornești pe laptop, să-l pui în rucsac și să pleci în afaceri. Așa că am rulat totul pe VPS. Cu codul promoțional habrahabr10 poți economisi încă 10% din cost.
- Accesibilitatea fizică a unor date (care sunt vizibile doar pentru administratori sau care sunt prea greu de colectat) — trebuie să ții cont de asta, nu toate datele pot fi colectate într-un timp rezonabil.
- Erorile de funcționare a rețelei: lucrul cu rețeaua poate fi o provocare.
- Acestea sunt date reale — nu sunt niciodată curate.
Desigur, este necesar să planifici aceste nuanțe în dezvoltare. Orele/zilele concrete depind de experiența de dezvoltare sau de experiența în lucrul cu sarcini similare, totuși vedem că aceasta este o sarcină pur tehnică și nu necesită mișcări suplimentare pentru a fi rezolvată — totul poate fi evaluat foarte bine, detaliat și realizat.
Compararea secțiunilor Habr
Trecem la o situație mai interesantă și mai non-trivială comparând fluxurile și/sau secțiunile Habr.
Să verificăm lista noastră de control pentru dificultăți — aici, pentru a înțelege fiecare punct, va trebui să interacționăm puțin cu sarcina în sine și să experimentăm.
- La început crezi că există API, dar nu este. Da, Habr are API, dar acesta nu este disponibil pentru utilizatori (sau poate nu funcționează deloc).
- Apoi pur și simplu începi să parsezi HTML — „import requests”, ce ar putea să meargă rău?
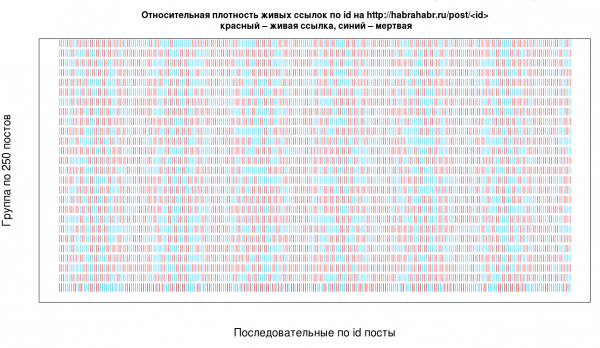
- Și cum se face de fapt parsarea? Cea mai simplă și frecvent utilizată abordare este să iterezi prin ID-uri, observăm că nu este cea mai eficientă și va trebui să gestionăm diverse cazuri — ca exemplu, densitatea reală a ID-urilor printre toate cele existente.

Preluat din articolului. - Datele brute, înfășurate în HTML pe tot internetul – reprezintă o adevărată durere. De exemplu, vrei să colectezi și să salvezi ratingul unui articol: ai extras score din html și ai decis să-l salvezi ca număr pentru procesări ulterioare:
1) int(score) generează o eroare: deoarece pe Habr minusul, cum ar fi în șirul "–5" – este un ghilimele scurt, nu un semn minus (neobișnuit, nu-i așa?), astfel că, într-un moment, a trebuit să reactualizez parserul cu o astfel de corectare îngrozitoare.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Datele, plusurile și minusurile pot să nu existe deloc (așa cum vedem mai sus în funcția check_date și s-a întâmplat).
2) Caracteristicile speciale neescapate – ele vor veni, trebuie să fim pregătiți.
3) Structura se schimbă în funcție de tipul postării.
4) Postările mai vechi pot avea **o structură ciudată**.
- Practica gestionării erorilor și a ceea ce poate sau nu poate să se întâmple va trebui tratată, iar nu poți anticipa sigur ce va merge prost și cum ar putea să arate structura sau ce anume va cădea – va trebui pur și simplu să încerci și să iei în considerare erorile pe care le aruncă parserul.
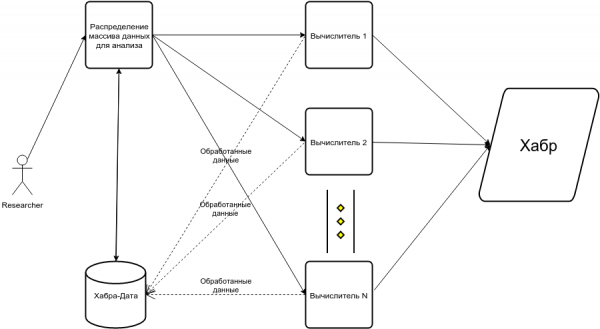
- Apoi, îți dai seama că trebuie să parsezi în mai multe fire, altfel parcarea într-un singur fir va dura 30+ ore (asta este pur și simplu timpul de execuție al parserului funcțional pe un singur fir, care doarme și nu este supus la niciun ban). În articol, aceasta a condus în vreun moment la o schemă similară:
Prin urmare, lista de verficare conform dificultății:
- Lucrul cu rețeaua și parcarea html cu iterație și parcurgerea pe ID.
- Documentele au o structură heterogenă.
- Multe locuri unde codul poate cădea cu ușurință.
- Este necesar să scrii || cod.
- Lipsesc documentația, exemplele de cod și/sau comunitatea necesară.
Evaluarea condiționată a timpului pentru această sarcină va fi de 3-5 ori mai mare decât pentru colectarea datelor de pe Reddit.
Compararea grupurilor de pe Odnoklassniki
Să trecem la cel mai tehnic caz interesant dintre cele descrise. Pentru mine a fost captivant tocmai pentru că, la prima vedere, pare destul de trivial, dar de fapt nu este deloc – de îndată ce dai cu stick-ul în el.
Va începe cu lista noastră de verificare a dificultății și să notăm că multe dintre ele se vor dovedi a fi mult mai complicate decât par la început:
- Există API, dar majoritatea funcțiilor necesare lipsesc aproape complet.
- Pentru anumite funcții trebuie să ceri acces prin email, adică acordarea accesului nu este instantanee.
- Documentația este extrem de slabă (începând cu amestecarea constantă a termenilor ruși și englezești, într-o manieră complet inconsistentă — uneori trebuie doar să ghicești ce vor de la tine) și, mai mult decât atât, nu este adaptată designului pentru extragerea datelor, de exemplu, .
- Cere sesiune în documentație, iar în realitate nu o folosește — și nu există nicio modalitate de a înțelege toate nuanțele modurilor API, în afară de a încerca și a spera că ceva va funcționa.
- Lipsesc exemple și comunitatea, singura sursă de informare fiind un mic în Python (fără multe exemple de utilizare).
- Cel mai practic pare a fi Selenium, deoarece multe date necesare sunt blocate.
1) Adică, autentificarea se face printr-un utilizator fictiv (și înregistrarea manuală).2) Totuși, cu Selenium nu există garanții pentru o funcționare corectă și repetabilă (cel puțin în cazul ok.ru cu siguranță).
3) Site-ul Ok.ru conține erori JavaScript și uneori se comportă ciudat și inconsistent.
4) Trebuie să te ocupi de paginare, încărcarea elementelor etc…
5) Erorile API returnate de wrapper trebuie procesate pe cale improvizată, de exemplu, așa (un fragment de cod experimental):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Cea mai dragă eroare a mea a fost:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) În cele din urmă, combinația Selenium + API pare a fi cea mai rațională opțiune.
- Este necesară menținerea stării și repornirea sistemului, gestionarea multor erori, inclusiv comportamente inconsistente ale site-ului — iar aceste erori sunt destul de greu de imaginat (dacă nu scrii profesional parsere, evident).
Estimarea condiționată a timpului pentru această sarcină va fi de 3-5 ori mai mare decât pentru extragerea datelor de pe Habr. Deși în cazul Habr utilizăm o abordare frontală prin parsarea HTML-ului, în cazul OK putem lucra în locuri critice cu API.
Conclusions
Indiferent de cât de mult ar solicita evaluarea termenelor "la fața locului" (avem planificare astăzi!), volumul modulului pipeline-ului de procesare a datelor este practic imposibil de evaluat calitativ fără o analiză a parametrilor sarcinii.
Dacă vorbim puțin mai filozofic, strategiile de evaluare în agile se potrivesc bine pentru sarcini ingineresti, dar pentru sarcini mai experimentale și, într-un anumit sens, "creaționale" și de cercetare, adică mai puțin previzibile, apar dificultăți, așa cum sunt exemplele pe care le-am discutat aici.
Desigur, colectarea datelor este un exemplu ilustrativ clar - de obicei, această sarcină pare incredibil de simplă și tehnic necomplicată, iar tocmai în detalii se ascunde adesea diavolul. Această sarcină ilustrează întregul spectru de variante posibile a ceea ce poate merge prost și cât de mult poate dura efectiv munca.
Dacă aruncăm o privire pe specificațiile sarcinii fără experimente suplimentare, Reddit și OK par asemănătoare: există API, wrapper python, dar esențial, diferența este enormă. Dacă judecăm după acești parametri, parsingul Habr pare mai complicat decât OK - dar în practică este exact invers și acest lucru poate fi descoperit efectuând experimente simple pentru analiza parametrilor sarcinii.
Din experiența mea, cea mai eficientă abordare este o estimare aproximativă a timpului necesar pentru analiza preliminară și primele experimente simple, citirea documentației - acestea vă vor permite să oferiți o evaluare exactă pentru întreaga muncă. În termeni de metodologie populară agile - vă rog să deschideți un tichet pentru „evaluarea parametrilor sarcinii”, pe baza căruia pot oferi o evaluare a ceea ce este posibil să se finalizeze în cadrul „sprintului” și să ofer o estimare mai precisă pentru fiecare sarcină.
Prin urmare, cel mai eficient, pare a fi argumentul care ar putea arăta unui specialist "non-tehnic" cât de mult va varia timpul și resursele în funcție de parametrii care urmează să fie evaluați.
Sursa: habr.com
