

Bună! Numele meu este Vadim Madison, conduc dezvoltarea System Platform Avito. A fost spus neîncetat cum trecem de la o arhitectură monolitică la una bazată pe microservicii. E timpul să împărtășim cum ne-am transformat infrastructura pentru a obține cele mai mari beneficii din microservicii și a nu ne pierde în ele. Cum ne ajută PaaS aici, cum am simplificat desfășurarea și am redus crearea unui microserviciu la un singur clic — citiți mai departe. Nu tot ce scriu mai jos este implementat în întregime la Avito, o parte — este cum dezvoltăm platforma noastră.
(Și la sfârșitul acestui articol vă voi povesti despre oportunitatea de a participa la un seminar de trei zile cu expertul în arhitectura microserviciilor, Chris Richardson).
Cum am ajuns la microservicii
Avito este unul dintre cele mai mari site-uri de clasificare din lume, pe el fiind publicate peste 15 milioane de anunțuri noi pe zi. Backend-ul nostru gestionează peste 20.000 de solicitări pe secundă. Acum avem câteva sute de microservicii.
Arhitectura microserviciilor a fost construită de noi nu de un an. Cum anume — colegii noștri în detalii în secțiunea noastră de la RIT++ 2017. La CodeFest 2017 (vezi ), Sergey Orlov și Mikhail Prokopchuk au explicat detaliat de ce am avut nevoie de această tranziție la microservicii și ce rol a jucat Kubernetes aici. Acum facem tot posibilul să minimizăm costurile de scalare specifice unei astfel de arhitecturi.
Inițial, nu am creat un ecosistem care să ne sprijine pe deplin în dezvoltarea și lansarea microserviciilor. Am adunat doar soluții open-source inteligente, le-am lansat pe ale noastre și am lăsat dezvoltatorul să se descurce. Ca urmare, acesta mergea în zeci de locuri (dashboards, servicii interne), după care se întărea în dorința de a scrie cod în stilul vechi, în monolit. În verde sunt marcate în schemele de mai jos ceea ce face dezvoltatorul, iar în galben — automatizarea.
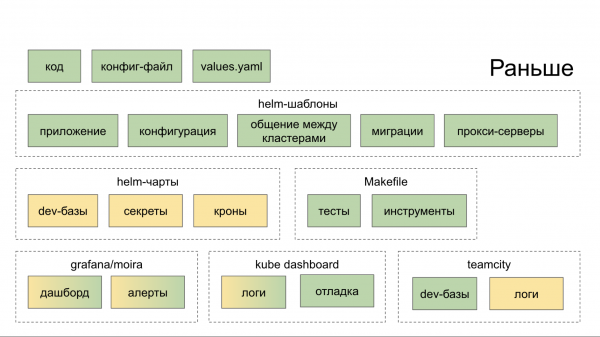
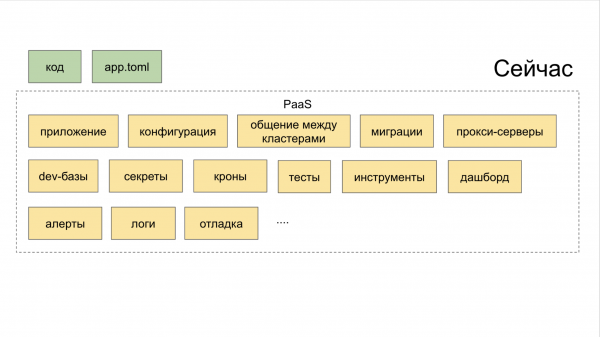
Acum, cu utilitarul CLI PaaS, un nou serviciu este creat cu o singură comandă, iar două comenzi adaugă o nouă bază de date și o desfășoară în Stage.
Cum să depășim epoca „fragmentării microserviciilor”
În arhitectura monolitică, din cauza coerenței schimbărilor în produs, dezvoltatorii au fost nevoiți să înțeleagă ce se întâmplă la vecini. În noua arhitectură, contextele serviciilor au încetat să depindă unele de altele.
În plus, pentru ca arhitectura microserviciilor să fie eficientă, este necesar să fie stabilite numeroase procese, și anume:
• logare;
• trasare a cererilor (Jaeger);
• agregarea erorilor (Sentry);
• statusuri, mesaje, evenimente din Kubernetes (Procesare a fluxului de evenimente);
• limitarea competiției / întrerupător de circuit (se poate utiliza Hystrix);
• controlul conectivității serviciilor (folosim Netramesh);
• monitorizare (Grafana);
• compilare (TeamCity);
• comunicare și notificare (Slack, email);
• urmărirea sarcinilor; (Jira)
• elaborarea documentației.
Pentru ca sistemul să nu își piardă integritatea și să rămână eficient pe măsură ce se scalează, am reconsiderat organizarea muncii microserviciilor în Avito.
Cum gestionăm microserviciile
O politică unitară între numeroasele microservicii Avito este susținută de:
- împărțirea infrastructurii în straturi;
- conceptul Platform as a Service (PaaS);
- monitorizarea tot ce se întâmplă cu microserviciile.
Nivelurile de abstractizare ale infrastructurii includ trei straturi. Să trecem de la partea superioară la cea inferioară.
A. Superior — mesh de servicii. La început, am încercat Istio, dar s-a dovedit că folosește prea multe resurse, ceea ce devine prea scump pentru volumele noastre. Așadar, inginerul senior din echipa de arhitectură, Alexander Lukiantsenko, a dezvoltat o soluție proprie — (disponibilă în Open Source), pe care o folosim acum în producție și care consumă de câteva ori mai puține resurse decât Istio (dar nici nu face tot ceea ce poate Istio).
B. Mediu — Kubernetes. Pe acesta desfășurăm și exploatăm microserviciile.
C. Inferior — bare metal. Nu folosim cloud-uri sau soluții precum OpenStack, ci ne bazăm exclusiv pe bare metal.
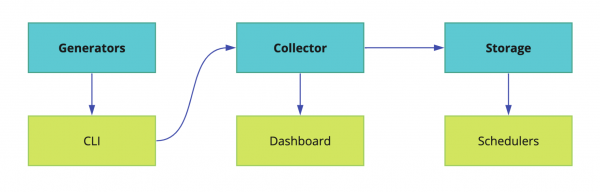
Toate straturile se reunesc în PaaS. Iar această platformă, la rândul ei, constă din trei părți.
I. Generatoare, gestionate printr-o unealtă CLI. Aceasta îl ajută pe dezvoltator să creeze un microserviciu corect și cu un efort minim.
II. Colecționarul unificat cu controlul tuturor instrumentelor printr-un tablou de bord comun.
III. Depozitul. Se integrează cu planificatorii care generează automat declanșatoare pentru acțiuni semnificative. Datorită acestui sistem, nicio sarcină nu este omisă doar pentru că cineva a uitat să își adauge o sarcină în Jira. Folosim un instrument intern numit Atlas pentru acest lucru.
Implementarea microserviciilor în Avito se realizează, de asemenea, conform unei scheme unice, ceea ce simplifică controlul asupra acestora în fiecare etapă a dezvoltării și lansării.
Cum este organizat canalul standard de dezvoltare a unui microserviciu
În termeni generali, lanțul de creație al unui microserviciu arată astfel:
CLI-push → Integrare Continuă → Bake → Deploy → Teste artificiale → Teste Canary → Squeeze Testing → Producție → Întreținere.
Vom parcurge aceasta exact în această ordine.
CLI-push
• Crearea unui microserviciu.
Am depus mult efort pentru a-i învăța pe fiecare dezvoltator să creeze microservicii. Am redactat inclusiv instrucțiuni detaliate în Confluence. Dar schemele s-au schimbat și au fost completate. Rezultatul — a apărut un gât de sticlă la începutul procesului: lansarea microserviciilor dura mult mai mult decât era acceptabil, iar totuși, la crearea lor apăreau adesea probleme.
În cele din urmă, am construit un utilitar CLI simplu care automatizează pașii de bază în crearea unui microserviciu. De fapt, acesta înlocuiește prima împingere git. Iată ce face concret.
— Creează un serviciu conform unui șablon — pas cu pas, în modul „wizard”. Avem șabloane pentru principalele limbaje de programare în backend-ul Avito: PHP, Golang și Python.
— Cu o singură comandă, desfășoară mediul pentru dezvoltarea locală pe un anumit calculator — se ridică Minikube, iar graficele Helm sunt generate și lansate automat în Kubernetes local.
— Conectează baza de date necesară. Dezvoltatorului nu îi este necesar să știe IP-ul, loginul și parola pentru a accesa baza de date de care are nevoie — fie local, fie în Stage, fie în producție. De asemenea, baza de date se desfășoară imediat în configurație rezistentă la erori și cu echilibrare a sarcinii.
— Efectuează singură o compilare live. Să zicem că dezvoltatorul a făcut o corectare în microserviciu prin intermediul IDE-ului său. Utilitarul detectează modificările în sistemul de fișiere și pe baza acestora recompune aplicația (pentru Golang) și o repornește. Pentru PHP, pur și simplu redirecționăm directorul în interiorul containerului și acolo live-reload-ul se realizează „automat”.
— Generează teste automate. Sub formă de șabloane, dar complet utilizabile.
• Implementare microserviciu.
Implementarea microserviciului a fost anterior un pic complicată. Era necesară în mod obligatoriu:
I. Dockerfile.
II. Configurație.
III. Helm chart, care în sine era voluminos și includea:
— chart-urile;
— șabloanele;
— valorile specifice, având în vedere diferitele medii.
Am scăpat de durerea rehacării manifestelor Kubernetes, iar acum ele se generează automat. Dar cel mai important, am simplificat la maximum implementarea. Acum avem Dockerfile, iar întreaga configurație este specificată de dezvoltator într-un singur fișier scurt app.toml.
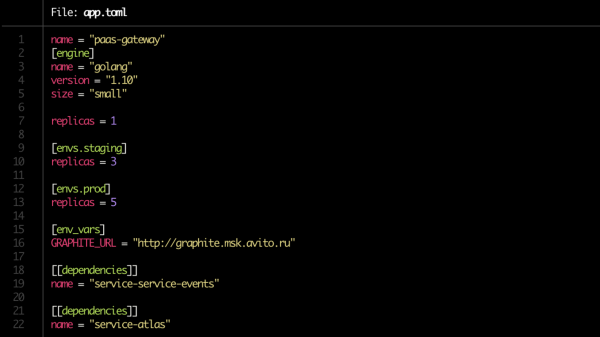
De asemenea, în app.toml acum durează un minut. Specificăm câte instanțe ale serviciului trebuie să fie activate (pe serverul de dezvoltare, pe staging, în producție), indicăm dependențele. Acordați atenție liniei size = "small" în blocul [engine]. Aceasta este limita care va fi alocată serviciului prin Kubernetes.
Pe baza configurației, toate chart-urile Helm necesare sunt generate automat și se creează conexiuni către bazele de date.
• Validare de bază. Aceste verificări sunt, de asemenea, automatizate.
Trebuie să monitorizăm:
— dacă există Dockerfile;
— dacă există app.toml;
— dacă există documentație;
— dacă dependențele sunt în ordine;
— dacă regulile de alerte sunt stabilite.
La ultimul punct: deținătorul serviciului specifică ce metrice de produs trebuie monitorizate.
• Pregătirea documentației.
Încă un loc problematic. Pare să fie cel mai evident, dar în același timp este „uitat” extrem de frecvent, astfel devenind un verigă vulnerabilă în lanț.
Este necesar ca documentația să fie pentru fiecare microserviciu. Aceasta include blocurile următoare.
I. Descriere scurtă a serviciului. Doar câteva propoziții despre ce face și la ce este necesar.
II. Link către diagrama arhitecturii. Este important ca, la o privire rapidă, să puteți înțelege, de exemplu, dacă folosiți Redis pentru caching sau ca depozit principal de date în mod persistent. La Avito, în prezent, este un link către Confluence.
III. Runbook. O scurtă ghidare pentru pornirea serviciului și detalii de utilizare.
IV. FAQ, unde ar fi bine să anticipați problemele cu care colegii dumneavoastră ar putea întâlni în lucrul cu serviciul.
V. Descrierea endpoint-urilor pentru API. Dacă nu ați specificat destinațiile, este aproape sigur că colegii dvs. care au microservicii legate de al dvs. vor suporta consecințele. În prezent, utilizăm Swagger și soluția noastră numită brief pentru aceasta.
VI. Etichete. Sau markere care indică la ce produs, funcționalitate sau structură organizațională a companiei se referă serviciul. Acestea ajută la înțelegerea rapidă, de exemplu, dacă nu cumva implementați o funcționalitate pe care colegii dvs. au lansat-o acum o săptămână pentru același unitate de afaceri.
VII. Proprietarul sau proprietarii serviciului. În majoritatea cazurilor, acesta — sau aceștia — poate fi determinați automat prin intermediul PaaS, dar pentru siguranță cerem dezvoltatorului să îi indice și manual.
În cele din urmă, o practică bună este să efectuați revizuiri ale documentației, similare cu revizuirile de cod.
Continuous Integration
- Pregătirea repositoarelor.
- Crearea pipeline-ului în TeamCity.
- Stabilirea drepturilor.
- Căutarea proprietarilor serviciului. Aici se utilizează un sistem hibrid — marcare manuală și automatizare minimă de la PaaS. Un sistem complet automatizat poate avea erori la transferul serviciilor în suportul unei alte echipe de dezvoltare sau, de exemplu, dacă dezvoltatorul serviciului a fost concediat.
- Înregistrarea serviciului în Atlas (vezi mai sus). Cu toți proprietarii și dependențele sale.
- Verificarea migrațiilor. Verificăm dacă printre ele există potențial periculoase. De exemplu, în una dintre ele apare un alter table sau altceva care ar putea afecta compatibilitatea schemei de date între diferite versiuni ale serviciului. În acest caz, migrarea nu se efectuează, ci se pune în așteptare — PaaS trebuie să-i semnaleze proprietarului serviciului când devine sigur să o aplice.
Bake
Următoarea etapă este ambalarea serviciilor înainte de deployment.
- Compilarea aplicației. După cum se obișnuiește — într-un imagine Docker.
- Generarea chart-urilor Helm pentru serviciu și resursele asociate. Inclusiv pentru baze de date și cache. Acestea sunt generate automat conform configurației app.toml, care a fost creată în etapa de CLI-push.
- Crearea tichetelor pentru administratori pentru deschiderea porturilor (când este necesar).
- Executarea testelor unitare și calcularea acoperirii codului. Dacă acoperirea codului este sub valoarea de prag specificată, este foarte probabil ca serviciul să nu treacă mai departe la desfășurare. Dacă este la limita permisibilului, serviciului i se va atribui un coeficient „pessimizator”: astfel, în absența unor îmbunătățiri ale indicatorului în timp, dezvoltatorul va primi o notificare că nu există progres în ceea ce privește testele (și ar trebui să facă ceva în legătură cu asta).
- Întreținerea restricțiilor privind memoriile și CPU. În principal, microserviciile le scriem în Golang și le lansăm în Kubernetes. Aici apare o subtilitate legată de particularitatea limbajului Golang: implicit, la lansare se folosesc toate nucleele de pe mașină, cu excepția cazului în care se setează explicit variabila GOMAXPROCS, iar atunci când pe o mașină sunt lansate mai multe astfel de servicii, acestea încep să concurențeze pentru resurse, afectându-se reciproc. În graficele de mai jos este arătat cum variază timpul de execuție dacă se lansează aplicația fără concurență și în modul de competiție pentru resurse. (Sursă graficelor se află la ).
Timpul de execuție, cu cât mai mic, cu atât mai bine. Maxim: 643ms, minim: 42ms. Fotografia este clicabilă.
Timpul pentru operație, cu cât mai mic, cu atât mai bine. Maxim: 14091 ns, minim: 151 ns. Fotografia este clicabilă.
În etapa de pregătire a compilării, este posibil să setăm explicit această variabilă sau putem folosi biblioteca de la echipa Uber.
Deploy
• Verificarea convențiilor. Înainte de a începe livrarea compilărilor serviciului în medii prestabilite, trebuie să verificați următoarele:
— API endpoints.
— Conformitatea răspunsurilor endpoint-urilor API cu schema.
— Formatul jurnalelor.
— Setarea antetelor în cererile către serviciu (acum este realizată de netramesh)
— Setarea unui marcator de proprietar la trimiterea mesajelor în bară (event bus). Acest lucru este necesar pentru a urmări coeziunea serviciilor prin bară. În bară pot fi trimise atât date idempotente, care nu cresc coeziunea serviciilor (ceea ce este bine), cât și date de afaceri, care întăresc coeziunea serviciilor (ceea ce este foarte rău!). Iar în momentul în care această coeziune devine o problemă, înțelegerea a cine scrie și citește din bară ajută la separarea corectă a serviciilor.
Deocamdată, convențiile în Avito nu sunt foarte multe, dar pool-ul acestora se extinde. Cu cât există mai multe astfel de acorduri într-o formă, ușor de înțeles și comodă pentru echipă, cu atât mai simplu este să menții coerența între microservicii.
Teste sintetice
• Testare într-un contur închis. Pentru aceasta, acum folosim o soluție open-source . În primul rând, înregistrează sarcina reală pe serviciu, apoi - exact în circuitul închis - o emulează.
• Testarea încărcării. Încercăm să aducem toate serviciile la o performanță optimă. Iar toate versiunile fiecărui serviciu trebuie să fie supuse testării încărcării - astfel putem înțelege performanța curentă a serviciului și diferența față de versiunile anterioare ale aceluiași serviciu. Dacă, după actualizarea serviciului, performanța sa scade cu o dată și jumătate, acesta este un semnal clar pentru proprietarii săi: trebuie să analizeze codul și să rezolve situația.
Pe baza datelor colectate, ne bazăm, de exemplu, pentru a implementa corect auto scaling-ul și, în cele din urmă, pentru a înțelege cât de mult poate fi scalat serviciul.
În timpul testării încărcării, verificăm dacă consumul de resurse respectă limitările stabilite. Și ne concentrăm în special pe extreme.
a) Ne uităm la sarcina totală.
— Dacă este prea mică - probabil că ceva nu funcționează deloc, dacă sarcina a scăzut brusc de câteva ori.
— Dacă este prea mare - este necesară optimizarea.
b) Ne uităm la limita pe RPS.
Aici ne uităm la diferența dintre versiunea curentă și cea anterioară și la numărul total. De exemplu, dacă serviciul oferă 100 rps - atunci fie este prost scris, fie aceasta este specificația sa, dar în orice caz, este un motiv să examinăm sistemul foarte atent.
Dacă RPS este, dimpotrivă, prea mare, atunci, poate, există un bug și unul dintre endpoint-uri a încetat să execute sarcina utilă și pur și simplu activează un return true;
Testele Canary
După ce au fost efectuate testele sintetice, testăm funcționarea microserviciului cu un număr mic de utilizatori. Începem cu prudență, cu o fracțiune minusculă din publicul estimat al serviciului - mai puțin de 0,1%. În această etapă, este foarte important ca în monitorizare să fie definite metrice tehnice și de produs corecte, astfel încât să arate problema în serviciu cât mai repede posibil. Timpul minim al testului canary este de 5 minute, iar cel principal - 2 ore. Pentru serviciile complexe, stabilim timpul manual.
Analizăm:
— metrice specifice limbajului, în special, lucrătorii php-fpm;
— erori în Sentry;
— statusurile răspunsurilor;
— timpii de răspuns (response time), atât exacti, cât și medii;
— latență;
— excepții, procesate și neprocesate;
— metrice de produs.
Testarea Squeeze
Testarea de Squeeze este cunoscută și sub denumirea de testare prin „stoarcere”. Denumirea metodei a fost introdusă de Netflix. Esența acesteia constă în faptul că inițial umplem o instanță cu trafic real până la starea de eșec și astfel stabilim limita acesteia. Apoi adăugăm încă o instanță și încărcăm această pereche — din nou până la maxim; vedem plafonul acestora și delta față de primul „squeeze”. Și așa conectăm câte o instanță pe rând și calculăm regularitatea în schimbări.
Datele din testele prin „stoarcere” se acumulează de asemenea într-o bază comună de metrici, unde fie le îmbogățim pe cele din rezultate generate artificial, fie le înlocuim complet cu „sintetice”.
Producție
• Scalare. Când lansăm serviciul în producție, urmărim cum se scalează. Din experiența noastră, a monitoriza doar indicatorii CPU nu este eficient. Scalarea automată cu benchmarking RPS în forma sa pură funcționează, dar doar pentru anumite servicii, cum ar fi streaming-ul online. Așadar, ne uităm în primul rând la metricile specifice produsului pentru aplicație.
În final, în timpul scalării, analizăm:
— indicatorii CPU și RAM,
— numărul de cereri în coadă,
— timpul de răspuns,
— prognoza bazată pe date istorice acumulate.
De asemenea, este important să monitorizăm dependențele serviciului în timpul scalării, pentru a evita situația în care scalăm primul serviciu din lanț, iar cele la care acesta se conectează cedează sub încărcătură. Pentru a stabili o încărcătură acceptabilă pentru întregul grup de servicii, ne uităm la datele istorice ale serviciului dependent „cel mai apropiat” (în funcție de combinația indicatorilor CPU și RAM împreună cu metricile specifice aplicației) și le comparăm cu datele istorice ale serviciului inițiator, și așa mai departe pe întreaga „lanț de dependențe”, de sus în jos.
Întreținere
După ce microserviciul a fost activat, putem adăuga declanșatoare.
Iată situațiile tipice în care se activează declanșatoarele.
— Au fost detectate migrații potențial periculoase.
— Au fost emise actualizări de securitate.
— Serviciul nu a fost actualizat de mult.
— Sarcina pe serviciu a scăzut considerabil sau anumite metrici de produs ies din limitele normale.
— Serviciul nu mai corespunde noilor cerințe ale platformei.
O parte din triggere este responsabilă pentru stabilitatea funcționării, o altă parte — ca funcție de întreținere a sistemului — de exemplu, un anumit serviciu nu a fost implementat de mult timp și imaginea sa de bază nu mai trece verificarea de securitate.
Tabloul de bord
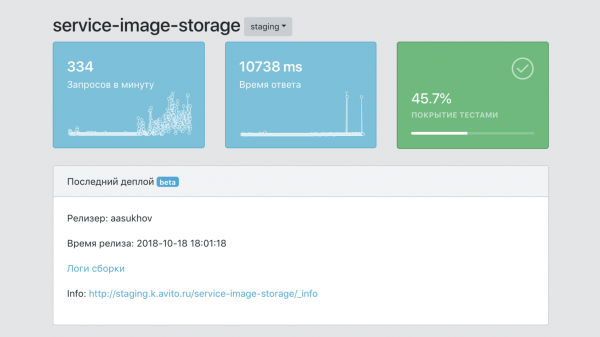
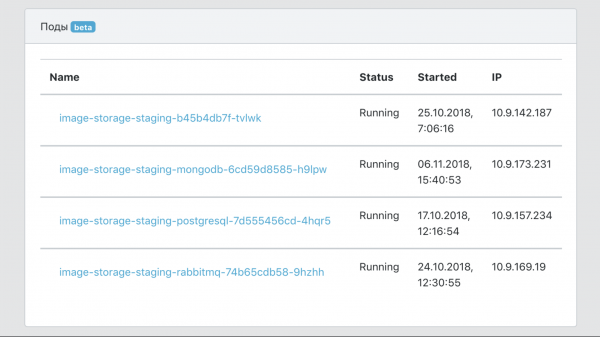
Pe scurt, dashboard-ul este panoul de control al întregului nostru PaaS.
- Un punct unic de informație despre serviciu, cu date despre acoperirea sa de teste, numărul imaginilor sale, numărul de copii în producție, versiuni etc.
- Un instrument de filtrare a datelor pe servicii și etichete (marcaje de apartenență la unități de afaceri, funcționalitate de produs etc.)
- Un instrument de integrare cu instrumentele infrastructurale pentru trasare, logging și monitorizare.
- Un punct unic de documentație despre servicii.
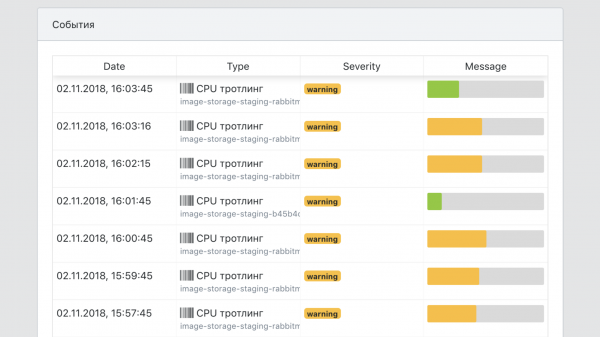
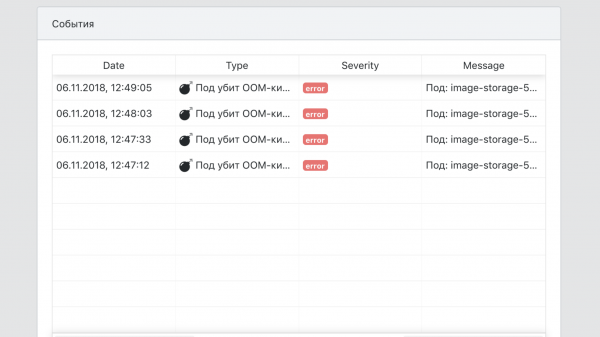
- Un punct unic de revizuire a tuturor evenimentelor legate de servicii.
În concluzie
Până la implementarea PaaS, un nou dezvoltator putea să petreacă câteva săptămâni pentru a se familiariza cu toate instrumentele necesare pentru a lansa un microserviciu în producție: Kubernetes, Helm, — în particularitățile noastre interne TeamCity, configurarea conexiunii la baze de date și cache-uri într-un mod rezistent la defecțiuni etc. Acum durează câteva ore — să citești quickstart-ul și să creezi serviciul.
Am susținut o prezentare pe această temă pentru HighLoad++ 2018, poate fi vizionată. și .
Un track bonus pentru cei care au citit până la capăt.
Noi, la Avito, organizăm un training intern de trei zile pentru dezvoltatori de la , expert în arhitectura microserviciilor. Vrem să oferim oportunitatea de a participa la acesta cuiva dintre cititorii acestui post. Programul trainingului a fost publicat.
Trainingul va avea loc între 5 și 7 august în Moscova. Acestea sunt zile lucrătoare care vor fi complet ocupate. Prânzul și formarea vor avea loc în biroul nostru, iar drumul și cazarea vor fi acoperite de participantul ales.
Poți aplica pentru a participa . De la tine — un răspuns la întrebarea de ce ar trebui să participești la training și informații pentru a te contacta. Te rugăm să răspunzi în engleză, deoarece participantul care va lua parte la training va fi ales de Chris.
Vom anunța numele participantului la training printr-o actualizare a acestui post și pe rețelele sociale Avito pentru dezvoltatori (AvitoTech în , , ) nu mai târziu de 19 iulie.
Sursa: habr.com
