

Web-ul Semantic și Linked Data sunt asemănătoare cu spațiul cosmic apropiat: acolo nu există viață. Pentru a ajunge acolo pentru o perioadă mai lungă de timp... ei bine, nu știu ce v-au spus în copilărie când ați spus „vreau să fiu astronaut”. Dar se poate observa ceea ce se întâmplă și de pe Pământ; să devii astronom amator sau chiar profesionist este mult mai simplu.
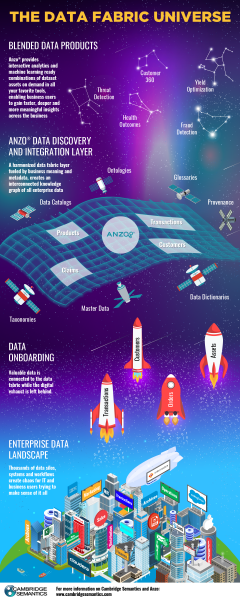
Articolul se va concentra pe tendințele recente din lumea depozitelor RDF, care nu au mai mult de câteva luni. Metafora din primul paragraf a fost inspirată de o imagine publicitară de dimensiuni epice.
Imagine epică
I. GraphQL pentru acces la RDF
, pentru că GraphQL pretinde că va deveni un limbaj universal pentru accesul la baze de date. Dar cum stau lucrurile cu posibilitatea de acces folosind GraphQL la RDF?
Această posibilitate este oferită „din cutie” de:
- Stardog (, );
- produsele TopQuadrant (, ).
Dacă depozitul nu oferă această posibilitate, aceasta poate fi implementată manual, scriind un „rezolvitor” corespunzător. Așa au procedat, de exemplu, în proiectul francez . Sau poate că acum nu mai trebuie să scrii nimic și pur și simplu să iei .
Din perspectiva unui susținător ortodox al Web-ului Semantic și Linked Data, toate acestea sunt, desigur, triste, deoarece par să fie destinate integrărilor construite în jurul unor noi silozuri de date, nu platformelor potrivite (desigur, depozitelor RDF).
Impresiile despre compararea GraphQL cu SPARQL sunt contradictorii.
- Pe de o parte, GraphQL arată ca un „rude îndepărtată” a SPARQL: rezolvă problemele tipice ale REST legate de suprasarcină și de multiplicitatea cererilor – fără de care, probabil, nu ar putea fi considerat un limbaj de interogare, chiar și pentru web;
- Pe de altă parte, mă întristează rigiditatea schema GraphQL. În consecință, „introspecția” sa pare foarte limitată comparativ cu reflexivitatea completă a RDF. Și nu există niciun echivalent al căilor proprietății, așa că nici nu este foarte clar de ce este denumit „Graph-”.
II. Adaptori pentru MongoDB
O tendință complementară celei anterioare.
- în Stardog acum — în principal, tot pe același GraphQL — pentru a configura afișarea datelor MongoDB în grafuri RDF virtuale;
- GraphDB, de ceva vreme, înserând în SPARQL fragmente în interogarea MongoDB.
Dacă vorbim mai larg despre adaptoare pentru sursele JSON, care permit reprezentarea mai mult sau mai puțin „din mers” a JSON-ului stocat în aceste surse ca RDF, ne putem aminti și de , care poate fi instalat, , la Apache Jena.
Rezumând primele două tendințe, se poate spune că depozitele RDF demonstrează o disponibilitate totală pentru integrare și pentru funcționarea în condițiile „stocării variate” (polyglot persistence). Totuși, este cunoscut faptul că această ultimă tendință nu mai este la modă, iar în locul ei multimodalitatea. Cum stau lucrurile cu multimodalitatea în lumea depozitelor RDF?
Pe scurt, nu prea bine. Subiectul sistemelor de gestionare a bazelor de date multimodale ar merita un articol separat, deocamdată se poate observa că nu există sisteme de gestionare a bazelor de date multimodale „bazate” pe modelul grafic (o variantă a acestuia poate fi considerată RDF). Se va discuta despre o oarecare mică multimodalitate - suportul de către depozitele RDF al unui model grafic alternativ LPG - în .
III. OLTP vs. OLAP
Totuși, același Gartner , că multimodalitatea este o condiție sine qua non în primul rând pentru baze de date operaționale. Și este de înțeles: în situația „stocării variate”, principalele probleme apar cu tranzacționalitatea.
Dar unde se află depozitele RDF pe scala OLTP—OLAP? Aș răspunde astfel: nici în stânga, nici în dreapta. Pentru a desemna ceea ce sunt destinate, este nevoie de un alt acronim. Ca variantă, aș propune OLIP — Procesare Intelectuală Online.
Cu toate acestea:
- mecanismele de integrare implementate în GraphDB nu sunt în ultimul rând oferirii de soluții pentru problemele de performanță a scrierii;
- Stardog merge și mai departe și rescrie complet Acum permiteți-mi să prezint un nou jucător pe piață. de la creatorii IBM Netezza și Amazon Redshift —
AnzoGraph SELECT ?month (COUNT(?event) OVER (PARTITION BY ?month) AS ?events) WHERE { … }
IV. RocksDBMai sus a fost
o referință În primul rând, conform
articolului de pe Wikipedia În al doilea rând, pe RocksDB sunt realizate proiecte (adică nu produse) de tematica corespunzătoare.
În al doilea rând, pe RocksDB se dezvoltă proiecte (adică nu produse) de tematică corespunzătoare.
De exemplu, eBay folosește RocksDB în pentru „graful său de cunoștințe”. Apropo, este amuzant să citești: limbajul de interogare a început ca un format creat intern, dar mai recent a început să semene mult mai mult cu SPARQL. Ca în gluma aceea: câți grafuri de cunoștințe facem, tot RDF iese.
Un alt exemplu - apărut cu câteva luni în urmă . Înainte de asta, pentru informații istorice despre Wikidata trebuia să apelăm la prin API-ul standard Mediawiki. Acum, multe sunt posibile în SPARQL pur. „Sub capotă” este tot RocksDB. Apropo, WDHQS a fost realizat de cineva care s-a ocupat cu importul Freebase în Google Knowledge Graph.
V. Suport pentru LPG
Amintesc principalul diferent dintre grafurile LPG și cele RDF.
În LPG, instanțele arcelor pot avea proprietăți scalare atașate, în timp ce în RDF acestea pot fi atașate doar la „tipurile” de arce (dar nu doar proprietăți scalare, ci și relații obișnuite). Această limitare a RDF în comparație cu LPG prin diferite tehnici de modelare. Totuși, limitarea LPG în comparație cu RDF este mai greu de depășit, dar grafurile LPG sunt mai asemănătoare cu imaginile din manualul lui Harari, de aceea oamenii le doresc.
Evident, sarcina „sprijinirii LPG” se împarte în două părți:
- introducerea în modelul RDF a modificărilor care permit imitarea structurilor LPG;
- introducerea în limbajul de interogare RDF a modificărilor care permit accesul la date în acest model modificat, sau realizarea posibilității de a face interogări în acest model în limbaje populare de interogare la LPG.
V.1. Model de date
Aici există câteva abordări posibile.
V.1.1. Proprietatea Singleton
Cea mai literală abordare de armonizare a RDF și LPG este probabil, :
- În loc de, de exemplu, predicatul
:isMarriedTose folosesc predicatele:isMarriedTo1,:isMarriedTo2etc. - Apoi, aceste predicate devin subiecți ai noilor triplete:
:isMarriedTo1 :since "2013-09-13"^^xsd:dateși altele. - Legătura acestor instanțe de predicate cu predicatul comun este stabilită prin triplete de tipul
:isMarriedTo1 rdf:singletonPropertyOf :isMarriedTo. - Este evident că
rdf:singletonPropertyOf rdfs:subPropertyOf rdf:type, dar gândiți-vă de ce nu ar trebui să scrieți pur și simplu:isMarriedTo1 rdf:type :isMarriedTo.
Sarcina „sprijinirii LPG” este rezolvată aici la nivelul RDFS. Această soluție necesită introducerea în cadrul . Este posibil să fie necesare modificări de la depozitele RDF care suportă atașarea efectelor, iar până atunci, Singleton Property poate fi perceput pur și simplu ca o altă tehnică de modelare.
V.1.2. Reificarea corectă
Abordările mai puțin naive derivă din conștientizarea că instanțele proprietăților pot fi cu adevărat instantiate prin triplete. Având capacitatea de a spune ceva despre triplete, vom obține și capacitatea de a vorbi despre instanțele proprietăților.
Cea mai solidă dintre aceste abordări este , cunoscut și ca RDR, în cadrul Blazegraph. Acesta a fost ales pentru sine și AnzoGraph. Soliditatea abordării este definită de faptul că în cadrul său modificările corespunzătoare în . Esența, totuși, este extrem de simplă. În serializarea Turtle a RDF, acum se va putea scrie aproximativ așa:
<> :since "2013-09-13"^^xsd:date .V.1.3. Alte abordări
Poți să nu te complici cu semantica formală și pur și simplu să consideri că tripletele au niște identificatori, care sunt, desigur, URI, și să compui noi triplete cu aceste URI. Rămâne doar să acorzi acces la aceste URI în SPARQL. Așa Stardog.
În Allegrograph pe un drum intermediar. Este cunoscut că identificatorii tripletelor în Allegrograph , dar la implementarea atributelor triple în exterior nu sunt expuși. Totuși, este departe de semantica formală. Notabil este că atributelor tripletelor nu sunt URI, iar valorile acestor atribute pot fi și ele doar literaluri. Adepții LPG obțin exact ceea ce au dorit. Într-un format special inventat NQX, un exemplu similar cu cel de mai sus pentru RDF* arată astfel:
:bob :marriedTo :alice {"since" : "2013-09-13"}V.2. Limbaje de interogare
Susținând LPG într-un fel sau altul la nivelul modelului, trebuie să oferim posibilitatea de a interoga datele într-un astfel de model.
- Blazegraph pentru interogările RDF* suportă și . O interogare SPARQL* arată astfel:
SELECT * { <> :since ?since }- AnzoGraph de asemenea suportă și intenționează să susțină , limbajul de interogare în Neo4j.
- Stardog suportă propriul său SPARQL și Gremlin. Obținerea în SPARQL a URI-ului tripletului și a „metainformației” se poate face cu o construcție de genul următor:
SELECT * {
    BIND (stardog:identifier(:bob, :isMarriedTo, ?wife) AS ?id)
    ?id :since ?since
}- Allegrograph de asemenea suportă propriul său SPARQL:
SELECT * { ("since" ?since) franz:attributesNameValue ( :bob :marriedTo ?wife ) }Apropo, GraphDB a susținut o vreme Tinkerpop/Gremlin, fără a susține LPG, dar în versiunea 8.0 sau 8.1 acest lucru a încetat.
VI. Întărirea licențelor
Nu au avut loc în ultima vreme adăugări în intersecția „triplestore of choice” și „open source triplestore”. Noile depozite RDF cu sursă deschisă sunt departe de a fi o alegere bună pentru utilizarea zilnică, iar codul sursă al noilor depozite RDF pe care ne-am dorit să le folosim (precum AnzoGraph) este închis. Mai degrabă, se poate vorbi chiar despre scăderi...
Desigur, un cod sursă deschis nu devine închis, dar unele depozite cu sursă deschisă încet încetează să fie considerate alegeri demne. Virtuoso, care are o ediție opensource, în opinia mea, se scufundă în buguri. Blazegraph a fost achiziționat de AWS și a stat la baza Amazon Neptune; acum nu este clar dacă va mai exista vreo versiune. Rămâne doar Jena...
Dacă sursa deschisă nu este foarte importantă și vrei doar să încerci, atunci lucrurile sunt la fel de sumbre ca înainte. De exemplu:
- Stardog distribuie o versiune gratuită (în orice caz, perioada de probă standard a crescut de două ori);
- în , unde înainte se putea alege un plan de bază gratuit, a fost suspendată înregistrarea utilizatorilor noi.
În general, pentru IT-iștii obișnuiți, cosmosul devine tot mai inaccesibil, iar explorarea lui devine apanajul corporațiilor.
Sursa: habr.com
