

În această postare, ne-ar plăcea să împărtășim o modalitate interesantă de a gestiona configurația unui sistem distribuit.
Configurația este reprezentată direct în limbajul Scala într-o manieră sigură din punct de vedere al tipurilor. O implementare exemplu este descrisă în detaliu. Diverse aspecte ale propunerii sunt discutate, inclusiv influența asupra întregului proces de dezvoltare.
()
Introducere
Construirea sistemelor distribuite robuste necesită utilizarea unei configurații corecte și coerente pe toate nodurile. O soluție tipică este să folosim o descriere textuală a desfășurării (terraform, ansible sau ceva asemănător) și fișiere de configurație generate automat (adesea — dedicate fiecărui nod/rol). De asemenea, ar trebui să folosim aceleași protocoale ale acelorași versiuni pe fiecare nod de comunicare (altfel ne-am confrunta cu probleme de incompatibilitate). În lumea JVM, aceasta înseamnă că, cel puțin, biblioteca de mesagerie ar trebui să fie de aceeași versiune pe toate nodurile de comunicare.
Ce zici de testarea sistemului? Desigur, ar trebui să avem teste unitare pentru toate componentele înainte de a ajunge la teste de integrare. Pentru a putea extrapola rezultatele testelor în timpul execuției, ar trebui să ne asigurăm că versiunile tuturor bibliotecilor sunt identice atât în mediile de execuție, cât și în cele de testare.
Atunci când rulăm teste de integrare, este adesea mult mai ușor să avem același classpath pe toate nodurile. Trebuie doar să ne asigurăm că același classpath este utilizat la desfășurare. (Este posibil să folosiți classpath-uri diferite pe noduri diferite, dar este mai complicat să reprezentați această configurație și să o desfășurați corect.) Așadar, pentru a menține lucrurile simple, vom considera doar classpath-uri identice pe toate nodurile.
Configurația tinde să evolueze împreună cu software-ul. De obicei, folosim versiuni pentru a identifica diverse
etape ale evoluției software-ului. Pare rezonabil să acoperim configurația sub managementul versiunilor și să identificăm diferite configurații cu anumite etichete. Dacă există o singură configurație în producție, putem folosi o versiune unică ca identificator. Uneori, putem avea mai multe medii de producție. Iar pentru fiecare mediu ar putea fi nevoie de o ramură separată de configurație. Așadar, configurațiile ar putea fi etichetate cu ramură și versiune pentru a identifica unic diferitele configurații. Fiecare etichetă de ramură și versiune corespunde unei combinații unice de noduri distribuite, porturi, resurse externe, versiuni de biblioteci classpath pe fiecare nod. Aici vom acoperi doar ramura singulară și vom identifica configurațiile printr-o versiune decimală în trei componente (1.2.3), la fel ca alte artefacte.
În medii moderne, fișierele de configurație nu sunt modificate manual. De obicei, generăm
fișiere de configurație la momentul desfășurării și după aceea. Așadar, s-ar putea întreba de ce mai folosim formatul text pentru fișierele de configurație? O opțiune viabilă este să plasăm configurația într-o unitate de compilare și să beneficiem de validarea configurației la compilare.
În această postare, vom examina ideea de a păstra configurația în artefactul compilat.
Configurație compilabilă
În această secțiune, vom discuta un exemplu de configurație statică. Două servicii simple — serviciul echo și clientul serviciului echo sunt configurate și implementate. Apoi, se instanțiază două sisteme distribuite cu ambele servicii. Unul este pentru o configurație de nod unic și celălalt pentru configurația de două noduri.
Un sistem distribuit tipic constă din câteva noduri. Nodurile ar putea fi identificate folosind un anumit tip:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
sau doar
case class NodeId(hostName: String)sau chiar
object Singleton
type NodeId = Singleton.type
Aceste noduri îndeplinesc diverse roluri, rulează anumite servicii și ar trebui să fie capabile să comunice cu celelalte noduri prin intermediul conexiunilor TCP/HTTP.
Pentru o conexiune TCP, este necesar cel puțin un număr de port. De asemenea, dorim să ne asigurăm că clientul și serverul comunică folosind același protocol. Pentru a modela o conexiune între noduri, să declarăm următoarea clasă:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])unde Port este doar un Int în intervalul permis:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Tipuri rafinate
Consultați biblioteca. Pe scurt, permite adăugarea de constrângeri de timp de compilare la alte tipuri. În acest caz Int poate accepta doar valori de 16 biți care pot reprezenta un număr de port. Nu este necesară utilizarea acestei biblioteci pentru această abordare de configurare. Pur și simplu pare să se potrivească foarte bine.
Pentru HTTP (REST), s-ar putea să avem nevoie și de o cale a serviciului:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Tip fantomă
Pentru a identifica protocolul în timpul compilării, folosim caracteristica Scala de a declara un argument de tip Protocol care nu este folosit în clasă. Este așa numitul tip fantomă. În timpul executării, rareori avem nevoie de o instanță a identificatorului de protocol, motiv pentru care nu îl stocăm. În timpul compilării, acest tip fantomă oferă o siguranță suplimentară a tipului. Nu putem trece un port cu un protocol incorect.
Unul dintre cele mai utilizate protocoale este REST API cu serializare Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]unde RequestMessage este tipul de bază al mesajelor pe care clientul le poate trimite către server și ResponseMessage este mesajul de răspuns de la server. Desigur, putem crea și alte descrieri ale protocolului care specifică protocolul de comunicație cu precizia dorită.
În scopurile acestui articol, vom folosi o versiune mai simplă a protocolului:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]În acest protocol, mesajul de cerere este atașat la url și mesajul de răspuns este returnat ca un șir simplu.
O configurație a serviciului ar putea fi descrisă prin numele serviciului, o colecție de porturi și câteva dependențe. Există câteva modalități posibile de a reprezenta toate aceste elemente în Scala (de exemplu, HList, tipuri de date algebraice). În scopurile acestui articol, vom folosi Cake Pattern și vom reprezenta modulele combinabile ca trăsături. (Cake Pattern nu este o cerință pentru această abordare de configurare compilabilă. Este doar o implementare posibilă a ideii.)
Dependențele ar putea fi reprezentate folosind Cake Pattern ca puncte finale ale altor noduri:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Serviciul Echo are nevoie doar de un port configurat. Și declarăm că acest port suportă protocolul de echo. Rețineți că nu este necesar să specificăm un port anume în acest moment, deoarece trăsătura permite declarații de metode abstracte. Dacă folosim metode abstracte, compilatorul va cere o implementare într-o instanță de configurare. Aici am furnizat implementarea (8081) și va fi folosită ca valoare implicită dacă o omitem într-o configurare concretă.
Putem declara o dependență în configurația clientului serviciului echo:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Dependența are același tip ca și echoService. În special, aceasta necesită același protocol. Prin urmare, putem fi siguri că, dacă conectăm aceste două dependențe, vor funcționa corect.
Implementarea serviciilor
Un serviciu are nevoie de o funcție pentru a începe și a se închide în mod grațios. (Capacitatea de a opri un serviciu este critică pentru teste.) Din nou, există câteva opțiuni de specificare a unei astfel de funcții pentru o configurație dată (de exemplu, am putea folosi clase de tip). Pentru acest articol, vom folosi din nou Cake Pattern. Putem reprezenta un serviciu folosind cats.Resource care oferă deja delimitare și eliberarea resurselor. Pentru a dobândi o resursă, trebuie să furnizăm o configurație și un context de execuție. Așa că funcția de pornire a serviciului ar putea arăta astfel:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
unde
Configurație— tipul de configurație care este necesar pentru acest starter de serviciuAddressResolver— un obiect de execuție care are capacitatea de a obține adresele reale ale altor noduri (continuă să citești pentru detalii).
celelalte tipuri vin din cats:
F[_]— tipul de efect (în cel mai simplu cazF[A]ar putea fi doar() => A. În acest articol, vom folosicats.IO.)Reader[A,B]— este mai mult sau mai puțin un sinonim pentru o funcțieA => Bcats.Resource— are modalități de a dobândi și eliberaTimer— permite să adormim/ măsurăm timpulContextShift— analogul luiExecutionContextApplicative— învelitor de funcții în efect (aproape un monad) (s-ar putea să înlocuim în cele din urmă cu altceva)
Folosind această interfață, putem implementa câteva servicii. De exemplu, un serviciu care nu face nimic:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Vezi pentru alte implementări de servicii — ,
și .)
Un nod este un singur obiect care rulează câteva servicii (începerea unei lanț de resurse este posibilă prin Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Rețineți că în nod specificăm tipul exact de configurație care este necesar pentru acest nod. Compilatorul nu ne va lăsa să construim obiectul (Cake) cu un tip insuficient, deoarece fiecare trăsătură de serviciu declară o constrângere asupra Configurație tip. De asemenea, nu vom putea începe nodul fără a furniza o configurație completă.
Rezolvarea adresei nodului
Pentru a stabili o conexiune, avem nevoie de o adresă reală a gazdei pentru fiecare nod. Aceasta ar putea fi cunoscută mai târziu decât alte părți ale configurației. Prin urmare, avem nevoie de o modalitate de a oferi o asociere între id-ul nodului și adresa sa actuală. Această asociere este o funcție:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Există câteva modalități posibile de a implementa o astfel de funcție.
- Dacă știm adresele reale înainte de desfășurare, în timpul instanțierii gazdelor nodurilor, putem genera cod Scala cu adresele reale și apoi să rulăm construirea ulterior (care efectuează verificări la timp de compilare și apoi rulează suite de teste de integrare). În acest caz, funcția noastră de asociere este cunoscută static și poate fi simplificată într-o formă ca o
Map[NodeId, NodeAddress]. - Uneori obținem adresele reale abia mai târziu, când nodul este efectiv pornit, sau nu avem adrese ale nodurilor care nu au fost încă pornite. În acest caz, am putea avea un serviciu de descoperire care este pornit înainte de toate celelalte noduri, iar fiecare nod ar putea face publică adresa sa în acel serviciu și să se aboneze la dependențe.
- Dacă putem modifica
/etc/hosts, putem folosi nume de gazdă predefinite (camy-project-main-nodeșiecho-backend) și pur și simplu să asociem acest nume cu adresa IP în timpul desfășurării.
În această postare, nu discutăm aceste cazuri în detaliu. De fapt, în exemplul nostru de probă, toate nodurile vor avea aceeași adresă IP — 127.0.0.1.
În această postare vom considera două layout-uri de sistem distribuit:
- Layout de nod unic, unde toate serviciile sunt plasate pe un singur nod.
- Layout cu două noduri, unde serviciul și clientul sunt pe noduri diferite.
Configurația pentru un este după cum urmează:
Configurația nodului unic
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identificatorul nodului unic
  \/\/ configurația serverului
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Specificație sigură pentru portul de serviciu. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configurația clientului

  \/** Vom folosi serviciul oferit de aceeași gazdă. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configurația controller-ului de ciclu de viață
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 secunde suplimentare pentru a avea 10 cereri, nu 9.
}
Aici creăm o configurație unică care extinde atât configurația serverului, cât și configurația clientului. De asemenea, configurăm un controler de ciclu de viață care va termina în mod normal clientul și serverul după lifetime trecerea intervalului.
Același set de implementări de servicii și configurații poate fi folosit pentru a crea un layout al sistemului cu două noduri separate. Tot ce trebuie să facem este să creăm cu serviciile corespunzătoare:
Configurația cu două noduri
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specificația dependenței
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 secunde suplimentare pentru a avea 10 cereri, nu 9.

    def testMessage: String = "dolly"
  }
Observați cum specificăm dependența. Menționăm serviciul furnizat de celălalt nod ca o dependență a nodului curent. Tipul de dependență este verificat deoarece conține un tip fantomă care descrie protocolul. Iar la timpul de execuție, vom avea id-ul nodului corect. Acesta este unul dintre aspectele importante ale abordării propuse pentru configurație. Ne oferă capacitatea de a seta portul o singură dată și de a ne asigura că facem referire la portul corect.
Implementarea cu două noduri
Pentru această configurație, folosim exact aceleași implementări de servicii. Nici o schimbare deloc. Cu toate acestea, creăm două implementări de noduri diferite care conțin seturi diferite de servicii:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Primul nod implementează serverul și are nevoie doar de configurația părții server. Al doilea nod implementează clientul și are nevoie de o altă parte a configurației. Ambele noduri necesită o specificare a duratei de viață. În scopul acestei postări, nodul serviciu va avea o durată de viață infinită care ar putea fi terminată utilizând SIGTERM, în timp ce clientul echo se va termina după durata finite configurate. Consultați aplicația pentru detalii.
Procesul general de dezvoltare
Să vedem cum această abordare schimbă modul în care lucrăm cu configurația.
Configurația ca și cod va fi compilată și va produce un artefact. Pare rezonabil să separăm artefactul de configurație de celelalte artefacte de cod. De multe ori putem avea o multitudine de configurații pe aceeași bază de cod. Și, bineînțeles, putem avea multiple versiuni ale diverselor ramuri de configurație. Într-o configurație putem selecta versiuni particulare ale bibliotecilor și aceasta va rămâne constantă ori de câte ori desfășurăm această configurație.
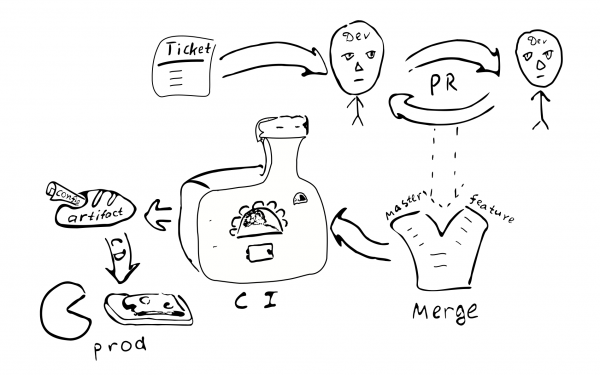
O schimbare a configurației devine o schimbare a codului. Așa că aceasta ar trebui să fie acoperită de același proces de asigurare a calității:
Ticket -> PR -> revizuire -> fuzionare -> integrare continuă -> desfășurare continuă
Există următoarele consecințe ale abordării:
- Configurarea este coerentă pentru o anumită instanță a sistemului. Se pare că nu există nicio modalitate de a avea o conexiune greșită între noduri.
- Nu este ușor să schimbi configurația doar în un singur nod. Pare nerezonabil să te conectezi și să schimbi câteva fișiere text. Așadar, devierea configurației devine mai puțin posibilă.
- Modificările mici ale configurației nu sunt ușor de realizat.
- Cele mai multe modificări ale configurației vor urma același proces de dezvoltare și vor trece printr-o revizuire.
Avem nevoie de un depozit separat pentru configurația de producție? Configurația de producție ar putea conține informații sensibile pe care ne-ar plăcea să le păstrăm departe de multe persoane. Așadar, ar putea merita să păstrăm un depozit separat cu acces restricționat care va conține configurația de producție. Putem împărți configurația în două părți - una care conține cele mai multe parametri deschise ale producției și una care conține partea secretă a configurației. Acest lucru ar permite accesul majorității dezvoltatorilor la cea mai mare parte a parametrilor, în timp ce restricționează accesul la lucruri cu adevărat sensibile. Este ușor să realizăm acest lucru folosind trăsături intermediare cu valori implicite ale parametrilor.
Variații
Să vedem avantajele și dezavantajele abordării propuse comparativ cu alte tehnici de gestionare a configurației.
În primul rând, vom lista câteva alternative pentru diferitele aspecte ale modului propus de a gestiona configurația:
- Fișier text pe mașina țintă.
- Stocare centralizată a cheilor-valorilor (de exemplu,
etcd/zookeeper). - Componente subprocess care ar putea fi reconfigurate/restartate fără a reporni procesul.
- Configurație în afara artefactului și controlului versiunii.
Fișierul text oferă o anumită flexibilitate în ceea ce privește repararea ad-hoc. UnAdministrator de sistem se poate conecta la nodul țintă, poate face o modificare și pur și simplu poate reporni serviciul. Aceasta poate să nu fie la fel de bună pentru sisteme mai mari. Nu rămân urme în urma modificării. Modificarea nu este revizuită de o altă pereche de ochi. Ar putea fi dificil să descoperim ce a cauzat modificarea. Nu a fost testată. Din perspectiva unui sistem distribuit, un administrator poate uita pur și simplu să actualizeze configurația în unul dintre celelalte noduri.
(Apropo, dacă totuși va fi nevoie să începem să folosim fișiere de configurare text, va trebui doar să adăugăm un parser + validator care să poată produce același Configurație tip și asta ar fi suficient pentru a începe să folosim configurații text. Acest lucru arată de asemenea că complexitatea configurației la momentul compilării este puțin mai mică decât complexitatea configurațiilor bazate pe text, deoarece în versiunea bazată pe text avem nevoie de un cod suplimentar.)
Stocarea centralizată a cheilor-valorilor este un mecanism bun pentru distribuirea parametrilor meta ai aplicației. Aici trebuie să ne gândim la ce considerăm a fi valori de configurare și ce este doar date. Dând o funcție C => A => B de obicei numim valori care se schimbă rar C «configurație», în timp ce datele care se schimbă frecvent A — doar date de intrare. Configurația ar trebui să fie furnizată funcției mai devreme decât datele A. Luând în considerare această idee, putem spune că frecvența așteptată a modificărilor ar putea fi utilizată pentru a distinge datele de configurare de datele simple. De asemenea, datele vin, de obicei, dintr-o singură sursă (utilizator) iar configurația dintr-o sursă diferită (administrator). Gestionarea parametrilor care pot fi modificați după inițializarea procesului duce la o creștere a complexității aplicației. Pentru astfel de parametri va trebui să ne ocupăm de mecanismul lor de livrare, analiza și validarea, gestionarea valorilor incorecte. Prin urmare, pentru a reduce complexitatea programului, ar fi mai bine să reducim numărul de parametri care pot fi modificați în timpul execuției (sau chiar să-i eliminăm total).
Din perspectiva acestui post, ar trebui să facem o distincție între parametrii statici și cei dinamici. Dacă logica serviciului necesită o schimbare rară a unor parametrii în timpul execuției, atunci îi putem numi parametrii dinamici. În caz contrar, sunt statici și pot fi configurați folosind abordarea propusă. Pentru reconfigurarea dinamică, ar putea fi necesare alte abordări. De exemplu, părțile sistemului ar putea fi repornite cu noii parametrii de configurare, similar cu repornirea proceselor separate ale unui sistem distribuit.
(Părerea mea umilă este să evităm reconfigurarea în timpul execuției, deoarece crește complexitatea sistemului.
Ar putea fi mai simplu să ne bazăm pe suportul OS pentru repornirea proceselor. Totuși, acest lucru poate să nu fie întotdeauna posibil.)
Un aspect important al utilizării configurației statice care uneori îi face pe oameni să considere configurația dinamică (fără alte motive) este timpul de nefuncționare al serviciului în timpul actualizării configurației. Într-adevăr, dacă trebuie să facem modificări la configurația statică, trebuie să repornim sistemul pentru ca noile valori să devină active. Cerințele privind timpul de nefuncționare variază pentru diferite sisteme, așa că poate să nu fie atât de critic. Dacă este critic, atunci trebuie să planificăm din timp orice repornire a sistemului. De exemplu, am putea implementa . În acest scenariu, ori de câte ori trebuie să repornim sistemul, începem o nouă instanță a sistemului în paralel, apoi comutăm ELB către aceasta, lăsând vechiul sistem să finalizeze servicii conexiunilor existente.
Ce zici de păstrarea configurației în interiorul unui artefact versiunat sau în afară? Păstrarea configurației într-un artefact înseamnă, în majoritatea cazurilor, că această configurație a trecut prin același proces de asigurare a calității ca și celelalte artefacte. Așadar, cineva ar putea fi sigur că configurația este de bună calitate și de încredere. În schimb, configurația într-un fișier separat înseamnă că nu există urme despre cine și de ce a făcut modificări în acel fișier. Este acest lucru important? Credem că pentru cele mai multe sisteme de producție este mai bine să avem o configurație stabilă și de înaltă calitate.
Versiunea artefactului permite să aflăm când a fost creat, ce valori conține, ce caracteristici sunt activate/dezactivate, cine a fost responsabil pentru fiecare modificare din configurație. Ar putea necesita un anumit efort să păstrăm configurația într-un artefact și este o alegere de design pe care trebuie să o facem.
Pro și contra
Aici am dori să evidențiem câteva avantaje și să discutăm despre unele dezavantaje ale abordării propuse.
Avantaje
Caracteristicile configurației compilabile a unui sistem distribuit complet:
- Verificare statică a configurației. Acest lucru oferă un nivel ridicat de încredere că configurația este corectă având în vedere constrângerile de tip.
- Limbaj bogat de configurație. În mod normal, alte abordări de configurare sunt limitate la cel mult substituirea variabilelor.
Folosind Scala, se pot utiliza o gamă largă de caracteristici ale limbajului pentru a face configurația mai bună. De exemplu, putem folosi trăsături pentru a oferi valori implicite, obiecte pentru a seta un domeniu diferit, putem face referire lavals definite o singură dată în domeniul extern (DRY). Este posibil să folosim secvențe literale sau instanțe ale anumitor clase (Seq,Map, etc.). - DSL. Scala are un suport decent pentru scriitorii de DSL. Cineva poate folosi aceste caracteristici pentru a stabili un limbaj de configurare care este mai convenabil și prietenos pentru utilizatorii finali, astfel încât configurația finală să fie cel puțin lizibilă de utilizatorii de domeniu.
- Integritate și coerență între noduri. Unul dintre beneficiile de a avea configurația întregului sistem distribuit într-un singur loc este că toate valorile sunt definite strict o singură dată și apoi reutilizate în toate locurile în care avem nevoie de ele. De asemenea, declarațiile de porturi sigure din punct de vedere al tipului asigură că, în toate configurațiile corecte posibile, nodurile sistemului vor vorbi aceeași limbă. Există dependențe explicite între noduri, ceea ce face dificilă uitarea de a oferi unele servicii.
- Calitatea ridicată a schimbărilor. Abordarea generală de a trece schimbările de configurație prin procesul normal de PR stabilește standarde ridicate de calitate și în configurație.
- Modificări simultane de configurare. Ori de câte ori facem modificări în configurație, desfășurarea automată asigură că toate nodurile sunt actualizate.
- Simplificarea aplicației. Aplicația nu trebuie să analizeze și să valideze configurația și să gestioneze valorile de configurație incorecte. Acest lucru simplifică întreaga aplicație. (Unele creșteri de complexitate sunt în configurație însă, este o alegere conștientă pentru siguranță.) Este destul de simplu să revenim la configurația obișnuită - trebuie doar să adăugăm piesele lipsă. Este mai ușor să începi cu o configurație compilată și să amâni implementarea pieselor suplimentare pentru o dată ulterioară.
- Configurație versiune. Datorită faptului că modificările de configurare urmează același proces de dezvoltare, rezultatul este un artefact cu o versiune unică. Acesta ne permite să revenim la o configurație anterioară, dacă este necesar. Putem chiar desfășura o configurație care a fost utilizată acum un an și va funcționa exact la fel. Configurația stabilă îmbunătățește previzibilitatea și fiabilitatea sistemului distribuit. Configurația este fixată la timpul de compilare și nu poate fi modificată ușor pe un sistem de producție.
- Modularitate. Framework-ul propus este modular și modulele pot fi combinate în diverse moduri pentru
a susține diferite configurații (setări/distribuții). În special, este posibil să avem o configurație mică pe un singur nod și o setare de mari dimensiuni pe mai multe noduri. Este rezonabil să avem mai multe dispuneri de producție. - Testare. În scopuri de testare, cineva ar putea implementa un serviciu fictiv și să-l folosească ca o dependență într-un mod sigur tipologic. Pot fi întreținute simultan mai multe configurații de testare cu diverse piese înlocuite cu mock-uri.
- Testare de integrare. Uneori, în sistemele distribuite este dificil să rulăm teste de integrare. Folosind abordarea descrisă pentru configurarea sigură tipologic a întregului sistem distribuit, putem rula toate părțile distribuite pe un singur server într-un mod controlabil. Este ușor să emulăm situația
când unul dintre servicii devine indisponibil.
Dezavantaje
Abordarea configurației compilate este diferită de configurația „normală” și ar putea să nu se potrivească tuturor nevoilor. Iată câteva dintre dezavantajele configurației compilate:
- Configurație statică. S-ar putea să nu fie potrivită pentru toate aplicațiile. În unele cazuri este nevoie de a corecta rapid configurația în producție, ocolind toate măsurile de siguranță. Această abordare face conceperea mai dificilă. Compilarea și desfășurarea sunt necesare după orice modificare a configurației. Acesta este atât un avantaj, cât și o povară.
- Generarea configurației. Când configurația este generată de un instrument de automatizare, această abordare necesită compilarea ulterioară (care, la rândul său, ar putea să eșueze). Poate necesita un efort suplimentar pentru a integra acest pas suplimentar în sistemul de construire.
- Instrumente. Există multe instrumente utilizate astăzi care se bazează pe configurații textuale. Unele dintre ele
nu vor fi aplicabile când configurația este compilată. - Este necesară o schimbare de mentalitate. Dezvoltatorii și DevOps sunt familiarizați cu fișierele de configurare textuale. Ideea de a compila configurația ar putea apărea ciudată pentru ei.
- Înainte de a introduce o configurație compilabilă, este necesar un proces de dezvoltare software de înaltă calitate.
Există unele limitări ale exemplului implementat:
- Dacă furnizăm configurații suplimentare care nu sunt cerute de implementarea nodului, compilatorul nu ne va ajuta să detectăm implementarea absentă. Acest lucru ar putea fi abordat prin utilizarea
HListsau a ADT-urilor (clase de caz) pentru configurația nodului în loc de trăsături și Cake Pattern. - Trebuie să furnizăm un anumit boilerplate în fișierul de configurare: (
pachet,import,obiectdeclarații;
override def's pentru parametrii care au valori implicite). Acest lucru ar putea fi abordat parțial utilizând un DSL. - În această postare nu acoperim reconfigurarea dinamică a clustrelor de noduri similare.
Concluzie
În această postare am discutat despre ideea de a reprezenta configurația direct în codul sursă într-un mod sigur din punct de vedere al tipurilor. Această abordare ar putea fi utilizată în multe aplicații ca înlocuire pentru configurările bazate pe XML și alte formate text. Deși exemplul nostru a fost implementat în Scala, acesta ar putea fi tradus și în alte limbaje compilabile (cum ar fi Kotlin, C#, Swift etc.). Cineva ar putea încerca această abordare într-un nou proiect și, în cazul în care nu se potrivește bine, să revină la metoda tradițională.
Desigur, configurația compilabilă necesită un proces de dezvoltare de înaltă calitate. La schimb, promite să ofere o configurație robustă de aceeași calitate ridicată.
Această abordare ar putea fi extinsă în diverse moduri:
- O persoană ar putea folosi macro-uri pentru a efectua validarea configurației și pentru a eșua la compilare în cazul în care apar vreo eșec al constrângerilor de logică de afaceri.
- Un DSL ar putea fi implementat pentru a reprezenta configurația într-un mod prietenos pentru utilizatorii domeniului.
- Gestionarea dinamică a resurselor cu ajustări automată de configurație. De exemplu, atunci când ajustăm numărul de noduri din cluster, am putea dori (1) ca nodurile să obțină o configurație ușor modificată; (2) managerul clusterului să primească informații noi despre noduri.
Mulțumesc
Aș dori să mulțumesc lui Andrey Saksonov, Pavel Popov și Anton Nehaev pentru feedback-ul inspirațional pe care mi l-au oferit asupra schiței acestei postări, care m-a ajutat să o fac mai clară.
Sursa: habr.com
