

Pe ce principii se bazează un depozit de date ideal?
Concentrarea asupra valorii pentru afaceri și analizei în absența codului boilerplate. Managementul DWH ca bază de cod: versionare, revizuire, testare automată și CI. Modularitate, extensibilitate, sursă deschisă și comunitate. Documentație prietenoasă pentru utilizatori și vizualizarea dependențelor (Data Lineage).
Despre toate acestea și despre rolul DBT în ecosistemul Big Data & Analytics — bun venit sub acest articol.
Salutare tuturor
Sunt Artemii Kozyr. De mai bine de 5 ani lucrez cu depozitele de date, mă ocup de construirea ETL/ELT, dar și de analiza datelor și vizualizare. În prezent lucrez la , predau la OTUS în cadrul cursului , și astăzi vreau să împărtășesc cu voi un articol pe care l-am scris în preajma începerii noului grup pentru curs.
Prezentare generală
Framework-ul DBT — totul se învârte în jurul literei T din acronimul ELT (Extract — Transform — Load).
Odată cu apariția unor baze de date analitice performante și scalabile precum BigQuery, Redshift, Snowflake, a dispărut orice sens de a efectua transformări în afara depozitului de date.
DBT nu extrage date din surse, dar oferă oportunități imense de a lucra cu datele care deja au fost încărcate în depozit (în Internal sau External Storage).
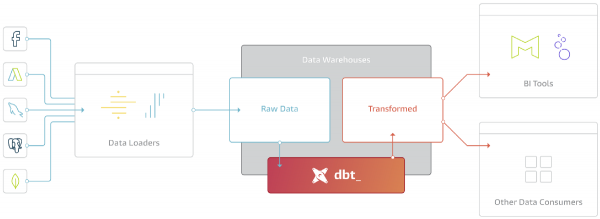
Scopul principal al DBT este de a lua codul, a-l compila în SQL, și a executa comenzile într-o secvență corectă în depozit.
Structura proiectului DBT
Proiectul constă din două tipuri de directoare și fișiere:
- Model (.sql) — unitatea de transformare exprimată printr-o interogare SELECT
- Fișier de configurare (.yml) — parametrii, setările, testele, documentația
La un nivel de bază, lucrul se desfășoară în felul următor:
- Utilizatorul pregătește codul modelelor într-o IDE convenabilă
- Prin CLI se cheamă execuția modelelor, DBT compilează codul modelelor în SQL
- Codul SQL compilat se execută în depozit într-o secvență dată (grafic)
Iată cum poate arăta execuția din CLI:
Totul este SELECT
Aceasta este caracteristica principală a framework-ului Data Build Tool. Cu alte cuvinte, DBT abstrează tot codul legat de materializarea interogărilor voastre în depozit (variații din comenzile CREATE, INSERT, UPDATE, DELETE, ALTER, GRANT,…).
Fiecare model implică scrierea unei interogări SELECT care definește setul de date rezultat.
Logica transformărilor poate fi multilevel și poate consolida date din mai multe alte modele. Exemplu de model care va construi o vitră a comenzilor (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

 select * from {{ ref('stg_orders') }}

),

order_payments as (

 select * from {{ ref('order_payments') }}

),

final as (

 select
 orders.order_id,
 orders.customer_id,
 orders.order_date,
 orders.status,
 {% for payment_method in payment_methods -%}
 order_payments.{{payment_method}}_amount,
 {% endfor -%}
 order_payments.total_amount as amount
 from orders
 left join order_payments using (order_id)
)

select * from final
Ce este interesant de văzut aici?
În primul rând: S-au folosit CTE (Expresii comune de tabel) — pentru organizarea și înțelegerea codului, care conține multe transformări și logică de afaceri
În al doilea rând: Codul modelului — este o mixtură de SQL și limbajul (limbaj de șablonizare).
În exemplu, s-a folosit un ciclu for pentru a forma suma pentru fiecare metodă de plată specificată în expresie set. De asemenea, se utilizează funcția ref — posibilitatea de a face referire în cod la alte modele:
- În timpul compilării ref va fi transformată într-un pointer țintă către o tabelă sau o vedere în Stocare
- ref permițând construirea unui grafic de dependență al modelelor
Exact aceasta adaugă în DBT posibilități aproape nelimitate. Cele mai utilizate dintre acestea sunt:
- If / else statements — operatori de ramificare
- For loops — bucle
- Variables — variabile
- Macro — crearea de macrocomenzi
Materializarea: Table, View, Incremental
Strategia de materializare — abordarea conform căreia setul de date final al modelului va fi salvat în Stocare.
Într-o considerare de bază, aceasta este:
- Table — tabel fizic în Stocare
- View — vedere, tabel virtual în Stocare
Există și strategii de materializare mai complexe:
- Incremental — încărcare incrementală (a tabelelor mari de fapte); noi rânduri sunt adăugate, cele modificate — actualizate, cele șterse — eliminate
- Ephemeral — modelul nu se materializează direct, ci participă ca CTE în alte modele
- Alte strategii pe care le poți adăuga tu însuți
Pe lângă strategiile de materializare, se deschid posibilități pentru optimizarea pentru stocări specifice, de exemplu:
- Snowflake: Tabele tranzitorii, comportament de fuziune, grupare de tabele, copierea granturilor, vederi securizate
- Redshift: Distkey, Sortkey (intercalat, compus), Vederi cu legături târzii
- BigQuery: Partiționarea și gruparea tabelelor, comportament de fuziune, criptare KMS, Etichete și Marcaje
- Spark: Format de fișier (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
În prezent, sunt acceptate următoarele Stocuri:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (parțial)
- Spark (parțial)
- Microsoft SQL Server (adaptator comunitar)
Să îmbunătățim modelul nostru:
- Să facem completarea sa incrementală (Incremental)
- Să adăugăm chei de segmentare și sortare pentru Redshift
-- Configurația modelului:
-- Umplere incrementală, cheie unică pentru actualizarea înregistrărilor (unique_key)
-- Cheie de segmentare (dist), cheie de sortare (sort)
{{
  config(
       materialized='incremental',
       unique_key='order_id',
       dist="customer_id",
       sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Acest filtru va fi aplicat doar pentru rularea incrementală
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Graful dependențelor modelului
Acesta este și arborele dependențelor. Este cunoscut și sub numele de DAG (Graf Acyclic Direcționat).
DBT construiește graful pe baza configurației tuturor modelelor din proiect, mai precis a referințelor ref() din modelele către alte modele. Existenta grafului permite următoarele:
- Rularea modelelor într-o succesiune corectă
- Paralelizarea formării vitrinelor
- Rularea unui subgraf arbitrar
Exemplu de vizualizare a graficului:
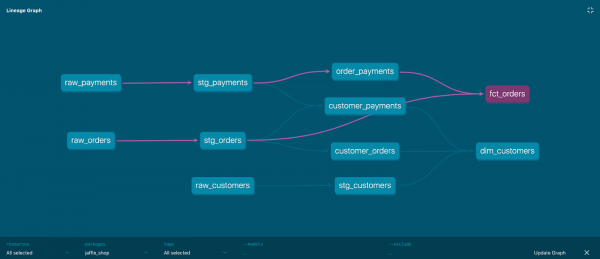
Fiecare nod al graficului este un model, arcurile graficului sunt definite prin expresia ref.
Calitatea datelor și Documentația
Pe lângă formarea modelurilor în sine, DBT permite testarea unei serii de presupuneri (assertions) despre setul rezultat de date, cum ar fi:
- Not Null
- Unic
- Integritatea referențială (exemplu, customer_id în tabelul orders corespunde id-ului din tabelul customers)
- Conformitatea cu lista valorilor permise
Este posibil să adăugați teste proprii (custom data tests), cum ar fi, de exemplu, % deviația veniturilor față de indicatorii din ziua, săptămâna, luna trecută. Orice presupunere formulată sub formă de interogare SQL poate deveni un test.
Astfel se pot depista deviațiile nedorite și erorile din date în vitrinele Stocului.
În ceea ce privește documentarea, DBT oferă mecanisme pentru adăugarea, versiunea și distribuirea meta-datelor și comentariilor la nivelul modelelor și chiar al atributelor.
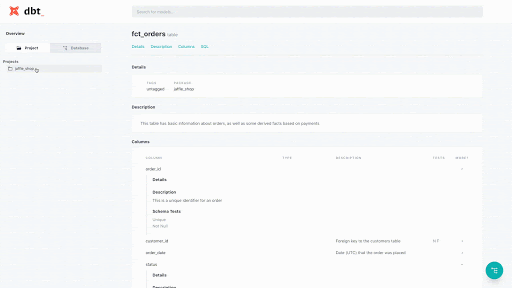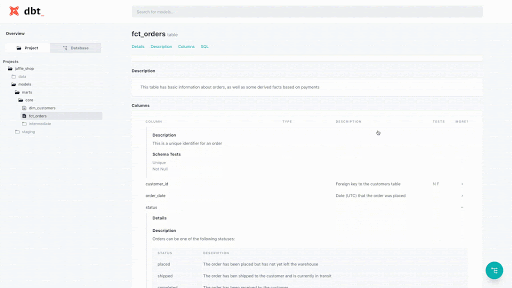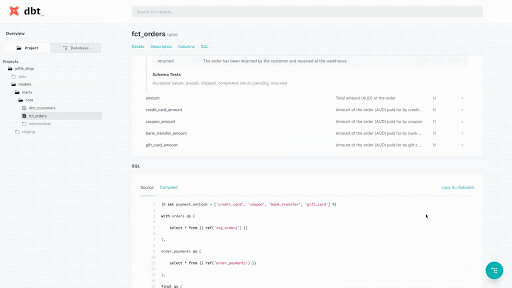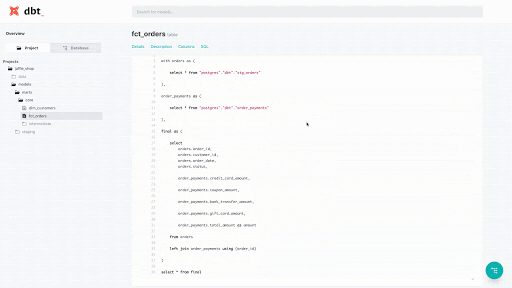
Iată cum arată adăugarea testelor și documentației la nivelul fișierului de configurare:
 - name: fct_orders
   description: Această tabelă conține informații de bază despre comenzi, precum și unele fapte derivate bazate pe plăți
   columns:
     - name: order_id
       tests:
         - unique # verificare pentru valori unice
         - not_null # verificare pentru existența valorilor null
       description: Acesta este un identificator unic pentru o comandă
     - name: customer_id
       description: Cheie străină către tabela clienților
       tests:
         - not_null
         - relationships: # verificare a integrității referențiale
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Data (UTC) la care comanda a fost plasată
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # verificare pentru valori permise
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Iată cum arată această documentație pe un site web generat:
Macro-uri și Module
Scopul DBT nu este atât de mult să devină un set de scripturi SQL, ci să ofere utilizatorilor instrumente puternice și bogate în funcționalități pentru a construi propriile transformări și a distribui aceste module.
Macro-urile sunt seturi de construcții și expresii care pot fi apelate ca funcții în cadrul modelelor. Macro-urile permit reutilizarea SQL între modele și proiecte, conform principiului ingineresc DRY (Nu repetați).
Exemplu de macro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Și utilizarea sa:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- apelarea macro-ului
from my_table
DBT vine cu un manager de pachete (packages) care permite utilizatorilor să publice și să reutilizeze module și macro-uri individuale.
Aceasta înseamnă posibilitatea de a încărca și folosi biblioteci precum:
- : gestionarea Date/Timp, Chei de substituție, teste de schemă, Pivot/Unpivot și altele
- Șabloane gata făcute pentru astfel de servicii precum și
- Biblioteci pentru anumite Data Warehouses, de exemplu
- — Modul pentru logging-ul activității DBT
Lista completă de pachete poate fi consultată pe .
Încă mai multe posibilități
Aici voi descrie câteva alte caracteristici interesante și implementări pe care eu și echipa le folosim pentru construirea unui Depozit de Date în .
Separarea mediilor de execuție DEV - TEST - PROD
Chiar și în cadrul unui cluster DWH (în cadrul unor scheme diferite). De exemplu, folosind următoarea expresie:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Acest cod spune practic: pentru mediile dev, test, ci ia datele doar pentru ultimele 3 zile și nu mai mult. Asta înseamnă că rularea în aceste medii va fi mult mai rapidă și va necesita mai puține resurse. Atunci când se rulează în mediul prod condiția de filtrare va fi ignorată.
Materializarea cu codificare alternativă a coloanelor
Redshift este un SGBD pe coloană, care permite setarea algoritmilor de compresie a datelor pentru fiecare coloană în parte. Alegerea algoritmilor optimi poate reduce spațiul ocupat pe disc cu 20-50%.
Macro va executa comanda ANALYZE COMPRESSION, va crea o nouă tabelă cu algoritmii recomandați de codificare a coloanelor, folosind cheile de segmentare (dist_key) și sortare (sort_key), va muta datele în aceasta și, dacă este necesar, va șterge vechea copie.
Semnătura macro-ului:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Logarea rulărilor modelelor
Fiecare execuție a modelului poate avea hooks atașate, care vor fi executate înainte de rulare sau imediat după finalizarea creării modelului:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
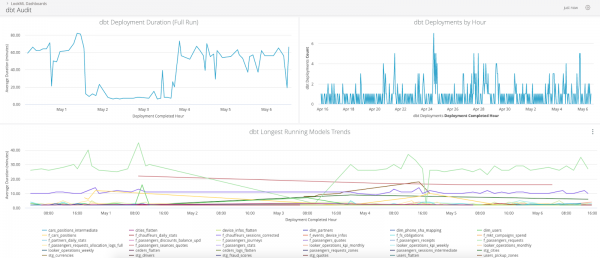
Modul de logare va permite înregistrarea tuturor metadatelor necesare într-o tabelă separată, pe care ulterior se pot realiza audite și analize ale problemelor (bottlenecks).
Iată cum arată dashboard-ul cu datele de logare în Looker:
Automatizarea întreținerii Depozitului
Dacă utilizați extensii ale funcționalității Depozitului utilizat, cum ar fi UDF (Funcții Definite de Utilizator), atunci versiunea acestor funcții, gestionarea accesului și desfășurarea automatizată a noilor versiuni se pot realiza foarte convenabil în DBT.
Folosim UDF pe Python pentru a calcula valori hash, domenii de adrese de email și pentru a decoda măști de biți (bitmask).
Exemplu de macro care creează UDF pe orice mediu de execuție (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
La Wheely folosim Amazon Redshift, care se bazează pe PostgreSQL. Este important pentru Redshift să adunăm regulat statistici pentru tabele și să eliberăm spațiu pe disc — comenzile ANALYZE și VACUUM, respectiv.
Pentru aceasta, în fiecare noapte se execută comenzile din macro-ul redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " of " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
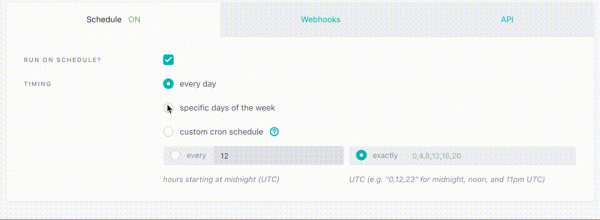
Există posibilitatea de a folosi DBT ca serviciu (Managed Service). Inclus:
- Web IDE pentru dezvoltarea proiectelor și modelor
- Configurarea joburilor și stabilirea unui program
- Acces simplu și comod la jurnale
- Site web cu documentația proiectului dvs.
- Conectare CI (Continuous Integration)
Concluzie
A pregăti și a consuma DWH devine la fel de plăcut și benefic ca a bea un smoothie. DBT este compus din Jinja, extensii personalizate (module), un compilator, un motor (executor) și un manager de pachete. Adunând aceste elemente la un loc, obțineți un mediu de lucru complet pentru Depozitul de Date. Astăzi, este greu să găsești o metodă mai bună de gestionare a transformărilor în cadrul DWH.
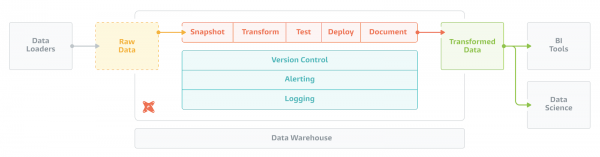
Credințele pe care le-au urmat dezvoltatorii DBT sunt formulate astfel:
- Codul, nu interfața grafică, este cea mai bună abstrahere pentru a exprima o logică analitică complexă.
- Lucrul cu datele ar trebui să adapteze cele mai bune practici de dezvoltare software (Software Engineering).
- Infrastructura esențială pentru lucrul cu datele ar trebui să fie controlată de comunitatea de utilizatori ca software open-source.
- Nu doar instrumentele de analiză, ci și codul vor deveni din ce în ce mai des parte a comunității Open Source.
Aceste credințe fundamentale au generat un produs care este astăzi utilizat în peste 850 de companii și constituie baza multor extensii interesante care vor fi dezvoltate în viitor.
Pentru cei interesați, există un videoclip al unei lecții deschise pe care am susținut-o acum câteva luni în cadrul unei lecții deschise în OTUS — .
Pe lângă DBT și Depozitele de Date, în cadrul cursului Data Engineer pe platforma OTUS, eu și colegii mei desfășurăm cursuri pe o serie de alte subiecte actuale și moderne:
- Conceptele arhitecturale ale aplicațiilor Big Data.
- Practică cu Spark și Spark Streaming.
- Studii asupra modurilor și instrumentelor de încărcare a surselor de date.
- Construirea vitrinelor analitice în DWH.
- Conceptele NoSQL: HBase, Cassandra, ElasticSearch.
- Principiile organizării monitorizării și orchestratului.
- Proiect final: reunim toate abilitățile sub sprijinul unui mentor.
Linkuri:
- — Documentația oficială.
- — Articol de prezentare de la unul dintre autorii DBT.
- — YouTube, înregistrarea lecției deschise OTUS.
- — Următoarea lecție deschisă pe 15 mai 2020.
- — OTUS.
- — O privire asupra viitorului lucrului cu date și analiză.
- — Evoluția analizei și influența Open Source.
- — Principiile construirii CI cu utilizarea DBT.
- — Practică, instrucțiuni pas cu pas pentru autodidacție.
- — Github, codul proiectului de învățare
Sursa: habr.com
