

SQL, ce poate fi mai simplu? Fiecare dintre noi poate scrie o interogare simplă — introducem select, enumerăm coloanele necesare, apoi from, numele tabelului, puține condiții în unde și gata — datele utile sunt în mână, iar (aproape) indiferent de baza de date care rulează în acest moment (sau poate că ). În rezultat, lucrul cu orice sursă de date (relațională sau nu) poate fi analizat din perspectiva codului obișnuit (cu toate implicațiile — controlul versiunilor, revizuirea codului, analiza statică, teste automate și tot așa). Și acesta nu se referă doar la datele în sine, scheme și migrații, ci la întreaga activitate a stocării. În acest articol, ne vom concentra asupra problemelor și sarcinilor zilnice legate de lucru cu diferite baze de date sub privirea conceptului de "database as code".
Și vom începe direct cu . Primele bătălii de tip "SQL vs ORM" au fost observate încă în .
Maparea obiect-relație
Susținătorii ORM apreciază tradițional viteza și simplitatea dezvoltării, independența de baza de date și curățenia codului. Pentru mulți dintre noi, codul de lucru cu baza de date (și adesea însăși baza de date)
arată de obicei cam așa…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Modelul este îmbogățit cu anotații inteligente, iar undeva în spatele scenei, bravul ORM generează și execută tone de cod SQL. Așa cum este de spus, dezvoltatorii încearcă din răsputeri să se izoleze de baza de date cu kilometri de abstracții, ceea ce sugerează o oarecare .
De cealaltă parte a baricadei, susținătorii purului "handmade"-SQL observă posibilitatea de a stoarce toate sucurile din baza de date fără straturi și abstracții suplimentare. În rezultatul a ceea ce apare proiecte "data-centric", unde baza de date este gestionată de oameni special instruiți (numiți și "bazisti", "bază-VIC", "bază-vieți" etc.), iar dezvoltatorilor le rămâne doar să "tragă" din vizualizările gata făcute și procedurile stocate, fără a intra în detalii.
Și ce ar fi dacă am lua ce e mai bun din ambele lumi? Așa cum este realizat în acest instrument minunat cu un nume optimist . Voi prezenta câteva rânduri din conceptul general în traducerea mea liberă, iar pentru mai multe detalii cu acesta se poate face cunoștință .
Clojure este un limbaj grozav pentru crearea DSL-urilor, dar SQL este deja un DSL fantastic în sine, așa că nu avem nevoie de unul suplimentar. S-exprimările sunt frumoase, dar nu aduc nimic nou în această situație. În cele din urmă, obținem paranteze pentru simpla plăcere a parantezelor. Nu ești de acord? Așteaptă momentul în care abstracția asupra bazei de date va începe să piardă informații și vei începe lupta cu funcția. (raw-sql)
Și ce putem face? Să lăsăm SQL să fie pur și simplu SQL — un fișier pentru o interogare:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… și apoi citește acest fișier, transformându-l într-o funcție Clojure obișnuită:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; A fost creată o funcție cu numele `users-by-country`.
;;; Să o folosim:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Respectând principiul „SQL separat, Clojure separat”, obțineți:
- Fără surprize de sintaxă. Baza ta de date (la fel ca orice altă bază de date) nu respectă standardul SQL în proporție de 100% — dar pentru Yesql acest lucru nu contează. Nu vei pierde niciodată timp căutând funcții cu o sintaxă echivalentă cu SQL. Nu va trebui niciodată să te întorci la funcția (raw-sql "some (‘funky’ :: SYNTAX)")).
- Cea mai bună susținere din partea editorului. Editorul tău deja are un suport excelent pentru SQL. Păstrând SQL ca SQL, poți pur și simplu să-l folosești.
- Compatibilitate în echipă. DBA-ii tăi pot citi și scrie SQL-ul pe care îl folosești în proiectul tău Clojure.
- Configurare de performanță mai simplă. Trebuie să construiești un plan pentru o interogare problematică? Nu este o problemă atunci când interogarea ta este pur și simplu SQL obișnuit.
- Reutilizarea interogărilor. Poți să tragi aceleași fișiere SQL în alte proiecte, deoarece este doar vechiul SQL — pur și simplu împărtășește-l.
Din punctul meu de vedere, ideea este foarte grozavă și în același timp extrem de simplă, ceea ce a dus la obținerea multor în diverse limbi. Aici vom încerca să aplicăm o filosofie similară de separare a codului SQL de restul, mult dincolo de ORM.
IDE & DB-gestionari
Să începem cu o sarcină simplă de zi cu zi. Adesea trebuie să căutăm anumite obiecte în baza de date, de exemplu, să găsim o masă în schemă și să studiem structura ei (ce coloane, chei, indecși, constrângeri etc. sunt utilizate). Și de la orice IDE grafic sau un manager de baze de date minimal, ne așteptăm mai întâi la aceste abilități. Să fie rapid și să nu trebuiască să așteptăm o jumătate de oră până se deschide fereastra cu informațiile necesare (mai ales în cazul unei conexiuni lente cu o bază de date de la distanță), și, în același timp, ca informațiile primite să fie proaspete și actuale, nu vechi cache-uite. Cu cât baza de date este mai complexă și mai mare, iar numărul lor este mai mare, cu atât devine mai dificil de realizat acest lucru.
Însă, de obicei, îmi pun mouse-ul deoparte și pur și simplu scriu cod. Să zicem că trebuie să aflu ce mese (și cu ce proprietăți) se află în schema "HR". În cea mai mare parte a SGBD-urilor, rezultatul dorit poate fi obținut cu o astfel de interogare simplă din information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
De la o bază de date la alta, conținutul acestor mese de referință variază în funcție de capabilitățile fiecărei SGBD. Și, de exemplu, pentru MySQL, din același director, se pot obține parametrii specifici pentru această SGBD:
select table_name
     , storage_engine -- Motorul utilizat ("MyISAM", "InnoDB" etc)
     , row_format     -- Formatul rândului ("Fixed", "Dynamic" etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle nu are information_schema, dar are , și nu apar mari probleme:
select table_name
     , pct_free       -- Minim de spațiu liber în blocul de date (%)
     , pct_used       -- Minim de spațiu utilizat în blocul de date (%)
     , last_analyzed  -- Data ultimei analizări a statisticilor
     , ...
  from all_tables
 where owner = 'HR'
Nu face excepție nici ClickHouse:
select name
     , engine -- Motorul utilizat ("MergeTree", "Dictionary" etc)
     , ...
  from system.tables
 where database = 'HR'
Ceva similar se poate face și în Cassandra (unde există columnfamilies în loc de mese și keyspace-uri în loc de scheme):
select columnfamily_name
     , compaction_strategy_class  -- Strategia de colectare a deșeurilor
     , gc_grace_seconds           -- Timpul de viață al deșeurilor
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Pentru majoritatea celorlalte baze de date, se pot inventa interogări similare (chiar și în Mongo există , care conține informații despre toate colecțiile din sistem).
Desigur, în acest mod se poate obține informații nu doar despre tabele, ci și despre orice obiect. Periodic, persoane binevoitoare împărtășesc astfel de coduri pentru diferite baze de date, cum ar fi, de exemplu, în seria de articole de pe Habr "Funcții pentru documentarea bazelor de date PostgreSQL" (, , ). Desigur, a ține toată această mulțime de interogări în minte și a le tasta constant nu este un "mare" confort, așa că, în IDE-ul/ editorul meu preferat, am un set de snippet-uri pregătite pentru interogările utilizate frecvent și trebuie doar să introduc numele obiectelor în șablon.
În final, acest mod de navigare și căutare a obiectelor este mult mai flexibil, economisește mult timp și permite obținerea exact informațiilor necesare în formatul dorit (așa cum este descris în postarea ).
Operații cu obiecte
După ce am găsit și studiat obiectele necesare, este momentul să facem ceva util cu ele. Desigur, fără a ne desprinde de tastatură.
Nu este un secret că simpla ștergere a unei tabele va arăta aproape identic în toate bazele de date:
drop table hr.personsDar în ceea ce privește crearea unei tabele, lucrurile devin mai interesante. Practic, orice SGBD (inclusiv multe NoSQL) poate efectua în vreun fel "create table", iar cea mai mare parte va fi similară (numele, lista coloanelor, tipurile de date), dar celelalte detalii pot diferenția semnificativ și depind de structura internă și capacitățile fiecărui SGBD specific. Exemplul meu preferat este că în documentația Oracle, doar definițiile BNF pentru sintaxa "create table" . Alte SGBD au capacități mai modeste, dar fiecare dintre ele are, de asemenea, o mulțime de caracteristici interesante și unice pentru crearea tabelelor (, , , ). Este puțin probabil ca vreun "wizard" grafic dintr-o IDE oarecare (mai ales una universală) să poată acoperi complet toate aceste capacități, iar dacă ar reuși, ar fi o vedere nu pentru cei slabi de inimă. Între timp, un operator corect și scris la timp create table va permite să profitați ușor de toate acestea, făcând stocarea și accesul la datele dumneavoastră fiabile, optime și cât mai plăcute posibil.
De asemenea, multe SGBD-uri au tipuri de obiecte specifice care lipsesc în alte SGBD-uri. Și putem efectua operații nu doar pe obiectele Bazei de Date, ci și pe SGBD-ul în sine, de exemplu, putem "omorî" un proces, elibera o zonă de memorie, activa trasarea, trece în modul "doar citire" și multe altele.
Acum hai să desenăm puțin.
Una dintre cele mai comune sarcini este să construiești un diagramă cu obiectele Bazei de Date, să vezi într-o imagine frumoasă obiectele și relațiile dintre ele. Practic orice IDE grafic, unele utilitare "de linie de comandă", unelte grafice specializate și modelatori pot face acest lucru. Acestea îți vor desena ceva "așa cum știu", iar să influențezi acest proces puțin se poate face doar prin câțiva parametri în fișierul de configurare sau bifând anumite opțiuni în interfață.
Însă această problemă poate fi rezolvată mult mai simplu, mai flexibil și mai elegant, și desigur, cu ajutorul codului. Pentru construirea diagramelor de orice complexitate, avem la dispoziție mai multe limbaje de marcare specializate (DOT, GraphML etc), și o mulțime de aplicații (GraphViz, PlantUML, Mermaid) care pot să citească astfel de instrucțiuni și să vizualizeze în cele mai variate formate. Iar informațiile despre obiecte și relațiile dintre ele le știm deja cum să le obținem.
Să dăm un mic exemplu despre cum ar putea arăta, folosind PlantUML și (în stânga interogarea SQL care va genera instrucțiunea necesară pentru PlantUML, iar în dreapta rezultatul):
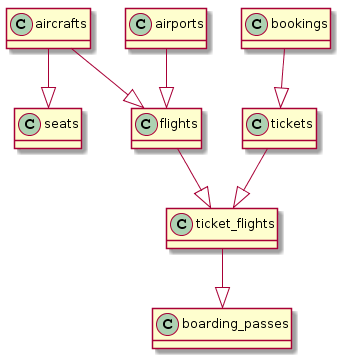
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Și dacă te străduiești puțin, pe baza poți obține ceva foarte asemănător cu o diagramă ER reală:
Interogarea SQL e puțin mai complexă.
-- Antet
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabele
select format('Table(%s, "%s n information about %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relații între tabele
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s may haven many %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Subsol
select '@enduml' 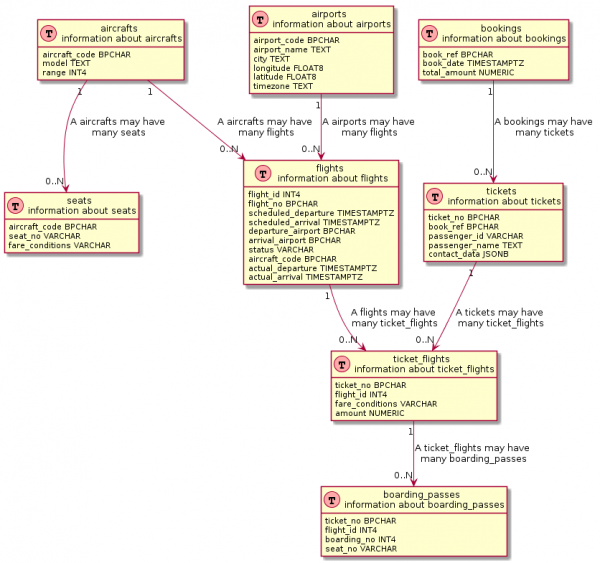
Dacă te uiți atent, multe dintre uneltele de vizualizare folosesc la fel de bine interogări asemănătoare sub capotă. Totuși, aceste interogări sunt de obicei adânc , darămite modificarea lor.
Metrii și monitorizare.
Să trecem la un subiect tradițional complicat — monitorizarea performanței bazelor de date. Îmi aduc aminte o poveste adevărată, spusă de „unul dintre prietenii mei”. Într-un proiect, exista un DBA foarte puternic, cu care rar dezvoltatorii erau familiarizați, și mai ales, nimeni nu l-a văzut vreodată în persoană (deși se spune că lucra undeva în clădirea vecină). În momentul „X”, când sistemul de producție al unui mare retailer începea din nou să „se simtă rău”, el trimitea în tăcere capturi de ecran ale unor grafice din Oracle Enterprise Manager, unde sublinia cu un marker roșu locurile critice pentru „claritate” (ceea ce, cu alte cuvinte, ajuta foarte puțin). Și astfel, pe baza acestei „fotografii” trebuia să se ia măsuri. În plus, nimeni nu avea acces la prețiosul (în ambele sensuri ale cuvântului) Enterprise Manager, deoarece sistemul era complex și scump, iar dezvoltatorii „s-ar putea să strice ceva”. Așa că dezvoltatorii găseau locul și cauza întârzierilor prin metode „empirice” și lansau un patch. Dacă o scrisoare înfricoșătoare de la DBA nu sosea din nou în curând, toată lumea respira ușurat și se întorcea la sarcinile curente (până la următoarea Scrisoare).
Însă procesul de monitorizare poate arăta mult mai vesel și prietenos, iar cel mai important — accesibil și transparent pentru toți. Măcar partea sa de bază, ca o completare la principalele sisteme de monitorizare (care sunt fără îndoială utile și în multe cazuri indispensabile). Orice SGBD este dispus să împărtășească informații despre starea și performanța sa curentă complet gratuit. În aceeași „sângeroasă” Oracle DB, aproape orice informație despre performanță poate fi obținută din vederile sistemului, începând cu procesele și sesiuni și terminând cu starea memoriei cache (de exemplu, , secțiunea „Monitorizare”). În PostgreSQL există de asemenea o mulțime de vederi sistemice pentru , în special unele indispensabile în viața de zi cu zi a oricărui DBA, cum ar fi , , . În MySQL, pentru acest scop, există chiar o schemă separată . Iar în Mongo, există un care agregă datele de performanță într-o colecție sistemică .
Așadar, echipându-ne cu un colector de metrici (Telegraf, Metricbeat, Collectd), care poate efectua interogări SQL personalizate, un depozit pentru aceste metrici (InfluxDB, Elasticsearch, Timescaledb) și un vizualizator (Grafana, Kibana), putem obține un sistem de monitorizare destul de ușor și flexibil, care va fi strâns integrat cu alte metrici sistemice generale (obținute, de exemplu, de la serverul aplicațiilor, de la OS și altele). De exemplu, așa cum este implementat în pgwatch2, unde se utilizează combinația InfluxDB + Grafana și un set de interogări la vizualizările sistemului, la care se pot adăuga .
În concluzie
Și aceasta este doar o listă aproximativă a ceea ce se poate face cu baza noastră de date prin intermediul codului SQL obișnuit. Sunt sigur că pot exista multe alte aplicații, scrieți în comentarii. Iar despre cum (și, cel mai important, de ce) să automatizăm totul și să-l integrăm în pipeline-ul nostru CI/CD, vom vorbi data viitoare.
Sursa: habr.com
