

Compania Variti dezvoltă soluții de protecție împotriva botilor și atacurilor DDoS, precum și teste de stres și de sarcină. La conferința HighLoad++ 2018, am discutat despre cum să protejăm resursele de diferite tipuri de atacuri. Pe scurt: izolați părțile sistemului, utilizați servicii cloud și CDN și actualizați-vă regulat. Dar fără companii specializate în securitate, nu veți face față 🙂
Înainte de a citi textul, puteți consulta un rezumat scurt .
Dacă nu vă place să citiți sau doriți pur și simplu să vizionați un videoclip, înregistrarea prezentării noastre se află mai jos sub spoiler.
Înregistrarea video a prezentării
Multe companii deja știu să efectueze teste de sarcină, dar nu toate fac teste de stres. Unii dintre clienții noștri cred că site-ul lor este invulnerabil, deoarece au un sistem highload, care îi protejează bine de atacuri. Noi însă demonstrăm că nu este chiar așa.
Desigur, înainte de a efectua testele, obținem permisiunea de la client, cu semnătură și ștampilă, iar cu ajutorul nostru nu se poate efectua o atac DDoS împotriva nimănui. Testarea se realizează în timpul selectat de client, când traficul pe resursa sa este minim, iar problemele de acces nu afectează clienții. În plus, deoarece în timpul testării pot apărea probleme, avem un contact permanent cu clientul. Acest lucru ne permite nu doar să raportăm rezultatele atinse, ci și să facem modificări pe parcursul testării. La finalizarea testării, întotdeauna întocmim un raport, în care menționăm deficiențele descoperite și oferim recomandări pentru remedierea punctelor slabe ale site-ului.
Cum lucrăm
În timpul testării, emulăm un botnet. Deoarece lucrăm cu clienți care nu se află în rețelele noastre, pentru a evita ca testul să se termine în prima minută din cauza activării limitelor sau protecției, furnizăm sarcina nu dintr-o singură adresă IP, ci din propria noastră subrețea. În plus, pentru a genera o sarcină semnificativă, avem propriul server de testare destul de puternic.
Postulate
Mult nu înseamnă neapărat bine
Cu cât putem reduce sarcina până la punctul de eșec al resursei, cu atât mai bine. Dacă reușim să facem ca site-ul să înceteze să funcționeze de la o solicitare pe secundă sau chiar de la o solicitare pe minut, este minunat. Pentru că, conform legii lui Murphy, utilizatorii sau atacatorii vor cădea întâmplător exact pe această vulnerabilitate.
Eșecul parțial este mai bun decât cel complet
Întotdeauna recomandăm să facem sistemele heterogene. Și trebuie să le separăm la nivel fizic, nu doar prin containerizare. În cazul separării fizice, chiar dacă ceva pe site eșuează, există o mare probabilitate ca acesta să nu înceteze complet să funcționeze, iar utilizatorii să aibă acces cel puțin la o parte din funcționalitate.
Arhitectura corectă este fundamentul rezistenței
Rezistența resursei și capacitatea sa de a rezista atacurilor și sarcinilor trebuie să fie integrate în etapa de proiectare, de fapt, încă de la desenarea primelor diagrame în caiet. Pentru că dacă se strecoară erori fatale, este posibil să le corectăm ulterior, dar este foarte greu.
Nu doar codul, ci și configurația trebuie să fie bună
Mulți cred că o echipă bună de dezvoltare este o garanție a rezistenței serviciului. O echipă bună de dezvoltare este într-adevăr necesară, dar trebuie să existe și o bună operare, un bun DevOps. Cu alte cuvinte, sunt necesari specialiști care să configureze corect Linux-ul și rețeaua, să scrie corect configurațiile în nginx, să stabilească limitele etc. Altfel, resursa va funcționa bine doar în test, iar în producție, la un moment dat, totul se va strica.
Diferențele dintre testarea de sarcină și testarea de stres
Testarea de sarcină permite identificarea limitelor de funcționare ale sistemului. Testarea de stres este destinată identificării punctelor slabe ale sistemului și este utilizată pentru a „sparge” acest sistem și a observa cum se va comporta în timpul eșecului unor părți. În acest timp, caracteristica sarcinii rămâne de obicei necunoscută pentru client până la începutul testării de stres.
Trăsături distinctive ale atacurilor L7
Tipurile de sarcină le împărțim de obicei în sarcini de nivel L7 și L3&4. L7 este sarcina la nivel de aplicație, de cele mai multe ori se referă doar la HTTP, dar noi înțelegem orice sarcină la nivelul protocolului TCP.
Atacurile L7 au anumite trăsături distinctive. În primul rând, acestea vizează direct aplicația, ceea ce face dificilă stoparea lor prin mijloace de rețea. Aceste atacuri implică logică și, datorită acestui lucru, consumă foarte eficient CPU, memorie, disc, bază de date și alte resurse, chiar și cu un trafic redus.
Inundație HTTP
În cazul oricărui atac, este mai ușor să generezi încărcare decât să o gestionezi, iar în cazul L7, acest lucru este de asemenea adevărat. Traficul atacului nu este întotdeauna ușor de distins de cel legitim și cel mai adesea acest lucru se poate face în funcție de frecvență, dar dacă totul este planificat corect, este imposibil să înțelegi din jurnale unde este atacul și unde sunt cererile legitime.
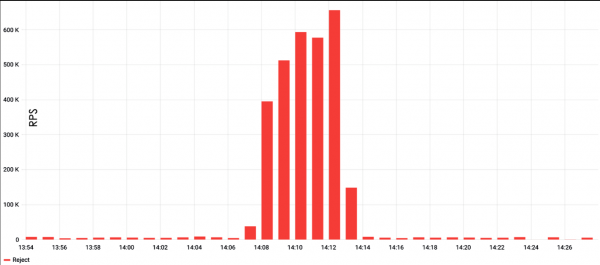
Ca prim exemplu, să analizăm atacul Inundație HTTP. Din grafic se poate observa că, de obicei, aceste atacuri sunt foarte puternice, în exemplul de mai jos, numărul maxim de cereri a depășit 600 de mii pe minut.
Inundația HTTP este cea mai simplă modalitate de a crea încărcare. De obicei, se folosește un instrument de testare a încărcării, cum ar fi ApacheBench, și se stabilesc o cerere și o țintă. Cu o abordare atât de simplă, riscul de a întâmpina probleme cu caching-ul serverului este ridicat, dar acesta poate fi evitat cu ușurință. De exemplu, adăugând șiruri aleatorii în cerere, ceea ce va obliga serverul să livreze constant pagina proaspătă.
De asemenea, nu trebuie uitat de user-agent în procesul de generare a încărcării. Multe user-agent-uri ale instrumentelor populare de testare sunt filtrate de administratori de sistem, și în acest caz, încărcarea poate să nu ajungă deloc la backend. Rezultatul poate fi semnificativ îmbunătățit prin inserarea unui antet valid din browser în cerere.
În ciuda simplității atacului, inundațiile HTTP au și dezavantajele lor. În primul rând, pentru a genera încărcare sunt necesare resurse mari. În al doilea rând, aceste atacuri sunt foarte ușor de detectat, mai ales dacă vin dintr-o singură adresă. Drept urmare, cererile încep imediat să fie filtrate fie de administratorii de sistem, fie chiar la nivelul furnizorului.
Ce să cauți
Pentru a reduce numărul de cereri pe secundă fără a pierde din eficiență, trebuie să ne folosim imaginația și să investigăm site-ul. Astfel, putem solicita nu doar canalul sau serverul, ci și părți separate ale aplicației, cum ar fi bazele de date sau sistemele de fișiere. De asemenea, putem căuta zone pe site care efectuează calcule complexe: calculatoare, pagini de recomandare de produse etc. În cele din urmă, se întâmplă adesea ca pe site să existe un script PHP care generează o pagină din câteva sute de mii de linii. Un astfel de script poate suprasolicita semnificativ serverul și poate deveni o țintă pentru un atac.
Unde să căutăm
Când scanăm resursa înainte de a desfășura testarea, ne uităm, desigur, la site-ul însuși. Căutăm diverse câmpuri de introducere, fișiere mari – în general, tot ce ar putea crea probleme resursei și ar putea încetini funcționarea acesteia. Aici ne ajută simplele instrumente de dezvoltare din Google Chrome și Firefox, care arată timpii de răspuns ai paginii.
De asemenea, scanăm subdomeniile. De exemplu, există un magazin online, abc.com, care are un subdomeniu admin.abc.com. Probabil este o interfață de administrare cu autentificare, dar dacă îi aducem o sarcină, aceasta poate crea probleme pentru resursa principală.
Site-ul poate avea un subdomeniu api.abc.com. Probabil acesta este un resource pentru aplicații mobile. Aplicația poate fi găsită în App Store sau Google Play, se poate stabili un hotspot special, modifica API-ul și înregistra conturi de testare. Problema este că, de cele mai multe ori, oamenii cred că tot ce este protejat prin autentificare este invulnerabil la atacuri de tip denial of service. De parcă autentificarea este cel mai bun CAPTCHA, dar nu este adevărat. Crearea a 10-20 de conturi de testare este ușoară, iar odată ce le avem, obținem acces la funcționalități complexe și necorectate.
Desigur, ne uităm la istoric, la robots.txt și WebArchive, ViewDNS, căutăm versiuni vechi ale resursei. Uneori se întâmplă ca dezvoltatorii să lanseze, să zicem, mail2.yandex.net, iar o versiune veche, mail.yandex.net, să rămână. Acest mail.yandex.net încetează să fie suportat, resursele de dezvoltare nu mai sunt alocate pentru el, dar continuă să consume baza de date. Prin urmare, cu ajutorul versiunii vechi putem folosi eficient resursele backend-ului și tot ceea ce se află în spatele structurării. Desigur, asta nu se întâmplă întotdeauna, dar ne confruntăm cu astfel de situații destul de des.
Desigur, analizăm toți parametrii cererii, structura cookie-urilor. Putem, de exemplu, să încarcăm în JSON un array în interiorul cookie-ului cu o anumită valoare, să creăm o ierarhie mare și să facem ca resursa să funcționeze extrem de lent.
Încărcare în căutare
Primul lucru care îmi vine în minte când analizez un site este să încarc baza de date, având în vedere că căutarea există aproape pe toate site-urile, iar majoritatea dintre ele, din păcate, sunt prost protejate. De ceva vreme, dezvoltatorii nu acordă suficientă atenție căutării. Totuși, există o recomandare: nu faceți cereri repetitive, deoarece s-ar putea să vă confruntați cu cache, la fel ca în cazul unui atac HTTP flood.
De asemenea, a face cereri aleatorii în baza de date nu este întotdeauna eficient. Mult mai bine este să creați o listă de cuvinte cheie relevante pentru căutare. Dacă revenim la exemplul unui magazin online: să presupunem că site-ul vinde anvelope auto și permite stabilirea razei anvelopelor, tipului de mașină și altor parametrii. Prin urmare, combinațiile de cuvinte relevante fac ca baza de date să funcționeze în condiții mult mai complexe.
În plus, este recomandat să folosiți paginarea: căutarea este mult mai dificilă atunci când trebuie să ofere înainte penultima pagină a rezultatelor decât prima. Asta înseamnă că prin paginare puteți diversifica puțin încărcarea.
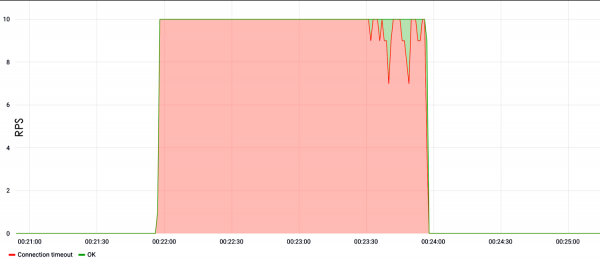
În exemplul de mai jos, ilustrăm încărcarea în căutare. Se observă că încă din prima secundă a testului cu zece cereri pe secundă, site-ul s-a prăbușit și nu a mai răspuns.
Dacă nu există căutare?
Dacă nu există căutare, nu înseamnă că site-ul nu conține alte câmpuri vulnerabile. Un astfel de câmp ar putea fi autentificarea. În prezent, dezvoltatorii iubesc să facă hash-uri complexe pentru a proteja baza de date a logins-urilor împotriva atacurilor cu tabele rainbow. Acest lucru este bine, dar aceste hash-uri consumă resurse mari de CPU. Un flux mare de autentificări false duce la eșecul procesorului, iar ca urmare, la final, site-ul nu mai funcționează.
Prezența pe site a diferitelor formulare pentru comentarii și feedback este un motiv bun pentru a trimite texte foarte mari sau pur și simplu pentru a genera spam în masă. Uneori, site-urile acceptă fișiere încărcate, inclusiv în format gzip. În acest caz, luăm un fișier de 1TB, îl comprimăm cu gzip la câțiva octeți sau kiloocteți și îl trimitem pe site. Apoi este dezarhivat, creând un efect foarte interesant.
Rest API
Ar fi bine să acordăm puțin atenție unor servicii care sunt foarte populare în prezent, cum ar fi Rest API. Protejarea unui Rest API este mult mai complicată decât protejarea unui site obișnuit. Chiar și cele mai banale metode de protecție împotriva atacurilor brute force și a altor activități ilegitime nu funcționează pentru Rest API.
Rest API este foarte ușor de compromis, deoarece se conectează direct la baza de date. În acest caz, oprirea unui astfel de serviciu are consecințe destul de grave pentru afacere. Problema este că de obicei Rest API este legat nu doar de site-ul principal, ci și de aplicația mobilă, de diverse resurse interne de afaceri. Și dacă toate acestea cedează, efectul este de multe ori mai pronunțat decât în cazul unei căderi simple a unui site.
Încărcătura pe conținut greu
Dacă ni se oferă să testăm o aplicație obișnuită de tip single-page, un landing page, sau un site de vizită, care nu are funcționalități complexe, căutăm conținut greu. De exemplu, imagini mari livrate de server, fișiere binare, documentație PDF — încercăm să descărcăm toate acestea. Astfel de teste solicită bine sistemul de fișiere și blochează canalele, fiind astfel eficiente. Adică, chiar dacă nu reușiți să dăunați serverului, descărcând un fișier mare la viteze mici, pur și simplu veți aglomera canalul serverului țintă, iar astfel veți genera un refuz de serviciu.
Dintr-un astfel de test se observă că la o viteză de 30 RPS site-ul nu a mai răspuns, sau a returnat erori de tip 500.
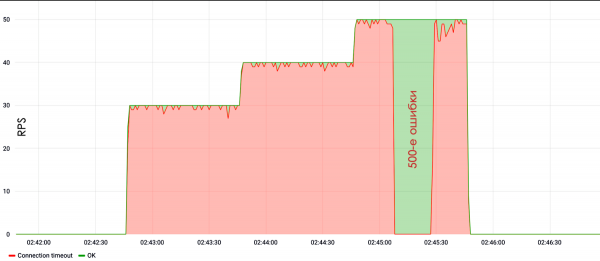
Nu trebuie să uităm de configurarea serverelor. Adesea putem observa că o persoană a cumpărat o mașină virtuală, a instalat Apache pe aceasta, a configurat totul din setările implicite, a plasat aplicația PHP, iar mai jos putem vedea rezultatul.
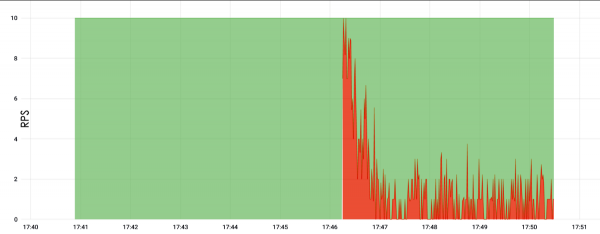
Aici încărcătura a mers în rădăcină și a fost de doar 10 RPS. Am așteptat 5 minute și serverul a cedat. De fapt, nu se știe precis de ce a cedat, dar se presupune că pur și simplu a consumat toată memoria și de aceea nu a mai răspuns.
Wave based
În ultimii ani, atacurile de tip wave au devenit destul de populare. Acest lucru se datorează faptului că multe organizații achiziționează diverse echipamente pentru protecția împotriva DDoS, care necesită o anumită perioadă pentru acumularea de statistici pentru a începe filtrarea atacului. Cu alte cuvinte, ele nu filtrează atacul în primele 30-40 de secunde, deoarece acumulează date și se antrenează. În consecință, în aceste 30-40 de secunde, se poate lansa atât de multă trafic pe site încât resursa va rămâne inaccesibilă o perioadă lungă de timp, până când toate cererile sunt procesate.
În cazul atacului de mai jos, intervalul a fost de 10 minute, după care a venit o nouă porțiune modificată a atacului.
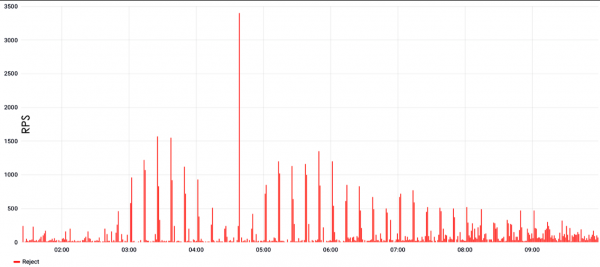
Asta înseamnă că protecția s-a antrenat, a început filtrarea, dar a venit o nouă porțiune de atac complet diferită și protecția a început din nou antrenamentul. De fapt, filtrarea încetează să mai funcționeze, protecția devine ineficientă și site-ul devine inaccesibil.
Atacurile de tip wave se caracterizează prin valori foarte mari la vârf, putând atinge sută de mii sau milioane de cereri pe secundă, în cazul L7. Dacă vorbim despre L3&4, atunci acolo pot fi sute de gigabiți de trafic sau, respectiv, sute de mpps, dacă ne raportăm la pachete.
Problema acestor atacuri constă în sincronizare. Atacurile vin din botnet-uri, iar pentru a crea un vârf de atac foarte mare, este necesară o sincronizare ridicată. Această coordonare nu reușește întotdeauna: uneori rezultatul este un vârf parabolic, care arată destul de lamentabil.
Nu doar HTTP
Pe lângă HTTP la nivelul L7, ne place să exploatăm și alte protocoale. De obicei, un site web obișnuit, și mai ales un hosting obișnuit, expune protocoale de email și MySQL. Protocoalele de email sunt mai puțin susceptibile la sarcini decât bazele de date, dar pot fi, de asemenea, suprasolicitate suficient de eficient, ducând la un CPU supraaglomerat pe server.
Am obținut rezultate reale prin exploatarea vulnerabilității SSH din 2016. Acum, această vulnerabilitate este majoritatea corectată, dar asta nu înseamnă că nu pot fi generate sarcini pe SSH. Se poate. Pur și simplu, se generează o sarcină enormă de autentificări, SSH consumă aproape tot CPU-ul de pe server, iar site-ul web cedează deja de la una-două cereri pe secundă. În consecință, aceste una sau două cereri nu pot fi diferențiate din jurnale de o sarcină legitimă.
Rămân relevante și numeroase conexiuni pe care le deschidem pe servere. În trecut, Apache a avut această problemă, iar acum nginx se confruntă în mod similar, deoarece este adesea configurat implicit. Numărul de conexiuni pe care nginx le poate menține deschise este limitat; astfel, odată ce atingem acest număr de conexiuni, nginx nu acceptă mai multe, iar site-ul nu mai funcționează.
Cluster-ul nostru de testare dispune de suficient CPU pentru a ataca SSL handshake. În principiu, după cum arată practica, botnet-urile fac și ele uneori acest lucru. Pe de o parte, este clar că fără SSL nu putem evita, datorită rezultatelor Google, clasificării și securității. Pe de altă parte, SSL, din păcate, are o problemă cu CPU.
L3&4
Când vorbim de atacuri la nivelurile L3&4, de obicei ne referim la atacuri la nivelul canalului. Această încărcare este aproape întotdeauna distinctă de cea legitimă, cu excepția cazului atacului SYN-flood. Problema atacurilor SYN-flood pentru măsurile de protecție constă în volumul mare. Valoarea maximă pentru L3&4 a fost de 1,5-2 Tbps. Un astfel de trafic este foarte greu de gestionat chiar și pentru companii mari, inclusiv Oracle și Google.
SYN și SYN-ACK sunt pachete utilizate în timpul stabilirii unei conexiuni. Prin urmare, SYN-flood este greu de distins de încărcarea legitimă: nu este clar dacă este un SYN care a venit pentru a stabili o conexiune sau o parte a unui flud.
UDP-flood
De obicei, infractorii nu au resursele pe care le avem noi, așa că pentru organizarea atacurilor se poate folosi amplificarea. Adică, infractorul scanează internetul și găsește fie servere vulnerabile, fie configurate greșit, care răspund, de exemplu, cu trei SYN-ACK la un singur pachet SYN. Schimbând adresa sursei cu cea a serverului țintă, printr-un singur pachet, se poate amplifica puterea, să zicem, de trei ori și redirecționa traficul către victimă.
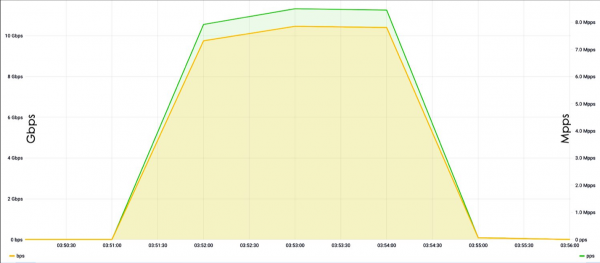
Problema amplificărilor constă în dificultatea de a le detecta. Unul dintre cele mai recente exemple este cazul bine cunoscut cu memcached vulnerabil. În plus, acum există foarte multe dispozitive IoT, camere IP, care de obicei sunt configurate implicit greșit, astfel că infractorii folosesc aceste dispozitive pentru a derula atacuri mai des.
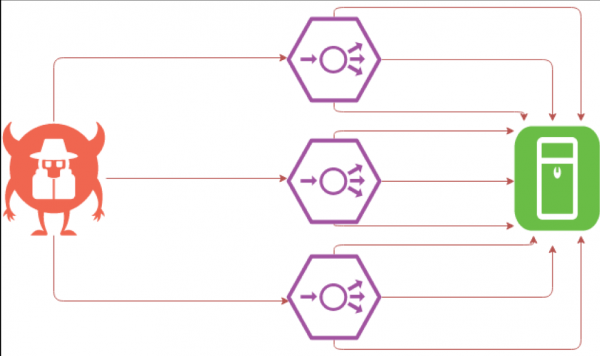
SYN-flood complicat
SYN-flood este, probabil, cea mai interesantă formă de atac din perspectiva dezvoltatorului. Problema este că de multe ori administratorii de sistem folosesc blocarea pe IP pentru protecție. Din păcate, blocarea pe IP afectează nu doar administratori care acționează conform unor scripturi, ci și unele sisteme de protecție foarte costisitoare.
Această metodă poate deveni o catastrofă, deoarece dacă atacatorii substituie adrese IP, compania își va bloca propria subrețea. Când Firewall-ul își blochează propriul cluster, interacțiunile externe se vor prăbuși, iar resursa va ceda.
Achiziționarea blocării propriei rețele nu este complicată. Dacă în biroul clientului există o rețea WI-Fi sau dacă funcționalitatea resurselor este evaluată prin diferite monitorizări, luăm adresa IP a acestui sistem de monitorizare sau a clientului Wi-Fi din birou și o folosim ca sursă. În acest caz, resursa pare a fi disponibilă, dar adresele IP țintă sunt blocate. Astfel, rețeaua Wi-Fi a conferinței HighLoad, care prezintă un nou produs al companiei, poate fi blocată — ceea ce implică anumite costuri de afaceri și economice.
În timpul testărilor, nu putem folosi amplificarea prin memcached cu resurse externe, deoarece există acorduri pentru transmiterea traficului doar către adrese IP autorizate. Drept urmare, folosim amplificarea prin SYN și SYN-ACK, când pentru trimiterea unui SYN, sistemul răspunde cu două-trei SYN-ACK și, astfel, atacul este multiplicat de două-trei ori.
Instrumente
Unul dintre principalele instrumente pe care le folosim pentru a genera încărcare la nivel de L7 este Yandex-tank. În mod special, se folosește „fanfara” Phantom, plus avem câteva scripturi pentru generarea gloanțelor și pentru analiza rezultatelor.
Pentru analiza traficului de rețea se folosește Tcpdump, iar pentru analiza serverului — Nmap. Pentru a crea o încărcare la nivel de L3&4 se folosește OpenSSL și puțină magie proprie cu biblioteca DPDK. DPDK este o bibliotecă de la Intel care permite lucrul cu interfața de rețea, ocolind stiva Linux, astfel sporind eficiența. Bineînțeles, folosim DPDK nu doar la nivel de L3&4, ci și la nivel de L7, deoarece permite crearea unui flux de încărcare foarte ridicat, de ordinul milioanelor de cereri pe secundă de la o singură mașină.
De asemenea, folosim anumite generatoare de trafic și instrumente speciale, pe care le scriem pentru teste specifice. Dacă ne gândim la vulnerabilitatea prin SSH, setul menționat mai sus nu poate fi exploatat. Dacă atacăm protocolul de e-mail, folosim utilitarele poștale sau pur și simplu scriem scripturi pentru ele.
Conclusions
În concluzie, aș dori să spun:
- Pe lângă testarea de încărcare clasică, este esențial să se efectueze și testare de stres. Avem un exemplu real în care subcontractorul unui partener a realizat doar testarea de încărcare. Aceasta a arătat că resursa poate suporta sarcina normală. Dar apoi a apărut o sarcină neobișnuită, iar vizitatorii site-ului au început să utilizeze resursa într-un mod ușor diferit — și, în final, subcontractorul a eșuat. Astfel, merită să căutați vulnerabilități, chiar dacă sunteți deja protejați împotriva atacurilor DDoS.
- Este necesar să izolați anumite părți ale sistemului de altele. Dacă aveți o funcție de căutare, aceasta trebuie să fie mutată pe mașini separate, adică nu în Docker. Pentru că, dacă căutarea sau autorizarea cedează, atunci măcar ceva va continua să funcționeze. În cazul unui magazin online, utilizatorii vor continua să găsească produse în catalog, să acceseze din agregatoare, să cumpere, dacă sunt deja autentificați sau să se autentifice prin OAuth2.
- Nu trebuie să neglijați diversele servicii cloud.
- Utilizați CDN nu doar pentru a optimiza întârzierile de rețea, ci și ca un mijloc de apărare împotriva atacurilor de epuizare a canalului și pur și simplu împotriva inundației în statice.
- Este necesar să folosiți servicii specializate de protecție. Nu vă veți putea proteja de atacuri L3&4 la nivel de canal, deoarece probabil nu aveți un canal suficient de mare. De asemenea, este puțin probabil să vă apărați de atacuri L7, deoarece acestea pot fi foarte mari. În plus, detectarea atacurilor mici este totuși prerogativa serviciilor specializate, a algoritmilor speciali.
- Actualizați-vă regulat. Acest lucru se aplică nu doar nucleului, ci și daemonului SSH, mai ales dacă sunt deschise către exterior. În principiu, trebuie să actualizați totul, deoarece este puțin probabil să puteți urmări vulnerabilitățile singuri.
Sursa: habr.com
