

Întotdeauna m-a interesat cum aș putea să-mi organizez mai bine cărțile în biblioteca electronică. În cele din urmă, am ajuns la o variantă cu numărătoare automată a paginilor și alte funcții utile. Îi rog pe toți cei interesați să citească mai departe.
Partea 1. Dropbox
Toate cărțile mele sunt în Dropbox. Există 4 categorii în care le-am împărțit: Manual, Referință, Ficțiune, Non-ficțiune. Dar nu adaug referințele în tabel.
Majoritatea cărților sunt .epub, restul sunt .pdf. Asta înseamnă că soluția finală ar trebui să acopere ambele variante.
Cărțile se află cam așa:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Dacă cartea este de ficțiune, atunci categoria (adică „Design” în cazul de mai sus) este omisă.
Am decis să nu mă complic cu API-ul Dropbox-ului, având aplicația lor care sincronizează folderul. Asta înseamnă că planul este acesta: luăm cărțile din folder, fiecare carte este analizată printr-un contor de cuvinte, apoi adăugată în Notion.
Partea 2. Adăugăm un rând
Tabelul ar trebui să arate aproximativ în felul acesta. ATENȚIE: numele coloanelor este mai bine să fie în litere latine.
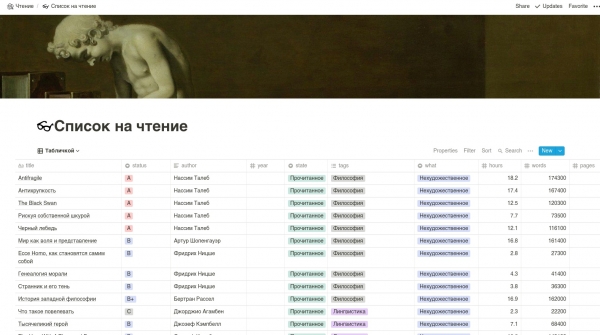
Vom folosi API-ul neoficial al Notion, deoarece cel oficial încă nu a fost livrat.

Intrăm în Notion, apăsăm Ctrl + Shift + J, mergem la Application -> Cookies, copiem token_v2 și îl numim TOKEN. Apoi mergem la pagina noastră dorită cu tabelul bibliotecii și copiem linkul. Îl numim NOTION.
Apoi scriem codul pentru conectarea la Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Apoi, să scriem o funcție pentru a adăuga un rând în tabel.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Ficțiune":
            row.author = tags[2]

        elif tags[0] == "Non-ficțiune":
            row.tags = tags[2]

        elif tags[0] == "Manuale":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Ce se întâmplă aici. Luăm și adăugăm un nou rând în tabel în prima poziție. Apoi împărțim calea noastră după „/” și obținem etichetele. Etichetele sunt în sensul „Ficțiune”, „Design”, cine este autorul etc. Apoi, completăm toate câmpurile necesare în tabel.
Partea 3. Numărăm cuvinte, ore și alte aspecte interesante
Aceasta este o problemă un pic mai complicată. Așa cum ne amintim, avem două formate: epub și pdf. Dacă în cazul epub lucrurile sunt clare — cuvintele sunt acolo, cel mai probabil, atunci în cazul pdf nu mai este atât de simplu: acesta ar putea fi doar un set de imagini lipite.
Așadar, funcția pentru numărarea cuvintelor în pdf va arăta astfel: luăm numărul de pagini și îl înmulțim cu o constantă specifică (numărul mediu de cuvinte pe pagină).
Iată-o:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Aceasta este constantă WORDS_PER_PAGE pentru o pagină A4, care este aproximativ 300.
Acum să scriem o funcție pentru numărarea paginilor. Vom folosi .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Apoi vom scrie un mic program pentru numărarea paginilor în epub. Folosim . Aici luăm cartea, o convertim în linii, iar pentru fiecare linie numărăm cuvintele.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Acum vom calcula timpul. Luăm numărul nostru preferat de cuvinte și îl împărțim la viteza ta de citire.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Partea 4. Îmbinăm toate părțile
Trebuie să parcurgem toate căile posibile din folderul nostru de cărți. Verificăm dacă cartea este deja în Notion: dacă da — nu trebuie să creăm deja o linie.
Apoi, trebuie să determinăm tipul fișierului, iar în funcție de acesta să numărăm numărul de cuvinte. La final, să adăugăm cartea.
Iată ce cod avem:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Și funcția pentru a verifica dacă cartea a fost adăugată arată astfel:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Concluzie
Mulțumesc tuturor celor care au citit acest articol. Sper că vă va ajuta să citiți mai mult 🙂
Sursa: habr.com
