

Salut tuturor! În cadrul lucrării de curs, am cercetat posibilitățile unei platforme cloud autohtone, cum ar fi . Platforma oferă diverse servicii pentru rezolvarea sarcinilor practice. Totuși, uneori este necesar să configurăm propria aplicație cloud pe baza acestor servicii, cu o infrastructură destul de extinsă. În acest articol vreau să împărtășesc experiența desfășurării unei astfel de aplicații.
Ce ne dorim?
— un instrument puternic pentru rezolvarea sarcinilor analitice sau de monitorizare a unor sisteme. În configurația sa de bază, aceasta este o mașină virtuală cu un server web Grafana, precum și o bază de date (ClickHouse, InfluxDB, etc.) cu un set de date pe care se va construi analiza.
După pornirea mașinii virtuale cu serverul web, se va putea accesa gazda acestuia și obține o interfață frumoasă, specificând bazele de date ca surse pentru muncă ulterioară, creând tablouri de bord și grafice.
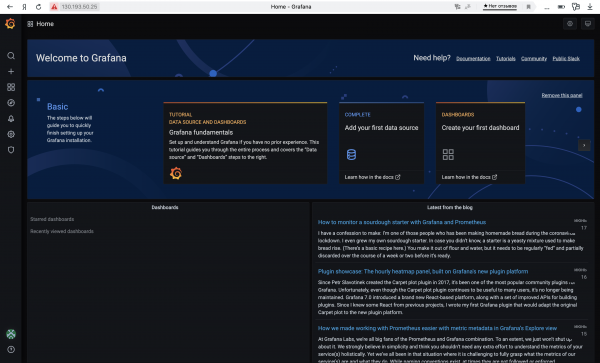
Versiunea de bază are un dezavantaj semnificativ — este complet lipsită de redundanță. Asta înseamnă că funcționalitatea aplicației depinde de viața unei singure mașini virtuale. Dacă aceasta eșuează sau 10 oameni deschid simultan interfața, vor apărea probleme.
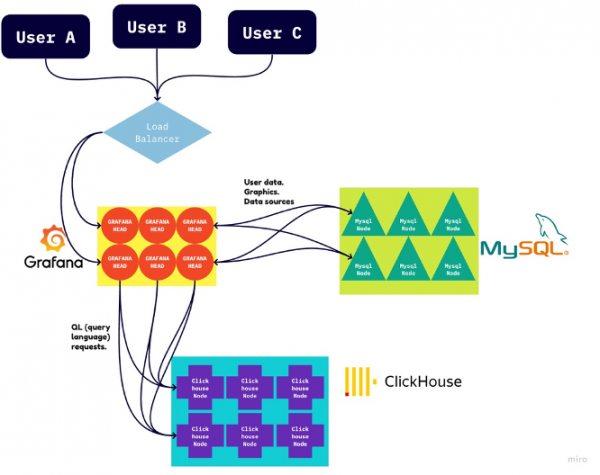
Acestea se rezolvă simplu: trebuie doar… să desfășurăm mai multe mașini virtuale identice cu server web și să le plasăm sub un balansor L3. Dar aici lucrurile nu sunt atât de simple. Grafana stochează setările utilizatorului (căile către bazele de date, tablouri de bord, grafice etc.) direct pe disc la mașina sa virtuală. Astfel, dacă modificăm anumite setări în interfață, aceste modificări se vor reflecta doar pe mașina virtuală căreia ne trimite balansorul. Aceasta va duce la setări inconsistente pentru aplicația noastră, vor apărea probleme la lansare și utilizare.
Aici intervine o altă bază de date, de exemplu, MySQL sau un echivalent al acesteia. Spunem Grafanei că ar trebui să stocheze setările utilizatorului în această bază "de rezervă". După aceea, va fi suficient să specificăm o singură dată pe fiecare mașină calea către această bază de date, iar toate celelalte setări ale utilizatorului pot fi ajustate pe oricare dintre mașinile virtuale, acestea vor fi propagate către celelalte.
Iată schema infrastructurii finale a aplicației:
Vom învăța să ridicăm manual
MySQL și ClickHouse
Înainte de a desfășura o astfel de aplicație printr-un singur click, a fost necesar să învăț să ridic manual fiecare componentă și să le integrez între ele.
Aici ne va ajuta Yandex.Cloud, care oferă balansoare L3, ClickHouse și MySQL ca servicii gestionate. Utilizatorul trebuie doar să specificați parametrii și să aștepte până când platforma le aduce la o stare funcțională.
M-am înregistrat, mi-am creat un cloud și un cont de plată. După aceea, am intrat în cloud și am ridicat clusterele MySQL și ClickHouse cu setări minime. Am așteptat până au devenit active.
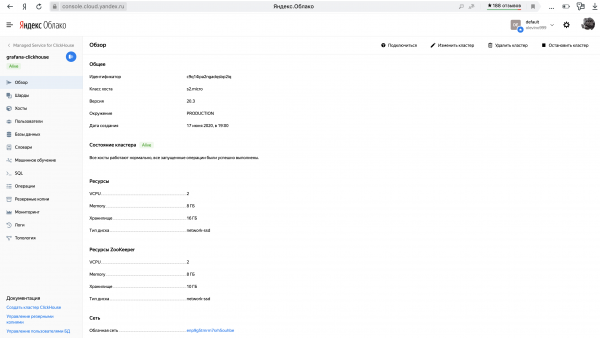
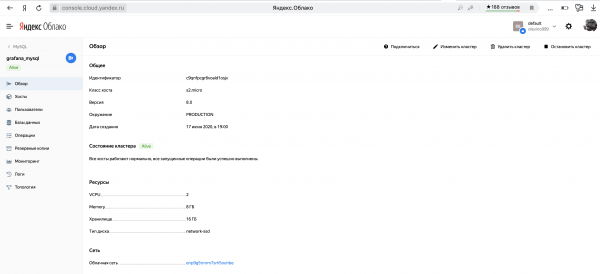
De asemenea, nu trebuie uitat să creez o bază de date în fiecare cluster și să configurez accesul la ea prin nume de utilizator și parolă. Nu voi intra în detalii aici - interfața este suficient de evidentă.
Un detaliu mai puțin evident a fost că aceste baze de date au numeroase gazde care le asigură reziliența. Cu toate acestea, Grafana necesită exact o gazdă pentru fiecare bază de date cu care lucrează. Cloudul m-a condus la soluția potrivită. Se pare că o gazdă de tip c-<cluster_id>.rw.mdb.yandexcloud.net se mapează la gazda principal activă a clusterului cu identificatorul corespunzător. Exact aceasta o vom preda Grafana.
Servidor web
Acum, rămâne de rezolvat cu serverul web. Vom ridica o mașină virtuală obișnuită cu Linux și vom configura manual Grafana pe aceasta.
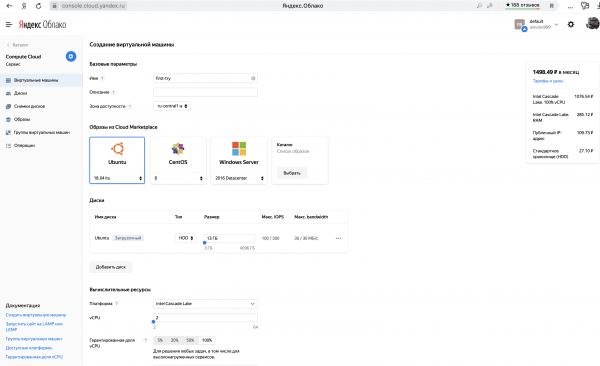
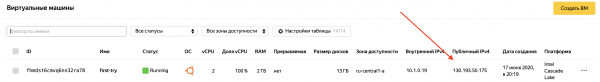
Ne vom conecta prin ssh și vom instala pachetele necesare.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
După aceea, vom porni Grafana sub systemctl și vom instala pluginul pentru a lucra cu ClickHouse (da, în compunerea de bază nu este inclus).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
Totul, după aceasta, cu o simplă comandă
sudo service grafana-server startvom porni serverul web. Acum, putem introduce în browser adresa IP externă a mașinii virtuale, specifica portul 3000 și vom vedea UI-ul frumos al Grafana.
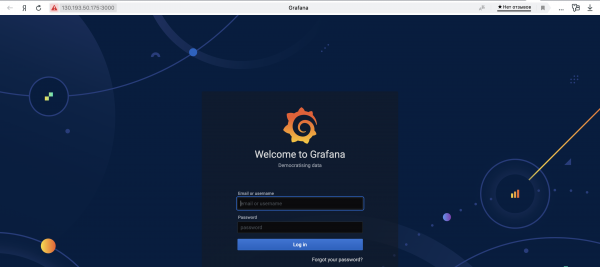
Dar nu trebuie să ne grăbim; înainte de a configura Grafana, nu trebuie uitat să îi specificăm calea către MySQL pentru a salva configurațiile acolo.
Toată configurația serverului web Grafana se află în fișierul /etc/grafana/grafana.ini. Linia necesară arată așa:
;url =Configurăm hostul pentru clusterul MySQL. În același fișier se află loginul și parola pentru a accesa Grafana, așa cum este arătat în imaginea de mai sus, care sunt ambele, în mod implicit, egale. admin.
Puteți folosi comenzile sed:
sudo sed -i "s#.*;url =.*#url = mysql://{MYSQL_USERNAME}:{MYSQL_PASSWORD}@{MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = {GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = {GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
Este momentul să repornim serverul web!
sudo service grafana-server restartAcum, în UI-ul Grafana, vom specifica ClickHouse ca sursă de date.
Am obținut o configurație funcțională cu următoarele setări:
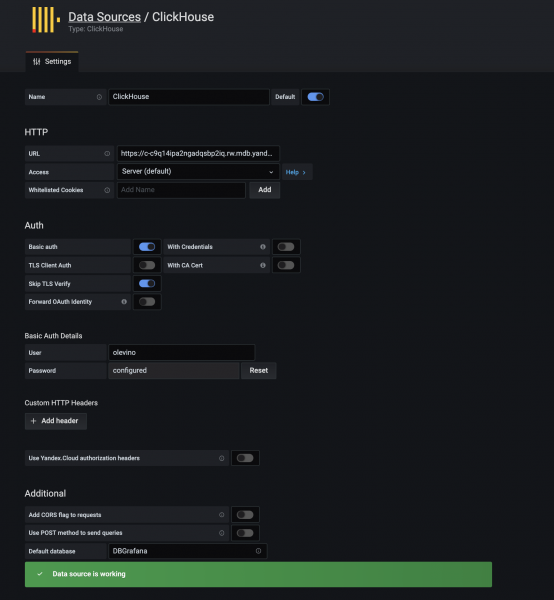
Ca URL, am specificat https://c-.rw.mdb.yandexcloud.net:8443
Totul este! Avem o mașină virtuală funcțională cu serverul web conectat la CH și MySQL. Putem deja să încărcăm datasetul în ClickHouse și să construim dashboard-uri. Cu toate acestea, nu am atins încă scopul nostru și nu am desfășurat o infrastructură completă.
Packer
Yandex.Cloud permite crearea unei imagini a discului pentru o mașină virtuală existentă, pe baza căreia se pot crea nenumărate mașini identice. Acesta este exact ceea ce vom folosi. Pentru a aduna confortabil imaginea, vom folosi instrumentul de la HashiCorp. Acesta primește un fișier JSON cu instrucțiuni pentru construirea imaginii.
Fișierul nostru JSON va consta din două blocuri: builders și provisioners. Primul bloc descrie parametrii imaginii ca entitate, iar al doilea - instrucțiunea privind completarea cu conținutul dorit.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
În acest șablon trebuie să specificați identificatorul secțiunii din cloud, unde doriți să creați imaginea, precum și calea către fișierul cu cheile contului de serviciu, configurat anterior în această secțiune. Puteți citi mai multe despre crearea conturilor de serviciu și a cheilor sub formă de fișier în secțiunea corespunzătoare. .
Această configurație indică faptul că imaginea discului va fi construită pe baza platformei ubuntu-1804-lts, fiind plasată în secțiunea corespunzătoare a utilizatorului în familia imaginilor GRAFANA cu numele grafana-{{timestamp}}.
Provisioners
Acum, partea mai interesantă a configurației. Aceasta va descrie pașii care trebuie urmați pe mașina virtuală înainte de a-i îngheța starea într-o imagine de disc.
{
...,"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Aici, toate acțiunile sunt împărțite în 3 etape. În prima etapă se execută un script simplu care creează un director auxiliar.
prepare-ctg.sh:
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
În etapa următoare, vom plasa în acest director un script care trebuie să fie rulat imediat după pornirea mașinii virtuale. Acest script va adăuga variabilele de utilizator necesare în configurația Grafana și va reporni serverul web.
setup.sh:
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
După aceasta, mai rămân de făcut 3 lucruri:
1) instalarea pachetelor
2) configurarea Grafana prin systemctl și instalarea pluginului ClickHouse
3) adăugarea scriptului setup.sh la coada de execuție imediat după pornirea mașinii virtuale.
install-packages.sh:
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh:
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh:
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
Acum, trebuie să rulăm Packer și să obținem, la final, o imagine plasată în secțiunea specificată. Când creăm mașina virtuală, o putem alege ca disc de boot și, după pornire, vom obține un server web Grafana gata de utilizare.
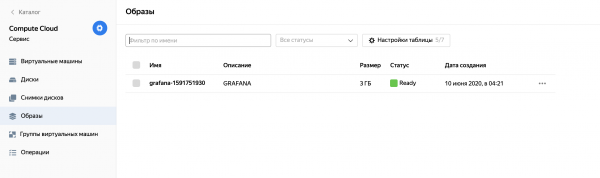
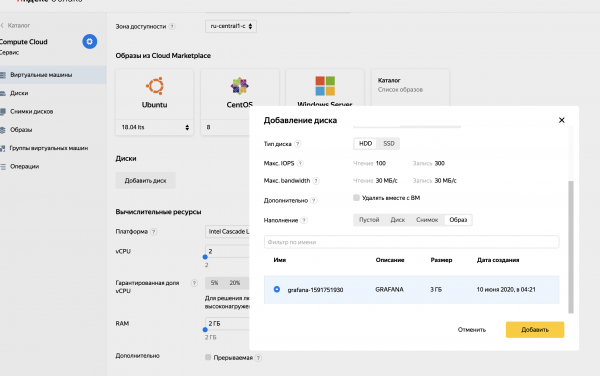
Grup de instanțe și balancer
După ce a apărut imaginea de disc care permite crearea mai multor servere web Grafana identice, putem crea un grup de instanțe. Pe platforma Yandex.Cloud, acest termen se referă la un grup de mașini virtuale cu caracteristici identice. La crearea grupului de instanțe, se configurează prototipul tuturor mașinilor din acest grup, iar apoi caracteristicile grupului în sine (de exemplu, numărul minim și maxim de mașini active). Dacă numărul curent nu corespunde acestor criterii, grupul de instanțe va șterge automat mașinile inutile sau va crea altele noi, după același model.
În cadrul sarcinii noastre, vom crea un grup de instanțe de servere web care vor fi generate din imaginea de disc creată anterior.
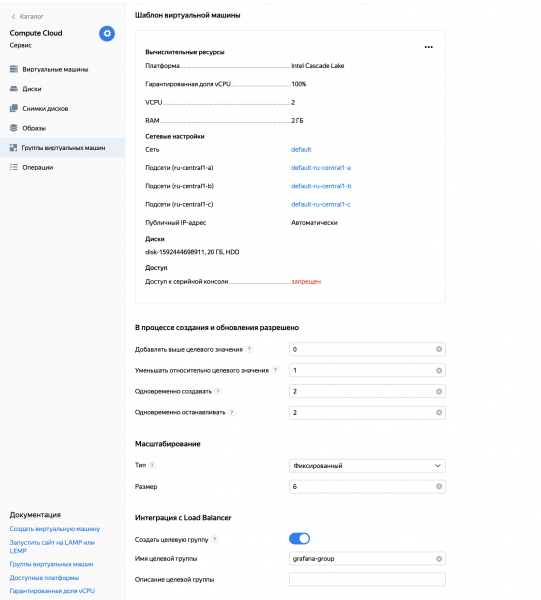
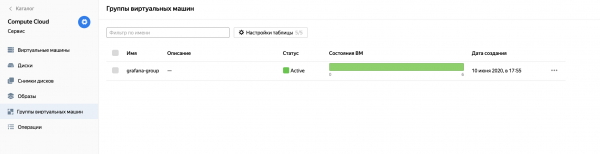
Ultima configurație a grupului de instanțe este deosebit de remarcabilă. Grupul țintă, integrat cu Load Balancer, va permite, cu câteva clicuri, să configurăm un balancer L3 deasupra mașinilor virtuale din acest grup.
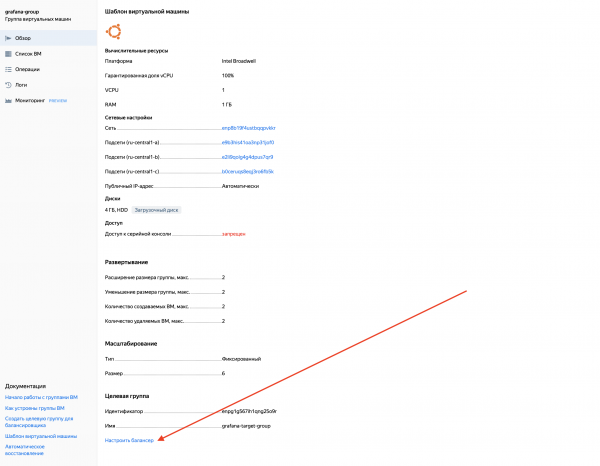
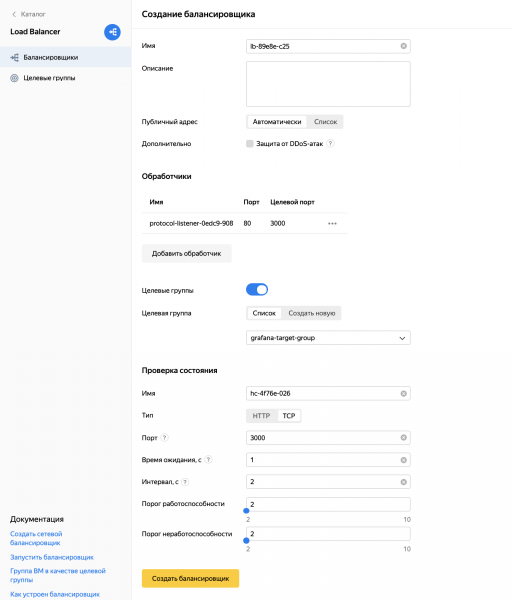
Când am configurat balancerul, am realizat două aspecte importante:
- Am făcut astfel încât balancerul să accepte trafic utilizator pe portul 80 și să-l redirecționeze pe portul 3000 al mașinilor virtuale, acolo unde funcționează Grafana.
- Am configurat verificarea funcționalității mașinilor, pingându-le pe portul 3000.
Mini-rezumat
În sfârșit, am reușit să desfășurăm manual infrastructura dorită a aplicației și acum avem un serviciu Grafana foarte disponibil. Trebuie doar să știm adresa IP a balancerului ca punct de intrare în aplicație și hostul clusterului ClickHouse, pentru a încărca setul de date.
Pare-se că aceasta este o victorie? Da, este o victorie. Dar ceva totuși ne deranjează. Întregul proces de mai sus necesită foarte multe acțiuni manuale și nu este deloc scalabil, astfel încât ne dorim să-l automatizăm cât mai mult posibil. Acest lucru va fi subiectul următoarei secțiuni.
Integrarea cu Terraform
Încă o dată, vom folosi instrumentul de la HashiCorp numit . Acesta va permite, cu o apăsare de buton, să desfășurăm întreaga infrastructură a aplicației, pe baza unor variabile transmise de utilizator. Să scriem o rețetă care poate fi executată de mai multe ori în secțiuni diferite ale diferitelor utilizatori.
Toată munca cu Terraform constă în scrierea unui fișier de configurare (*.tf) și în crearea infrastructurii pe baza acestuia.
Variabile
La începutul fișierului, vom scoate variabilele de care depinde locul și modul în care va fi desfășurată infrastructura viitoare.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
Întregul proces de desfășurare a aplicației se va reduce la construirea unei imagini de disc și la setarea acestor variabile. Voi explica pentru ce sunt responsabile:
oauth_token — tokenul pentru accesul la cloud. Poate fi obținut prin .
cloud_id — identificatorul cloud-ului unde vom desfășura aplicația
folder_id — identificatorul secțiunii în care vom desfășura aplicația
service_account_id — identificatorul contului de serviciu din secțiunea corespunzătoare a norului.
image_id — identificatorul imaginii discului obținut cu ajutorul Packer
username și parola — numele utilizatorului și parola pentru accesul la ambele baze de date și la serverul web Grafana
dbname — numele bazei de date din clusterele CH și MySQL
public_key_path — calea către fișierul cu cheia dumneavoastră publică ssh, pentru a vă putea conecta folosind numele ubuntu la mașinile virtuale cu servere web
Configurarea providerului
Acum trebuie să configurăm providerul Terraform — în cazul nostru Yandex:
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
Se poate observa că aici folosim variabilele definite mai sus.
Rețeaua și clusterele
Acum să creăm o rețea în care vor comunica elementele infrastructurii noastre, trei subrețele (câte una în fiecare regiune) și să ridicăm clusterele CH și MySQL.
resource "yandex_vpc_network" "grafana_network" {}

resource "yandex_vpc_subnet" "subnet_a" {
  zone           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0/24"]
}

resource "yandex_vpc_subnet" "subnet_b" {
  zone           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0/24"]
}

resource "yandex_vpc_subnet" "subnet_c" {
  zone           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0/24"]
}

resource "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  name        = "grafana-clickhouse"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
    }
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

resource "yandex_mdb_mysql_cluster" "mysql_cluster" {
  name        = "grafana_mysql"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id
  version     = "8.0"

  resources {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
      roles         = ["ALL"]
    }
  }

  host {
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
După cum se poate observa, fiecare dintre cele două clustere este creat suficient de rezistent la erori, datorită amplasării în trei zone de disponibilitate.
Servere web
Ar părea că putem continua la fel, dar m-am confruntat cu o dificultate. În trecut, am ridicat mai întâi un cluster MySQL și doar după aceea, știind ID-ul său, construisem imaginea discului cu configurația dorită, unde specificam gazda clusterului. Dar acum nu știm ID-ul clusterului până la lansarea Terraform, inclusiv în momentul construirii imaginii. Prin urmare, a fost necesar să recurgem la următoarea .
Folosind serviciul de metadate de la Amazon, vom transmite mașinii virtuale anumite parametrii pe care aceasta îi va accepta și procesa. Este necesar ca, după pornire, mașina să acceseze metadatele pentru gazda clusterului MySQL și pentru username-parola pe care utilizatorul le-a specificat în fișierul Terraform. Vom modifica ușor conținutul fișierului. setup.sh, care se pornește la activarea mașinii virtuale.
setup.sh:
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Grup de instanțe și echilibror
Recompilând o nouă imagine a discului, putem în sfârșit să completăm fișierul nostru pentru Terraform.
Să indicăm că dorim să folosim o imagine existentă a discului:
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Acum să creăm grupul de instanțe:
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Merită să menționăm cum am transmis în metadată cluster_uri, username și parola. Anume acestea vor fi accesate de maşina virtuală la pornire și plasate în configurația Grafana.
Acum este rândul echilibrorului.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Un pic de zahăr
Mai rămâne foarte puțin. După ce infrastructura se va desfășura, va trebui să accesăm UI Grafana și să adăugăm manual clusterul CH (ID-ul acestuia trebuie încă obținut) ca sursă de date. Dar ID-ul clusterului este cunoscut de Terraform. Îi vom delega lui să finalizeze acest lucru.
Vom adăuga un nou furnizor — Grafana, iar ca gazdă îi vom face un IP de la load balancer. Toate modificările pe care Terraform le va face pe mașina către care îl va direcționa load balancer-ul, se vor reflecta în MySQL, așadar și pe toate celelalte mașini.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Ne vom aranja
Vom extrage IP-ul load balancer-ului și gazda cluster-ului ClickHouse
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
Se poate porni
Totul este gata! Fișierul nostru de configurare este complet și putem, setând variabilele, să spunem lui Terraform să ridice tot ce am descris mai sus. Întregul proces mi-a luat aproximativ 15 minute.
La final, se poate vedea un mesaj frumos:
Aplicare completă! Resurse: 9 adăugate, 0 modificate, 0 distruse.
Ieșiri:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
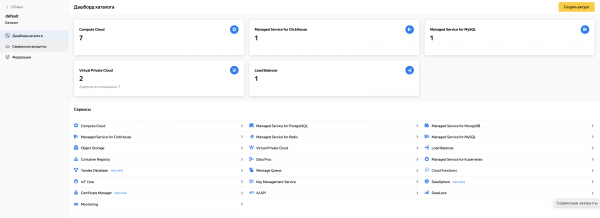
Iar în cloud vor fi vizibile elementele infrastructurii ridicate:
Să rezumăm
Acum, utilizând Grafana ca exemplu, fiecare dintre voi poate desfășura aplicații cu o arhitectură cloud complexă pe platforma Yandex.Cloud. În acest sens, vă pot ajuta instrumente utile de la HashiCorp, cum ar fi Packer și Terraform. Sper că această articol va fi de ajutor pentru cineva 🙂
P.S. Mai jos voi atașa un link către repository-ul în care puteți găsi rețete gata făcute pentru Packer și Terraform, fragmente din care le-am prezentat în acest articol.
Sursa: habr.com
