

Salut tuturor! Avem vești excelente, în iunie OTUS va relua cursul , motiv pentru care împărtășim cu voi materiale utile.
Dacă te-ai confruntat cu toată această poveste despre microservicii fără niciun context, este de înțeles să o consideri puțin ciudată. Împărțirea aplicației în fragmente interconectate printr-o rețea presupune, inevitabil, adăugarea unor moduri complexe de redundanță într-un sistem distribuit rezultat.
Cu toate că această abordare implică împărțirea în numeroase servicii independente, scopul final este mult mai amplu decât simpla funcționare a acestor servicii pe mașini diferite. Este vorba despre interacțiunea cu lumea din jur, care, în esență, este tot distribuită. Nu în sens tehnic, ci mai degrabă în sensul unei ecosisteme formate din numeroase persoane, echipe, programe, și fiecare dintre aceste părți trebuie să își îndeplinească, într-un fel sau altul, rolul.
Companiile, de exemplu, reprezintă un set de sisteme distribuite, care, în totalitate, contribuie la atingerea unui anumit obiectiv. Am ignorat acest fapt timp de zeci de ani, încercând să obținem integrarea, transferând fișiere prin FTP sau folosind instrumente de integrare corporativă, concentrându-ne pe obiectivele noastre personale izolate. Dar odată cu apariția serviciilor, totul s-a schimbat. Serviciile ne-au ajutat să privim dincolo de orizont și să vedem o lume de programe interdependente care lucrează împreună. Cu toate acestea, pentru a avea succes, este necesar să înțelegem și să proiectăm două lumi fundamental diferite: lumea exterioară, unde trăim într-o ecosistemă de multe alte servicii, și lumea noastră interioară, unde domnim singuri.
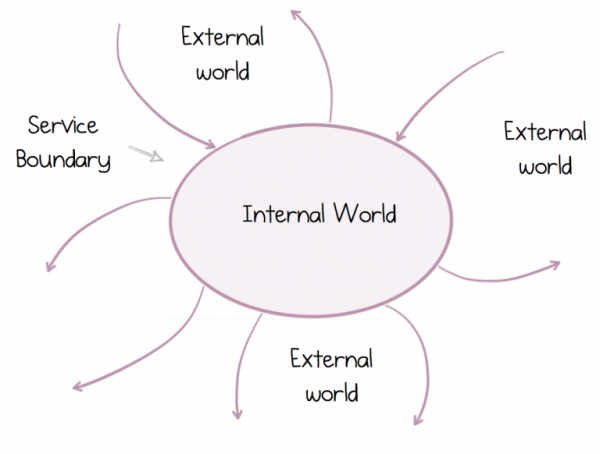
Această lume distribuită este diferită de cea în care am crescut și la care ne-am obișnuit. Principiile construirii arhitecturii tradiționale monolitice nu rezistă criticii. Prin urmare, o înțelegere corectă a acestor sisteme reprezintă mai mult decât realizarea unei scheme elegante pe o tablă albă sau o demonstrație atrăgătoare a conceptului. Este vorba despre asigurarea funcționării de succes a unui astfel de sistem pe termen lung. Din fericire, serviciile există deja de ceva timp, deși apar diferit. sunt încă relevante, chiar și condimentate cu Docker, Kubernetes și ușor uzate de bărbile hipster.
Așadar, astăzi ne vom concentra asupra modului în care s-au schimbat regulile, de ce trebuie să ne regândim abordarea față de servicii și datele pe care acestea le transmit între ele și de ce avem nevoie de unelte complet diferite pentru acest lucru.
Încapsularea nu va fi întotdeauna prietena ta
Microserviciile pot opera independent unele de altele. Această proprietate le conferă cea mai mare valoare. Aceeași proprietate permite serviciilor să se scaleze și să crească. Nu atât în sensul de a scala la cvadrilioane de utilizatori sau petabytes de date (deși pot ajuta și aici), cât în sensul de a scala din perspectiva oamenilor, pe măsură ce echipele și organizațiile cresc continuu.
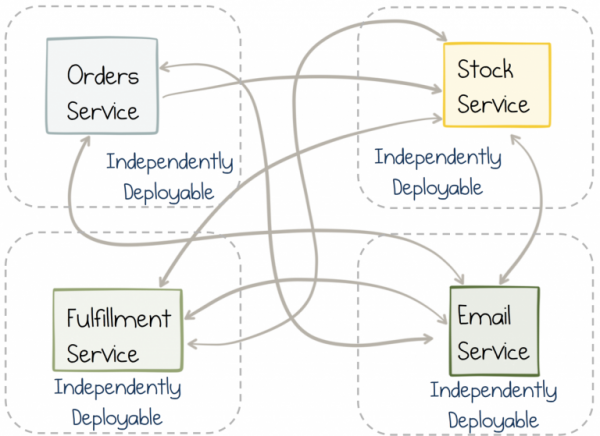
Cu toate acestea, independența este o sabie cu două tăișuri. Adică, serviciul în sine poate funcționa ușor și fără probleme. Dar dacă în cadrul unui serviciu se implementează o funcție care necesită implicarea unui alt serviciu, în final va trebui să facem modificări în ambele servicii aproape simultan. Într-un monolit, acest lucru este simplu, pur și simplu faci modificarea și o lansezi, dar în cazul sincronizării serviciilor independente vor apărea mai multe probleme. Coordonarea între echipe și ciclurile de lansare distruge flexibilitatea.
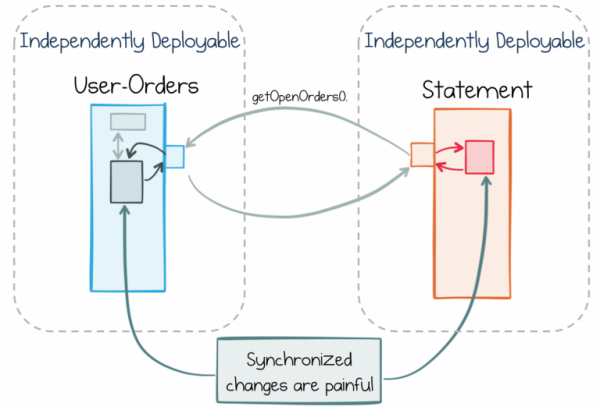
În cadrul abordării standard, schimbările nedorite sunt evitate prin delimitarea clară a funcționalității între servicii. Un serviciu de intrare unică poate fi un bun exemplu aici. Acesta are un rol clar definit, care îl diferențiază de celelalte servicii. Această delimitare clară înseamnă că, într-o lume cu cerințe în continuă schimbare, serviciul de intrare unică va avea puține modificări. Acesta există într-un context strict limitat.
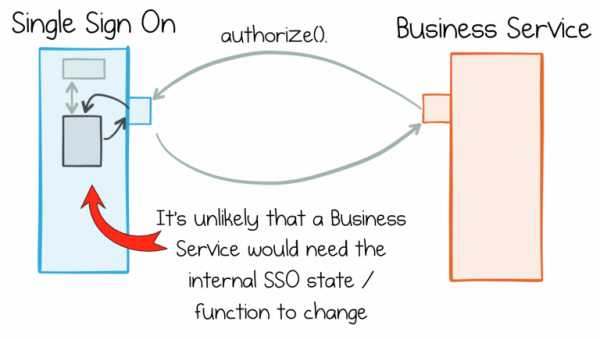
Problema constă în faptul că în lumea reală, serviciile de business nu pot menține constant o separare clară a rolurilor. De exemplu, aceleași servicii de business lucrează adesea cu date provenite de la alte servicii similare. Dacă te ocupi de comerțul online, atunci gestionarea fluxului de comenzi, a catalogului de produse sau a informațiilor despre utilizatori va deveni o cerință pentru multe dintre serviciile tale. Fiecare dintre servicii va necesita acces la aceste date pentru a funcționa.
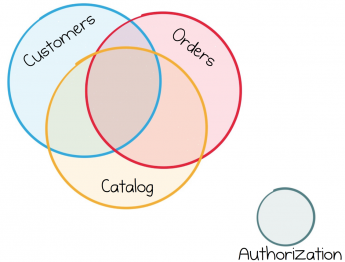
Majoritatea serviciilor de business folosesc același flux de date, astfel încât activitatea lor se împletesc inevitabil.
Astfel, am ajuns la un moment important despre care merită să discutăm. În timp ce serviciile funcționează bine pentru componentele infrastructurii care operează într-un mod relativ separat, majoritatea serviciilor de business se dovedesc a fi interconectate mult mai strâns.
Dihotomia datelor
Abordările orientate spre servicii există poate deja, însă au încă foarte puține informații despre cum să schimbe volume mari de date între servicii.
Problema principală constă în faptul că datele și serviciile sunt inseparabile. Pe de o parte, encapsularea ne îndeamnă să ascundem datele, astfel încât serviciile să poată fi separate unele de altele, facilitând creșterea și modificările ulterioare. Pe de altă parte, trebuie să avem posibilitatea de a împărtăși și controla liber datele comune, la fel ca pe orice alte date. Este vorba despre a putea începe imediat să lucrăm, la fel de liber ca în orice alt sistem informațional.
Cu toate acestea, sistemele informaționale au puțin în comun cu encapsularea. De fapt, chiar opusul. Bazele de date fac tot ce le stă în putere pentru a oferi acces la datele stocate în ele. Ele vin cu o interfață declarativă puternică, care permite modificarea datelor așa cum dorești. Această funcționalitate este importantă în etapa cercetărilor preliminare, dar nu pentru gestionarea complexității în continuă creștere a unui serviciu în dezvoltare.
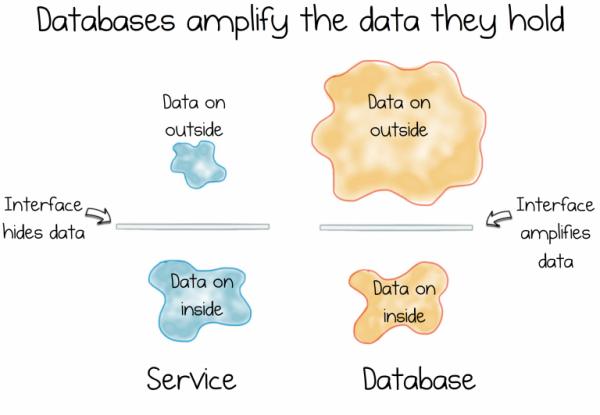
Și aici apare dilema. Contradicția. Dihotomia. Sistemele informaționale sunt despre furnizarea de date, iar serviciile sunt despre a ascunde.
Aceste două forțe sunt fundamentale. Ele stau la baza celei mai mari părți din munca noastră, luptând constant pentru supremație în sistemele pe care le construim.
Pe măsură ce sistemele de servicii cresc și evoluează, observăm diferite manifestări ale consecințelor dihotomiei datelor. Fie interfața serviciului va crește, oferind un set din ce în ce mai larg de funcții și va începe să semene cu o bază de date foarte ciudată și de casă, fie vom suferi de dezamăgire și vom implementa o modalitate de a extrage sau de a muta în masă întregi seturi de date dintr-un serviciu în altul.
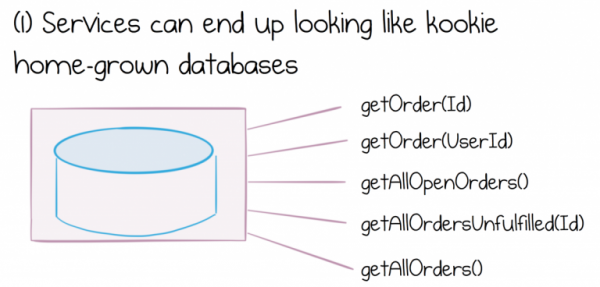
În schimb, crearea a ceva care arată ca o bază de date foarte ciudată și de casă va duce la o serie întreagă de probleme. Nu ne vom aprofunda în detaliile despre ce este periculos, shared database, dar să spunem doar că reprezintă dificultăți ingineresti și operaționale semnificative și costisitoare Mai rău, volumul de date amplifică problemele cu limitele serviciilor. Cu cât există mai multe date comune în cadrul serviciului, cu atât interfața devine mai complicată și mai greu de combinat seturile de date care provin din diverse servicii.
O abordare alternativă pentru extragerea și mutarea întregilor seturi de date are, de asemenea, problemele sale. Un mod comun de a aborda această problemă arată ca o simplă extragere și stocare a unui set de date în întregime, apoi stocarea acestuia local în fiecare serviciu consumator.
Problema este că diferitele servicii interpretează datele pe care le consumă în mod diferit. Aceste date sunt întotdeauna la îndemână. Ele sunt modificate și procesate local. Destul de repede, ele încetează să mai aibă ceva în comun cu datele din sursă.
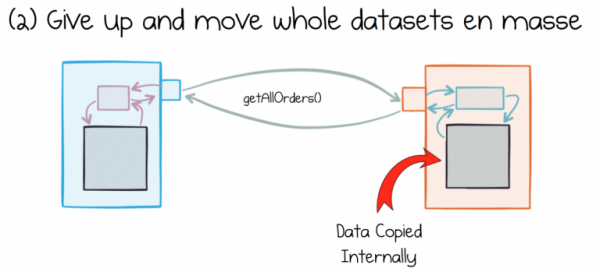
Cu cât copiile sunt mai mutabile, cu atât datele vor diferi mai mult în timp.
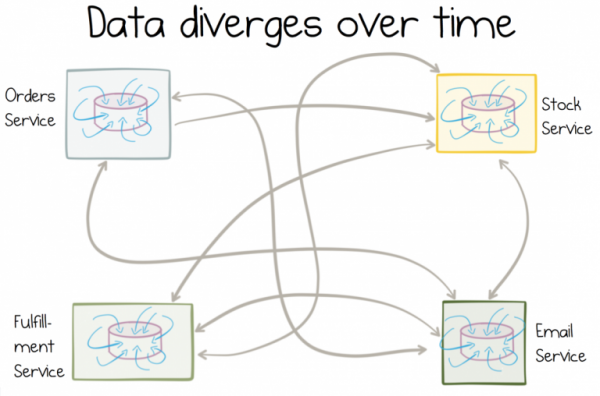
Ce e și mai rău, astfel de date sunt greu de corectat în retrospectivă (
MDM Pentru a găsi o soluție la această problemă cu datele comune, trebuie să gândim diferit. Ele trebuie să devină obiecte de primă clasă în arhitecturile pe care le construim.
Pat Helland denumește aceste date „externe”, iar aceasta este o caracteristică foarte importantă. Avem nevoie de încapsulare pentru a nu dezvălui structura internă a serviciului, dar trebuie să facilităm accesul serviciilor la datele partajate, astfel încât acestea să-și poată îndeplini corect sarcinile.
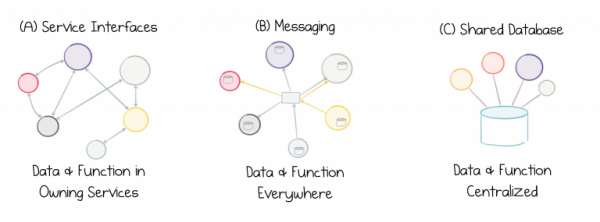
Problema constă în faptul că niciuna dintre metodele disponibile nu mai este relevantă astăzi, deoarece nici interfețele de serviciu, nici schimbul de mesaje, nici baza de date partajată nu oferă o soluție bună pentru a lucra cu date externe. Interfețele de serviciu sunt puțin potrivite pentru schimbul de date la orice scară. Schimbul de mesaje mută datele, dar nu le păstrează istoricul, astfel că, în timp, datele se corup. Bazele de date partajate se concentrează prea mult într-un singur punct, ceea ce restricționează progresul. Inevitabil, rămânem blocați într-un ciclu de eșec al datelor:
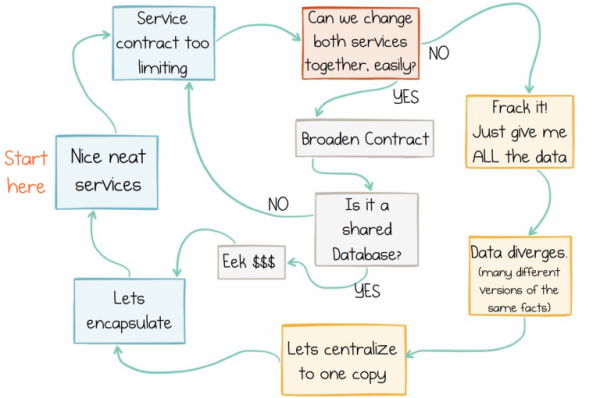
Ciclul de eșec al datelor
Fluxuri: o abordare descentralizată a datelor și serviciilor
În ideal, trebuie să schimbăm abordarea privind modul în care serviciile lucrează cu datele comune. În prezent, orice metodă se confruntă cu dicotomia menționată, deoarece nu există o soluție miraculoasă cu care să o acoperim pentru a o face să dispară. Cu toate acestea, putem reinterpreta problema și ajunge la un compromis.
Acest compromis presupune un anumit grad de centralizare. Putem folosi mecanismele jurnalelor distribuite, deoarece acestea oferă fluxuri fiabile și scalabile. Acum trebuie ca serviciile să se poată alătura și să utilizeze aceste fluxuri comune, dar dorim să evităm serviciile centralizate complexe care fac această prelucrare. Prin urmare, cea mai bună opțiune este să integrăm procesarea fluxurilor în fiecare serviciu-consumator. Astfel, serviciile vor putea combina seturi de date din surse diferite și vor lucra cu ele așa cum au nevoie.
Una dintre modalitățile de a atinge o astfel de abordare este utilizarea unei platforme de streaming. Există multe opțiuni disponibile, dar astăzi ne vom concentra pe Kafka, deoarece utilizarea sa pentru procesarea fluxurilor de stări ne permite să abordăm eficient problema prezentată.
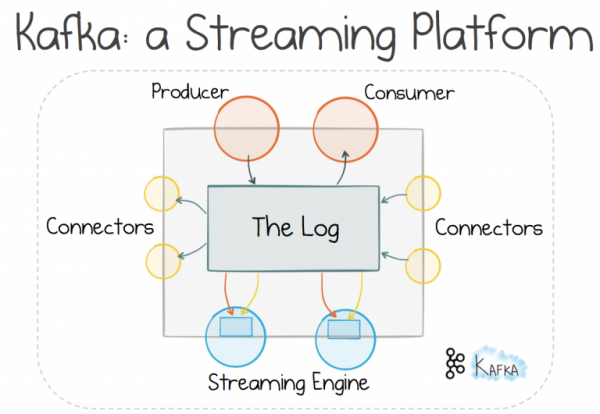
Utilizarea mecanismului de jurnalizare distribuită ne permite să urmăm un drum bătătorit și să folosim schimbul de mesaje pentru a lucra cu . Se consideră că această abordare oferă o scalabilitate și o separare mai bună decât mecanismul „cerere-răspuns”, deoarece predă controlul fluxului către destinatari, nu expeditori. Totuși, trebuie să plătiți pentru tot în viața aceasta, iar aici veți avea nevoie de un broker. Dar pentru sistemele mari, acest compromis merită (ceea ce nu se poate spune despre aplicațiile web medii).
Dacă brokerul se ocupă de jurnalizarea distribuită, nu sistemul tradițional de mesagerie, se pot folosi funcționalități adiționale. Transportul poate fi scalat liniar aproape la fel de bine ca un sistem de fișiere distribuit. Datele pot fi stocate în jurnale pentru o perioadă destul de lungă, astfel încât obținem nu doar mesagerie, ci și stocare de informații. Stocare scalabilă fără teama de a obține o stare generală modificabilă.
Apoi, se poate folosi mecanismul de procesare a fluxului cu stare (stateful stream processing) pentru a adăuga instrumente declarative de bază de date în serviciile consumatori. Aceasta este o idee foarte importantă. Atâta timp cât datele sunt stocate în fluxuri comune, la care pot avea acces toate serviciile, combinarea și prelucrarea efectuate de serviciu sunt private. Ele se află izolate într-un context strict limitat.
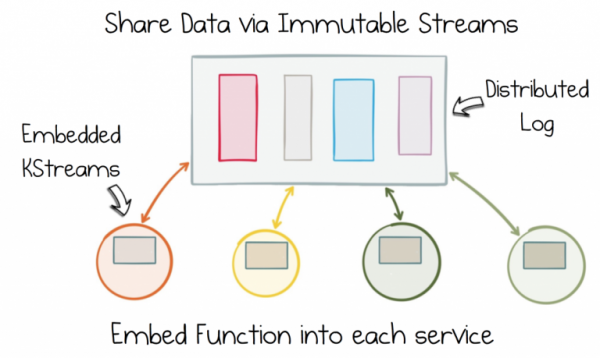
Scăpați de dicotomia datelor, împărțind fluxul de stări imutabile. Apoi, adăugați această funcție în fiecare serviciu folosind Procesarea Fluxului cu Stare.
Astfel, dacă serviciul vostru trebuie să lucreze cu comenzi, catalogul de produse, depozit, va avea acces complet: doar voi veți decide ce date să combinați, unde să le procesați și cum ar trebui să se schimbe în timp. Deși datele sunt comune, lucrul cu ele este complet descentralizat. Se desfășoară în interiorul fiecărui serviciu, într-o lume unde totul se desfășoară după regulile voastre.
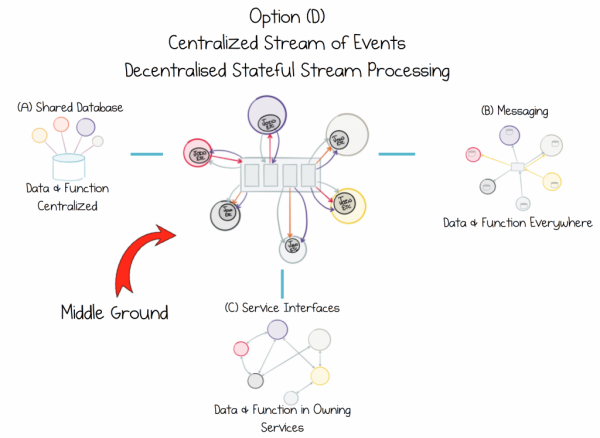
Împărtășiți datele astfel încât să nu fie afectată integritatea acestora. Încapsulați funcția, nu sursa, în fiecare serviciu de care este nevoie.
Se întâmplă ca datele să fie necesar să fie mutate în masă. Uneori, serviciul are nevoie de un set istoric local de date în motorul de baze de date ales. Cheia este că se poate garanta că, atunci când este necesar, copia poate fi restaurată din sursă prin intermediul mecanismului de jurnalizare distribuită. Conectorii din Kafka își fac excelent treaba în această privință.
Așadar, abordarea discutată astăzi are câteva avantaje:
- Datele sunt utilizate sub formă de fluxuri comune, care pot fi stocate mult timp în jurnale, iar mecanismul de lucru cu datele comune este încorporat în fiecare context în parte, ceea ce permite serviciilor să funcționeze ușor și rapid. Astfel, se poate echilibra dihotomia datelor.
- Datele provenite din diverse servicii pot fi ușor combinate în seturi. Astfel, interacțiunea cu datele comune este simplificată și dispare necesitatea de a menține seturi locale de date în baza de date.
- Stateful Stream Processing stochează doar datele, iar sursa adevărului rămâne jurnalizarea comună, astfel că problema deteriorării datelor în timp nu mai este atât de acută.
- Prin natura sa, serviciile sunt gestionate de date, adică, în ciuda creșterii constante a volumului de date, serviciile pot răspunde rapid la evenimentele de afaceri.
- Problemele de scalabilitate sunt responsabilitatea brokerului, nu a serviciilor. Astfel, complexitatea scrierii serviciilor este semnificativ redusă, deoarece nu mai este necesar să te gândești la scalabilitate.
- Adăugarea de noi servicii nu necesită modificarea celor existente, deci conectarea noilor servicii devine mai ușoară.
După cum puteți vedea, este mai mult decât simplu REST. Am obținut un set de instrumente care permite lucrul cu date comune într-o manieră descentralizată.
În articolul de astăzi nu au fost dezvăluite toate aspectele. Trebuie încă să ne hotărâm cum să echilibrăm între paradigma „cerere-răspuns” și paradigma bazată pe evenimente. Dar cu asta ne vom ocupa data viitoare. Există teme cu care trebuie să ne familiarizăm mai bine, de exemplu, cât de bun este Stateful Stream Processing. Despre acest subiect vom discuta în al treilea articol. De asemenea, există alte construcții puternice pe care le putem utiliza, dacă apelăm la ele, cum ar fi, . Acesta schimbă regulile jocului pentru sistemele de afaceri distribuite, deoarece această construcție oferă garanții tranzacționale pentru într-o formă scalabilă. Despre aceasta se va discuta în al patrulea articol. În cele din urmă, va trebui să aruncăm o privire asupra detaliilor implementării acestor principii.
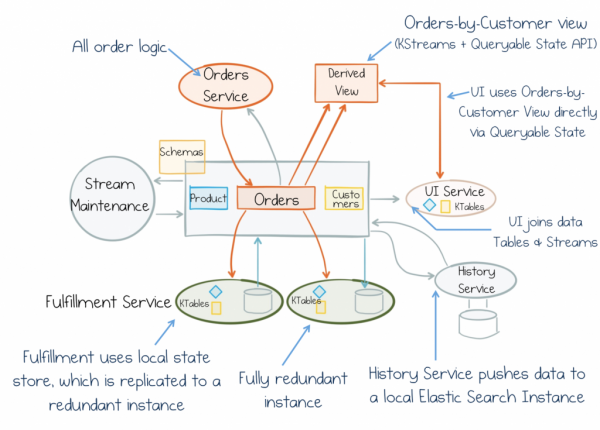
Dar, deocamdată, rețineți următorul lucru: dihotomia datelor este forța cu care ne confruntăm atunci când creăm servicii de afaceri. Și trebuie să ne amintim de asta. Accentul se pune pe a răsturna totul cu susul în jos și a începe să considerăm datele comune ca fiind obiecte de primă clasă. Procesarea fluxurilor stateful oferă un compromis unic pentru aceasta. Evită componentele centralizate 'God' care împiedică dezvoltarea progreselor. Mai mult, oferă rapiditate, scalabilitate și reziliență pentru pipeline-urile de streaming de date și le integrează în fiecare serviciu. Astfel, ne putem concentra pe fluxul comun de conștiință la care orice serviciu poate să se conecteze și să lucreze cu datele sale. Astfel, serviciile devin mai scalabile, interoperabile și autonome. Prin urmare, nu doar că arată bine pe tablourile de marcă și în testarea ipotezelor, dar vor funcționa și se vor dezvolta timp de decenii.
Sursa: habr.com
