

Continuând tema înregistrării fluxurilor mari de date, ridicată , în acesta vom analiza modalitățile prin care putem reduce „dimensiunea fizică” a datelor stocate în PostgreSQL și influența lor asupra performanței serverului.
Vor fi discutate setările TOAST și alinierea datelor. „În medie”, aceste modalități vor permite economisirea nu prea multor resurse, dar — fără nicio modificare a codului aplicației.
Cu toate acestea, experiența noastră s-a dovedit a fi destul de productivă în acest sens, deoarece stocarea aproape oricărei monitorizări este, prin natura sa, în cea mai mare parte, append-only din punctul de vedere al datelor scrise. Și dacă vă interesează cum se poate învăța baza să scrie pe disc într-o viteză de 200MB/s mult mai mică — vă rog să citiți în continuare.
Secrete mici despre Big Data
Conform profilului de activitate , acesta primește în mod regulat din loguri pachete de text.
Și deoarece , ale cărui baze de date le monitorizăm, este un produs multicomponent cu structuri complexe de date, cererile pentru a atinge performanța maximă au devenit astfel Astfel, volumul fiecărui exemplu de cerere sau al planului de execuție rezultat din logul care ne sosește este „în medie” destul de mare.
Să ne uităm la structura uneia dintre tabele, în care scriem datele „neprelucrate” — adică textul original din înregistrarea logului:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- cheia secțiunii
    date
, data -- cel mai important
    text
, PRIMARY KEY(pack, recno)
);
Este o tabelă tipică (deja secționată, desigur, prin urmare acesta este un șablon de secțiune), unde cel mai important este — textul. Uneori este destul de voluminos.
Să ne amintim că dimensiunea „fizică” a unei înregistrări în PG nu poate ocupa mai mult de o pagină de date, dar dimensiunea „logică” este o altă poveste. Pentru a scrie o valoare voluminoasă într-un câmp (varchar/text/bytea) se utilizează :
PostgreSQL utilizează o dimensiune fixă a paginii (de obicei 8 KB) și nu permite ca tuplele să ocupe mai multe pagini. Prin urmare, nu este posibilă stocarea directă a valorilor foarte mari ale câmpurilor. Pentru a depăși această limitare, valorile mari ale câmpurilor sunt comprimate și/sau divizate în mai multe rânduri fizice. Acest lucru se întâmplă fără ca utilizatorul să observe, iar majoritatea codului serverului este afectată nesemnificativ. Această metodă este cunoscută sub numele de TOAST …
De fapt, pentru fiecare tabel cu câmpuri „potențial mari”, se creează automat fiecare înregistrare „mare” segmentată în bucăți de 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Asta înseamnă că, atunci când trebuie să scriem un rând cu o valoare „mare”, dataînregistrarea reală va avea loc nu doar în tabela principală și cheia ei primară, ci și în TOAST și cheia sa primară.
Reducerea impactului TOAST
Dar majoritatea înregistrărilor noastre nu sunt atât de mari, ar trebui să se încadreze în 8KB — cum putem economisi pe acest lucru?..
Aici ne ajută atributul de la coloana tabelului:
- EXTENDED permite atât comprimarea, cât și stocarea separată. Aceasta este varianta standard pentru majoritatea tipurilor de date compatibile cu TOAST. Mai întâi se încearcă comprimarea, apoi — stocarea în afara tabelului, dacă rândul este în continuare prea mare.
- MAIN permite comprimarea, dar nu stocarea separată. (De fapt, stocarea separată va fi efectuată pentru aceste coloane, dar doar ca ultimă soluție, când nu există altă metodă de a reduce rândul, astfel încât să încapă în pagină.)
De fapt, tocmai asta avem nevoie pentru text — să comprimăm la maximum și, dacă tot nu încap, să mutăm în TOAST.Acest lucru se poate face direct „în zbor”, cu o singură comandă:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Cum să evaluăm efectul
Deoarece fluxul de date se schimbă în fiecare zi, nu putem compara cifrele absolute, dar în termeni relativi, cu cât o proporție mai mică am scris în TOAST — cu atât mai bine. Dar aici există un risc — cu cât volumul „fizic” al fiecărei înregistrări individuale este mai mare, cu atât „mai larg” devine indexul, deoarece este nevoie să acopere un număr mai mare de pagini de date.
Secțiunea înainte de modificări:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Secțiunea după modificări:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
De fapt, am început să scriem în TOAST de 2 ori mai rar, care a degrevat nu doar discul, ci și CPU-ul:
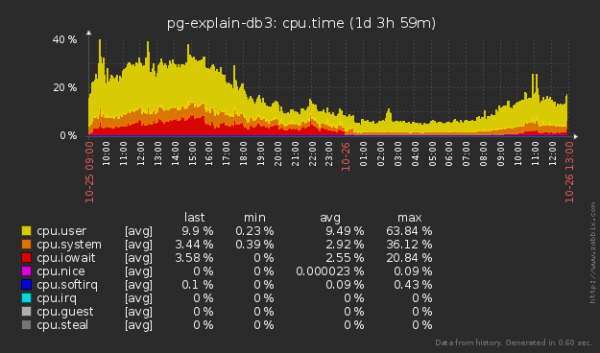
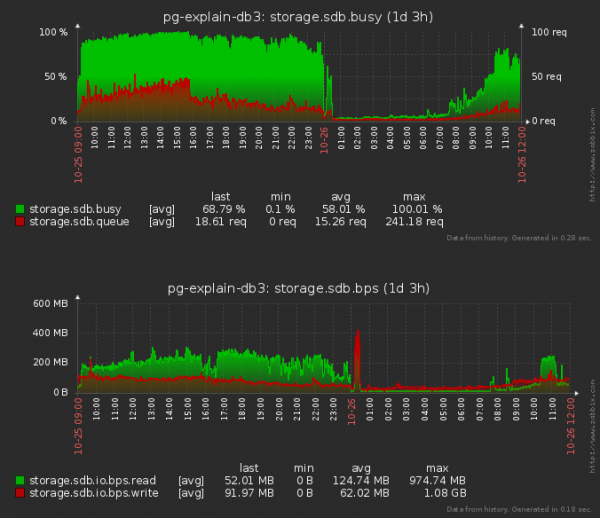
Observ că am început să „cităm” mai puțin discul, nu doar să „scriem” — deoarece, atunci când inserăm o înregistrare într-un tabel, trebuie să „citim” și o parte din arborele fiecărui index pentru a-i determina viitoarea poziție în acestea.
Cui îi place să trăiască pe PostgreSQL 11
După actualizarea la PG11, am decis să continuăm „tuningul” TOAST și am observat că, începând cu această versiune, a devenit disponibil pentru configurare parametrul :
Codul de procesare TOAST se activează doar atunci când dimensiunea valorii șirului care trebuie stocată în tabel depășește TOAST_TUPLE_THRESHOLD bytes (de obicei, 2 KB). Codul TOAST va comprima și/sau va muta valorile câmpului în afara tabelului până când dimensiunea șirului devine mai mică decât TOAST_TUPLE_TARGET bytes (o valoare variabilă, de obicei, tot 2 KB) sau până când nu mai este posibil să se reducă dimensiunea.
Am decis că datele noastre sunt de obicei fie „foarte scurte”, fie „foarte lungi”, așa că am decis să ne limităm la cea mai mică valoare posibilă:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Haideți să vedem cum noile setări au influențat încărcarea discului după reconfigurare:
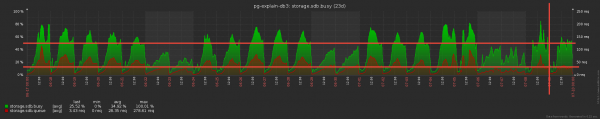
Nu rău! Media întârziere la disc s-a redus cu aproximativ 1.5 ori, iar „ocuparea” discului — cu 20%! Dar poate că aceasta a influențat și CPU-ul?
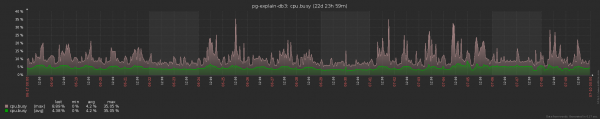
Cel puțin, clar nu a fost mai rău. Totuși, e greu de spus, dacă chiar și aceste volume nu pot ridica încărcarea medie a CPU-ului mai sus 5%.
De la schimbarea locurilor se schimbă suma…
După cum se știe, un ban economisește un leu, iar cu volumele noastre de stocare de aproximativ 10TB/lună chiar și o mică optimizare poate aduce un profit considerabil. De aceea, ne-am concentrat asupra structurii fizice a datelor noastre — cum sunt concret „aranjate” câmpurile în fiecare înregistrare a fiecărui tabel.
Pentru că din cauza acesta afectează direct :
Multe arhitecturi prevăd alinierea datelor pe granițele cuvintelor mașină. De exemplu, pe un sistem x86 pe 32 de biți, numerele întregi (tip integer, care ocupă 4 byte) vor fi aliniate pe limita cuvintelor de 4 byte, la fel ca și numerele în virgulă mobilă cu dublă precizie (tip double precision, 8 byte). Iar pe un sistem pe 64 de biți, valorile double vor fi aliniate pe limita cuvintelor de 8 byte. Aceasta este o altă cauză a incompatibilității.
Din cauza aliniamentului, dimensiunea rândului tabelului depinde de ordinea aranjării câmpurilor. De obicei, acest efect nu este foarte vizibil, dar în unele cazuri poate duce la o creștere semnificativă a dimensiunii. De exemplu, dacă amestecăm câmpuri de tip char(1) și integer, între ele vor dispărea, de regulă, 3 bytes inutil.
Să începem cu modelele sintetice:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bytes

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bytes
De unde au apărut câteva bytes în plus în primul caz? E simplu — smallint-ul de 2 bytes se aliniează pe granița de 4 bytes în fața următorului câmp, iar când este ultimul — nu mai este nimic de aliniat și de ce.
În teorie — totul este bine și putem muta câmpurile cum dorim. Să verificăm cu date reale, folosind un exemplu dintr-unul dintre tabele, a cărui secțiune zilnică ocupă 10-15GB.
Structura inițială:
CREATE TABLE public.plan_20190220
(
-- Moștenită din tabelul plan:  pack uuid NOT NULL,
-- Moștenită din tabelul plan:  recno smallint NOT NULL,
-- Moștenită din tabelul plan:  host uuid,
-- Moștenită din tabelul plan:  ts timestamp with time zone,
-- Moștenită din tabelul plan:  exectime numeric(32,3),
-- Moștenită din tabelul plan:  duration numeric(32,3),
-- Moștenită din tabelul plan:  bufint bigint,
-- Moștenită din tabelul plan:  bufmem bigint,
-- Moștenită din tabelul plan:  bufdsk bigint,
-- Moștenită din tabelul plan:  apn uuid,
-- Moștenită din tabelul plan:  ptr uuid,
-- Moștenită din tabelul plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Secțiunea după schimbarea ordinii coloanelor — exact aceleași câmpuri, doar ordinea este diferită:
CREATE TABLE public.plan_20190221
(
-- Moștenită din tabelul plan:  dt date NOT NULL,
-- Moștenită din tabelul plan:  ts timestamp with time zone,
-- Moștenită din tabelul plan:  pack uuid NOT NULL,
-- Moștenită din tabelul plan:  recno smallint NOT NULL,
-- Moștenită din tabelul plan:  host uuid,
-- Moștenită din tabelul plan:  apn uuid,
-- Moștenită din tabelul plan:  ptr uuid,
-- Moștenită din tabelul plan:  bufint bigint,
-- Moștenită din tabelul plan:  bufmem bigint,
-- Moștenită din tabelul plan:  bufdsk bigint,
-- Moștenită din tabelul plan:  exectime numeric(32,3),
-- Moștenită din tabelul plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Volumul total al secțiunii este determinat de numărul de „fapte” și depinde doar de procesele externe, prin urmare să împărțim dimensiunea heap (pg_relation_size) pe numărul de înregistrări din aceasta — adică vom obține dimensiunea medie a înregistrării reținute:
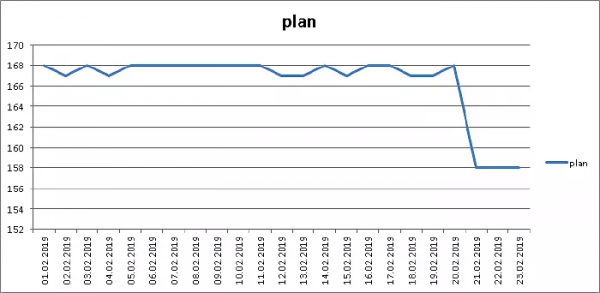
Minus 6% din volum, excelent!
Dar, desigur, nu totul este atât de roz — deoarece în indici nu putem schimba ordinea câmpurilor, și prin urmare «în general» (pg_total_relation_size)…
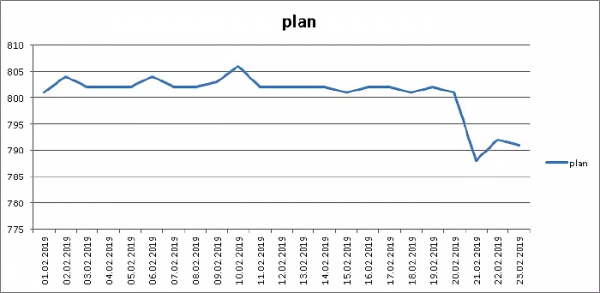
… cu siguranță și aici am economisit 1.5%, fără a schimba nicio linie de cod. Așa este!
O să observ că varianta de aranjare a câmpurilor de mai sus nu este neapărat cea mai optimă. Pentru că unele blocuri de câmpuri nu vrem să le «rupt» din motive estetice — de exemplu, o pereche (pack, recno), care este PK pentru acest tabel.
În general, definirea unei aranjări «minimale» a câmpurilor este o sarcină relativ simplă de «încercare». De aceea, puteți obține rezultate chiar mai bune decât noi cu datele dumneavoastră — încercați!
Sursa: habr.com
