

Când vorbim despre steganografie, oamenii își imaginează teroriști, pedofili, spioni, sau cel mult criptoanarhiști și alți cercetători. Și într-adevăr, cine altcineva ar avea nevoie să ascundă ceva de privirile externe? Ce beneficii ar putea avea o persoană obișnuită din asta?
Se pare că există. De aceea astăzi vom comprima datele folosind metode de steganografie. Iar la final, cititorul va putea chiar să-și folosească prețioasele arhive foto în JPEG-uri pentru a crește numărul de gigaocteți liberi pe sistemul de fișiere.
Ce?
Dacă cititorul își amintește, steganografia este un set de algoritmi ciudați care permit ascunderea unei informații în interiorul alteia. Cu alte cuvinte: imagine + fișier == aproximativ aceeași imagine, dar nu chiar (în loc de imagini poate fi orice, dar de obicei pe imagini este mai clar). În plus, nu ar trebui să existe un mod simplu de a determina dacă există ceva în interior sau nu.
Dar dacă nu putem deosebi unul de altul, are vreo importanță? Din perspectiva consumatorului, utilizatorului nu-l interesează precizia matematică (reflectată de un anumit set de biți), ci doar ceea ce percepe.
De exemplu, să ne uităm la trei imagini cu un câine drăguț:
Feriți-vă de JPEG!
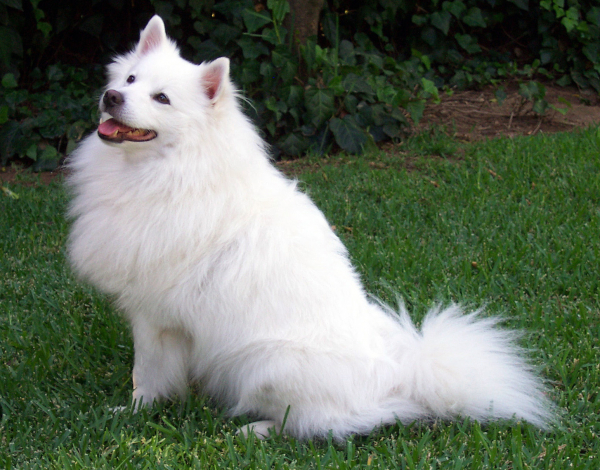
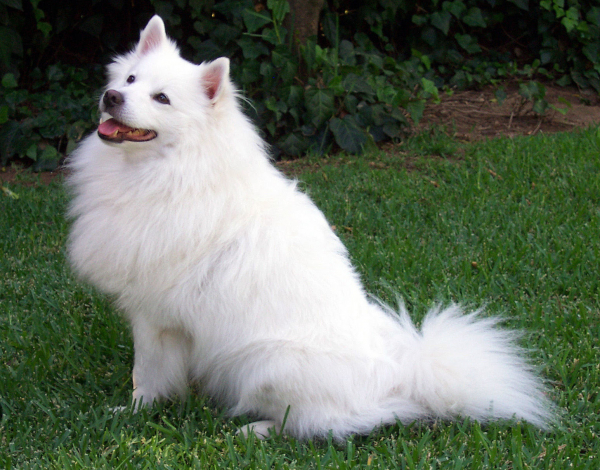
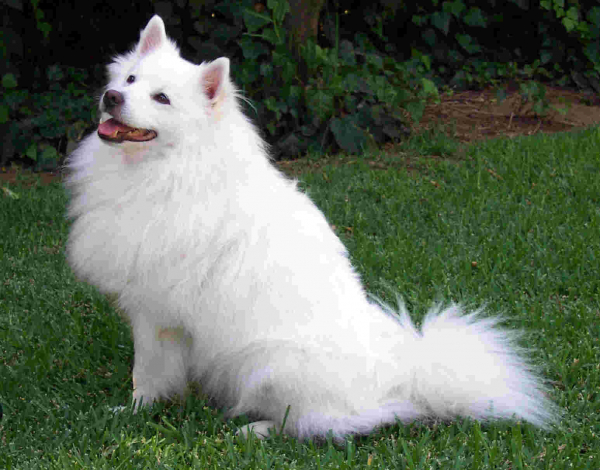
În ciuda diferenței colosale de dimensiune, puțini ar alege cea de-a treia versiune. Pe de altă parte, între primele două fotografii diferența nu este atât de evidentă, iar cantitatea de informații din ele (din punctul meu de vedere) poate fi considerată echivalentă.
Acest principiu în sine este deja vechi și este exploatat de mulți ani prin metode de comprimare a informației cu pierderi. Dar a rupe nu este ca a construi, ne interesează partea mai avansată a problemei. Este posibil să încorporăm informații suplimentare de dimensiune N într-un fișier astfel încât dimensiunea acestuia să crească cu M < N, iar modificările să nu fie vizibile utilizatorului?
Desigur, se poate. Dar merită menționate câteva precizări:
- În primul rând, metoda trebuie să fie universală și să ofere rezultate pozitive pe majoritatea datelor de intrare. Adică, în medie, pentru intrări arbitrare, ar trebui să existe efectiv o reducere a cantității de informație stocate. „În medie” înseamnă că cazurile opuse ar putea apărea, dar nu ar trebui să predomină.
- În al doilea rând, dimensiunea containerului comprimat înainte de a încorpora informația trebuie să fie mai mare decât cea a versiunii comprimate similar a modificării sale. Pur și simplu a încorpora o mulțime de biți în imagine BMP prin metoda LSB nu reprezintă o compresie steganografică, deoarece, fiind procesat printr-un DEFLATE oarecare, imaginea originală va fi probabil mult mai mică.
- În al treilea rând, rezultatul trebuie evaluat și comparat în raport cu datele deja comprimate prin metode clasice. Acest lucru va elimina efectul probabilistic al diferenței de redundanță și va permite o comprimare mai eficientă în general.
Unde?
Utilizarea steganografiei implică că, pe lângă informația comprimată, ne vor fi necesare containerele în care aceasta va fi încorporată. Cantitatea maximă de informație care poate fi încorporată depinde în mare măsură de proprietățile specifice, dar scalarea este mult mai simplă cu numărul acestora. Prin urmare, formatul containerelor ar trebui să fie comun, astfel încât utilizatorul să aibă suficiente opțiuni pentru a obține o rentabilitate de la procesul de 'comprimare'.
În acest context, candidații buni sunt fișierele grafice, audio și video. Dar, din cauza diversității diferitelor formate, codecuri etc., în practică, ne rămâne să alegem dintr-un număr nu atât de mare de opțiuni.
Ținând cont de toate acestea, alegerea mea a căzut pe JPEG. Este practic disponibil pentru toată lumea, fiind utilizat pe scară largă atât în scopuri personale, cât și de afaceri, având statut de format de facto pentru majoritatea imaginilor.
C̶u̶n̶d̶ ̶?̶
Apoi urmează scheme și descrieri tehnice și aproximative fără explicații deosebite, așa că cei interesați le pot sări, derulând până la secțiunea „Tehnologii avansate”.
Caracteristici generale
Pentru a încorpora datele undeva, trebuie mai întâi să determinăm unde. Pe un sistem de fișiere pot exista nenumărate fotografii diferite, dintre care utilizatorul poate dori să utilizeze doar unele. Această mulțime dorită de containere o vom numi bibliotecă.
Aceasta se formează în două cazuri: înainte de comprimare și înainte de decompresie. În primul caz, se poate folosi pur și simplu un set de nume (sau, mai bine, o expresie regulată pentru acestea) de fișiere, dar în al doilea caz este nevoie de ceva mai fiabil: utilizatorul poate copia și muta fișierele în interiorul sistemului de fișiere, nepermițându-le astfel să fie identificate corect. Prin urmare, este necesar să se păstreze hash-urile acestora (md5 este suficient) după efectuarea tuturor modificărilor.
Căutarea inițială după expresia regulată nu are sens să fie efectuată pe întreaga FS, este suficient să se indice un anumit director rădăcină. Acolo va fi salvat un fișier-archiv special, în care vor fi păstrate acele hash-uri, alături de alte metainformații necesare pentru recuperarea ulterioară a informației comprimate.
Toate acestea se aplică în aceeași măsură oricărei implementări a oricărui algoritm de comprimare steganografică a datelor. Procesele propriu-zise de comprimare și recuperare a datelor pot fi numite împachetare și despachetare.
F5
Acum, când a devenit clar ce facem și de ce, rămâne să descriem algoritmul pentru a atinge obiectivul. Să ne amintim procesul de codificare a fișierului JPEG (mulțumim Wikipediei Bibliotecii Naționale numită Bauman):
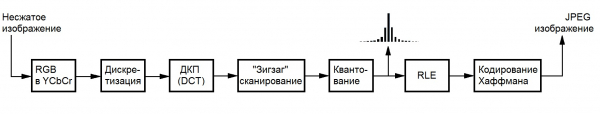
Privind la el, ar fi bine să facem câteva observații imediat:
- Dimensiunea fișierului JPEG poate fi considerată optimă, chiar fără a încerca să-l comprimăm cu vreun WinRAR;
- Este permisă modificarea doar a informației stocate (cele care ies din transformarea cosinusoidală discretă, DCT), pentru a asigura o performanță cât de cât acceptabilă.
- Pentru a nu pierde date în proporții semnificative pentru utilizator, este necesar să se facă un minim de modificări la fiecare imagine individuală;
Pentru aceste condiții se pot folosi o întreagă familie de algoritmi, cu care se poate familiariza . Cel mai avansat dintre ei este algoritmul gândit de Andreas Westfeld, care lucrează cu coeficienții DCT ai componentei de luminozitate (ochiul uman fiind cel mai puțin sensibil la modificările sale). Schema sa generală atunci când lucrează cu un fișier JPEG existent este ilustrată în următoarea diagramă:
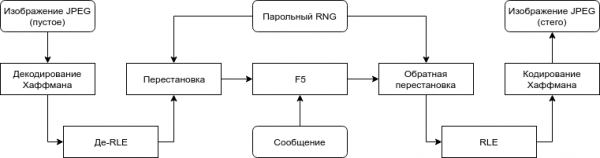
Blocul F5 utilizează o metodă avansată de încorporare, bazată pe codificarea matricii. Cititorul poate afla mai multe despre aceasta și despre algoritm în linkul de mai sus, dar ne interesează în primul rând faptul că, cu ajutorul său, se pot face modificări mai mici în timpul încorporării aceleași cantități de informații, cu cât dimensiunea containerului utilizat este mai mare, iar pentru a rula efectiv algoritmul este necesar să se efectueze doar operațiuni simple de (de)coding Huffman și RLE.
Modificările în sine sunt realizate asupra coeficientilor întregi și sunt reduse la diminuarea valorii absolute a acestora cu o unitate, ceea ce teoretic permite utilizarea F5 pentru comprimarea datelor. Motivul este că un coeficient cu o valoare absolută redusă va ocupa cu siguranță un număr mai mic de biți după codificarea Huffman din cauza distribuției statistice a valorilor în JPEG.
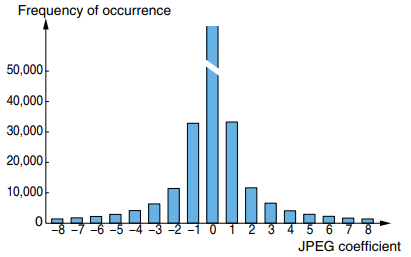
În cazul formării unui zero (așa-numita reducere), cantitatea de informație stocată va scădea cu dimensiunea acestuia, deoarece coeficientul care a fost anterior independent devine parte a secvenței codificate RLE de zerouri:
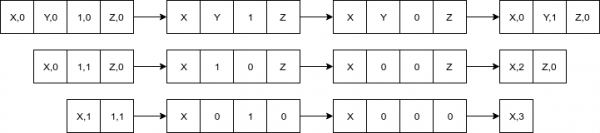
Modificări
Protecția datelor și comprimarea acestora sunt sarcini ortogonale, prin urmare, se poate neglija permutarea secretă a parolei din algoritmul original. Mai mult, avem nevoie să știm exact cum să extragem datele, astfel că toată informația necesară pentru aceasta (ce containere au fost utilizate, în ce ordine etc.) trebuie să fie înregistrată într-un fișier separat și să fie deschisă pentru citire liberă de către arhivator.
Algoritmul original este proiectat pentru transmiterea mesajelor secrete, astfel încât funcționează împreună cu un singur container la un moment dat, presupunând că utilizatorul va trebui să-l împartă în părți dacă este necesar. Mai mult, în cazul încorporării independente în fiecare container, este necesar să se știe anterior câți biți de date se pot plasa în fiecare. Prin urmare, coeficientii fiecărui element din bibliotecă ar trebui să fie combinați într-un singur mare abstract și să lucrăm cu acesta conform algoritmului original.
Deoarece F5 original permite utilizarea a până la 12% din dimensiunea containerului, această modificare va crește, de asemenea, capacitatea maximă: „până la 12%” din dimensiunea întregii biblioteci este mai mare sau egal cu suma „până la 12%” din fiecare dintre elementele sale.
Schema generală codificată arată astfel:
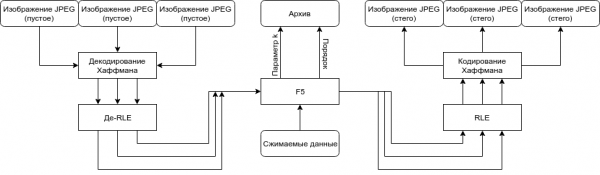
Algoritmul în sine
Acum este timpul să descriem algoritmul de la început până la sfârșit, pentru a nu lăsa cititorul în necunoștință:
- Utilizatorul definește datele binare compresibile M și biblioteca L cu ajutorul unei expresii regulate și a directorului rădăcină de căutare;
- În ordinea în care se află în sistemul de fișiere, elementele bibliotecii formează MC:
- Din datele fișierului se decodează o serie de coeficienti C;
- MC <- MC | C;
- Parametrul k se determină pe baza inegalității terifiante:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Se ia pe rând
n = (1 << k) - 1cei mai puțini biți ai elementelor nenule din MC și se scriu îna:- Se calculează funcția de hash magică
f, care mapează un cuvânt de n bițiaîn unul de k bițis; - Dacă
dacă s == 0, atunci nu este nevoie să se modifice nimic și algoritmul trece la coeficientii următori; - Se reduce valoarea absolută a coeficientului, responsabil pentru
s-bitul în cuvânta; - Dacă prin reducere s-a întâmplat o scădere (coeficientul a devenit 0), atunci se repetă pasul de la început;
- Se calculează funcția de hash magică
- Toți coeficientii sunt codificați RLE și Huffman, scriindu-se în fișierele originale;
- În fișierul arhivei se scrie parametrul k;
- Pentru fiecare fișier L, în ordinea în care se află inițial, se calculează hash-ul MD5 și se scrie în fișierul arhivei.
Tehnologii avansate
Forma naivă a algoritmului și implementările în alte limbaje de nivel înalt (în special, cele cu colectare de gunoi) ar oferi o performanță îngrozitoare, așa că toate aceste complexe le-am realizat în C pur și am efectuat o serie de optimizări atât în ceea ce privește viteza de execuție, cât și pe memorie (nu vă imaginați câte greutate au aceste imagini fără compresie chiar și până la DCT). Dar chiar și așa, la început, viteza de execuție lăsa mult de dorit, așa că nu voi descrie întregul proces și metodele utilizate.
Portabilitatea a fost obținută prin utilizarea unei combinații de biblioteci libjpeg, pcre și tinydir, pentru care le mulțumesc. În mod implicit, totul este compilat printr-un obicei make, așa că utilizatorii Windows doresc să instaleze un fel de Cygwin sau să se descurce cu Visual Studio și bibliotecile singuri.
Implementarea este disponibilă sub formă de utilitar de consolă și bibliotecă. Cei care doresc să afle mai multe despre utilizarea acesteia pot consulta readme-ul din depozitul de pe GitHub, a cărui legătură o voi atașa la finalul postării. Acum să trecem la descrierea și demonstrarea funcționării.
Cum se folosește?
Cu precauție. Imaginile utilizate pot fi mutate, redenumite și copiate la decizia utilizatorului. Totuși, trebuie să fiți extrem de atenți și să nu modificați în niciun fel conținutul acestora. Schimbarea unui singur bit va duce la coruperea hash-ului și la imposibilitatea recuperării informațiilor.
Să presupunem că, după compilare, am obținut un fișier executabil f5ar. Putem analiza dimensiunea bibliotecii pentru a calcula posibilitățile sale de utilizare cu ajutorul flag-ului -a: ./f5ar -a [folder de căutare] [expresie regulată compatibilă Perl]. Pachetul se realizează cu comanda ./f5ar -p [folder de căutare] [expresie regulată compatibilă Perl] [fișier de pachetat] [nume arhivă], iar despachetarea se face prin ./f5ar -u [fișier arhivă] [nume fișier restaurat].
Demonstrarea funcționării
Pentru a arăta eficiența metodei, am încărcat o colecție de 225 de fotografii gratuite cu câini de pe serviciul . Fiecare dintre acestea are o calitate puțin mai bună decât fotografiile obișnuite ale utilizatorilor, dar totuși. Fiecare a fost reencodată cu ajutorul libjpeg pentru a atenua influența particularităților codării bibliotecii asupra dimensiunii generale. Pentru a ilustra cel mai slab exemplu de date comprimate, a fost generat cu dd un fișier uniform distribuit de 36 de metri (puțin peste 5% din dimensiunea totală).
Procesul de testare este destul de simplu:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ ./f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Reading compressing file... ok
Initializing the archive... ok
Analysing library capacity... done in 16.8s
Detected somewhat guaranteed capacity of 48439359 bytes
Detected possible capacity of upto 102618787 bytes
Compressing... done in 32.6s
Saving the archive... ok

$ ./f5ar -u dogs/dogs.f5ar unpacked
Initializing the archive... ok
Reading the archive file... ok
Filling the archive with files... done in 1.2s
Decompressing... done in 17.5s
Writing extracted data... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Sau un screenshot pentru pasionați
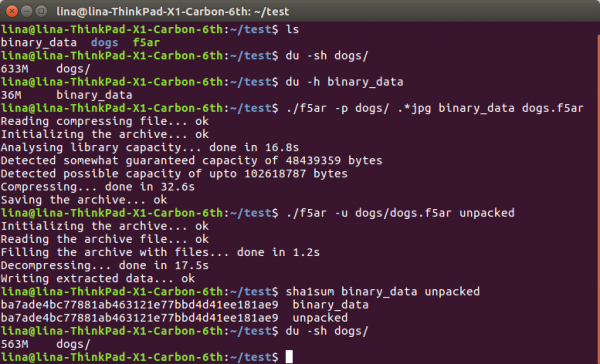
Așa cum se vede, de la cele 633 + 36 == 669 megabiți de date pe hard disk, am ajuns la un mai plăcut 563, oferindu-ne un coeficient de compresie de ~1,188. Această diferență radicală se explică prin pierderi extrem de mici, asemănătoare celor obținute prin optimizarea fișierelor JPEG cu metodele clasice (de tip tinyjpg). Evident, atunci când se utilizează compresia steganografică, informația nu este pur și simplu „pierdută”, ci folosită pentru codificarea altor date. Mai mult, numărul de coeficienți „optimizati” prin utilizarea F5 este mult mai mic decât în cazul optimizării tradiționale.
Indiferent de modificările aduse, pentru ochi nu sunt deloc vizibile. Sub spoilerul de mai jos, cititorul poate evalua diferența atât vizual, cât și prin scăderea valorilor componentei modificate din cea originală (cu cât culoarea este mai închisă, cu atât diferența este mai mică):
Linkuri către imagini care nu s-au încărcat pe habrastorage
Original —
Modificat —
Diferență —
În concluzie
Sper că am reușit să conving cititorul că astfel de metode sunt posibile și merită să existe. Cu toate acestea, a cumpăra un hard disk sau un canal suplimentar (pentru transferul de date în rețea) poate părea o soluție mult mai simplă decât încercarea de a economisi în acest mod. Pe de o parte, așa este, dezvoltarea extensivă este adesea mai simplă și mai fiabilă. Dar, pe de altă parte, nu trebuie uitată nici dezvoltarea intensivă. Nu există nicio garanție că mâine se va putea merge în magazin și cumpăra un alt hard disk de o mie de terabiți, dar utilizarea celor existente acasă rămâne mereu o opțiune.
->
Sursă: habr.com
