

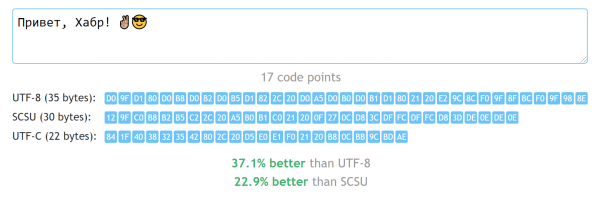
Dacă ești dezvoltator și trebuie să alegi o codificare, aproape întotdeauna soluția corectă va fi Unicode. Modul specific de reprezentare depinde de context, dar cel mai adesea există un răspuns universal – UTF-8. Este eficient pentru că permite utilizarea tuturor simbolurilor Unicode, fără a consuma prea multe byte în cele mai multe cazuri. Totuși, pentru limbile care folosesc nu doar literele latine, „nu prea multe” înseamnă, cel puțin două byte pe simbol. Se poate o soluție mai bună, fără a reveni la codificările preistorice, care ne limitează la doar 256 de simboluri disponibile?
Mai jos te invit să descoperi tentativa mea de a răspunde la această întrebare și implementarea unui algoritm relativ simplu, care permite stocarea șirurilor în majoritatea limbilor lumii, fără a adăuga excesul pe care îl are UTF-8.
Declinarea responsabilității. Imediat voi face câteva precizări importante: soluția descrisă nu este propusă ca o înlocuire universală a UTF-8, ci se potrivește doar unui număr restrâns de cazuri (despre care vom vorbi mai jos), și nu trebuie folosită în interacțiunea cu API-uri externe (care nu au cunoștință de ea). Cel mai adesea, pentru stocarea compactă a unor volume mari de date text, algoritmii de compresie generali (de exemplu, deflate) sunt mai adecvați. În plus, deja în procesul de creării soluției mele am descoperit un standard existent în cadrul Unicode-ului, care rezolvă aceeași problemă – este puțin mai complicat (și adesea mai puțin eficient), dar este, în continuare, un standard acceptat, nu o soluție improvizată. De asemenea, voi vorbi despre el.
Despre Unicode și UTF-8
Mai întâi – câteva cuvinte despre ce este, de fapt, Unicode și UTF-8.
După cum se știe, codificările de 8 biți au fost populare în trecut. Cu acestea a fost simplu: 256 de simboluri pot fi numerotate cu numere de la 0 la 255, iar numerele de la 0 la 255 sunt evident reprezentabile printr-un byte. Dacă ne întoarcem la cele mai vechi origini, codificarea ASCII este limitată la 7 biți, astfel că cel mai semnificativ bit în reprezentarea sa byte este zero, iar majoritatea codificărilor de 8 biți sunt compatibile cu aceasta (diferențele apar doar în partea „superioară”, unde cel mai semnificativ bit este unu).
Cu ce se deosebește Unicode de aceste codificări și de ce este legat de atât de multe reprezentări specifice – UTF-8, UTF-16 (BE și LE), UTF-32? Hai să analizăm pe rând.
Standardul de bază Unicode descrie doar corespondența între caractere (iar în unele cazuri – componentele individuale ale caracterelor) și numerele lor. Și numerele posibile din acest standard sunt foarte multe – de la 0x00 la 0x10FFFF (1 114 112 de bucăți). Dacă am dori să stocăm un număr în acest interval într-o variabilă, 1 sau 2 octeți nu ne-ar fi suficienți. Și cum procesoarele noastre nu sunt foarte pregătite pentru a lucra cu numere de trei octeți, am fi nevoiți să folosim nu mai puțin de 4 octeți pentru un singur caracter! Asta este UTF-32, dar tocmai din cauza acestei "risipe" acest format nu este popular.
Din fericire, caracterele din Unicode nu sunt dispuse întâmplător. Toată această multitudine este împărțită în 17 „planuri”, fiecare conținând 65536 (0x10000) «puncte de cod”. Conceptul de „punct de cod” se referă pur și simplu la numărul caracterului, atribuit lui de Unicode. Dar, așa cum s-a menționat mai sus, în Unicode sunt numerotate nu doar caracterele individuale, ci și componentele lor și semnele de serviciu (iar uneori, numărul de nimic nu corespunde – poate, până când va fi nevoie, dar pentru noi nu este atât de important), prin urmare, este mai corect să vorbim despre numărul efectiv al numerelor, nu despre caractere. Totuși, pentru concizie, voi folosi adesea cuvântul „caracter”, însemnând termenul „punct de cod”.
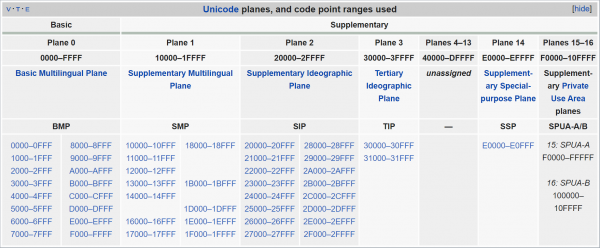
Planurile Unicode. După cum se poate observa, cea mai mare parte (planurile de la 4 la 13) este încă neutilizată.
Ceea ce este cu adevărat remarcabil – întreaga „miez” principală se află în planul zero, numit "Basic Multilingual Plane". Dacă o linie conține text într-una dintre limbile moderne (inclusiv limba chineză), nu veți ieși din această plană. Dar nu putem tăia partea rămasă a Unicode-ului – de exemplu, emoji-urile se află în principal la finalul următoarei planuri, "Supplementary Multilingual Plane" (care se întinde de la 0x10000 la 0x1FFFF). Prin urmare, UTF-16 acționează astfel: toate caracterele care se încadrează în Basic Multilingual Plane, sunt codificate „așa cum sunt”, cu numărul de două octeți corespunzător. Totuși, o parte din numere din acest interval nu reprezintă caractere specifice, ci indică faptul că, după acest duo de octeți, trebuie să privim încă unul – combinând valorile acestor patru octeți, obținem un număr care acoperă întreaga gamă permisă de Unicode. Această reprezentare se numește „perechi surrogate” – poate ați auzit despre ele.
Astfel, UTF-16 necesită două sau (în cazuri foarte rare) patru octeți pentru un "punct de cod". Este mai bine decât să folosești constant patru octeți, dar literele latine (și alte caractere ASCII) consumă, prin această codificare, jumătate din spațiu pe zerouri. UTF-8 este destinat să remedieze aceasta: ASCII în el ocupă, la fel ca înainte, doar un octet; codurile de 0x80 la 0x7FF — două octeți; de 0x800 la 0xFFFF — trei, iar de 0x10000 la 0x10FFFF — patru. Pe de o parte, literele latine au câștigat: s-a restabilit compatibilitatea cu ASCII, iar distribuția este mai uniform "întinsă" de la 1 la 4 octeți. Dar alfabeturile diferite de cel latin, din păcate, nu câștigă deloc în comparație cu UTF-16, iar multe necesită acum chiar trei octeți în loc de doi — intervalul acoperit de înregistrarea de doi octeți s-a restrâns de 32 de ori, de 0xFFFF la 0x7FF, și acum nu mai include nici chineza, nici, de exemplu, georgiana. Din fericire, cyrilica și alte cinci alfabete au beneficiat — 2 octeți pe simbol.
De ce se întâmplă asta? Să vedem cum UTF-8 reprezintă codurile caracterelor:
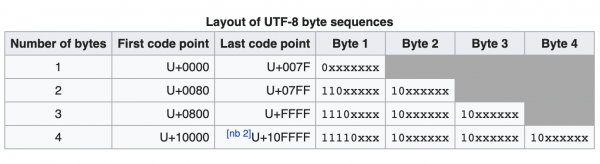
Direct pentru reprezentarea numerelor, aici sunt utilizați biți marcați cu simbolul x. Se observă că în înregistrarea de doi octeți sunt doar 11 biți (din 16). Biții de conducere au doar o funcție de serviciu. În cazul înregistrării de patru octeți, sunt alocați 21 de biți din 32 pentru numărul punctului de cod — părea că ar fi fost suficienți și trei octeți (care oferă în total 24 de biți), dar marcajele de serviciu consumă prea mult.
Este un lucru rău? De fapt, nu foarte. Pe de o parte — dacă ne preocupăm foarte mult de spațiul ocupat, avem algoritmi de compresie care pot elimina cu ușurință toată entropia și redundanța. Pe de altă parte — scopul Unicode-ului a fost să ofere o codificare cât mai universală. De exemplu, un lanț codificat în UTF-8 poate fi încredințat unui cod care înainte funcționa doar cu ASCII și nu ne temem că va vedea un caracter din intervalul ASCII care de fapt nu există acolo (deoarece în UTF-8 toate byte-urile care încep cu bitul zero sunt chiar ASCII). Iar dacă brusc dorim să tăiem un mic coadă dintr-un lanț mare, fără a-l decodifica de la început (sau de a recupera o parte din informație după o zonă deteriorată) — nu este greu să găsim acel offset unde începe un anumit caracter (e suficient să sărim peste byte-urile care au un prefix de bit 10).
De ce atunci să inventăm ceva nou?
În același timp, ocazional apar situații în care algoritmii de comprimare, cum ar fi deflate, sunt ineficienți, dar se dorește obținerea unei stocări compacte a șirurilor. Personal, m-am confruntat cu o astfel de provocare, gândindu-mă la construirea pentru un dicționar mare, care include cuvinte în diverse limbi. Pe de o parte, fiecare cuvânt este foarte scurt, deci comprimarea acestuia ar fi ineficientă. Pe de altă parte, implementarea arborelui pe care o lua în considerare era proiectată astfel încât fiecare byte al șirului stocat să genereze un nod distinct al arborelui, iar minimizarea numărului lor era foarte utilă. În biblioteca mea (la fel ca și în , pe care este bazată) problema de genul acesta se rezolvă simplu — șirurile, împachetate în sunt stocate acolo în De asemenea, vreau să subliniez un alt aspect neplăcut care apare atunci când se folosește UTF-8 în o astfel de structură de date. În imaginea de mai sus, se vede că atunci când este scris un caracter sub formă de două byte, biții care îi corespund nu sunt consecutivi, ci sunt întrerupți de o pereche de biți
în mijloc: 10 . Din cauza acestui lucru, atunci când în codul caracterului se depășesc cei 6 biți inferiori ai celui de-al doilea byte (adică se produce o tranziție 110xxxxx 10xxxxxx), atunci se schimbă și primul byte. Rezultatul este că litera „п” este reprezentată de byte-uri 10111111 → 10000000, iar următoarea litera „р” — de byte-uri 0xD0 0xBF. În arborele prefixat, acest lucru duce la divizarea nodului părinte în două — unul pentru prefix 0xD1 0x80, și altul pentru 0xD0(deși întreaga chirilică ar putea fi codificată doar cu al doilea byte). 0xD1 Ce am realizat
Confruntându-mă cu această problemă, am decis să exersez cu biți și, în același timp, să cunosc mai bine structura Unicode în ansamblu. Rezultatul a fost un format de codare UTF-C („C” de la
compact), care nu consumă mai mult de 3 byte-uri pe un punct de cod, dar foarte adesea permite consumarea doar a unui byte suplimentar pentru întreaga linie codificată.Aceasta duce la faptul că pe multe alfabete non-ASCII, această codare devine cu 30-60% mai compactă decât UTF-8.Am organizat exemple de implementări ale algoritmilor de codare și decodare sub forma bibliotecilor în JavaScript și Go..
Am realizat exemple de implementare a algoritmilor de codare și decodare sub formă de , puteți utiliza liber în codul dvs. Totuși, voi sublinia că, într-un anumit sens, acest format rămâne un „bicicletă”, iar eu nu recomand să-l folosiți fără a înțelege de ce aveți nevoie de el. Este mai degrabă un experiment decât o „îmbunătățire” serioasă a UTF-8. Cu toate acestea, codul este scris cu grijă, concis, cu multe comentarii și acoperire de teste.
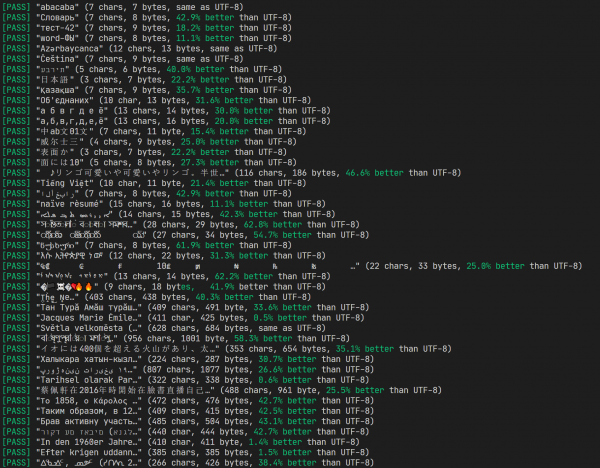
Rezultatul testelor efectuate și comparația cu UTF-8
De asemenea, am realizat , unde poate fi evaluată funcționarea algoritmului, iar apoi voi explica mai în detaliu principiile și procesul de dezvoltare.
Eliminăm biții redundanți
Ca bază, am folosit, desigur, UTF-8. Primul și cel mai evident lucru pe care îl putem schimba este să reducem numărul de biți de control din fiecare octet. De exemplu, primul octet din UTF-8 începe întotdeauna fie cu 0, fie cu 11 — prefixul 10 există doar la octetii următori. Să înlocuim prefixul 11 pe 1, iar la octetii următori eliminăm complet prefixelor. Ce va rezulta?
0xxxxxxx — 1 octet
10xxxxxx xxxxxxxx — 2 octeți
110xxxxx xxxxxxxx xxxxxxxx — 3 octeți
Stop, dar unde este reprezentarea pe patru octeți? Aceasta a devenit inutilă — la scrierea pe trei octeți avem acum acces la 21 de biți și acest lucru este mai mult decât suficient pentru toate numerele până la 0x10FFFF.
Ce am sacrificat aici? Cel mai important — detectarea limitelor caracterelor dintr-un loc aleatoriu al tamponului. Nu putem să ne uităm într-un octet aleatoriu și să găsim începutul următorului caracter. Aceasta este o limitare a formatului nostru, dar în practică necesitatea unei astfel de funcționalități nu apare des. De obicei, suntem capabili să parcurgem tamponul de la început (mai ales când este vorba de șiruri scurte).
Situația cu acoperirea limbilor pe 2 octeți a devenit de asemenea mai bună: acum formatul cu două octeți oferă un interval de 14 biți, iar aceasta permite coduri până la 0x3FFF. Chinezii nu au noroc (ieroglifele lor sunt în principal în intervalul de la 0x4E00 la 0x9FFF), dar georgienii și multe alte națiuni au devenit mai fericiți — limbile lor se încadrează și ele în 2 octeți pe caracter.
Introducem starea encoderului
Acum să ne gândim la proprietățile șirurilor în sine. În dicționar, cuvintele sunt adesea scrise cu caractere dintr-un singur alfabet, ceea ce este de asemenea adevărat pentru multe alte texte. Ar fi bine să specificăm o dată acest alfabet și apoi să indicăm doar numărul literei din interiorul său. Să vedem dacă ne ajută poziționarea caracterelor în tabelul Unicode.
După cum s-a menționat mai sus, Unicode-ul este împărțit în planuri câte 65536 coduri fiecare. Dar aceasta nu este o diviziune foarte utilă (cum am spus deja, cel mai adesea ne aflăm în planul zero). O diviziune mai interesantă este blocuri. Aceste intervale nu mai au o lungime fixă și au mai mult sens — de obicei, fiecare reunește caractere din aceeași alfabet.
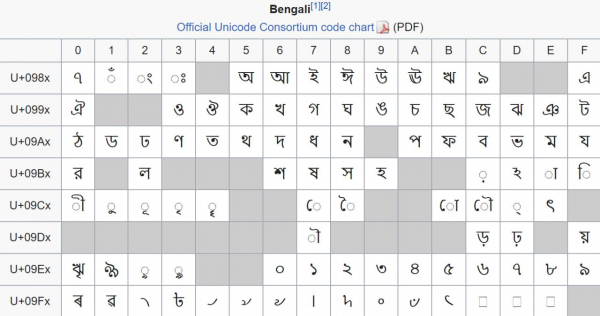
Un bloc care conține caractere din alfabetul bengalez. Din păcate, din motive istorice, acesta este un exemplu de ambalare nu foarte densă — 96 de caractere sunt dispersate haotic pe 128 de puncte de cod ale blocului.
Întâlnirile blocurilor și dimensiunile lor sunt întotdeauna multipli de 16 — aceasta a fost făcută pur și simplu pentru comoditate. În plus, multe blocuri încep și se termină la valori care sunt multipli de 128 sau chiar 256 — de exemplu, chirilica de bază ocupă 256 de bytes de 0x0400 la 0x04FF. Este destul de convenabil: dacă salvăm o dată prefixul 0x04, atunci orice caracter chirilic poate fi scris cu un singur byte. Totuși, în acest mod, vom pierde posibilitatea de a reveni la ASCII (și la orice alte caractere în general). De aceea facem așa:
- Două bytes
10yyyyyy yxxxxxxxnu doar indică un caracter cu numărulyyyyyy yxxxxxxx, ci și schimbă alfabetul curent peyyyyyy y0000000adică, memorăm toate bitii, cu excepția celor de jos 7 bits); - Un byte
0xxxxxxxeste un caracter din alfabetul curent. Trebuie să-l adunăm pur și simplu cu offsetul pe care l-am memorat în pasul 1. Până când alfabetul nu a fost schimbat, offsetul este zero, astfel că compatibilitatea cu ASCII a fost menținută.
În mod similar pentru codurile care necesită 3 bytes:
- Trei bytes
110yyyyy yxxxxxxx xxxxxxxxindică un caracter cu numărulyyyyyy yxxxxxxx xxxxxxxx, schimbă alfabetul curent peyyyyyy y0000000 00000000(am memorat tot, cu excepția celor de jos 15 bits), și pun un steag că acum suntem în mod lung (când schimbăm alfabetul înapoi la modului cu două bytes, acest steag va fi resetat); - Două bytes
0xxxxxxx xxxxxxxxîn mod lung, acesta este caracterul din alfabetul curent. În mod similar, îl adunăm cu offsetul din pasul 1. Tot ce diferă este că acum citim două bytes (deoarece am schimbat în acest mod).
Pare destul de bine: acum, atât timp cât trebuie să codificăm caractere din același interval de 7 biți Unicode, cheltuim un byte suplimentar la început și la fiecare caracter un byte.
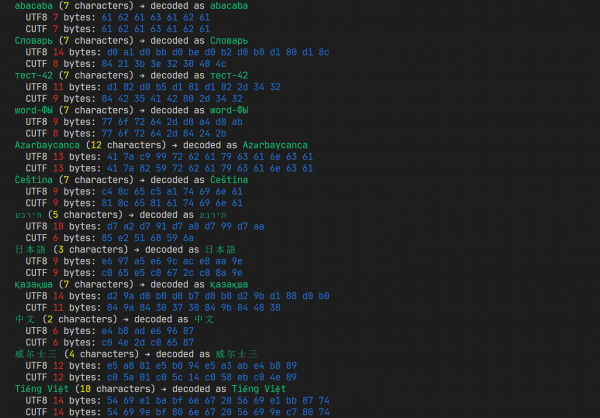
Funcționarea uneia dintre versiunile timpurii. Deja evită adesea UTF-8, dar mai sunt multe de îmbunătățit.
Ce s-a înrăutățit? În primul rând, am obținut o stare, și anume offsetul alfabetului curent și steagul modului lungAceasta ne limitează suplimentar: acum aceleași caractere pot fi codificate diferit în contexte diferite. Căutarea subșirurilor, de exemplu, va trebui să se facă ținând cont de acest aspect, nu doar comparând byte-urile. În al doilea rând, imediat ce am schimbat alfabetul, a apărut o problemă cu codificarea caracterelor ASCII (iar asta nu se referă doar la literele latine, ci și la punctuația de bază, inclusiv spațiile) - acestea necesită o schimbare repetată a alfabetului în 0, adică din nou un byte suplimentar (apoi încă unul, pentru a reveni la alfabetul nostru principal).
Un alfabet e bine, două sunt și mai bine.
Să încercăm să modificăm puțin prefixelor noastre de biți, adăugând unul la cele trei menționate mai sus:
0xxxxxxx — 1 byte în modul normal, 2 în modul lung.
11xxxxxx — 1 octet
100xxxxx xxxxxxxx — 2 octeți
101xxxxx xxxxxxxx xxxxxxxx — 3 octeți
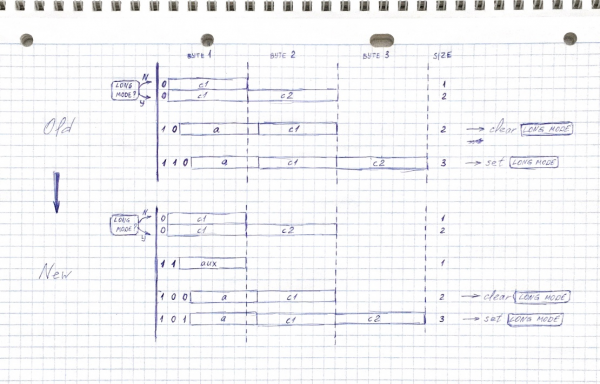
Acum, în reprezentarea de două byte, există cu un bit disponibil mai puțin - pot fi incluse puncte de cod până la 0x1FFF, nu 0x3FFF. Cu toate acestea, este încă semnificativ mai mult decât în codurile de două byte UTF-8, cea mai mare parte a limbilor comune încă se potrivește, cea mai notabilă pierdere fiind și , japonezii sunt triști.
Ce este noul cod 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) alfabet. Atunci când schimbăm alfabetul curent, o parte din vechiul alfabet devine auxiliar. De exemplu, am trecut de la ASCII la chirilică – în „rezervor” acum sunt 64 de caractere, conținând litere latine, cifre, un spațiu și o virgulă (cele mai frecvente inserții în textele non-ASCII). Am revenit la ASCII – și alfabetul auxiliar va deveni majoritatea caracterelor chirilice.
Datorită accesului la două alfabete, putem gestiona un număr mai mare de texte, având costuri minime pentru schimbarea alfabetelor (punctuația va conduce cel mai adesea la revenirea în ASCII, dar după aceea multe caractere non-ASCII le vom obține deja din alfabetul suplimentar, fără o schimbare repetată).
Bonus: definind alfabetul suplimentar cu un prefix 11xxxxxx și alegându-i decalajul inițial egal cu 0xC0, obținem compatibilitate parțială cu CP1252. Cu alte cuvinte, multe (dar nu toate) texte vest-europene codificate în CP1252 vor arăta la fel și în UTF-C.
Aici, totuși, apare o dificultate: cum să obținem alfabetul auxiliar din alfabetul principal? Poate rămâne același decalaj, dar - din păcate - aici structura Unicode joacă împotriva noastră. Foarte frecvent, partea principală a alfabetului nu se află la începutul blocului (de exemplu, litera mare rusă „A” are cod 0x0410, deși blocul chirilic începe cu 0x0400). Astfel, luând în „rezervă” primele 64 de caractere, am putea pierde accesul la partea finală a alfabetului.
Pentru a remedia această problemă, am parcurs manual unele blocuri corespunzătoare diferitelor limbi și am specificat pentru ele un offset al alfabetului auxiliar în cadrul celui principal. Latinele, în mod excepțional, le-am reordonat complet similar cu base64.
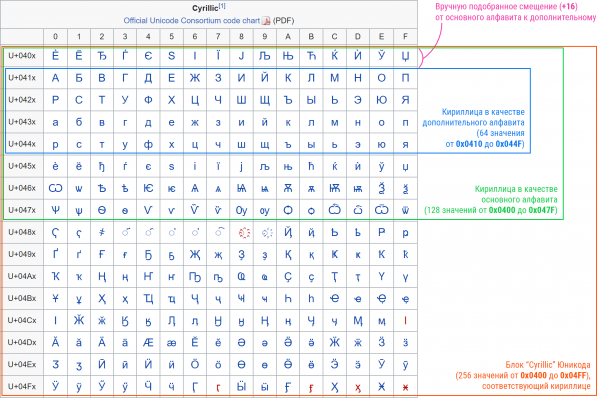
Retușuri finale
Să ne gândim în cele din urmă unde am mai putea îmbunătăți ceva.
Observăm că formatul 101xxxxx xxxxxxxx xxxxxxxx permite codificarea numerelor până la 0x1FFFFF, iar Unicode se încheie mai devreme, la 0x10FFFF. Cu alte cuvinte, ultimul punct de cod va fi reprezentat ca 10110000 11111111 11111111. Așadar, putem spune că dacă primul byte are forma 1011xxxx (unde xxxx mai mare de 0), acesta reprezintă altceva. De exemplu, se pot adăuga încă 15 caractere, disponibile în permanență pentru codificare cu un byte, dar am decis să fac altfel.
Să examinăm acele blocuri Unicode care necesită trei bytes acum. În principal, după cum s-a spus deja, acestea sunt caracterele chinezești — dar este greu de făcut ceva cu ele, sunt 21 de mii. Dar mai sunt și hiragana cu katakana — iar acestea nu sunt atât de multe, mai puțin de două sute. Și, având în vedere că ne-am amintit de japonezi — acolo se află și emoji-urile (de fapt, acestea sunt răspândite în multe locuri în Unicode, dar blocurile principale sunt în intervalul 0x1F300 – 0x1FBFF). Dacă ne gândim că acum există emoji-uri care sunt formate din mai multe puncte de cod (de exemplu, emoji-ul constă din 7 coduri!), devine cu adevărat frustrant să cheltuim trei bytes pentru fiecare (7×3 = 21 bytes pentru un singur simbol, un coșmar).
De aceea, alegem câteva intervale selectate, corespunzătoare emoji-urilor, hiraganei și katakanei, le renumerotăm într-o listă continuă și le codificăm sub formă de două bytes în loc de trei:
1011xxxx xxxxxxxx
Excelent: emoji-ul menționat anterior , format din 7 puncte de cod, în UTF-8 ocupă 25 bytes, iar noi l-am încadra în 14 (exact câte două bytes pentru fiecare punct de cod). Apropo, Habr a refuzat să-l prelucreze (atât în vechiul, cât și în noul editor), așa că a fost necesar să-l inserăm ca imagine.
Să încercăm să corectăm încă o problemă. După cum ne amintim, alfabetul principal este practic bitii 6 cei mai semnificativi, pe care îi avem în minte, și îi lipim la codul fiecărui simbol de decodificat. În cazul caracterelor chinezești, care se află în blocul 0x4E00 – 0x9FFF, este fie un bit 0, fie un bit 1. Acest lucru nu este foarte practic: va trebui să comutăm constant între aceste două valori ale alfabetului (adică să consumăm câte trei bytes). Dar să observăm că, în modul lung, din codul în sine putem scădea numărul de simboluri pe care le codificăm folosind modul scurt (după toate trucurile descrise mai sus, acesta este 10240) — astfel, gama de hieroglife se va muta la 0x2600 – 0x77FF, și în acest caz, în toată această gamă, cei mai semnificativi 6 biți (din 21) vor fi egali cu 0. Astfel, secvențele de hieroglife vor folosi câte două bytes pe hieroglif (ceea ce este optim pentru o astfel de gamă mare), fără a necesita comutări între alfabete.
Soluții alternative: SCSU, BOCU-1
Cunoștințele Unicode, chiar și citind titlul articolului, cel mai probabil se vor grăbi să reamintească că, printre standardele Unicode, există (SCSU), care descrie o metodă de codificare foarte similară cu cea descrisă în articol.
Trebuie să recunosc: despre existența sa am aflat doar după ce m-am angajat profund în scrierea propriului meu sistem. Dacă aș fi știut despre el de la început, probabil că aș fi încercat să scriu implementarea lui în loc să inventez abordarea mea.
Ce este interesant, SCSU folosește idei foarte asemănătoare cu cele la care am ajuns singur (în loc de noțiunea de „alfabet”, sunt folosite „feron” și există mai multe decât la mine). Totuși, acest format are și dezavantaje: este puțin mai apropiat de algoritmii de comprimare decât de codificare. În special, standardul oferă multe moduri de reprezentare, dar nu precizează cum să alegi din ele pe cel optim — pentru aceasta, encoderul trebuie să aplice anumite euristici. Astfel, un encoder SCSU care oferă o ambalare bună va fi mai complex și mai greu de utilizat decât algoritmul meu.
Pentru comparație, am transferat o implementare relativ simplă SCSU în JavaScript — ca volum de cod, s-a dovedit comparabil cu al meu UTF-C, dar în anumite cazuri a arătat rezultate cu zeci de procente mai slabe (uneori poate și depăși, dar nu cu mult). De exemplu, textele în ebraică și greacă UTF-C le-a codificat cu cu 60% mai bine decât SCSU (probabil din cauza alfabetelor lor compacte).
În plus, voi adăuga că, pe lângă SCSU, există și o altă metodă de reprezentare compactă a Unicode — , dar acesta își propune compatibilitatea cu MIME (ceea ce nu aveam nevoie), și folosește o abordare ușor diferită în codificare. Eficiența sa nu am evaluat-o, dar mi se pare că probabil nu va fi mai bună decât SCSU.
Posibile îmbunătățiri
Algoritmul pe care l-am prezentat nu este universal prin design (în aceasta, probabil, obiectivele mele se deosebesc cel mai mult de cele ale Consorțiului Unicode). Am menționat deja că a fost dezvoltat în principal pentru o singură sarcină (stocarea unui dicționar multilingv în arbore prefixat), iar unele dintre trăsăturile sale pot fi mai puțin potrivite pentru alte sarcini. Dar, faptul că nu este un standard, poate fi chiar un avantaj — puteți să-l adaptați cu ușurință la nevoile dumneavoastră.
De exemplu, în mod evident, se poate elimina starea, făcând codificarea fără stare — pur și simplu nu actualizați variabilele excursii, auxOffs și is21Bit în encoder și decoder. În acest caz, nu va fi posibil să se comprime eficient secvențele de caractere dintr-un anumit alfabet, dar va exista garanția că același caracter este întotdeauna codificat cu aceleași octeți, indiferent de context.
În plus, se poate adapta codificatorul pentru o anumită limbă, schimbând starea implicită — de exemplu, orientându-se spre textele rusești, se pot seta la început encoderul și decoderul ofs = 0x0400 și auxOffs = 0. În special, are sens în cazul modului fără stare. În general, va fi asemănător cu utilizarea vechii codificări pe opt biți, doar că nu elimină posibilitatea de a insera caractere din întregul Unicode după necesitate.
O altă deficiență menționată anterior — în textul voluminos, codificat în UTF-C, nu există o modalitate rapidă de a găsi limita caracterului cea mai apropiată de un octet aleator. Tăind din bufferul codificat ultimele, să zicem, 100 de octeți, riscați să obțineți gunoi, cu care nu se poate face nimic. Stocarea jurnalele de câteva gigabytes nu este pentru care codificarea este gândită, dar în general aceasta poate fi corectată. Octetul 0xBF nu ar trebui să apară niciodată ca primul octet (dar poate fi al doilea sau al treilea). Așadar, în timpul codificării, se poate insera o secvență 0xBF 0xBF 0xBF la fiecare, să zicem, 10 Kb — atunci, la nevoie, pentru a găsi limita va fi suficient să scanați bucata aleasă până când se găsește un astfel de marcaj. Urmând ultimul 0xBF se va garanta începutul caracterului. (La decodare, această secvență de trei octeți trebuie, desigur, ignorată.)
În concluzie
Dacă ai citit până aici — te felicit! Sper că, la fel ca mine, ai învățat ceva nou (sau ai reîmprospătat lucruri mai vechi) despre structura Unicode.
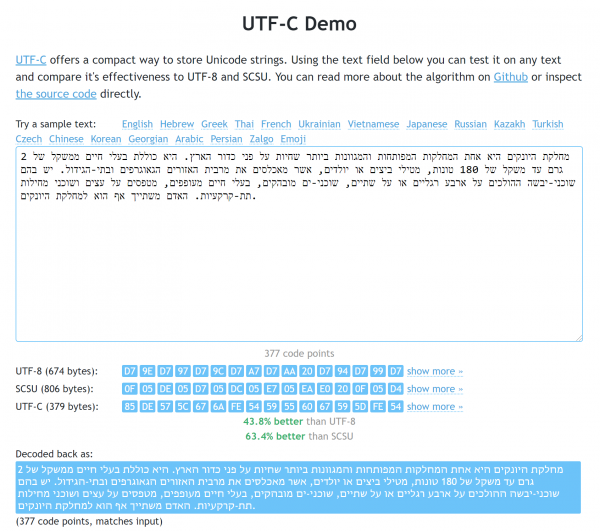
Pagina demonstrațională. Exemplul în ebraică evidențiază avantajele atât față de UTF-8, cât și față de SCSU.
Nu trebuie să consideri cercetările de mai sus ca o încălcare a standardelor. Totuși, sunt în general mulțumit de rezultatele muncii mele, așa că sunt bucuros să le : de exemplu, biblioteca JS în formă minificată are doar 1710 octeți (și, desigur, nu are dependențe). Așa cum am menționat mai sus, poți găsi informații despre utilizarea acesteia pe (acolo există și un set de texte cu care poate fi comparată cu UTF-8 și SCSU).
În final, voi mai sublinia încă o dată cazurile în care se poate utiliza UTF-C nu merită:
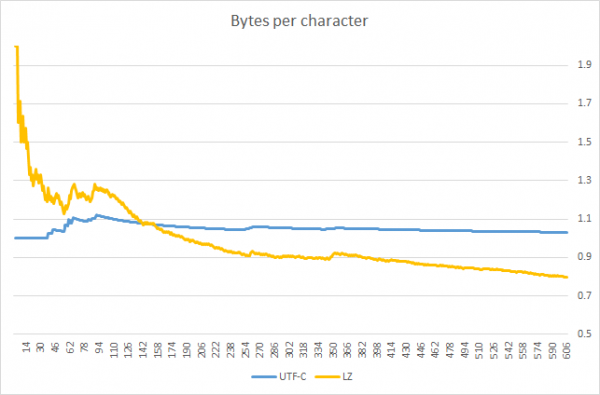
- Dacă șirurile tale sunt suficient de lungi (de la 100-200 de caractere). În acest caz, merită să te gândești la aplicarea algoritmilor de comprimare precum deflate.
- Dacă ai nevoie de transparenta ASCII, adică, este important pentru tine ca în secvențele codificate să nu apară coduri ASCII care nu au fost în șirul original. Poți evita aceste nevoi dacă, lucrând cu API-uri externe (de exemplu, când lucrezi cu baze de date), transmiți rezultatul codării ca un set abstract de octeți, nu ca șiruri. În caz contrar, riști să obții vulnerabilități neașteptate.
- Dacă dorești să ai capacitatea de a găsi rapid granițele caracterelor printr-o deplasare arbitrară (de exemplu, în cazul deteriorării unei părți din șir). Acest lucru se poate face, dar doar scanând șirul de la început (sau aplicând modificările descrise în secțiunea anterioară).
- Dacă ai nevoie de rapiditate în efectuarea operațiunilor asupra conținutului șirurilor (pentru a le sorta, a căuta subșiruri, a le concatena). Pentru aceasta, șirurile trebuie mai întâi decodificate, prin urmare, UTF-C va fi mai lent decât UTF-8 în aceste cazuri (dar mai rapid decât algoritmii de comprimare). Deoarece același șir este întotdeauna codificat în același mod, compararea exactă a decodării nu este necesară, aceasta putând fi efectuată pe octeți.
Actualizare: utilizator am publicat un grafic care subliniază limita de aplicare a UTF-C. Acesta arată că UTF-C este mai eficient decât algoritmul de compresie generică (variațiile LZW) până când stringul comprimat devine mai scurt ~140 de caractere (adevărat, voi menționa că comparația a fost realizată pe același text; pentru alte limbi, rezultatul poate diferi).
Sursa: habr.com
