

Astăzi, majoritatea produselor software sunt dezvoltate în echipe. Condițiile de succes ale dezvoltării de echipă pot fi reprezentate sub forma unei scheme simple.
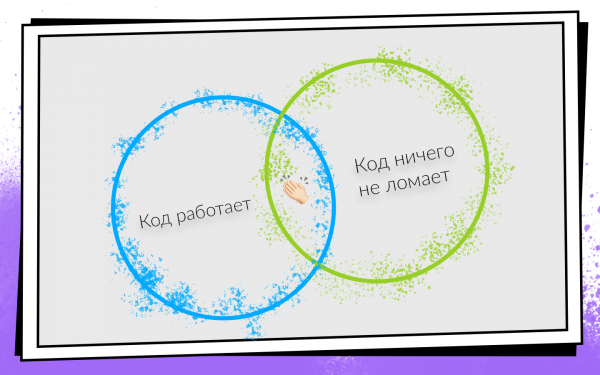
După ce ați scris codul, trebuie să vă asigurați că acesta:
- Funcționează.
- Nu rupe nimic, inclusiv codul scris de colegii dvs.
Dacă ambele condiții sunt îndeplinite, atunci sunteți pe drumul cel bun. Pentru a verifica cu ușurință aceste condiții și a nu devia de la calea profitabilă, a fost inventat Continuous Integration.
CI este un flux de lucru în care integrați codul dvs. în codul produsului cât mai des posibil. Și nu doar l integrați, ci verificați constant că totul funcționează. Deoarece trebuie să faceți multe teste frecvent, ar trebui să luați în considerare automatizarea. Puteți verifica totul manual, dar nu ar trebui, și iată de ce.
- Oamenii sunt costisitori. O oră de muncă a oricărui programator costă mai mult decât o oră de funcționare a oricărui server.
- Oamenii greșesc. De aceea pot apărea situații în care ați rulat testele pe o ramură greșită sau ați construit un commit greșit pentru testerii de software.
- Oamenii sunt leneși. Perioadele în care termin o sarcină, îmi apar în minte gânduri de genul: „Ce să verific aici? Am scris doar două linii – cu siguranță funcționează!” Cred că și unora dintre voi le trec astfel de gânduri prin minte. Dar trebuie să verificați întotdeauna.
Cum a fost implementat și dezvoltat Continuous Integration în echipa de dezvoltare mobilă Avito, cum au ajuns de la 0 la 450 de build-uri pe zi și ce mașini de build realizează 200 de ore de muncă pe zi, ne povestește Nikolai Nesterov () – participant la toate schimbările evolutive CI/CD ale aplicației Android.
Povestea este construită pe exemplul echipei Android, dar majoritatea abordărilor sunt aplicabile și pe iOS.
Cu mult timp în urmă, în echipa Android de la Avito lucra o singură persoană. Prin definiție, nu avea nevoie de nimic din Continuous Integration: nu se integra cu nimeni.
Dar aplicația creștea, apărea tot mai multe sarcini noi, astfel că echipa se mărea. La un moment dat, a venit vremea să se organizeze mai formal procesul de integrare a codului. S-a decis utilizarea Git flow.
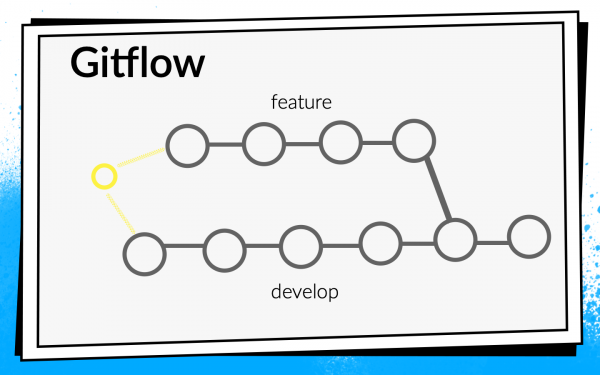
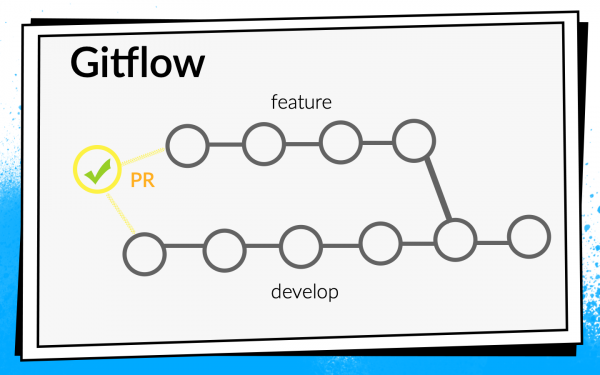
Conceptul Git flow este cunoscut: în proiect există un singur branch comun develop, iar pentru fiecare nouă funcționalitate, dezvoltatorii creează un branch separat, commit-ă în el, împing codul și, când doresc să integreze codul în branch-ul develop, deschid un pull request. Pentru schimbul de cunoștințe și discutarea abordărilor, am introdus code review, adică colegii trebuie să verifice și să confirme codul unii altora.
Verificări
A te uita la cod este grozav, dar nu este suficient. De aceea, se introduc verificări automate.
- În primul rând, verificăm build-ul ARC.
- Multe teste Junit.
- Calculăm code coverage, având în vedere că pornim testele.
Pentru a înțelege cum ar trebui să ruleze aceste verificări, să ne uităm la procesul de dezvoltare de la Avito.
Schematic, acesta poate fi reprezentat astfel:
- Dezvoltatorul scrie cod pe laptopul său. Poate rula verificările de integrare chiar aici — fie prin commit hook, fie pur și simplu rulând verificările în fundal.
- După ce dezvoltatorul a împins codul, deschide un pull request. Pentru ca codul să fie integrat în branch-ul develop, trebuie să treacă prin code review și să obțină suficiente aprobări. Verificările și build-urile pot fi activate aici: atâta timp cât nu toate build-urile sunt de succes, pull request-ul nu poate fi fuzionat.
- După ce pull request-ul a fost fuzionat și codul a intrat în develop, se poate alege un moment convenabil: de exemplu, noaptea, când toate serverele sunt libere, și să rulăm verificările cât mai mult posibil.
A rula verificările pe laptopul său nu a plăcut nimănui. Când dezvoltatorul a terminat funcționalitatea, vrea să o împingă cât mai repede și să deschidă un pull request. Dacă în acel moment se desfășoară niște verificări de lungă durată, nu este doar incomod, ci și încetinește dezvoltarea: atâta timp cât laptopul face verificări, nu este posibil să lucreze normal.
A rula verificările noaptea ne-a plăcut foarte mult, deoarece sunt multe timp și servere, putem să ne desfășurăm. Dar, din păcate, când codul funcționalității a intrat în develop, dezvoltatorul are mult mai puțină motivație să repare erorile găsite de CI. Periodic mă surprindeam privind raportul matinal la toate erorile găsite, gândindu-mă că le voi repara mai târziu, pentru că acum în Jira este o sarcină nouă grozavă pe care abia aștept să o încep.
Dacă verificările blochează pull request-ul, atunci motivația este suficientă, deoarece atâta timp cât build-urile nu sunt verzi, codul nu va ajunge în develop, iar, prin urmare, sarcina nu va fi finalizată.
În final, am ales această strategie: noaptea executăm cât mai multe teste posibil, iar cele mai critice dintre acestea, și cel mai important, cele rapide, le lansăm la pull request. Dar nu ne oprim aici — în paralel optimizăm viteza trecerii testelor pentru a le transforma din mod nocturn în teste pentru pull request.
La acel moment, toate construcțiile noastre treceau destul de repede, așa că am inclus pur și simplu construcția ARC, testele Junit și calculul acoperirii codului ca blocator la pull request. Am inclus, am reflectat — și ne-am răzgândit în legătură cu acoperirea codului, deoarece am considerat că nu avem nevoie de ea.
Configurația inițială a CI-ului ne-a luat două zile (aceasta și următoarele estimări de timp sunt aproximative, necesare pentru context).
După aceea, ne-am gândit mai departe — verificăm corect? Rulăm corect construcțiile la pull request?
Noi rulam construcția pe ultimul commit al ramurii din care a fost deschis pull request-ul. Dar testele acestui commit pot arăta doar că codul scris de dezvoltator funcționează. Dar ele nu demonstrează că n-a stricat nimic. De fapt, trebuie să verificăm starea ramurii develop după ce funcționalitatea a fost integrată.
Pentru aceasta, am scris un script bash simplu premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Aici sunt preluate cele mai recente modificări din develop și integrate în ramura curentă. Am adăugat scriptul premerge.sh ca primul pas în toate construcțiile și am început să verificăm exact ceea ce dorim, adică integrarea.
Pentru localizarea problemelor, găsirea soluțiilor și scrierea acestui script ne-au luat trei zile.
Aplicația evolua, apărând din ce în ce mai multe sarcini și echipa creștea, iar premerge.sh a început să ne facă uneori probleme. Modificările conflicting pătrundeau în develop, ceea ce rupea construcțiile.
Un exemplu despre cum se întâmplă acest lucru:
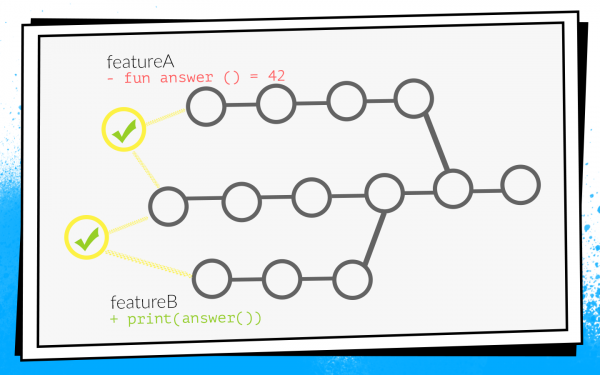
Doi dezvoltatori încep simultan să lucreze la funcționalitățile A și B. Dezvoltatorul funcționalității A descoperă într-o funcție nefolosită în proiect answer() și, ca un bun scout, o elimină. În același timp, dezvoltatorul funcționalității B adaugă un nou apel al acestei funcții în ramura sa.
Dezvoltatorii termină lucrul și deschid simultan pull request-uri. Se lansează construcțiile, premerge.sh verifică ambele pull request-uri în raport cu starea recentă a lui develop — toate verificările sunt verzi. După aceea, se face merge pe pull request-ul funcționalității A, se face merge pe pull request-ul funcționalității B… Bam! Develop se strică, deoarece în codul develop există un apel la o funcție care nu mai există.
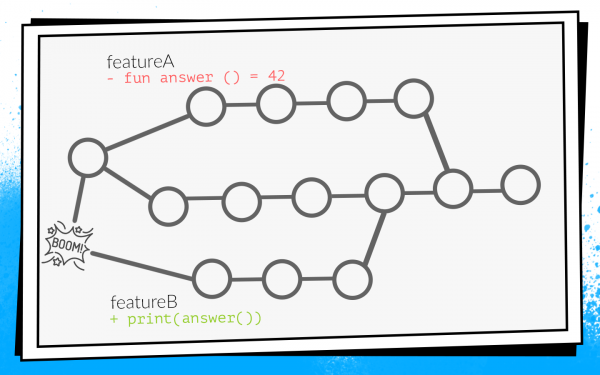
Când develop nu se compilează, aceasta catastrofă locală. Întreaga echipă nu poate aduna nimic și trimite la testare.
Așa s-a întâmplat că m-am ocupat cel mai des de sarcini de infrastructură: analiză, rețea, baze de date. Adică eu am scris acele funcții și clase pe care le folosesc alți dezvoltatori. Din acest motiv, m-am aflat foarte des în astfel de situații. Chiar aveam o imagine care era afișată o perioadă de timp.
Deoarece asta nu ne mulțumea, am început să analizăm opțiuni pentru a preveni asta.
Cum să nu stricăm develop
Prima opțiune: reconstruirea tuturor pull request-urilor la actualizarea develop. Dacă în exemplul nostru pull request-ul cu caracteristica A ajunge primul în develop, pull request-ul caracteristicii B va trebui reconstruit și, din acest motiv, verificările nu vor trece din cauza unei erori de compilare.
Pentru a înțelege cât timp va dura, să luăm un exemplu cu două PR-uri. Deschidem două PR-uri: două build-uri, două runde de verificări. După ce primul PR este fuzionat în develop, al doilea trebuie reconstruit. Așadar, pentru două PR-uri, avem trei runde de verificări: 2 + 1 = 3.
În principiu, este acceptabil. Dar ne-am uitat la statistică și situația tipică în echipa noastră era de 10 PR-uri deschise, iar atunci numărul de verificări ar fi suma progresiei: 10 + 9 +… + 1 = 55. Deci, pentru a accepta 10 PR-uri, trebuie reconstruit de 55 de ori. Și asta în situația ideală, când toate verificările trec din prima, iar nimeni nu deschide un alt pull request în timp ce se procesează acest grup de zece.
Imaginați-vă că sunteți dezvoltator și trebuie să reușiți să apăsați butonul „merge” primul, pentru că dacă o face vecinul, va trebui să așteptați până când toate build-urile trec din nou… Nu, așa nu merge, asta va încetini serios dezvoltarea.
A doua opțiune posibilă: să construim pull request-ul după revizuirea codului. Adică deschideți pull request-ul, obțineți numărul necesar de aprobat de la colegi, corectați ce trebuie, după care lansați build-urile. Dacă acestea sunt de succes, pull request-ul este fuzionat cu develop. În acest caz, nu sunt necesare reconstrucții suplimentare, dar feedback-ul este încetinit semnificativ. Eu, ca dezvoltator, deschizând un pull request, vreau să văd imediat dacă se construiește. De exemplu, dacă un test a picat, trebuie reparat rapid. În cazul unei construcții amânate, feedback-ul este încetinit, ceea ce înseamnă că întreaga dezvoltare este afectată. Asta nu ne mulțumea nici pe noi.
În cele din urmă, a rămas doar a treia opțiune — a bicicleta. Tot codul nostru, toate sursele noastre sunt stocate într-un repository pe serverul Bitbucket. Prin urmare, a trebuit să dezvoltăm un plugin pentru Bitbucket.
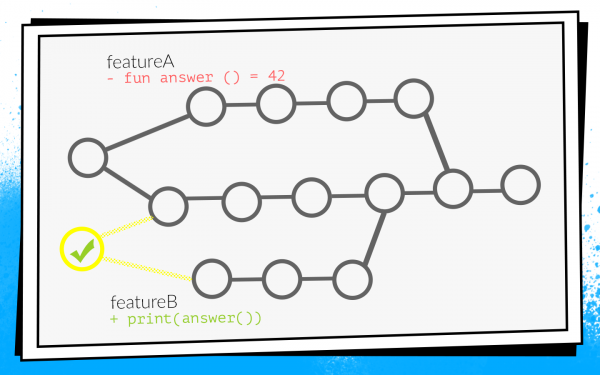
Acest plugin redefinește mecanismul de îmbinare a pull request-urilor. Procesul standard începe: se deschide un PR, se lansează toate build-urile, se desfășoară revizuirea codului. Dar după ce revizuirea codului este finalizată, iar dezvoltatorul decide să apese pe „merge”, pluginul verifică în raport cu ce stare a develop s-au rulat verificările. Dacă după build-uri develop s-a actualizat, pluginul nu va permite îmbinarea acelui pull request în ramura principală. Pur și simplu va reporni build-urile în raport cu develop-ul actualizat.
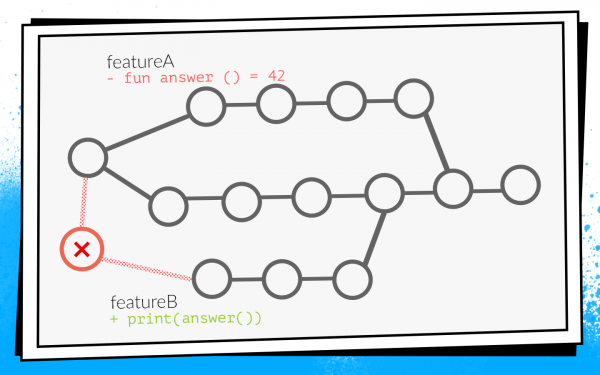
În exemplul nostru cu modificări conflictuale, aceste build-uri nu vor trece din cauza unei erori de compilare. Prin urmare, dezvoltatorul funcției B va trebui să corecteze codul, să repornească verificările, iar pluginul va aplica automat pull request-ul.
Înainte de implementarea acestui plugin, aveam în medie 2.7 lansări de verificări pentru un pull request. Cu pluginul, am ajuns la 3.6 lansări. Ne-am mulțumit cu aceasta.
Este de menționat că acest plugin are un dezavantaj: repornește build-ul doar o singură dată. Deci, tot rămâne o mică fereastră prin care modificări conflictuale pot ajunge în develop. Dar probabilitatea acestuia nu este mare, și am acceptat acest compromis între numărul de lansări și probabilitatea de a provoca o defecțiune. În două ani, a avut loc doar o singură dată, deci, probabil, nu degeaba.
Scrierea primei versiuni a pluginului pentru Bitbucket ne-a luat două săptămâni.
Verificări noi
Între timp, echipa noastră a continuat să crească. S-au adăugat noi verificări.
Ne-am gândit: de ce să reparăm erorile, când le putem preveni? Așa că am implementat statică a codului. Am început cu lint, care face parte din Android SDK. Dar în acea vreme nu funcționa deloc cu codul Kotlin, iar 75% din aplicație era deja scrisă în Kotlin. Așa că am adăugat la lint verificările încorporate din Android Studio.
Pentru aceasta, a fost necesar să ne îngrijim puțin: să luăm Android Studio, să o ambalăm în Docker și să o rulăm pe CI cu un monitor virtual, pentru ca aceasta să creadă că este rulată pe un laptop real. Dar a funcționat.
De asemenea, în această perioadă am început să scriem multe teste de instrumentație și am implementat testarea prin capturi de ecran.. Acesta este momentul în care se generează o captură de ecran de referință pentru o mică vizualizare separată, iar testul constă în a face o captură de ecran de pe vizualizare și a o compara pixel cu pixel cu referința. Dacă există abateri, înseamnă că designul s-a stricat în vreun fel sau că stilurile nu sunt corecte.
Dar testele de instrumentare și testele de captură de ecran trebuie să fie rulate pe dispozitive: pe emulatori sau pe dispozitive reale. Având în vedere că sunt multe teste și sunt rulate frecvent, este nevoie de o întreagă fermă. A înființa propria fermă este prea costisitor, așa că am găsit o opțiune gata făcută — Firebase Test Lab.
Firebase Test Lab
A fost ales pentru că Firebase este un produs Google, ceea ce înseamnă că ar trebui să fie de încredere și că este puțin probabil să dispară vreodată. Prețurile sunt accesibile: 5$ pe oră pentru utilizarea unui dispozitiv real, 1$ pe oră pentru utilizarea unui emulator.
Implementarea Firebase Test Lab în CI-ul nostru a durat aproximativ trei săptămâni.
Dar echipa a continuat să crească, iar Firebase, din păcate, a început să ne dezamăgească. La acel moment nu avea niciun SLA. Uneori Firebase ne făcea să așteptăm până când erau disponibile suficiente dispozitive pentru teste, și nu începea să le execute imediat, așa cum ne doream. Așteptarea în coadă dura până la jumătate de oră, iar asta este foarte mult. Testele de instrumentare erau rulate la fiecare PR, întârzierile încetineau foarte mult dezvoltarea, iar apoi a venit factura pe luna cu o sumă rotundă. În general, s-a decis să renunțăm la Firebase și să dezvoltăm intern, având în vedere că echipa a crescut destul de mult.
Docker + Python + bash
Am folosit docker, am bagat emulatorii în el, am scris un program simplu în Python care la momentul potrivit ridică numărul necesar de emulatori în versiunea dorită și când trebuie, îi oprește. Și, bineînțeles, câteva scripturi bash — cum altfel?
Crearea propriului mediu de testare a durat cinci săptămâni.
Ca urmare, pentru fiecare pull request existau o serie extinsă, blocantă a fuzionării, de verificări:
- Construirea ARC;
- Testele Junit;
- Lint;
- Verificările Android Studio;
- Teste de instrumentare;
- Teste de captură de ecran.
Acest lucru prevenea multe posibile defecte. Tehnic, totul funcționa, dar dezvoltatorii se plângeau că așteptarea rezultatelor durează prea mult.
Prea mult — cât de mult? Am extras datele din Bitbucket și TeamCity în sistemul de analiză și am realizat că timpul mediu de așteptare este de 45 de minute. Deci, dezvoltatorul, atunci când deschide un pull request, așteaptă în medie 45 de minute pentru rezultatele construcțiilor. Din punctul meu de vedere, acesta este foarte mult, și nu se poate lucra astfel.
Desigur, am decis să accelerăm toate construcțiile noastre.
Accelerăm
Observând că adesea build-urile așteptau, am decis mai întâi să adăugăm hardware — dezvoltarea extensivă este cea mai simplă. Build-urile nu mai așteaptă, dar timpul de așteptare a scăzut doar puțin, deoarece unele verificări durează foarte mult.
Eliminăm verificările prea lungi
CI-ul nostru poate să identifice astfel de tipuri de erori și probleme.
- Nu se compilează. CI poate prinde o eroare de compilare când din cauza modificărilor conflictuale ceva nu se compilează. Așa cum am spus deja, atunci nimeni nu poate să compileze nimic, dezvoltarea se oprește și toată lumea devine neliniștită.
- Bug în comportament. De exemplu, când aplicația se compilează, dar la apăsarea butonului se blochează, sau butonul nu răspunde deloc. Aceasta este o problemă serioasă, deoarece un astfel de bug poate ajunge la utilizator.
- Bug în design. De exemplu, butonul răspunde, dar s-a mutat cu 10 pixeli spre stânga.
- Creșterea datoriei tehnice.
Privind această listă, ne-am dat seama că doar primele două puncte sunt critice. Astfel de probleme dorim să le identificăm prioritare. Bug-urile în design sunt descoperite în etapa de revizuire a designului și atunci pot fi corectate ușor. Lucrul cu datoriile tehnice necesită un proces și o planificare separate, de aceea am decis să nu le verificăm în pull request.
Pe baza acestei clasificări, am revizuit întreaga listă de verificări. Am exclus Lint și am mutat rularea lui pe timpul nopții: doar pentru a emite un raport despre câte probleme sunt în proiect. Am decis să lucrăm separat cu datoria tehnică, iar ne-am abandonat complet verificările Android Studio. Android Studio în Docker pentru a rula inspecțiile sună interesant, dar oferă multe neplăceri în mentenanță. Orice actualizare a versiunilor Android Studio este o luptă cu bug-uri neclare. De asemenea, a fost dificil să menținem teste de screenshot, deoarece biblioteca nu funcționa foarte stabil, existau false alarme. Testele de screenshot au fost eliminate din lista de verificări.
În final, ne-au rămas:
- Construirea ARC;
- Testele Junit;
- Teste de instrumentație.
Cache-ul remote Gradle
Fără verificări grele, totul a devenit mai bine. Dar nu există limită pentru perfecțiune!
Aplicația noastră era deja împărțită în aproximativ 150 de module gradle. De obicei, în astfel de cazuri, cache-ul remote Gradle funcționează bine, așa că am decis să-l încercăm.
Gradle remote cache este un serviciu care poate stoca artefacte de construcție pentru sarcini specifice în module separate. Gradle, în loc să compileze efectiv codul, face o cerere HTTP la remote cache și întreabă dacă cineva a mai executat deja această sarcină. Dacă da, pur și simplu descarcă rezultatul.
Pornirea Gradle remote cache este ușoară, deoarece Gradle oferă o imagine Docker. Am reușit să facem asta în trei ore.
A fost suficient să pornim Docker și să adăugăm o linie în proiect. Dar, deși poate fi lansat rapid, pentru ca totul să funcționeze bine, va fi nevoie de ceva timp.
Mai jos este grafica privind ratele de rată a cache-ului.
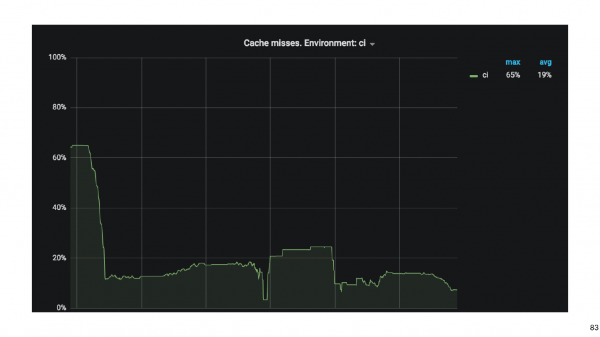
La început, procentul ratelor de rată a cache-ului era de aproximativ 65%. După trei săptămâni, am reușit să reducem această valoare la 20%. S-a dovedit că sarcinile pe care le compilează aplicația Android au dependențe tranzitive ciudate, din cauza cărora Gradle a ratat cache-ul.
Prin activarea cache-ului, am accelerat semnificativ construcția. Dar, în afară de construcție, se rulează și teste de instrumentare, care durează mult. Poate că nu toate testele trebuie rulate pentru fiecare pull request. Pentru a determina acest lucru, folosim analiza impactului.
Analiza impactului
Pe pull request, colectăm git diff și găsim modulele Gradle modificate.
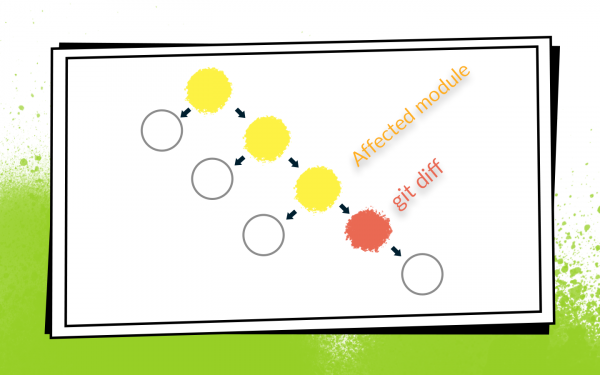
Are sens să rulăm doar testele de instrumentare care verifică modulele modificate și toate modulele care depind de acestea. Nu are sens să rulăm teste pentru modulele vecine: acolo codul nu s-a schimbat și nimic nu se poate defecta.
Cu testele de instrumentare lucrurile nu sunt atât de simple, deoarece ele trebuie să fie în modulul cel mai de sus Application. Am aplicat o euristică cu analiza bytecode-ului pentru a înțelege la ce modul se referă fiecare test.
Modernizarea funcționării testelor de instrumentare, astfel încât să verifice doar modulele implicate, a durat aproximativ opt săptămâni.
Măsurile de accelerare a verificărilor au fost eficiente. De la 45 de minute am ajuns la aproximativ 15. Așteptarea unui build timp de un sfert de oră este deja acceptabilă.
Dar acum dezvoltatorii au început să se plângă că nu este clar ce builds sunt lansate, unde pot vedea logurile, de ce build-ul este roșu, care test a picat etc.
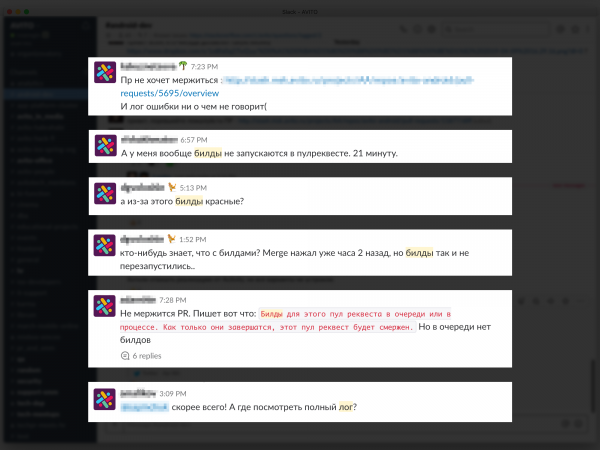
Problemele cu feedback-ul încetinesc dezvoltarea, așa că ne-am străduit să oferim cele mai clare și detaliate informații despre fiecare PR și build. Am început cu comentarii în Bitbucket pentru PR, specificând care build a picat și de ce, și am trimis mesaje pe Slack. În cele din urmă, am creat o pagină dashboard pentru PR cu o listă a tuturor build-urilor care sunt în curs de rulare și starea lor: în așteptare, în rulare, picat sau finalizat. Puteți face clic pe build pentru a accesa log-ul acestuia.
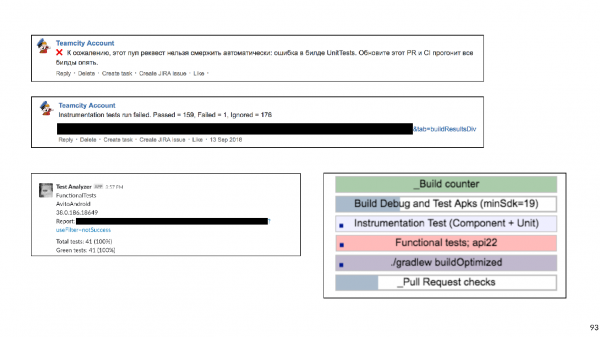
A fost necesară o perioadă de șase săptămâni pentru feedback detaliat.
Planuri
Să trecem la cele mai recente evenimente. Odată ce am rezolvat problema feedback-ului, am ajuns la un nou nivel — am decis să construim propria fermă de emulatori. Când sunt multe teste și emulatori, devine greu de gestionat. În cele din urmă, toate emulatorii noștri s-au mutat într-un cluster k8s cu gestionare flexibilă a resurselor.
În plus, avem și alte planuri.
- Restorarea Lint (și alte analize statice). Lucrăm deja în această direcție.
- Să rulăm toate testele end-to-end pe toate versiunile SDK.
Astfel, am urmărit dezvoltarea Continuous Integration în Avito. Acum vreau să ofer câteva sfaturi din perspectiva unui veteran.
Sfaturi
Dacă ar fi să dau doar un singur sfat, acesta ar fi:
Vă rog, fiți mai atenți cu scripturile shell!
Bash este un instrument foarte flexibil și puternic, este foarte convenabil și rapid pentru a scrie scripturi. Dar poate fi o capcană, și, din păcate, am căzut în ea.
Totul a început cu scripturi simple care erau rulate pe mașinile noastre de build:
#!/usr/bin/env bash
./gradlew assembleDebug
Dar, după cum se știe, totul se dezvoltă și devine mai complex — hai să rulăm un script din altul, hai să-i transmitem câteva parametrii — în cele din urmă, a trebuit să scriu o funcție care determină nivelul de imbricare bash în care ne aflăm, pentru a pune ghilimelele corecte ca să funcționeze totul.
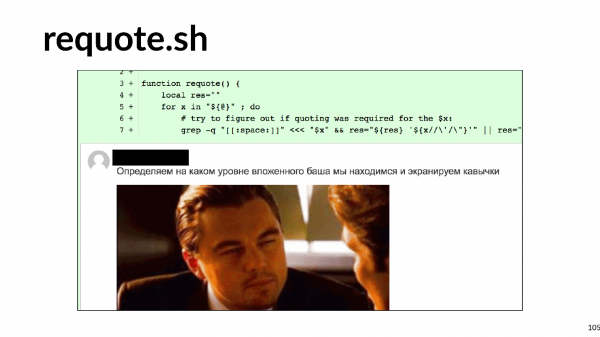
Îți poți imagina eforturile necesare pentru dezvoltarea unor astfel de scripturi. Îți recomand să nu cazi în această capcană.
Cu ce poate fi înlocuit?
- Orice limbaj de scriptare. Este mai convenabil să scrii în Python sau Kotlin Script pentru că este programare, nu scripturi.
- Sau poți descrie întreaga logică a build-urilor sub formă de sarci gradle personalizate pentru proiectul tău.
Am decis să alegem a doua opțiune și acum eliminăm sistematic toate scripturile bash și scriem multe sarcini gradle personalizate.
Sfat nr. 2: păstrați infrastructura în cod.
Este este convenabil când configurația Continuous Integration nu este stocată în interfața UI a Jenkins sau TeamCity, ci sub formă de fișiere text direct în depozitul proiectului. Acest lucru oferă versiune. Nu va fi greu să reveniți sau să compilați codul pe o altă ramură.
Scripturile pot fi stocate în proiect. Dar ce facem cu mediu?
Sfatul nr. 3: Docker poate ajuta cu mediu.
Cu siguranță le va fi de ajutor dezvoltatorilor Android, din păcate nu și celor de la iOS.
Acesta este un exemplu de fișier Docker simplu, care conține jdk și android-sdk:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Descarcă Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Instalează Android Build Tool și Biblioteci
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Am scris acest fișier docker (îți spun în secret, nu e nevoie să-l scrii, ci poți descărca unul gata de pe GitHub) și, construind imaginea, obții o mașină virtuală, pe care poți construi aplicația și rula teste Junit.
Cele două argumente principale pentru care are sens: scalabilitate și repetabilitate. Folosind Docker, poți ridica rapid o duzină de agenți de build, care vor avea exact același mediu ca și anteriorul. Acest lucru facilitează mult viața inginerilor CI. A integra android-sdk în Docker este foarte simplu, cu emulatorii este puțin mai complicat: va trebui să te străduiești puțin (sau, din nou, să descarci un exemplu de pe GitHub).
Sfatul nr. 4: nu uitați că verificările nu se fac pentru că sunt verificări, ci pentru oameni.
Dezvoltatorilor le este foarte important un feedback rapid și, mai ales, clar: ce s-a stricat, ce test a picat, unde să se uite în buildlog.
Sfatul nr. 5: fiți pragmatici în dezvoltarea Continuous Integration.
Înțelegeți clar ce tipuri de erori doriți să preveniți, cât sunteți dispuși să cheltuiți resurse, timp, timp de calcul. Verificările care durează prea mult pot fi, de exemplu, mutate pe timpul nopții. Iar de la cele care depistează erori mai puțin importante, puteți renunța complet.
Sfatul nr. 6: folosiți instrumente gata făcute.
Acum sunt multe companii care oferă CI în cloud.
Pentru echipe mici, acesta este un bun compromis. Nu trebuie să susțineți nimic, doar plătiți puțini bani, adunați-vă aplicația și chiar rulați teste de instrumentare.
Sfaturi №7: într-o echipă mare, soluțiile in-house sunt mai avantajoase.
Dar mai devreme sau mai târziu, pe măsură ce echipa crește, soluțiile in-house vor fi mai profitabile. Cu aceste soluții există un aspect. În economie există legea randamentelor în scădere: în orice proiect, fiecare îmbunătățire ulterioară devine din ce în ce mai dificilă și necesită tot mai multe investiții.
Economia descrie întreaga noastră viață, inclusiv Continuous Integration. Am construit un grafic al eforturilor necesare pentru fiecare etapă a dezvoltării Continuous Integration-ului nostru.
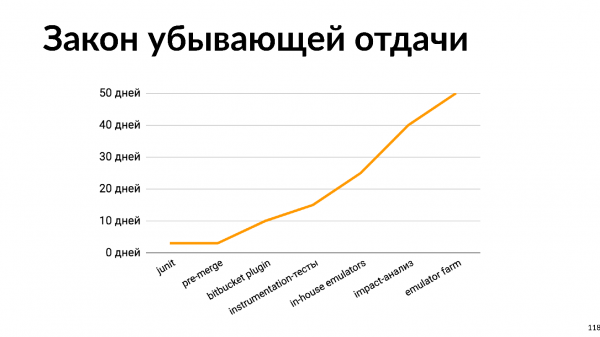
Se observă că orice îmbunătățire devine din ce în ce mai dificil de realizat. Privind acest grafic, putem înțelege că dezvoltarea Continuous Integration-ului trebuie să fie în conformitate cu creșterea dimensiunii echipei. Pentru o echipă de două persoane, a cheltui 50 de zile pentru a dezvolta o fermă internă de emulatoare este o idee proastă. Dar, pe de altă parte, pentru o echipă mare să nu se ocupe deloc de Continuous Integration este, de asemenea, o idee proastă, deoarece va dura și mai mult timp pentru a rezolva problemele de integrare, repararea comunicării etc.
Am început cu ideea că automatizarea este necesară, deoarece oamenii sunt costisitori, fac greșeli și sunt leneși. Dar și automatizarea este realizată de oameni. Prin urmare, toate aceste probleme se aplică și automatizării.
- Automatizarea este costisitoare. Amintiți-vă graficul eforturilor.
- Când automatizăm, oamenii fac greșeli.
- Uneori, este foarte greu să automatizezi, deoarece totul funcționează deja. De ce să îmbunătățim ceva? De ce toată această Continuous Integration?
Dar am statistici: în 20% din construcții sunt descoperite erori. Și asta nu se întâmplă pentru că dezvoltatorii noștri scriu cod prost. Se întâmplă pentru că dezvoltatorii sunt siguri că, dacă comit o greșeală, aceasta nu va ajunge în develop, va fi prinsă de verificările automatizate. Prin urmare, dezvoltatorii pot petrece mai mult timp scriind cod și lucruri interesante, în loc să verifice local.
Încercați Continuous Integration. Dar cu măsură.
Apropo, Nikolai Nesterov nu doar că face prezentări grozave, ci face parte și din comitetul de program și ajută pe alții să pregătească pentru voi prezentări de conținut. Completa și utilitatea programului următoarei conferințe pot fi evaluate după temele din . Iar pentru detalii veniți pe 22-23 aprilie în Infoprospăria.
Sursa: habr.com
