

Algoritmii RAID au fost prezentați publicului în 1987. Până în prezent rămân cea mai căutată tehnologie pentru protecția și accelerarea accesului la date în domeniul stocării informațiilor. Însă, vârsta tehnologiei IT, care a trecut de 30 de ani, reprezintă mai degrabă o bătrânețe decât o maturitate. Motivul este progresul, care aduce în mod inexorabil noi oportunități. În vremurile când practic nu existau alte medii de stocare în afară de HDD-uri, algoritmii RAID permiteau utilizarea celor disponibile în cel mai eficient mod. Totuși, odată cu apariția SSD-urilor, situația s-a schimbat radical. Acum, RAID, atunci când lucrează cu unități de stocare cu stare solidă, devine o „strangulare” pentru performanța acestora. Prin urmare, pentru a dezvălui întregul potențial al caracteristicilor de viteză ale SSD-urilor, este necesar un alt mod de abordare în utilizarea acestora.
Pe lângă diferențele evidente între HDD și SSD în ceea ce privește principiile de funcționare, aceste tipuri de suporturi au și o altă caracteristică importantă: orice hard disk poate rescrie orice date cu o granularitate de un singur bloc (aceasta fiind acum cel mai frecvent 4KB). Pentru SSD-uri, procesul de rescriere este o procedură mult mai complexă:
- Datele modificate sunt copiate într-o nouă locație. Granularitatea este aceeași, dar blocul este compus din mai multe pagini și are o dimensiune între 256KB și 4MB. Adică, la modificarea celor 4KB trebuie să se copieze și toate paginile vecine care formează un bloc unit.
- Blocurile „vechi” sunt marcate ca neutilizate, pentru a fi șterse ulterior de colectorul de deșeuri (Garbage Collector).
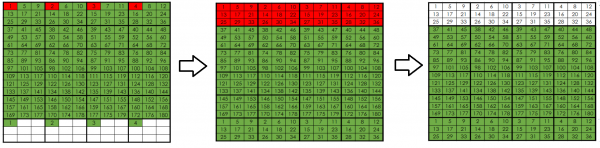
Scrierea/scrierea secvențială pe SSD
În cazul scrierii/scrierii secvențiale, această specificitate a funcționării SSD-ului nu joacă un rol semnificativ în ceea ce privește performanța sa, fiindcă blocurile sunt plasate aproape unul de altul, iar colectorul de deșeuri își face treaba destul de bine în fundal. Însă, în viața reală, mai ales în segmentul Enterprise, SSD-urile sunt de cele mai multe ori utilizate pentru accesul aleatoriu la date. Iar aceste date sunt scrise în locuri aleatorii pe unitățile de stocare.
Cu cât mai multe date sunt scrise pe SSD, cu atât mai greu devine pentru colectorul de „gunoi” să funcționeze, deoarece fragmentarea crește semnificativ. Ca urmare, ajunge un moment în care procesul de curățare a unității nu mai este „în fundal”: performanța SSD-ului scade considerabil, deoarece o parte semnificativă din ea este preluată de Garbage Collector.
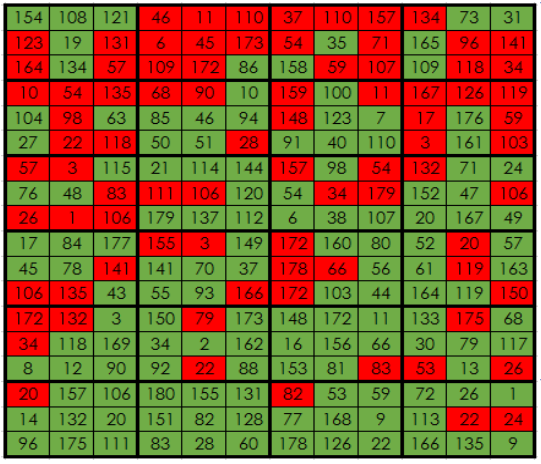
Locația reală a datelor pe SSD în utilizarea de zi cu zi
Pentru a ilustra efectul influenței funcționării colectorului de „gunoi” în funcție de modul de scriere pe unitate, se pot efectua teste simple: scriere secvențială și aleatorie cu blocuri de 4KB pe o unitate de 100GB. (Sursa – compania )
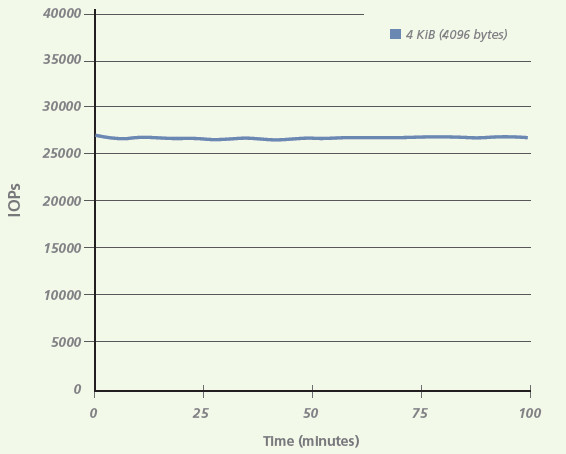
Performanța în scriere secvențială
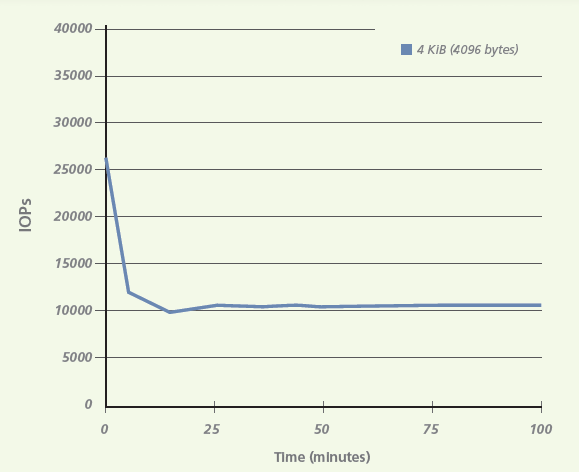
Performanța în scriere aleatorie
După cum se poate observa din teste, scăderea performanței poate depăși de două ori. Și aceasta este doar o unitate unică. În cazul utilizării SSD-urilor în cadrul unui grup RAID, numărul de operațiuni de rescriere crește semnificativ, datorită lucrului cu parity.
În general, datorită acestor caracteristici de funcționare a SSD-urilor, există un parametru, numit coeficient de scriere (write amplification). Acesta este raportul dintre volumul de date scrise pe unitate și volumul de date pe care, de fapt, l-a trimis gazda. Și pentru cel mai popular RAID5, acest coeficient este de aproximativ ~3.5.
Ca urmare, sistemele cu RAID clasic, în esență, utilizează SSD-urile doar cu ~10% din viteza lor reală și se scalează slab în ceea ce privește performanța pe măsură ce numărul de unități crește peste zece.
De asemenea, menționăm că operațiile redundante de scriere nu doar că reduc performanța SSD-ului, dar și scad resursa sa care nu este deloc infinită, reducând astfel durata de viață a unității.
, care este nucleul tuturor produselor AccelStor, a fost dezvoltată ca o alternativă la algoritmii clasici RAID în utilizarea SSD-urilor. Inovativitatea tehnologiei este recunoscută prin diverse brevete și premii (inclusiv la Flash Memory Summit 2016), dar și prin rezultatele testelor independente (de exemplu, SPC1).
Esenta constă în transformarea tuturor solicitărilor de scriere primite, și în principal a celor de tip random, într-un set de blocuri, cât mai asemănător cu modul de scriere secvențial din punct de vedere al unității de stocare. Ca urmare, scrierea pe SSD se realizează în modul cel mai confortabil pentru acestea, iar performanța finală depășește orice sistem cu RAID clasic.
Toate SSD-urile din sistemele AccelStor sunt împărțite în două grupuri simetrice FlexiRemap®. Dimensiunea grupului depinde de model și variază între 5 și 11 unități de stocare. Pentru redundanță, în cadrul grupului se aplică paritate similară cu RAID5. Ambele grupuri sunt utilizate împreună, formând un spațiu comun de stocare. Prin urmare, rezistența finală la defecte va fi similară cu un RAID50 format din două grupuri: sistemul este capabil să reziste la defectarea a până la două SSD-uri, dar nu mai mult de unul în fiecare grup FlexiRemap®.
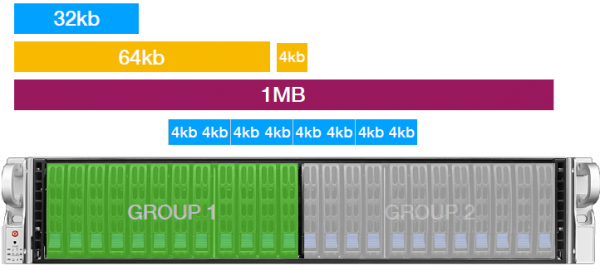
Toate solicitările de scriere primite sunt împărțite în blocuri de 4KB, care sunt scrise în mod round robin pe ambele grupuri FlexiRemap®. În același timp, sistemul ține constant evidența cererii blocurilor scrise, încercând, în cazul în care sunt modificate, să scrie blocurile similare cât mai aproape unul de celălalt. Se obține un analog virtual al tiering-ului, dacă ne exprimăm în termenii unui sistem de stocare. În acest caz, activitatea colectorului de „gunoi” este semnificativ ușurată: deoarece blocurile neutilizate vor fi mereu aproape unul de celălalt.
Merită menționat că spre deosebire de produsele concurenților, nu utilizează funcționalitatea de cache pentru solicitările primite în memoria RAM a controlerului. Toate blocurile de date primite sunt imediat scrise pe SSD. Gazda primește confirmarea unei scrieri de succes doar după plasarea fizică a datelor pe unitățile de stocare. În RAM sunt păstrate doar tablouri de plasare a blocurilor pe SSD pentru a accelera accesul și a determina unde să scrie următorul bloc de date. Desigur, pentru fiabilitate, copii ale acestor tablouri sunt localizate și pe unitățile de stocare. Ca rezultat, sistemele AccelStor nu necesită nicio protecție a cache-ului sub formă de baterie/condenzator (totuși, există posibilitatea de a se conecta la un UPS – pentru o oprire „blândă” în caz de probleme cu alimentarea).
Datorită unui astfel de mod de organizare a scrierii, colectorul de „deșeuri” este capabil să funcționeze în fundal, fără a avea un impact semnificativ asupra vitezei unităților, ceea ce permite, în cele din urmă, reciclarea a până la 90% din performanța SSD în cadrul sistemului. Acestea sunt motivațiile din spatele valorilor ridicate IOPS în sistemele AccelStor, în comparație cu All Flash, care se bazează pe algoritmi RAID.
De asemenea, o caracteristică importantă a tehnologiei FlexiRemap® este reducerea semnificativă a operațiunilor excesive de scriere pe SSD. Astfel, coeficientul de scriere (write amplification) pentru sistemele AccelStor este de doar 1.3, ceea ce, tradus în termeni comuni, înseamnă o creștere a duratei de viață a unităților de peste 2.5 ori în comparație cu RAID5!
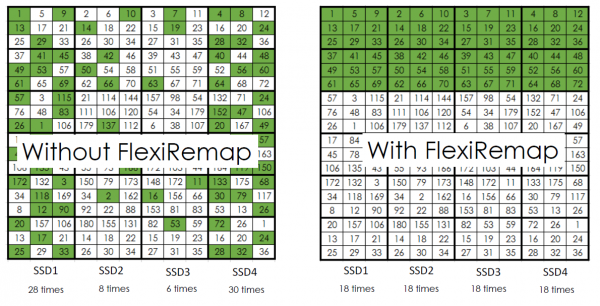
Datorită controlului constant din partea sistemului asupra politicii de distribuire a datelor pe SSD, toate unitățile se uzează uniform. Această abordare permite prognozarea duratei de viață a acestora și avertizarea administratorului cu privire la epuizarea resurselor de scriere.
Este evident că SSD-urile pot ceda. În acest caz, sistemul va începe imediat rebuild-ul pe unul dintre discurile hot spare. Grupul FlexiRemap®, aflat în stare degraded, trece în modul „doar citire”, iar toate cererile de scriere sunt direcționate către cel de-al doilea grup. Acest mecanism de protecție este conceput pentru a accelera operația de rebuild și a reduce probabilitatea de a pierde încă o unitate în cadrul aceluiași grup. Nu este un secret că, în timpul rebuild-ului, toate unitățile din grup suportă o încărcare crescută din cauza interferențelor între operațiile de citire, scriere și recuperare pe hot spare. Astfel, crește probabilitatea avarierii unei alte unități. Și cu cât sunt mai multe operații de scriere, cu atât mai mult va dura rebuild-ul.
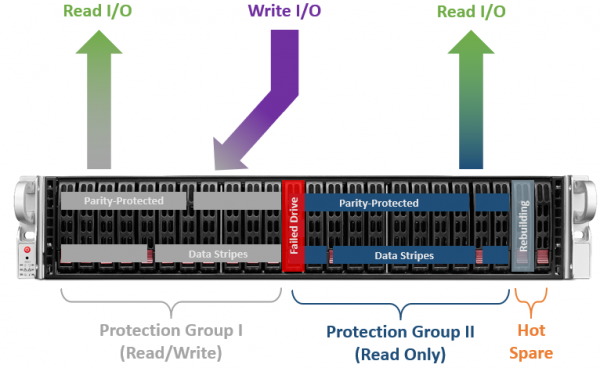
După finalizarea procesului de recuperare și returnarea grupului FlexiRemap® la starea normală, va apărea o mică asimetrie în resursa de scriere între cele două grupuri. Prin urmare, pentru a o echilibra, operațiile de scriere ulterioare vor avea loc mai frecvent în grupul recuperat (bineînțeles, astfel încât performanța finală a sistemului să nu aibă de suferit).
Creșterea performanței sistemelor All Flash bazate pe algoritmi RAID peste anumite valori (~280K IOPS@4K scriere aleatorie) nu este posibilă nici măcar cu utilizarea sistemelor complexe de caching. Tehnologia FlexiRemap®, datorită unei abordări complet diferite în organizarea spațiului de stocare, nu doar că depășește cu ușurință această barieră, dar și îmbunătățește considerabil durata de viață a SSD-urilor. Așadar, sistemele au avantaje semnificative în rândul masivelor All Flash pe multe fronturi (IOPS/$, GB/$, TCO, ROI), făcându-le candidați ideali pentru poziții cheie în centrele de date ale clienților pentru a rezolva sarcini intensive din punct de vedere al resurselor.
Sursa: habr.com
