

În zilele noastre, nu putem imagina un proiect bazat pe Kubernetes fără stiva ELK, care păstrează logurile atât pentru aplicații, cât și pentru componentele sistemului din cluster. În practica noastră, folosim stiva EFK cu Fluentd în loc de Logstash.
Fluentd este un colector de loguri modern, versatil, care câștigă din ce în ce mai multă popularitate și a aderat la Cloud Native Computing Foundation, motiv pentru care direcția sa de dezvoltare este orientată către utilizarea împreună cu Kubernetes.
Faptul că se folosește Fluentd în loc de Logstash nu schimbă esența generală a complexului de programe, totuși, Fluentd are propriile nuanțe specifice, care decurg din multifuncționalitatea sa.
De exemplu, începând să folosim EFK într-un proiect intens, cu un volum mare de scriere a logurilor, ne-am confruntat cu problema că în Kibana unele mesaje sunt afișate de mai multe ori. În acest articol, vă vom explica de ce apare acest fenomen și cum să rezolvăm problema.
Problema duplicării documentelor
În proiectele noastre, Fluentd este implementat ca DaemonSet (se pornește automat în câte un exemplar pe fiecare nod al clusterului Kubernetes) și monitorizează logurile stdout ale containerelor în /var/log/containers. După colectare și procesare, logurile sunt trimise în ElasticSearch, ridicat în mod cluster sau standalone, în funcție de dimensiunea proiectului și cerințele de performanță și redundanță. Ca interfață grafică se folosește Kibana.
Când am folosit Fluentd cu pluginul de buffer pe ieșire, ne-am confruntat cu situația în care unele documente din ElasticSearch au același conținut și se deosebesc doar prin identificator. Puteți verifica dacă este vorba despre un mesaj duplicat, luând ca exemplu logul Nginx. În fișierul de log, acest mesaj există într-un singur exemplar:
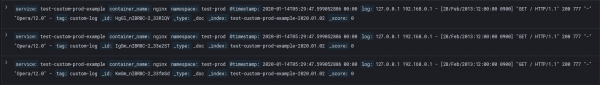
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Cu toate acestea, în ElasticSearch există mai multe documente care conțin acest mesaj:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}
În plus, pot exista mai mult de două repetiții.
În timpul detectării acestei probleme, în log-urile Fluentd se pot observa numeroase avertismente de următorul tip:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] nu s-a reușit golirea buffer-ului. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="nu s-au putut trimite logurile la cluster-ul Elasticsearch ({:host=>\"elasticsearch\", :port=>9200, :scheme=>\"http\", :user=>\"elastic\", :password=>\"obfuscated\"}): timpul de citire a fost depășit"Aceste avertismente apar atunci când ElasticSearch nu poate returna un răspuns la cerere în intervalul de timp stabilit prin parametru request_timeout, ceea ce face ca porțiunea de buffer trimisă să nu poată fi golită. După aceea, Fluentd încearcă din nou să trimită porțiunea de buffer către ElasticSearch, iar după un număr arbitrar de încercări, operațiunea are succes:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] reîncercarea a reușit. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] reîncercarea a reușit. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] reîncercarea a reușit. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] reîncercarea a reușit. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] reîncercarea a reușit. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Cu toate acestea, ElasticSearch consideră fiecare dintre fragmentele de buffer retrimise ca fiind unice și le atribuie valori unice pentru câmpurile _id la indexare. Astfel, apar copiile mesajelor.
În Kibana, aceasta arată astfel:
Rezolvarea problemei
Există mai multe opțiuni pentru a rezolva această problemă. Una dintre ele este mecanismul de generare a unui hash unic pentru fiecare document, încorporat în pluginul fluent-plugin-elasticsearch. Dacă se folosește acest mecanism, ElasticSearch va recunoaște duplicatele în etapa de transmitere și nu va permite duplicarea documentelor. Totuși, este important de menționat că această soluție abordează efectul și nu rezolvă eroarea legată de lipsa unui timeout, motiv pentru care ne-am decis să nu o aplicăm.
Folosim un plugin de buffer la ieșirea Fluentd pentru a preveni pierderea logurilor în cazul unor probleme temporare de rețea sau a unei intensificări a scrierii logurilor. Dacă, din diverse motive, ElasticSearch nu poate înregistra imediat un document în index, documentul ajunge într-o coadă, care este stocată pe disc. Prin urmare, în cazul nostru, pentru a aborda sursa problemei care duce la apariția erorii menționate mai sus, este necesar să se stabilească valori corecte ale parametrilor de bufferizare, astfel încât bufferul de ieșire al Fluentd să aibă un volum suficient și să aibă timp să se golească în intervalul de timp alocat.
Merită menționat faptul că valorile parametrilor despre care se va discuta mai jos sunt individuale pentru fiecare caz specific de utilizare a bufferizării în pluginurile de ieșire, deoarece depind de mulți factori: intensitatea scrierii mesajelor de log de către servicii, performanța sistemului de stocare, încărcarea canalului de rețea și capacitatea sa de transmitere. Prin urmare, pentru a obține setările de buffer potrivite pentru fiecare caz în parte, fără a relua procesul de ajustare într-o manieră aleatorie, se poate folosi informația de depanare pe care Fluentd o scrie în logfile-ul său pe parcursul funcționării, obținând rapid valori corecte.
La momentul în care problema a fost identificată, configurația arăta după cum urmează:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
În cadrul soluționării problemei, au fost selectate manual valorile următorilor parametri:
chunk_limit_size — dimensiunea bucatelor în care sunt împărțite mesajele în buffer.
- flush_interval — intervalul de timp după care are loc curățarea buffer-ului.
- queue_limit_length — numărul maxim de fragmente din coadă.
- request_timeout — timpul de conectare între Fluentd și ElasticSearch.
Dimensiunea totală a buffer-ului poate fi calculată înmulțind parametrii queue_limit_length și chunk_limit_size, ceea ce se poate interpreta ca «numărul maxim de fragmente din coadă, fiecare având un volum specificat». Dacă dimensiunea buffer-ului este insuficientă, în loguri va apărea următorul avertisment:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] failed to write data into buffer by buffer overflow action=:blockAceasta înseamnă că buffer-ul nu reușește să se curețe în timp util, iar datele care ajung în buffer-ul plin sunt blocate, ceea ce va duce la pierderea unei părți din loguri.
Buffer-ul poate fi mărit în două moduri: fie prin creșterea dimensiunii fiecărui fragment din coadă, fie prin creșterea numărului de fragmente care pot fi în coadă.
Dacă se setează dimensiunea fragmentului chunk_limit_size la mai mult de 32 megabaiți, ElasticSearch nu îl va accepta, deoarece pachetul de intrare va fi prea mare. Prin urmare, dacă este necesară o mărire suplimentară a buffer-ului, este mai bine să se crească lungimea maximă a cozii queue_limit_length.
Când buffer-ul nu va mai fi supraaglomerat și va rămâne doar un mesaj despre lipsa timpului de așteptare, se poate începe să se mărească parametru request_timeout. Totuși, la setarea unei valori mai mari de 20 de secunde, în logurile Fluentd vor începe să apară următoarele avertismente:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] buffer flush took longer time than slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Acest mesaj nu afectează în niciun fel funcționarea sistemului și înseamnă că timpul de curățare a buffer-ului a durat mai mult decât este stabilit de parametrul slow_flush_log_threshold. Aceasta este informație de depanare și o folosim în ajustarea valorii parametrului request_timeout.
Algoritmul general de ajustare arată astfel:
- Setați valoarea request_timeout garantat mai mare decât necesar (sute de secunde). În timp ce se configurează, principalul criteriu de corectitudine al acestui parametru va fi dispariția avertismentelor legate de lipsa timpului de așteptare.
- Așteptați mesajele care indică depășirea pragului slow_flush_log_threshold. În textul avertismentului, în câmpul elapsed_time va fi scris timpul real de curățare a buffer-ului.
- Set the request_timeout value higher than the maximum elapsed_time value obtained during the observation period. We calculate the request_timeout value as elapsed_time + 50%.
- To remove warnings about long buffer flushing from the log, you can increase the slow_flush_log_threshold value. We calculate this value as elapsed_time + 25%.
The final values of these parameters, as mentioned earlier, are individual for each case. By following the algorithm outlined above, we can reliably eliminate the error that causes message duplication.
The table below shows how the number of errors per day that lead to message duplication changes as the values of the above parameters are adjusted:
node-1
node-2
node-3
node-4
Before/After
Before/After
Before/After
Before/After
failed to flush the buffer
1749/2
694/2
47/0
1121/2
retry succeeded
410/2
205/1
24/0
241/2
It is also worth noting that the obtained settings may lose their relevance as the project grows and, consequently, the log volume increases. A primary indication of insufficient timeout settings is the return of messages about long buffer flushing in the Fluentd log, indicating that the slow_flush_log_threshold has been exceeded. At this point, there is still a small buffer before exceeding the request_timeout parameter, so it is necessary to respond promptly to these messages and repeat the optimization process described above.
Concluzie
Fine-tuning the Fluentd output buffer is one of the key stages in configuring the EFK stack, determining its operational stability and the correct placement of documents in indices. Based on the described tuning algorithm, you can be confident that all logs will be recorded in the ElasticSearch index in the correct order, without duplicates or losses.
Citiți și alte articole de pe blogul nostru:
Sursa: habr.com
