

Comanda oferă inginerul Rahul Bhatia de la Clairvoyant despre ce formate de fișiere există în big data, care sunt cele mai comune funcții ale formatelor Hadoop și care format este cel mai potrivit.
De ce sunt necesare diferite formate de fișiere
O problemă serioasă în performanța aplicațiilor care suportă HDFS, cum ar fi MapReduce și Spark, este timpul de căutare, citire și scriere a datelor. Aceste probleme sunt agravate de dificultățile de gestionare a unor seturi mari de date, dacă nu avem un schemă fixă, ci una evolutivă, sau există anumite restricții de stocare.
Prelucrarea big data crește sarcina asupra subsistemului de stocare - Hadoop stochează date în mod redundant pentru a asigura fiabilitatea. Pe lângă discuri, sunt suprasolicitate procesorul, rețeaua, sistemul de intrare-ieșire și așa mai departe. Pe măsură ce volumul de date crește, costul procesării și stocării acestora se intensifică.
Diversele formate de fișiere în sunt concepute pentru a rezolva exact aceste probleme. Alegerea unui format de fișier adecvat poate aduce unele avantaje semnificative:
- Timp de citire mai rapid.
- Timp de scriere mai rapid.
- Fișiere partajabile.
- Suport pentru evoluția schemelor.
- Suport extins pentru compresie.
Unele formate de fișiere sunt destinate uzului general, altele pentru variante mai specifice, iar unele sunt dezvoltate având în vedere caracteristici specifice ale datelor. Astfel, alegerea este într-adevăr destul de mare.
Formatul de fișier Avro
Pentru serializarea datelor este utilizat pe scară largă - acesta este un format de stocare a datelor bazat pe rânduri, adică un format de tip rând în Hadoop. Acesta stochează schema în format JSON, facilitând citirea și interpretarea acesteia de către orice program. Datele în sine sunt stocate într-un format binar, compact și eficient.
Sistemul de serializare Avro este neutră la limbaj. Fișierele pot fi prelucrate în diferite limbaje, în prezent fiind C, C++, C#, Java, Python și Ruby.
O caracteristică cheie a Avro este suportul solid pentru scheme de date care se schimbă în timp, adică evoluează. Avro înțelege modificările de schemă - eliminarea, adăugarea sau modificarea câmpurilor.
Avro suportă structurii de date diverse. De exemplu, se poate crea un înregistrare care conține un tablou, un tip enumerat și un sub-înregistrare.
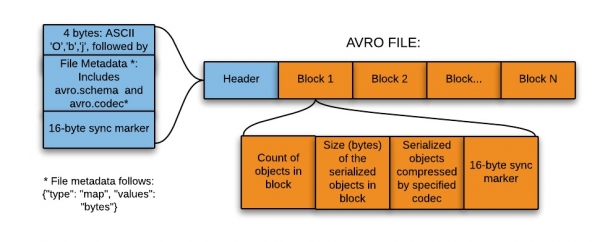
Acest format este ideal pentru scrierea în zona de aterizare (transitional) a lacului de date (, sau data lake – o colecție de instanțe pentru stocarea diferitelor tipuri de date în completarea surselor de date).
Așadar, pentru a scrie în zona de landing a lacului de date, acest format este cel mai potrivit din următoarele motive:
- Datele din această zonă sunt de obicei citite integral pentru procesare ulterioară de către sistemele inferioare – iar formatul bazat pe șiruri este mai eficient în acest caz.
- Sistemele inferioare pot extrage cu ușurință schemele tabelare din fișiere – nu este nevoie să stocheze schemele separat într-un depozit extern de metadate.
- Orice modificare a schemei sursă este ușor de gestionat (evoluția schemei).
Formatul fișierelor Parquet
Parquet este un format de fișier open-source pentru Hadoop, care stochează structuri de date imbricate într-un format plat, coloană..
Comparativ cu abordarea tradițională bazată pe șiruri, Parquet este mai eficient din punct de vedere al stocării și performanței.
Aceasta este deosebit de utilă pentru interogările care citesc anumite coloane dintr-un tabel larg (cu multe coloane). Datorită formatului fișierelor, sunt citite doar coloanele necesare, astfel încât intrările și ieșirile sunt reduse la minimum.
O mică explicație suplimentară: pentru a înțelege mai bine formatul fișierului Parquet în Hadoop, să vedem ce înseamnă un format bazat pe coloane – adică un format coloanal. Într-un astfel de format, valorile de aceeași tip sunt stocate împreună pentru fiecare coloană.
, înregistrarea include câmpurile ID, Nume și Departament. În acest caz, toate valorile coloanei ID vor fi stocate împreună, la fel și valorile coloanei Nume și așa mai departe. Tabelul va arăta aproximativ așa:
ID
Name
Departament
1
emp1
d1
2
emp2
d2
3
emp3
d3
În formatul pe șiruri, datele vor fi stocate astfel:
1
emp1
d1
2
emp2
d2
3
emp3
d3
În formatul coloanei, aceleași date vor fi stocate astfel:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Formatul coloană este mai eficient când trebuie să interoghezi mai multe coloane dintr-un tabel. Acesta va citi doar coloanele necesare pentru că sunt adiacente. Astfel, operațiunile de intrare-ieșire sunt reduse la minimum.
De exemplu, ai nevoie doar de coloana NUME. În fiecare înregistrare din setul de date trebuie să fie încărcată, analizată pe câmpuri și apoi datele NUME extrase. Formatul coloanei permite accesarea directă a coloanei Nume, deoarece toate valorile pentru această coloană sunt stocate împreună. Nu va fi necesară scanarea întregii înregistrări.
Astfel, formatul columnar îmbunătățește performanța interogărilor, deoarece timpul de căutare pentru a accesa coloanele dorite este mai scurt, reducând numărul operațiunilor de intrare-ieșire, deoarece doar coloanele necesare sunt citite.
Una dintre caracteristicile unice constă în faptul că în acest format poate stoca date cu structuri înnesterate.Aceasta înseamnă că în fișierul Parquet, chiar și câmpurile înnesterate pot fi citite separat, fără a fi necesară citirea tuturor câmpurilor din structura înnesterată. Pentru a stoca structuri înnesterate, Parquet folosește un algoritm de fragmentare și asamblare.
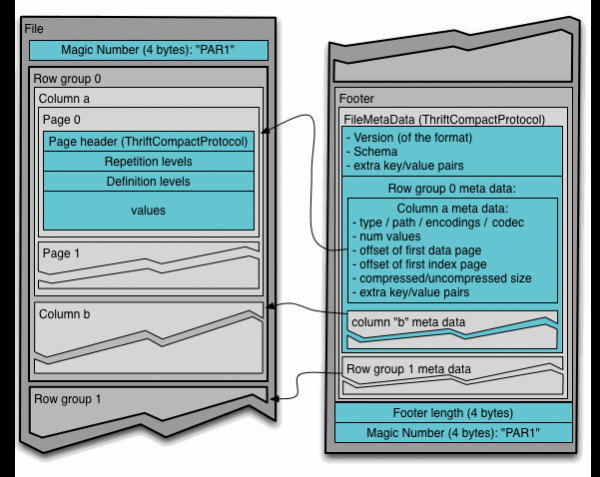
Pentru a înțelege formatul fișierului Parquet în Hadoop, este necesar să cunoașteți următorii termeni:
- Grup de rânduri (row group): o diviziune logică orizontală a datelor în rânduri. Grupul de rânduri constă dintr-un fragment al fiecărei coloane din setul de date.
- Fragment de coloană (column chunk): un fragment al unei coloane specifice. Aceste fragmente de coloane trăiesc într-un grup de rânduri specific și vor fi garantat adiacente în fișier.
- Pagina (page): fragmentele de coloane sunt împărțite în pagini, scrise una după alta. Paginile au un header comun, astfel că la citire se pot sări cele inutile.
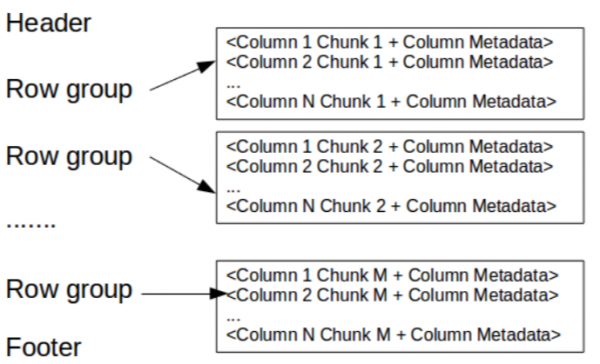
Aici, headerul conține pur și simplu un număr magic PAR1 (4 octeți), care identifică fișierul ca fiind de format Parquet.
În footer este scris următoarele:
- Metadatele fișierului, care conțin coordonatele de start ale metadatelor fiecărei coloane. La citire, trebuie mai întâi să se citească metadatele fișierului pentru a găsi toate fragmentele de coloane relevante. Apoi, fragmentele de coloane ar trebui citite secvențial. De asemenea, metadatele includ versiunea formatului, schema și orice alte perechi cheie-valoare suplimentare.
- Lungimea metadatelor (4 octeți).
- Numărul magic PAR1 (4 octeți).
Formatul fișierelor ORC
Formatul fișierelor optimizat pe rând și coloană (Optimized Row Columnar, ) oferă un mod foarte eficient de stocare a datelor și a fost dezvoltat pentru a depăși limitările altor formate. Stochează datele într-o formă perfect compactă, permițând sări peste detalii inutile — fără a necesita construirea de indecși mari, complecși sau gestionați manual.
Avantajele formatului ORC:
- Un fișier la ieșirea fiecărei sarcini, ceea ce reduce încărcătura pe NameNode (nodul de nume).
- Suport pentru tipurile de date Hive, inclusiv DateTime, tipuri de date zecimale și complexe (struct, listă, mapă și uniune).
- Citirea simultană a aceluiași fișier de către diferite procese RecordReader.
- Capacitatea de a diviza fișiere fără a scana pentru marcaje.
- Evaluarea alocării maxime posibile a memoriei heap pentru procesele de citire/scriere, conform informațiilor din footer-ul fișierului.
- Metadatele sunt stocate în format binar de serializare Protocol Buffers, care permite adăugarea și eliminarea câmpurilor.
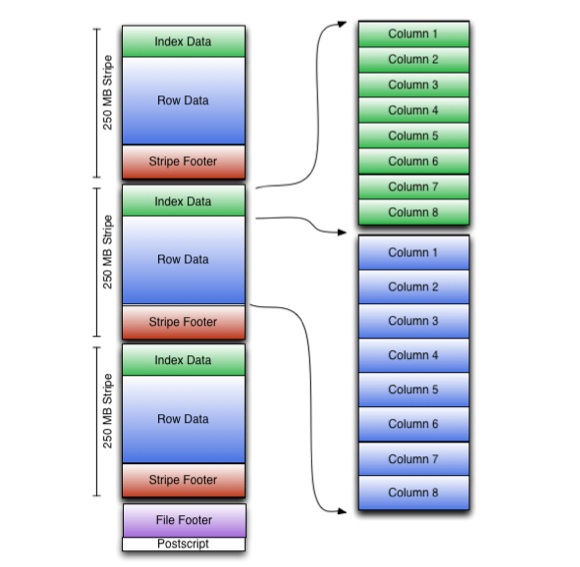
ORC stochează colecții de rânduri într-un singur fișier, iar datele de tip rând din cadrul colecției sunt stocate în format columnar.
Fișierul ORC stochează grupuri de rânduri denumite dungi (stripes) și informații auxiliare în footer-ul fișierului. Postscriptul de la sfârșitul fișierului conține parametrii de comprimare și dimensiunea footer-ului comprimat.
Prin default, dimensiunea unei dungi este de 250 MB. Datorită dimensiunii mari a dungilor, citirea din HDFS se efectuează mai eficient: în blocuri mari și continue.
În footer-ul fișierului este listată o listă de dungi din fișier, numărul de rânduri pe dungă și tipul de date pentru fiecare coloană. De asemenea, sunt înregistrate valorile rezultate count, min, max și sum pentru fiecare coloană.
Footer-ul dungi conține un catalog al locațiilor fluxului.
Datele de tip rând sunt folosite la scanarea tabelilor.
Datele de index includ valorile minime și maxime pentru fiecare coloană și pozițiile rândurilor din fiecare coloană. Indicele ORC este utilizat doar pentru selectarea dungilor și grupurilor de rânduri, nu pentru răspunsurile la interogări.
Comparația între diferite formate de fișiere
Avro comparativ cu Parquet
- Avro este un format de stocare pe baza rândurilor, în timp ce Parquet stochează datele pe baza coloanelor.
- Parquet este mai potrivit pentru interogările analitice, adică operațiunile de citire și interogare a datelor sunt mult mai eficiente decât cele de scriere.
- Operațiunile de scriere în Avro se realizează mai eficient decât în Parquet.
- Avro funcționează mai bine cu evoluția schemelor. Parquet suportă doar adăugarea de scheme, în timp ce Avro implementează o evoluție multifuncțională, adică adăugarea sau modificarea coloanelor.
- Parquet este ideal pentru interogarea unui subansamblu de coloane într-un tabel multi-coloană. Avro este potrivit pentru operațiunile ETL, unde solicităm toate coloanele.
ORC comparativ cu Parquet
- Parquet stochează mai bine datele imbricate.
- ORC este mai adaptat pentru împingerea predicatelor (predicate pushdown).
- ORC suportă proprietăți ACID.
- ORC comprimă mai bine datele.
What else to read on the topic:
- .
- .
- .
Sursa: habr.com
