

Bună, cititori ai Habr. Cu acest articol deschidem un ciclu care va vorbi despre sistemul nostru hiperconvergent AERODISK vAIR. Inițial, am vrut ca prima noastră articol să fie o prezentare completă, dar sistemul este destul de complex, așa că vom aborda subiectul pas cu pas.
Vom începe povestea cu istoria creării sistemului, vom explora sistemul de fișiere ARDFS, care stă la baza vAIR, și vom discuta puțin despre poziționarea acestei soluții pe piața din România.
În articolele viitoare, vom detalia diferitele componente arhitecturale (cluster, hypervisor, load balancer, sistem de monitorizare etc.), procesul de configurare, vom aborda întrebările legate de licențiere, vom prezenta teste de stres și, desigur, vom scrie despre testarea performanței și dimensionarea. De asemenea, vom dedica un articol versiunii community a vAIR.
AERODISK este oare o poveste despre stocare? Sau de ce am început să ne ocupăm de hiperconvergență?
Inițial, ideea de a crea propria soluție hiperconvergentă ne-a venit în jurul anului 2010. Atunci nu existau încă AERODISK sau soluții similare (sisteme hiperconvergente comerciale) pe piață. Sarcina noastră era următoarea: dintr-un set de servere cu discuri locale, interconectate prin protocol Ethernet, trebuia să realizăm un stocare distribuită și să rulăm acolo mașini virtuale și o rețea software. Totul trebuia implementat fără soluții de stocare (deoarece nu aveam buget pentru un astfel de sistem, iar propria soluție de stocare nu o inventasem încă).
Am încercat multe soluții open source și, în cele din urmă, am rezolvat această sarcină, dar soluția a fost foarte complexă și greu de reprodus. În plus, această soluție era de tipul „Funcționează? Nu o atinge!”. Prin urmare, după ce am rezolvat problema, nu am continuat să dezvoltăm ideea de a transforma rezultatul muncii noastre într-un produs complet.
După acel incident, am abandonat această idee, dar ne-a rămas în minte senzația că această sarcină este complet realizabilă și că beneficiile unei astfel de soluții sunt mai mult decât evidente. Ulterior, produsele HCI lansate de companii străine au confirmat această senzație.
Prin urmare, în mijlocul anului 2016, ne-am întors la această sarcină în cadrul creării unui produs complet. Atunci nu aveam niciun fel de relații cu investitorii, așa că a fost necesar să cumpărăm standul de dezvoltare din banii noștri destul de puțini. După ce am căutat servere second-hand și switch-uri pe Avito, ne-am apucat de treabă.
Principala sarcină inițială a fost să creăm propriul nostru sistem de fișiere, chiar dacă simplu, dar care să poată distribui automat și uniform datele sub formă de blocuri virtuale pe un număr n de noduri ale clusterei, care sunt conectate prin interconectare Ethernet. În același timp, sistemul de fișiere trebuie să fie bine și ușor scalabil și să fie independent de sistemele învecinate, adică să fie disociabil de vAIR sub forma unei „simple stocări”.
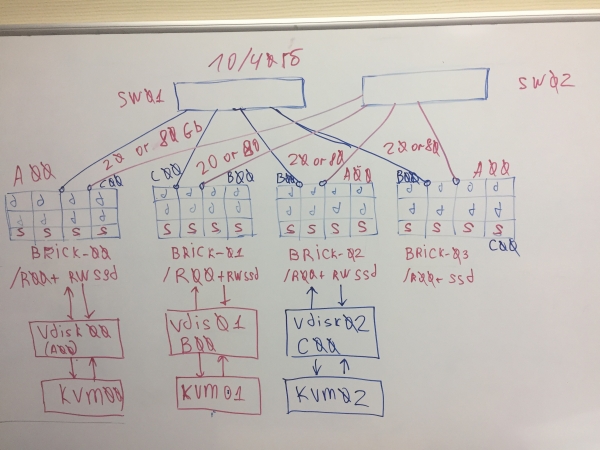
Prima conceptie vAIR
Am renunțat intenționat la utilizarea soluțiilor open source gata făcute pentru organizarea unui depozit distribuit (ceph, gluster, lustre și similare) în favoarea dezvoltării noastre proprii, deoarece aveam deja multă experiență de proiectare cu ele. Fără îndoială, aceste soluții sunt excelente în sine, iar până la lucrările asupra Aerodisc-ului am realizat cu ele nu unul, ci mai multe proiecte de integrare. Dar este un lucru să implementezi o sarcină specifică pentru un client, să instruiți personalul și, poate, să cumpărați suport de la un mare furnizor, și cu totul altceva este să creați un produs ușor reproducibil, care va fi utilizat pentru sarcini diferite, pe care poate nici măcar noi, ca furnizor, nu le vom cunoaște. Pentru a doua sarcină, produsele open source existente nu ne-au fost potrivite, așa că am decis să ne dezvoltăm noi sistemul de fișiere distribuit.
După doi ani, cu ajutorul câtorva dezvoltatori (care combinau activitatea pe vAIR cu munca asupra sistemului de stocare clasic Engine) am obținut un rezultat concret.
Până în 2018, am scris un sistem de fișiere simplu și l-am completat cu legăturile necesare. Sistemul combina prin interconectarea internă discuri fizice (locale) de pe diferite servere într-un singur pool plat și le „tăia” în blocuri virtuale, iar din blocurile virtuale erau create dispozitive bloc cu un anumit grad de rezistență la defecțiuni, pe care, cu ajutorul hipervizorului KVM, erau create și rulate mașini virtuale.
Nu ne-am complicat prea mult cu numele sistemului de fișiere și l-am numit simplu ARDFS (ghiciți ce înseamnă))
Acest prototip arăta bine (nu vizual, desigur, nu existau încă aspecte vizuale) și arăta rezultate bune în ceea ce privește performanța și scalabilitatea. După prima realizare reală, am dat start acestui proiect, organizând deja un mediu complet de dezvoltare și o echipă separată care s-a ocupat doar de vAIR.
Exact atunci s-a maturizat arhitectura generală a soluției, care nu a suferit modificări semnificative până în prezent.
Să ne adâncim în sistemul de fișiere ARDFS
ARDFS este baza vAIR, care oferă stocare distribuită și tolerantă la defecțiuni a datelor întregului cluster. Una dintre (dar nu singura) caracteristicile distincte ale ARDFS este că nu utilizează aditivi serverelor dedicate sub metă și management. A fost gândită astfel de la început pentru a simplifica configurarea soluției și pentru fiabilitatea acesteia.
Structura de stocare
În cadrul tuturor nodurilor clusterului, ARDFS organizează un pool logic din tot spațiul de stocare disponibil. Este important de înțeles că un pool nu reprezintă datele și nici un spațiu formatat, ci este pur și simplu o marcare, adică orice nod cu vAIR instalat, atunci când este adăugat la cluster, este automat inclus în pool-ul comun ARDFS, iar resursele de stocare devin automat comune pentru întregul cluster (și disponibile pentru stocarea viitoare a datelor). Această abordare permitem adăugarea și eliminarea rapidă a nodurilor fără a afecta semnificativ sistemul deja funcțional. Asta înseamnă că sistemul este foarte ușor de scalat „cu cărămizi”, adăugând sau eliminând noduri în cluster după necesitate.
Deasupra pool-ului ARDFS sunt adăugate discuri virtuale (obiecte de stocare pentru virtuale), care sunt construite din blocuri virtuale de 4 megabytes. Pe discurile virtuale sunt stocate datele propriu-zise. La nivelul discurilor virtuale se stabilește de asemenea schema de toleranță la defecțiuni.
Așa cum ați putea ghici, pentru reziliența subsistemului de stocare, nu folosim conceptul RAID (Redundant array of independent Disks), ci RAIN (Redundant array of independent Nodes). Asta înseamnă că reziliența este măsurată, automatizată și gestionată pe baza nodurilor, nu a discurilor. Desigur, discurile sunt de asemenea obiecte de stocare, ele, la fel ca tot restul, sunt monitorizate și cu ele se pot efectua toate operațiunile standard, inclusiv construirea unui RAID hardware local, dar clusterul operează la nivel de noduri.
În situația în care doriți cu adevărat RAID (de exemplu, un scenariu care suportă multiple defecțiuni pe clustere mici), nimic nu împiedică utilizarea controlerelor RAID locale, iar deasupra să se construiască un stocaj extins și o arhitectură RAIN. Acest scenariu este destul de viabil și este suportat de noi, așa că vom vorbi despre el în articolul despre scenariile tipice de utilizare a vAIR.
Scheme de reziliență a stocării
Există două scheme de reziliență a discurilor virtuale în vAIR:
1) Factor de replicare sau pur și simplu replicare – această metodă de reziliență este simplă «ca un băț și o frânghie». Se efectuează replicarea sincronă între noduri cu un factor de 2 (2 copii pe cluster) sau 3 (3 copii, respectiv). RF-2 permite discului virtual să reziste la defecțiunea unei noduri în cluster, dar „consumă” jumătate din volumul util, iar RF-3 va rezista la defecția a 2 noduri în cluster, dar va rezerva deja 2/3 din volumul util pentru propriile nevoi. Această schemă seamănă foarte mult cu RAID-1, adică discul virtual configurat în RF-2 este rezistent la defecția oricărei noduri din cluster. În acest caz, datele vor fi în regulă și chiar intrarea-ieșirea nu se va opri. Când nodul căzut revine în funcțiune, va începe restaurarea/sincronizarea automată a datelor.
Mai jos sunt exemple de distribuție a datelor RF-2 și RF-3 în mod normal și în situații de defecțiuni.
Avem o mașină virtuală cu 8 MB de date unice (utile), care funcționează pe 4 noduri vAIR. Este clar că, în realitate, un volum atât de mic este puțin probabil, dar pentru schema care reflectă logica de funcționare a ARDFS, acest exemplu este cel mai clar. AB - sunt blocuri virtuale de 4 MB conținând date unice ale mașinii virtuale. La RF-2, se creează două copii ale acestor blocuri A1+A2 și B1+B2, respectiv. Aceste blocuri sunt „distribuite” pe noduri, evitând suprapunerea acelorași date pe un singur nod, adică copia A1 nu va fi pe același nod cu copia A2. La fel pentru B1 și B2.
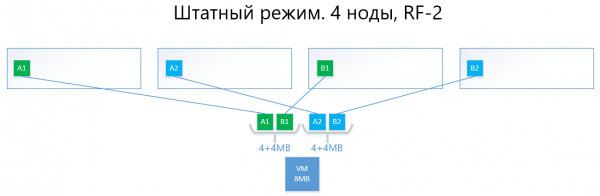
În cazul în care unul dintre noduri (de exemplu, nodul Nr. 3, unde se află copia B1) eșuează, această copie se activează automat pe nodul unde nu există copia sa (adică copia B2).
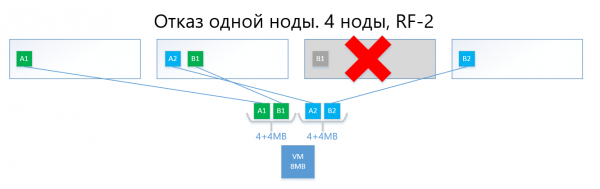
Astfel, discul virtual (și VM-ul, respectiv) va face față cu ușurință eșecului unui nod în schema RF-2.
Schema cu replicare, în ciuda simplității și fiabilității sale, suferă de aceeași problemă ca și RAID1 - puțin spațiu util.
2) Codificarea erorilor sau codificarea de ștergere (cunoscută și sub numele de „codificare redundantă”, „codificare de ștergere” sau „cod de redundanță”) există tocmai pentru a rezolva problema de mai sus. EC - este o schemă de redundanță care asigură o disponibilitate ridicată a datelor, cu cheltuieli mai mici de spațiu pe disc comparativ cu replicarea. Principiul de funcționare al acestui mecanism este similar cu RAID 5, 6, 6P.
În timpul codificării, procesul EC împarte un bloc virtual (în mod implicit 4 MB) în mai multe „bucăți de date” mai mici, în funcție de schema EC (de exemplu, schema 2+1 împarte fiecare bloc de 4 MB în 2 bucăți de 2 MB). În plus, acest proces generează pentru „bucățile de date” „bucăți de paritate” de dimensiune maximă egală cu una dintre părțile anterior împărțite. La decodare, EC generează bucățile lipsă citind datele „supraviețuitoare” din întregul cluster.
De exemplu, un disc virtual cu schema EC 2 + 1, implementat pe 4 noduri ale clusterului, va face față cu ușurință eșecului unui nod din cluster, la fel ca și RF-2. În același timp, cheltuielile vor fi mai mici, în special coeficientul de utilizare utilă la RF-2 este 2, iar la EC 2+1 va fi 1,5.
Pentru a explica mai simplu, esența constă în faptul că un bloc virtual este împărțit în 2-8 (de ce de la 2 la 8, vezi mai jos) „bucăți”, iar pentru aceste bucăți se calculează „bucăți” de paritate de volum similar.
În final, datele și paritatea sunt distribuite uniform pe toate nodurile clusterului. Totodată, ca și în cazul replicării, ARDFS distribuie automat datele pe noduri într-un mod care să prevină stocarea acelorași date (copia datelor și paritatea acestora) pe un singur nod, pentru a excluede riscul de pierdere a datelor din cauza faptului că datele și paritatea lor se află brusc pe un singur nod de stocare care ar putea să se defecteze.
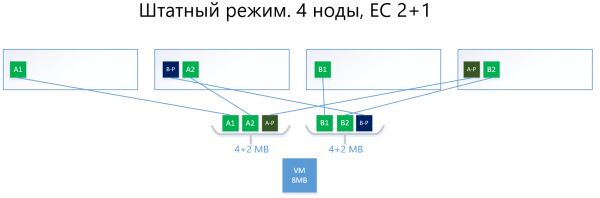
Mai jos este un exemplu, folosind aceeași mașină virtuală de 8 MB și 4 noduri, dar deja cu schema EC 2+1.
Blocurile A și B sunt împărțite în două bucăți fiecare de câte 2 MB (în două deoarece 2+1), adică A1+A2 și B1+B2. Spre deosebire de replicat, A1 nu este o copie a lui A2, ci un bloc virtual A, împărțit în două părți, la fel și blocul B. Așadar, avem două seturi de câte 4 MB, fiecare având câte două bucăți de două megabyte. Apoi, pentru fiecare dintre aceste seturi se calculează paritatea, cu o dimensiune de maximum o bucată (adică 2 MB), adăugând astfel 2 bucăți de paritate (A-P și B-P). În total, avem 4×2 date + 2×2 paritate.
Apoi, bucățile sunt „împrăștiate” pe noduri astfel încât datele să nu se intersecteze cu paritatea lor. Adică A1 și A2 nu vor coexista pe același nod cu A-P.
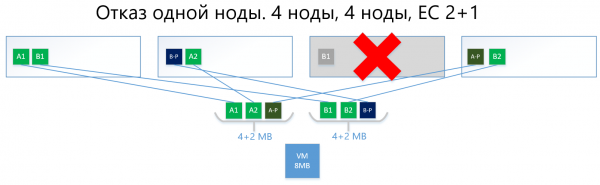
În cazul unei defecțiuni a unui nod (să zicem, al treilea), blocul căzut B1 va fi restaurat automat din paritatea B-P, care este stocată pe nodul nr. 2, și va fi activat pe nodul unde nu există paritatea B, adică B-P. În acest exemplu, acesta este nodul nr. 1.
Sunt sigur că cititorului îi apare întrebarea:
„Tot ce ați descris este deja implementat de concurenți și în soluții open source, care este diferența implementării dvs. EC în ARDFS?”
Apoi, vor urma trăsături interesante ale funcționării ARDFS.
Codificarea erorilor cu un accent pe flexibilitate
Inițial, am prevăzut un sistem EC X+Y destul de flexibil, unde X este un număr de la 2 la 8, iar Y este un număr de la 1 la 8, dar întotdeauna mai mic sau egal cu X. Acest sistem este destinat flexibilității. Creșterea numărului de bucăți de date (X) în care se împarte un blok virtual permite reducerea costurilor generale, adică creșterea spațiului util.
Creșterea numărului de bucăți de paritate (Y) crește fiabilitatea discului virtual. Cu cât valoarea lui Y este mai mare, cu atât mai multe noduri din cluster pot ieși din funcțiune. Evident, creșterea volumului de paritate reduce capacitatea utilă, dar acestea sunt costurile pentru fiabilitate.
Dependența performanței de schemele EC este aproape directă: cu cât sunt mai multe „bucăți”, cu atât performanța este mai scăzută; aici, este evident că este nevoie de o viziune echilibrată.
Această abordare le permite administratorilor să configureze în mod flexibil stocarea extinsă. În cadrul grupului ARDFS se pot folosi orice scheme de redundanță și combinațiile acestora, ceea ce, de asemenea, considerăm foarte util.
Mai jos se află un tabel de comparare a mai multor scheme RF și EC (dar nu toate posibile).
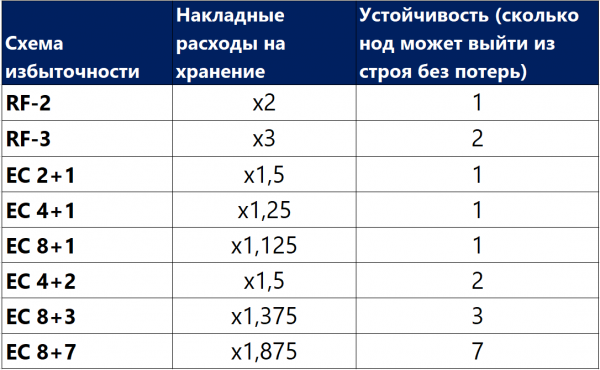
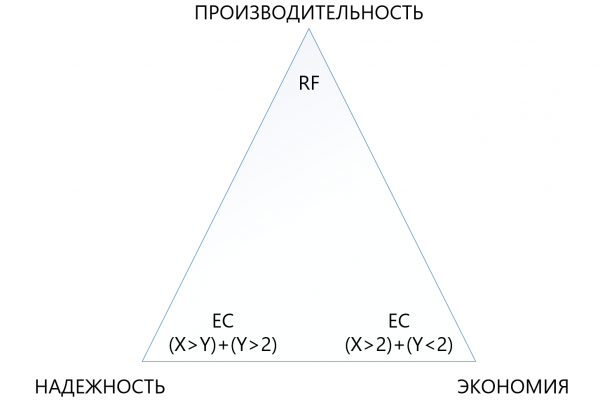
Din tabel se poate observa că chiar și cea mai „extremă” combinație EC 8+7, care permite pierderea simultană a până la 7 noduri din cluster, „consumă” mai puțin spațiu util (1,875 față de 2) decât replicarea standard, dar protejează de 7 ori mai bine, ceea ce face ca acest mecanism de protecție să fie, deși mai complex, semnificativ mai atractiv în situațiile în care trebuie asigurată o fiabilitate maximă în condiții de spațiu de stocare insuficient. În același timp, trebuie înțeles că fiecare „plus” la X sau Y va reprezenta un cost suplimentar pentru performanță, așa că în triunghiul dintre fiabilitate, economisire și performanță, trebuie să alegi cu foarte mare atenție. Din acest motiv, o articolă separată va fi dedicată dimensionării codificării de îndepărtare.
Fiabilitatea și autonomia sistemului de fișiere
ARDFS rulează local pe toate nodurile clusterului și le sincronizează prin propriile sale mijloace prin intermediul unor interfețe Ethernet dedicate. Un aspect important este că ARDFS sincronizează nu doar datele, ci și meta-datele aferente stocării. În cursul lucrărilor la ARDFS, am studiat în paralel o serie de soluții existente și am descoperit că multe sincronizează meta-datele sistemului de fișiere printr-o DB distribuită externă, pe care o folosim și noi pentru sincronizare, dar doar a configurațiilor, nu a meta-datelor FS (despre aceasta și alte subsisteme conexe în articolul următor).
Sincronizarea metadatelor FS cu ajutorul unei SGBD externe este, desigur, o soluție funcțională, dar atunci consistența datelor stocate pe ARDFS ar depinde de SGBD-ul extern și comportamentul său (iar acesta, să fim sinceri, este destul de capricios), ceea ce, în opinia noastră, este un aspect negativ. De ce? Dacă metadatele FS se vor deteriora, datele FS ar trebui, de asemenea, să spună „adio”, așa că am decis să optăm pentru o cale mai complexă, dar mai sigură.
Subsystema de sincronizare a metadatelor pentru ARDFS a fost realizată de noi, trăind complet independent de subsistemele învecinate. Adică, niciun alt subsistem nu poate afecta datele ARDFS. În opinia noastră, aceasta este cea mai sigură și corectă cale, iar dacă este sau nu așa, timpul va arăta. În plus, cu această abordare apare un avantaj suplimentar. ARDFS poate fi utilizat independent de vAIR, pur și simplu ca un depozit extins, ceea ce cu siguranță vom folosi în produsele viitoare.
În cele din urmă, dezvoltând ARDFS, am obținut un sistem de fișiere flexibil și fiabil, care oferă opțiuni pentru economisirea capacității sau maximizarea performanței sau pentru a crea un stocaj extrem de fiabil la un cost moderat, dar cu cerințe mai puțin exigente în ceea ce privește performanța.
Împreună cu o politică de licențiere simplă și un model de livrare flexibil (pentru a anticipa, licența vAIR este bazată pe noduri, iar livrarea se face fie prin software, fie ca PAK), acest lucru permite o adaptare foarte precisă a soluției la cele mai diverse cerințe ale clienților și, ulterior, întreținerea ușoară a acestui echilibru.
Cui îi trebuie această minune?
Pe de o parte, s-ar putea spune că pe piață există deja jucători cu soluții serioase în domeniul hiperconvergent și de ce ne-am băga, de fapt, aici. Se pare că această afirmație este adevărată, DAR...
Pe de altă parte, ieșind „în teren” și discutând cu clienții, noi și partenerii noștri vedem că lucrurile nu stau deloc așa. Există multe sarcini pentru hiperconvergent, în unele cazuri oamenii pur și simplu nu știau că astfel de soluții există, în alte cazuri părea prea scump, în alte cazuri au fost teste nereușite ale soluțiilor alternative, iar în alte cazuri cumpărarea este pur și simplu interzisă din cauza sancțiunilor. În general, câmpul s-a dovedit a fi neexploatat, așa că am decis să cultivăm pământul neexploatat))).
Când este un SCD mai bun decât un GKS?
În activitatea noastră pe piață, suntem frecvent întrebați când ar trebui să utilizăm schema clasică cu stocare ierarhică și când ar trebui să ne îndreptăm către soluții hiperconvergente? Multe companii producătoare de GKS (în special cele care nu au stocare ierarhică în portofoliu) afirmă: „Stocarea ierarhică ajunge la final, numai hiperconvergent!”. Aceasta este o afirmație îndrăzneață, dar nu reflectă complet realitatea.
Adevărul este că piața stocării ierarhice migrează cu adevărat către soluții hiperconvergente, dar există întotdeauna un „dar”.
În primul rând, centrele de date și infrastructurile IT construite pe schemă clasică cu stocare ierarhică nu pot fi transformate atât de ușor, așadar modernizarea și completarea acestor infrastructuri va reprezenta încă un moștenire de 5-7 ani.
În al doilea rând, infrastructurile care sunt construite în prezent în masă (aici ne referim la Federația Rusă) sunt, în principal, bazate pe schema clasică cu stocare ierarhică, și nu din cauza că oamenii nu sunt conștienți de soluțiile hiperconvergente, ci pentru că piața soluțiilor hiperconvergente este nouă, soluțiile și standardele nu s-au stabilit încă, specialiștii IT nu sunt încă instruiți, experiența este limitată, iar centrele de date trebuie construite imediat. Această tendință va continua încă 3-5 ani (și apoi va reprezenta din nou o moștenire, vezi punctul 1).
În al treilea rând, există o limitare tehnică pură în întârzierile suplimentare de 2 milisecunde la scriere (fără a lua în considerare memoria cache locală, desigur), ce reprezintă prețul plătit pentru stocarea distribuită.
Și să nu uităm de utilizarea serverelor fizice mari, care preferă scalarea verticală a subsistemului de stocare.
Există multe sarcini necesare și populare în care stocarea ierarhică se comportă mai bine decât soluțiile hiperconvergente. Că sunt de altă opinie cei care nu au stocare ierarhică în portofoliu, este de înțeles, dar suntem pregătiți să argumentăm. Bineînțeles, noi, ca dezvoltatori ai ambelor produse, vom realiza în viitor o comparație între stocarea ierarhică și GKS, unde vom demonstra clar condițiile în care fiecare soluție este superioară.
Unde vor funcționa mai bine soluțiile hiperconvergente decât stocarea ierarhică?
Pe baza tezelor de mai sus, se pot trasa trei concluzii evidente:
- Acolo unde întârzierile suplimentare de 2 milisecunde la scriere, care apar constant în orice mediu de producție (aici nu se discută despre mediul sintetic, unde se pot obține nano-seconds), sunt necritice, soluțiile hiperconvergente vor fi potrivite.
- Acolo unde sarcina de pe serverele fizice mari poate fi transformată în mai multe servere virtuale mai mici și distribuită pe noduri, hiperconvergența se va integra bine.
- Acolo unde scalarea orizontală este mai prioritară decât scalarea verticală, hiperconvergența va fi foarte binevenită.
Ce soluții sunt acestea?
- Toate serviciile standard de infrastructură (serviciul de director, poștă, Sistem de Management al Documentelor, servere de fișiere, sisteme ERP și BI mici sau medii etc.). Noi le numim «calcul comun».
- Infrastructura furnizorilor de cloud, unde este necesară extinderea rapidă și standardizată orizontal și ușor «tăierea» unui număr mare de mașini virtuale pentru clienți.
- Infrastructură birouri virtuale (VDI), unde multe mașini virtuale utilizator se activează și «navighează» în liniște în interiorul unui cluster uniform.
- Rețelele filialelor, unde în fiecare filială este necesară o infrastructură standard, tolerantă la defecțiuni, dar în același timp ieftină, formată din 15-20 de mașini virtuale.
- Orice calcul distribuit (servicii big data, de exemplu). Acolo unde sarcina nu merge «în adâncime», ci «în lățime».
- Mediile de testare, unde întârzierile suplimentare sunt acceptabile, dar există limitări bugetare, deoarece sunt teste.
În prezent, pentru aceste sarcini am creat AERODISK vAIR și ne concentrăm pe acestea (deocamdată cu succes). Este posibil să se schimbe în curând, deoarece lumea nu stă pe loc.
Așadar...
Aici se încheie prima parte a unui mare ciclu de articole, în următorul articol vom vorbi despre arhitectura soluției și componentele utilizate.
Vom fi bucuroși să primim întrebări, sugestii și dispute constructive.
Sursa: habr.com
