

Tema accidentelor majore în centrele de date moderne ridică întrebări care nu au fost abordate în primul articol — am decis să o dezvoltăm.
Dacă ne luăm după statisticile Uptime Institute, cea mai mare parte a incidentelor în centrele de date sunt legate de defecțiuni ale sistemului de alimentare cu energie — acestea reprezintă 39% din incidente. Următorul pe listă este factorul uman — încă 24% din accidente. A treia cauză ca importanță (15%) a fost defecțiunea sistemului de climatizare, iar pe locul patru (12%) s-au plasat catastrofele naturale. Ponderea altor neplăceri reprezintă doar 10%. Fără a pune la îndoială datele unei organizații respectate, vom identifica un element comun în diferitele accidente și ne vom strădui să înțelegem dacă acestea ar fi putut fi evitate. Spoiler: în majoritatea cazurilor, da.
Știința contactelor
Spunând simplist, cu alimentarea electrică există doar două probleme: fie nu există contact acolo unde ar trebui, fie există acolo unde nu ar trebui. Poți discuta mult despre fiabilitatea sistemelor moderne de alimentare neîntreruptă, dar ele nu salvează întotdeauna situația. Să luăm ca exemplu cazul bine cunoscut al centrului de date al British Airways, care aparține companiei-mamă International Airlines Group. Aproape de aeroportul Heathrow se află două astfel de locații — Boadicea House și Comet House. În primul dintre acestea, pe 27 mai 2017, a avut loc o deconectare accidentală a alimentării electrice, care a dus la suprasarcină și la eșecul sistemului UPS. În rezultat, o parte din echipamentele IT au fost deteriorate fizic, iar remedierea ultimei avarii a durat trei zile.
Compania aeriană a fost nevoită să anuleze sau să reprogrameze peste o mie de zboruri, iar aproximativ 75.000 de pasageri nu au putut decola la timp — despăgubirile acordate au totalizat 128 milioane dolari, fără a include costurile necesare pentru restabilirea funcționalității centrelor de date. Povestea cauzelor blackout-ului rămâne neclară. Dacă avem încredere în rezultatele investigației interne prezentate de directorul general al International Airlines Group, Willie Walsh, acesta s-a datorat unei erori a inginerilor. Cu toate acestea, sistemul de alimentare neîntreruptă ar fi trebuit să reziste la o astfel de deconectare — pentru aceasta a fost instalat. Centrele de date erau gestionate de specialiștii companiei de outsourcing CBRE Managed Services, prin urmare British Airways a încercat să recupereze suma daunelor prin intermediul instanței din Londra.
Problemele de alimentare cu energie electrică se desfășoară conform unor scenarii similare: mai întâi, are loc o deconectare cauzată de furnizorul de energie electrică, uneori din cauza vremii nefavorabile sau a problemelor interne (inclusiv erori umane), iar apoi sistemul de alimentare neîntreruptă nu face față sarcinii sau o întrerupere temporară a sinusoidei provoacă defecțiuni în numeroase servicii, recuperarea funcționalității acestora necesitând o cantitate semnificativă de timp și bani. Se pot evita astfel de incidente? Absolut. Dacă sistemul este proiectat corect, cu toate acestea, chiar și creatorii marilor centre de date nu sunt scutiți de erori.
Factorul uman
Când cauza directă a incidentului este reprezentată de acțiunile greșite ale personalului din centrul de date, problemele afectează de cele mai multe ori (dar nu întotdeauna) partea software a infrastructurii IT. Astfel de incidente se întâmplă chiar și în corporații mari. În februarie 2017, din cauza unei comenzi greșit introduse de un membru al echipei tehnice de operare a unui centru de date, o parte din serverele Amazon Web Services au fost deconectate. Eroarea s-a petrecut în timpul debugării procesului de facturare pentru clienții serviciului de stocare în cloud Amazon Simple Storage Service (S3). Angajatul a încercat să ștergă un anumit număr de servere virtuale utilizate de sistemul de facturare, dar a atins un cluster mai mare.
Ca rezultat al erorii inginerului, serverele pe care erau lansate module software importante ale stocării în cloud Amazon au fost șterse. În primul rând, a fost afectat subsistemul de indexare, care conținea informații despre metadate și locația tuturor obiectelor S3 în regiunea americană US-EAST-1. Incidentul a afectat de asemenea subsistemul utilizat pentru stocarea datelor și gestionarea spațiului disponibil pentru stocare. După ștergerea mașinilor virtuale, aceste două subsisteme au necesitat o repornire completă, iar inginerii Amazon s-au confruntat cu o surpriză — timp îndelungat, stocarea publică în cloud nu a putut procesa cererile clienților.
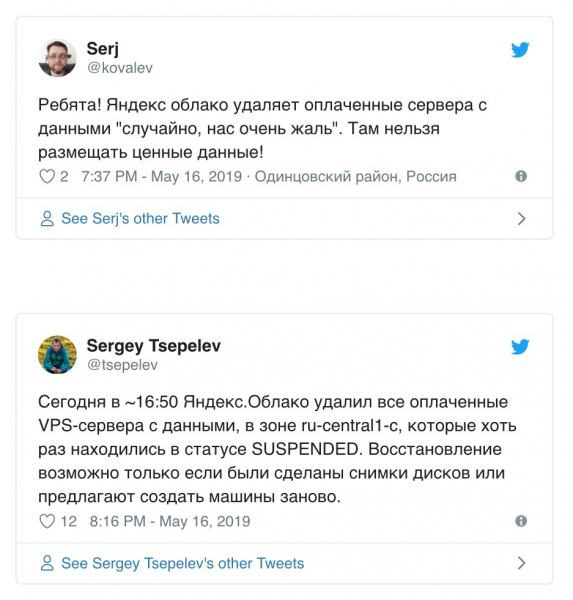
Impactul a fost amplu, deoarece multe dintre resursele mari utilizează Amazon S3. Defecțiunile au afectat Trello, Coursera, IFTTT și, ce este și mai grav, serviciile unor mari parteneri Amazon din lista S&P 500. Estimarea daunelor în astfel de cazuri este dificilă, dar acestea se ridică la sute de milioane de dolari americani. Așa cum observați, pentru a aduce în incapacitate serviciul celei mai mari platforme de cloud, este suficientă o singură comandă greșită. Acesta nu este un caz izolat, pe 16 mai 2019, în timpul lucrărilor de întreținere, serviciul Yandex.Cloud mașinile virtuale ale utilizatorilor în zona ru-central1-c care au fost vreodată în starea SUSPENDED. Aici au fost deja afectate datele clienților, parte dintre ele fiind irevocabil pierdute. Bineînțeles, oamenii nu sunt perfecți, dar sistemele moderne de securitate a informațiilor știu de mult să controleze acțiunile utilizatorilor privilegiați înainte de a executa comenzile introduse de aceștia. Dacă în Yandex sau Amazon ar fi implementate astfel de soluții, astfel de incidente ar putea fi evitate.
Răcirea înghețată
În ianuarie 2017, a avut loc un accident major în centrul de date din Dmitrov al companiei „Megafon”. Atunci, temperatura din regiunea Moscovei a scăzut până la -35 °C, ceea ce a dus la defectarea sistemului de răcire al obiectivului. Biroul de presă al operatorului nu a dorit să divulge detalii despre cauzele incidentului - companiile rusești sunt extrem de reticente să discute despre accidentele de pe proprietățile lor, iar în privința transparenței suntem cu mult în urma Occidentului. Pe rețelele sociale a circulat teoria că agentul termic s-a înghețat în țevile săpate pe stradă, provocând scurgeri de etilenglicol. Dacă ne luăm după acestă ipoteză, serviciul de exploatare nu a reușit, din cauza sărbătorilor prelungite, să obțină rapid 30 de tone de agent de răcire și s-a descurcat folosind resurse improvizate, organizând un sistem de răcire în regim de urgență cu încălcarea regulilor de operare. Frigul extrem a agravat problema - în ianuarie, în Rusia a venit brusc iarna, deși nimeni nu o aștepta. Ca urmare, personalul a fost nevoit să deconecteze o parte din rackurile serverelor, ceea ce a făcut ca unele servicii ale operatorului să nu fie disponibile timp de două zile.
Poate că ar trebui să vorbim și despre anomalii meteorologice, dar astfel de friguri nu sunt deosebite pentru regiunea metropolitană. Temperatura pe timp de iarnă în suburbiile Moscovei poate scădea chiar și la valori mai scăzute, așa că centrele de date sunt construite având în vedere funcționarea stabilă la −42°С. Cel mai frecvent, sistemele de răcire cedează la frig din cauza concentrației insuficiente de glicoli și a excesului de apă din soluția agentului termic. Există și probleme legate de instalarea tuburilor sau de erori în proiectarea și testarea sistemului, în principal din dorința de a economisi. În cele din urmă, o avarie gravă se poate produce din nimic, care ar fi putut fi evitată cu ușurință.
Fenomenelor naturale
Cel mai adesea, furtunile și/sau uraganele perturbă funcționarea infrastructurii ingineresti a centrului de date, ceea ce duce la oprirea serviciilor și/sau la deteriorarea fizică a echipamentului. Incidentele provocate de vreme nefavorabilă se întâmplă destul de frecvent. În 2012, pe coasta de vest a Statelor Unite, uraganul Sandy a adus ploi torențiale. Centrul de date Peer 1, situat într-un zgârie-nori din Lower Manhattan, , după ce apa sărată a inundat subsolurile. Generatoarele de urgență ale obiectivului erau amplasate la etajul 18, iar rezerva de combustibil pentru acestea era limitată — regulile impuse în New York după atacurile din 11/09 interzic păstrarea unei cantități mari de combustibil la etajele superioare.
Pompa de combustibil s-a defectat și personalul a transportat manual motorină pentru generatoare timp de câteva zile. Eroismul echipei a salvat centrul de date de o avarie gravă, dar era atât de necesar? Trăim pe o planetă cu o atmosferă de azot și oxigen și cu o cantitate mare de apă. Furtunile și uraganele sunt aici o raritate (în special în zonele de coastă). Cred că proiectanții ar trebui să ia în considerare riscurile asociate și să construiască un sistem potrivit de alimentare electrică neîntreruptă. Sau, măcar, să aleagă pentru centrul de date un loc mai potrivit decât un zgârie-nori pe o insulă.
Tot restul
În această categorie, Uptime Institute evidențiază diverse incidente, dintre care este greu să alegi unul tipic. Furtul cablurilor de cupru, intervențiile neautorizate în centrele de date, stâlpii de înaltă tensiune și substațiile electrice, accidentele cu automobile, incendiile care afectează fibra optică provocate de excavatoare, rozătoarele (șoarecii, iepurii și chiar wombat-urile, care, de fapt, fac parte din marsupiale), precum și amatorii de a trage în fire — opțiunile sunt variate. Problemele de alimentare electrică pot fi cauzate chiar și de de marijuana care fură energie electrică. În cele mai multe cazuri, vinovații pentru incidente sunt persoane specifice, adică ne confruntăm din nou cu factorul uman, când problema are un nume și un prenume. Chiar dacă, la prima vedere, accidentul este legat de o defecțiune tehnică sau de calamități naturale, acesta poate fi evitat dacă se face o proiectare corectă a obiectivului și o utilizare adecvată a acestuia. Excepțiile sunt cazurile de daune critice aduse infrastructurii centrului de date sau distrugerea clădirilor și structurilor din cauza unui cataclism natural. Acestea sunt cu adevărat circumstanțe de forță majoră, iar toate celelalte probleme sunt cauzate de legătura dintre computer și scaun — poate că aceasta este cea mai nesigură parte a oricărei sisteme complexe.
Sursa: habr.com
