

3. Varietățile de structuri folosind globale
O astfel de structură ca un arbore ordonat are diferite cazuri particulare. Să analizăm cele care au o valoare practică în munca cu globale.
3.1 Caz particular 1. Un nod fără ramuri
 Globale pot fi utilizate nu doar ca un array, ci și ca variabile obișnuite. De exemplu, ca un contor:
Set ^counter = 0  ; setarea contorului
Set id=$Increment(^counter) ;  incrementare atomică
În acest caz, globalul, pe lângă valoare, poate avea și ramuri. Unele nu exclud pe altele.
3.2 Caz particular 2. Un vârf și multe ramuri
În general — aceasta este o bază clasică de tip key-value. Iar dacă, ca valoare, vom salva un tuplu de valori, vom obține o tabelă obișnuită cu o cheie primară.
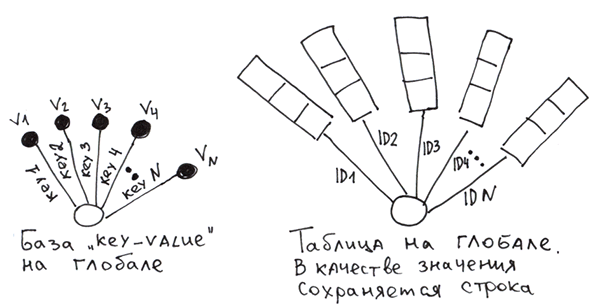
Pentru a implementa o tabelă pe globale, va trebui să formăm singuri rândurile din valorile coloanelor și apoi să le salvăm în global după cheia primară. Pentru ca, la citire, să fie posibilă separarea rândului înapoi în coloane, putem utiliza:
- caractere delimitatoare.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - o schemă rigidă, în care fiecare câmp ocupă un număr prestabilit de bytes. Așa cum se practică în bazele de date relaționale.
- o funcție specială $LB (disponibilă în Cache), care formează un rând din valori.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Ce este interesant, nu este greu să creezi pe globale ceva similar cu indecșii secundari din bazele de date relaționale. Să numim aceste structuri globale de index. Un global de index este un arbore auxiliar pentru căutări rapide pe câmpuri ce nu fac parte din cheia primară a globalului principal. Pentru a-l completa și utiliza, trebuie să scrii cod suplimentar.
Să creăm un global de index pe prima coloană.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Acum, pentru a căuta informații rapid pe prima coloană, va trebui să verificăm globalul ^i și să găsim cheile primare (id) corespunzătoare valorii dorite din prima coloană.
Când inserăm o valoare, putem crea imediat atât valoarea, cât și globalele de index pentru câmpurile necesare. Iar pentru fiabilitate, să le învăluim toate într-o tranzacție.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detalii despre cum să faci pe M , .
Aceste tabele vor funcționa la fel de rapid ca și în bazele de date tradiționale (sau chiar mai repede), dacă funcțiile de inserare/update/ștergere a rândurilor sunt scrise în COS/M și compilate.Am verificat această afirmație prin teste de inserare și selectare în masă într-o tabelă cu două coloane, inclusiv folosind comenzile TSTART și TCOMMIT (tranzacții).
Nu am testat scenarii mai complexe cu acces concurent și tranzacții paralele.
Fără utilizarea tranzacțiilor, viteza inserțiilor a fost de 778.361 inserții/secundă la un milion de valori.
La 300 de milioane de valori — 422.141 inserții/secundă.
Când se folosesc tranzacții — 572.082 inserții/secundă pentru 50M inserții. Toate operațiile au fost efectuate din cod M compilat.
Discurile sunt obișnuite, nu SSD. RAID5 cu Write-back. Procesor Phenom II 1100T.
Pentru a efectua un test similar pe o bază de date SQL, trebuie să scrii o procedură stocată care să facă inserții într-un ciclu. Când am testat MySQL 5.5 (stocare InnoDB) folosind această metodă, rezultatele nu au depășit 11K inserții pe secundă.
Da, implementarea tabelelor pe globale pare mai complexă decât în bazele de date relaționale. De aceea, bazele de date industriale pe globale au acces SQL pentru a simplifica lucrul cu datele tabelare.
 În general, dacă schema de date nu se va schimba frecvent, viteza de inserare nu este critică și întreaga bază poate fi ușor reprezentată sub formă de tabele normalizate, este mai simplu să lucrezi cu SQL, deoarece acesta oferă un nivel mai înalt de abstracție.
 În acest caz particular, am vrut să arăt că globalele pot funcționa ca un constructor pentru a crea alte baze de date. Ca un assembler, pe care poți scrie alte limbaje. Iată exemple despre cum poți crea pe globale echivalentele
Dacă trebuie să creezi o bază de date non-standard cu eforturi minime, ar trebui să te uiți spre globale.
3.3 Caz special 3. Arbore bidimensional, fiecare nod de al doilea nivel are un număr fix de ramuri
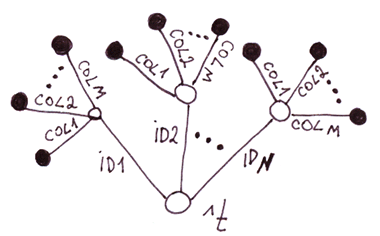 Probabil că ai ghicit: aceasta este o implementare alternativă a tabelelor pe globale. Să comparăm această implementare cu cea anterioară.
Tabele pe arbore bidimensional vs. pe arbore unidimensional.
Dezavantaje
Advantages
- Mai lent la inserare, deoarece trebuie să se stabilească numărul de noduri egal cu numărul de coloane.
- Mai mult spațiu de stocare. Deoarece indicii globali (în sensul indicilor la array-uri) cu numele coloanelor ocupă loc pe disc și sunt duplicate pentru fiecare rând.
- Acces mai rapid la valorile coloanelor individuale, deoarece nu trebuie să parsam rândul. Din testele mele, este mai rapid cu 11,5% pe 2 coloane și și mai mult pe un număr mai mare de coloane.
- Mai simplu de modificat schema datelor
- Codul este mai clar
Concluzie: pentru anumite gusturi. Deoarece viteza este unul dintre cele mai importante avantaje ale globalilor, nu are aproape niciun sens să folosești această implementare, deoarece probabil nu va funcționa mai repede decât tabelele din bazele de date relaționale.
3.4 Caz general. Arbori și arbori ordonați
Orice structură de date care poate fi reprezentată sub formă de arbore se potrivește perfect cu globalii.
3.4.1 Obiecte cu subobiecte
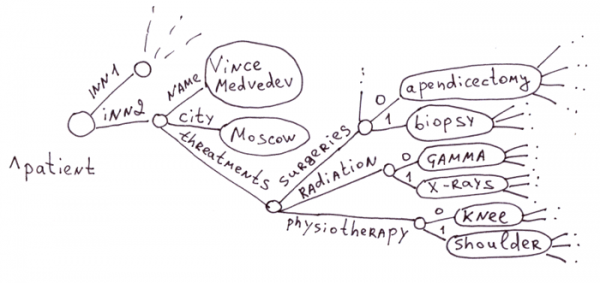
Aceasta este domeniul de aplicare tradițional al globalilor. În domeniul medical, există un număr imens de boli, medicamente, simptome, metode de tratament. Crearea unei tabele pentru fiecare pacient cu un milion de câmpuri este nerațională. Cu atât mai mult cu cât 99% din câmpuri vor fi goale.
Imaginați-vă o bază de date SQL din tabele: „pacient” ~ 100.000 câmpuri, „medicament” — 100.000 câmpuri, „terapie” — 100.000 câmpuri, „complicații” — 100.000 câmpuri și așa mai departe. Sau am putea crea o bază de date din mii de tabele, fiecare pentru un tip specific de pacient (care ar putea să se suprapună!), tratament, medicament și încă mii de tabele pentru relațiile dintre aceste tabele.
Globalii se potrivesc perfect în medicină, deoarece permit crearea unei descrieri exacte a istoricului medical al fiecărui pacient, diferitelor terapii, acțiunilor medicamentelor, sub formă de arbore, fără a consuma spațiu de stocare pe coloane goale, așa cum ar fi fost în cazul relațional.
 Pe globali, este convenabil să faci o bază de date cu date despre oameni, când este important să acumulezi și să sistematizezi cât mai multe informații diverse despre client. Aceasta este o cerință în medicină, domeniul bancar, marketing, arhivare și alte domenii
.
Fără îndoială, și pe SQL se poate emula un arbore cu doar câteva tabele (, ,,,,,,,,,), dar este mult mai complicat și va funcționa mai lent. Practic, ar trebui să scriem un global care să funcționeze pe tabele și să ascundem tot procesul cu tabelele sub un strat de abstractizare. Nu este corect să emulăm o tehnologie de nivel inferior (globals) prin mijloace de nivel superior (SQL). Nu este fezabil.
Nu este un secret că modificarea schemei de date pe tabele uriașe (ALTER TABLE) poate dura mult timp. MySQL, de exemplu, realizează ALTER TABLE ADD|DROP COLUMN prin copierea completă a informațiilor din vechea în noua tabelă (am testat motoarele MyISAM, InnoDB). Acest lucru poate bloca o bază de date activă cu miliarde de înregistrări pentru zile, dacă nu pentru săptămâni.
 Modificarea structurii de date, dacă folosim globals, nu ne costă nimic. În orice moment putem adăuga proprietăți noi, de orice tip, la orice obiect, la orice nivel al ierarhiei. Modificările legate de redenumirea ramurilor pot fi rulate în fundal pe o bază de date activă.
Prin urmare, atunci când vine vorba de stocarea obiectelor cu un număr uriaș de proprietăți opționale, globals sunt o alegere excelentă.
Mai mult, reamintesc că accesul la oricare dintre proprietăți este instantaneu, deoarece în global toate căile sunt arbore B.
Bazele de date pe globals sunt, în general, un tip de baze de date orientate pe documente, cu posibilitatea de a stoca informații ierarhice. Prin urmare, în domeniul stocării dosarelor medicale, globals pot concura cu bazele de date orientate pe documente. Dar totuși, nu este exact aceeași situație.Să luăm, de exemplu, MongoDB. În această arie, pierde în fața globals din motive:
- Dimensiunea documentului. Unitatea de stocare este un text în format JSON (mai precis BSON) cu un volum maxim de aproximativ 16MB. Această limitare este impusă special pentru a evita întârzierile în procesare a unei baze de date JSON, dacă se salvează un document JSON uriaș și apoi se face referire la el pe baza câmpurilor. În acest document ar trebui să fie concentrată toată informația despre pacient. Toți știm cât de voluminoase pot fi dosarele pacienților. Dimensiunea maximă a dosarului de 16MB exclud imediat pacienții ale căror dosare includ fișiere IRM, radiografii și alte cercetări. Într-o ramură a globalului, însă, se pot stoca informații în gigaocteți și terabiți. În principiu, aici aș putea încheia, dar voi continua.
- Timpul de conștientizare/modificare/ștergere a noilor proprietăți în fișa pacientului. Această bază de date trebuie să încarce întreaga fișă în memorie (este un volum mare!), să parseze BSON, să adauge/modifice/ștergă un nou nod, să actualizeze indexurile, să împacheteze în BSON și să salveze pe disk. Globalului îi ajunge doar să acceseze o proprietate specifică și să efectueze manipulări cu aceasta.
- Rapiditatea accesului la proprietăți individuale. Cu multe proprietăți în document și o structură ierarhică, accesul la proprietăți individuale va fi mai rapid datorită faptului că fiecare cale din global este un B-tree. În BSON, însă, va trebui să parsezi liniar documentul pentru a găsi proprietatea dorită.
3.3.2 Mese asociative
Mesele asociative (chiar și cu mese încorporate) se potrivesc perfect în globale. De exemplu, o astfel de masă din PHP se va afișa în prima imagine 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Documente ierarhice: XML, JSON
De asemenea, se stochează ușor în globale. Poate fi organizat în mai multe moduri.
XML
Cel mai simplu mod de a desfășura XML pe globale este atunci când în noduri stocăm atributele etichetelor. Dacă avem nevoie de acces rapid la atributele etichetelor, le putem extrage în ramuri separate.
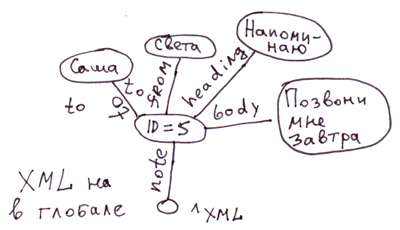
<note id="5">
<to>Vasya</to>
<from>Sveta</from>
<heading>Reamintire</heading>
<body>Suna-mă mâine!</body>
</note>
Pe COS, aceasta va corespunde codului:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Reminder"
Set ^xml("note","body")="Suna-mă mâine!"
Observație: Pentru XML, JSON, mese asociative, se pot inventa multe modalități diferite de a le reprezenta pe globale. În acest caz, nu am reflectat ordinea etichetelor în eticheta note. În global ^xml etichetele încorporate vor fi afișate în ordine alfabetică. Pentru a reflecta strict ordinea, se poate folosi, de exemplu, o astfel de reprezentare:
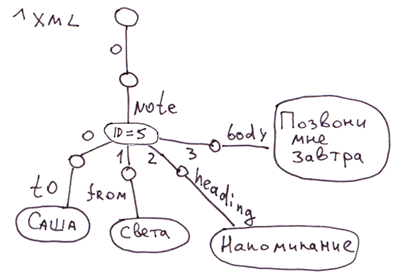
JSON.
În prima imagine din secțiunea 3.3.1 este arătată reflectarea acestui document JSON:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "treatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Structuri identice, legate prin relații ierarhice
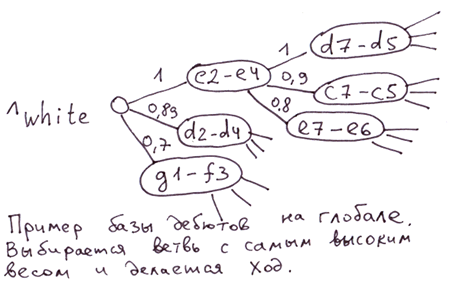
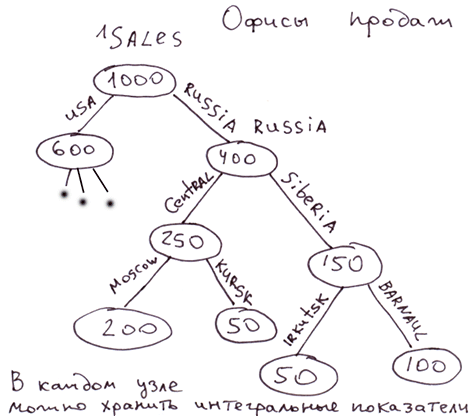
Exemple: structura birourilor de vânzări, poziționarea oamenilor în structura MLM, baza deschiderilor în șah.
Baza deschiderilor. Puteți utiliza evaluarea forței unei mișcări ca valoare a indexului nodului global. Astfel, pentru a alege cea mai puternică mișcare, va fi suficient să selectați ramura cu cea mai mare greutate. În global, toate ramurile de la fiecare nivel vor fi sortate după puterea mișcărilor.
Structura birourilor de vânzări, structura oamenilor din MLM. În noduri, se pot stoca valori cache care reflectă caracteristicile întregului subarbore. De exemplu, volumul vânzărilor pentru acest subarbore. În orice moment, putem obține un număr care reflectă realizările oricărei ramuri.
4. În ce cazuri este cel mai rentabil să utilizați globale
În prima coloană sunt prezentate cazurile în care veți obține un câștig substanțial în viteză prin utilizarea globalelor, iar în a doua când se va simplifica dezvoltarea sau modelul de date.
Viteză
Conveniența procesării/prezentării datelor
- Inserare [cu sortare automată la fiecare nivel], [indexare pe cheia principală]
- Ștergerea subarborilor
- Obiecte cu un număr mare de proprietăți încastrate, la care este necesar acces individual
- Structură ierarhică cu posibilitatea de a traversa ramurile fiice de la orice, chiar și de la cele inexistente
- Traversarea subarborilor în adâncime
- Obiecte/entități cu un număr imens de proprietăți/entități opționale [și/sau încastrate]
- Date fără schemă (schema-less). Când proprietățile noi pot apărea frecvent și cele vechi dispar.
- Trebuie să creați o bază de date nestandard.
- Baze de căi și arbori decizionali. Când căile sunt convenabil reprezentate sub formă de arbore.
- Ștergerea structurilor ierarhice fără utilizarea recursivității
Continuare .
Declinarea: Această articolă și comentariile mele la aceasta reprezintă opinia mea și nu au legătură cu poziția oficială a corporației InterSystems.
Sursa: habr.com
