

Vă invit să consultați transcrierea prezentării din sfârșitul anului 2019 a lui Alexander Valyalkin "Optimizări Go în VictoriaMetrics"
— un DBMS rapid și scalabil pentru stocarea și procesarea datelor sub formă de serii temporale (înregistrarea formează timpul și un set de valori corespunzătoare acestui timp, de exemplu, obținute prin interogarea periodică a stării senzorilor sau colectarea de metrici).
Iată linkul către videoclipul acestei prezentări —
Voi spune câteva cuvinte despre mine. Eu sunt Alexander Valyalkin. Iată . Mă pasionează Go și optimizarea performanței. Am scris multe biblioteci utile și unele mai puțin utile. Acestea încep fie cu fast, fie cu quick prefix.
În prezent, lucrez la VictoriaMetrics. Ce este asta și ce fac eu acolo? Despre acestea voi vorbi în această prezentare.
Planul prezentării este următorul:
- La început, vă voi explica ce este VictoriaMetrics.
- Apoi voi explica ce sunt seriile temporale.
- Apoi voi vorbi despre cum funcționează o bază de date pentru serii temporale.
- Mai departe, voi vorbi despre arhitectura bazei de date: din ce este alcătuită.
- Și apoi vom trece la optimizările care există în VictoriaMetrics. Acestea sunt optimizarea indexului invers și optimizarea pentru implementarea bitset în Go.
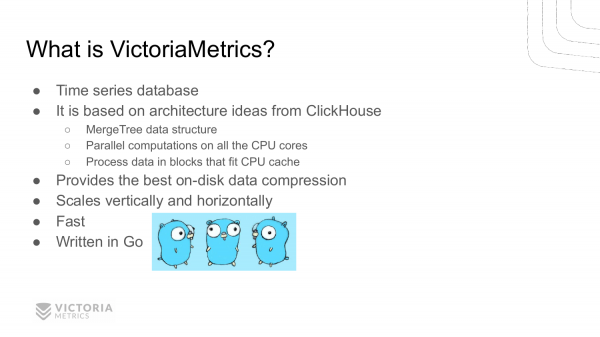
Știe cineva din audiență ce este VictoriaMetrics? Wow, deja mulți oameni știu. Asta este o veste bună. Pentru cei care nu știu – aceasta este o bază de date pentru serii temporale. Este bazată pe arhitectura ClickHouse, pe unele detalii de implementare ale ClickHouse. De exemplu, pe aspecte precum: MergeTree, calcul paralel pe toate nucleele disponibile ale procesorului și optimizarea performanței prin lucrul cu blocuri de date care sunt plasate în cache-ul procesorului.
VictoriaMetrics oferă cea mai bună compresie a datelor comparativ cu alte baze de date pentru serii temporale.
Se scalează vertical — adică puteți adăuga mai multe procesoare, mai multă memorie RAM pe un singur computer. VictoriaMetrics va utiliza cu succes aceste resurse disponibile și va crește performanța liniară.
De asemenea, VictoriaMetrics se scalează orizontal — adică puteți adăuga noduri suplimentare în clusterul VictoriaMetrics, iar performanța sa va crește aproape liniar.
După cum ați ghicit, VictoriaMetrics este o bază de date rapidă, deoarece nu pot scrie despre altele. Și este scrisă în Go, așa că vorbesc despre ea la acest meetup.
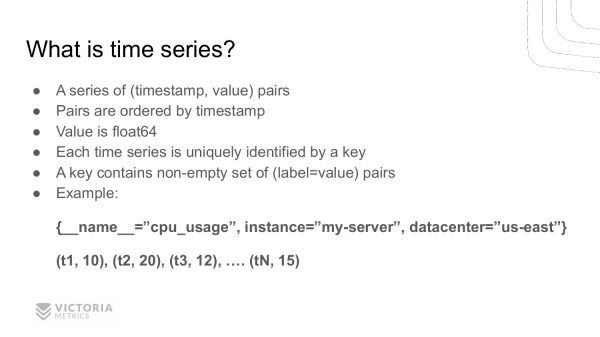
Cine știe ce este un șir temporar? Multe persoane știu, de asemenea. Un șir temporar este o serie de perechi (timestamp, valoare), unde aceste perechi sunt sortate în funcție de timp. Valoarea reprezintă un număr în virgulă mobilă – float64.
Fiecare șir temporar este identificat în mod unic printr-o cheie. Din ce este formată această cheie? Este formată dintr-un set nevid de perechi cheie-valoare.
Iată un exemplu de șir temporar. Cheia acestui șir este o listă de perechi: __name__="cpu_usage" – acesta este numele metricii, instance="my-server" — acesta este computerul pe care această metrică a fost colectată, datacenter="us-east" — acesta este data center-ul unde se află acest computer.
Am obținut un nume de șir temporar format din trei perechi cheie-valoare. Această cheie corespunde unei liste de perechi (timestamp, value). t1, t2, t3, ..., tN — acestea sunt timestampurile, 10, 20, 12, ..., 15 — valorile corespunzătoare. Aceasta este utilizarea CPU în acel moment pentru acest șir.
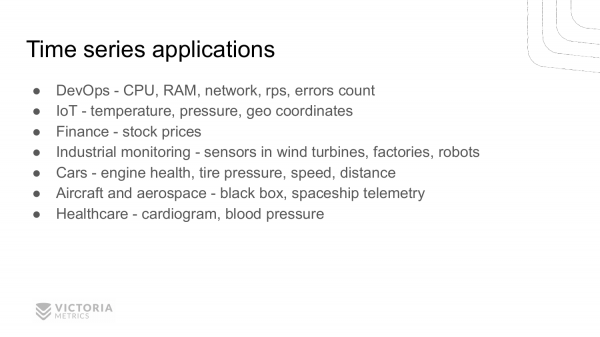
Unde pot fi folosite șirurile temporale? Are cineva idei?
- În DevOps, se pot măsura citirile încărcării CPU, RAM, rețelei, rps, numărul de erori etc.
- IoT – putem măsura temperatura, presiunea, coordonatele geoce și altele.
- De asemenea, în finanțe – putem monitoriza prețurile la diferite acțiuni și valute.
- În plus, șirurile temporale pot fi folosite în monitorizarea proceselor de producție în fabrici. Avem utilizatori care folosesc VictoriaMetrics pentru monitorizarea turbinelor eoliene, pentru roboți.
- De asemenea, șirurile temporale sunt utile pentru colectarea informațiilor de la senzori ai diferitelor dispozitive. De exemplu, pentru motor; pentru măsurarea presiunii în anvelope; pentru măsurarea vitezei, distanței; pentru măsurarea consumului de benzină etc.
- De asemenea, șirurile temporale pot fi folosite pentru monitorizarea avioanelor. Fiecare avion are o cutie neagră care colectează șiruri temporale pentru diferiți parametri de sănătate ai avionului. Șirurile temporale sunt utilizate și în industria aerospațială.
- Sistemul de sănătate – este vorba despre tensiunea arterială, pulsul etc.
Poate există și alte aplicații despre care am uitat, dar sper că ați înțeles că șirurile temporale sunt folosite activ în lumea modernă. Și volumul utilizării lor crește de la an la an.
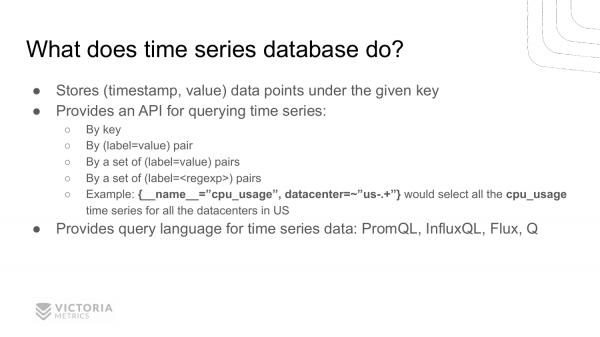
De ce este nevoie de o bază de date pentru șirurile temporale? De ce nu se poate folosi o bază de date relațională obișnuită pentru stocarea șirurilor temporale?
Pentru că în seriile temporale de obicei există un volum mare de informații, ceea ce face dificilă stocarea și procesarea acestora în baze de date obișnuite. De aceea au apărut baze de date specializate pentru series temporale. Aceste baze stochează eficient punctele (timestamp, value) cu o cheie specificată. Ele oferă API-uri pentru citirea datelor stocate după cheie, fie o singură pereche cheie-valoare, fie mai multe astfel de perechi, fie prin regexp. De exemplu, dacă doriți să găsiți utilizarea procesorului tuturor serviciilor dvs. din centrul de date din America, trebuie să folosiți acest tip de pseudo-interogare.
De obicei, baze de date pentru serii temporale oferă limbaje de interogare specializate, deoarece SQL nu se potrivește foarte bine cu seriile temporale. Deși există baze de date care suportă SQL, acesta nu se potrivește foarte bine. Limbajele de interogare cum ar fi , , , . Sper că cineva a auzit măcar de unul dintre aceste limbaje. Probabil că mulți au auzit de PromQL. Acesta este limbajul de interogare Prometheus.
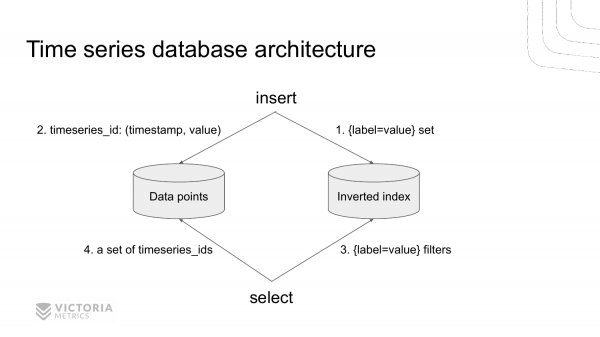
Iată cum arată arhitectura unei baze de date moderne pentru serii temporale prin exemplul VictoriaMetrics.
Aceasta este formată din două părți. Este un depozit pentru indexul inversat și un depozit pentru valorile seriilor temporale. Aceste depozite sunt separate.
Când vine o nouă înregistrare în baza de date, ne adresăm mai întâi indexului inversat pentru a găsi identificatorul seriei temporale în funcție de setul dat label=value pentru această metrică. Găsim acel identificator și salvăm valoarea în depozitul de date.
Când vine o interogare pentru extragerea datelor din TSDB, ne uităm mai întâi în indexul inversat. Extragem toate timeseries_ids înregistrările care se potrivesc cu acest set de label=value. Apoi extragem toate datele necesare din depozitul de date, indexate după timeseries_ids.
Să luăm un exemplu despre cum o bază de date pentru serii temporale procesează o interogare de tip select.
- Mai întâi, extrage toate
timeseries_idsdin indexul inversat, care conțin perechile specificatelabel=value, sau care îndeplinesc o expresie regulată specificată. - Apoi, extrage toate punctele de date din depozitul de date pe intervalul de timp specificat pentru cele găsite
timeseries_ids. - După aceea, baza de date efectuează anumite calcule asupra acestor puncte de date, conform cererii utilizatorului. Și apoi returnează răspunsul.
În această prezentare, vă voi vorbi despre prima parte. Este vorba despre căutare timeseries_ids pe indexul inversat. Puteți consulta apoi a doua și a treia parte , sau așteptați să pregătesc alte prezentări 🙂
Să începem cu indexul inversat. Mulți ar putea crede că este simplu. Câți știu ce este un index inversat și cum funcționează? O, nu sunt atât de multe persoane. Haideți să încercăm să înțelegem despre ce este vorba.
De fapt, totul este simplu. Este pur și simplu un dicționar care mapează o cheie pe o valoare. Ce este o cheie? Această pereche label=value, unde label și valoare — sunt șiruri. Iar valorile sunt un set timeseries_ids, care include perechea dată label=value.
Indexul inversat permite găsirea rapidă a tuturor timeseries_ids, care au label=value.
Și permite, de asemenea, găsirea rapidă timeseries_ids serii temporale pentru mai multe perechi label=value, sau pentru perechi label=regexp. Cum se întâmplă asta? Prin identificarea intersecției mulțimii timeseries_ids pentru fiecare pereche label=value.
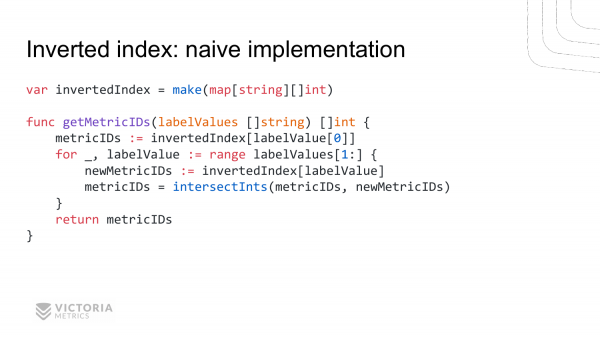
Să analizăm diferitele implementări ale indexului inversat. Să începem cu cea mai simplă implementare naivă. Arată așa.
Funcția getMetricIDs primește o listă de șiruri. Fiecare șir conține label=value. Această funcție returnează o listă metricIDs.
Cum funcționează asta? Avem o variabilă globală numită invertedIndex. Este un dicționar obișnuit (map), care mapează un șir pe un slice de int-uri. Șirul conține label=value.
Implementarea funcției: obținem metricIDs pentru primul label=value, apoi parcurgem toate celelalte label=value, obținem metricIDs pentru ele. Și apelăm funcția intersectInts, despre care va fi vorba mai departe. Această funcție returnează intersecția acestor liste.
După cum vedeți, implementarea indexului inversat nu este foarte complicată. Dar aceasta este o implementare naivă. Ce dezavantaje are? Principalul dezavantaj al implementării naive este că acest index inversat este stocat în memoria RAM. După repornirea aplicației, pierdem acest index. Nu există salvarea acestui index pe disc. Pentru o bază de date, un astfel de index inversat este puțin potrivit.
Al doilea dezavantaj este, de asemenea, legat de memorie. Indexul inversat trebuie să încapă în memoria RAM. Dacă depășește dimensiunea memoriei RAM, este evident că vom obține – eroare de memorie insuficientă. Și programul nu va funcționa.
Această problemă poate fi rezolvată folosind soluții gata făcute, cum ar fi , sau .
Pe scurt, avem nevoie de o bază de date care să permită realizarea rapidă a trei operații.
- Prima operație – aceasta este înregistrarea
cheie-valoareîn această bază de date. O face foarte repede, undecheie-valoare– sunt șiruri arbitrare. - A doua operație – este căutarea rapidă a valorii după cheia specificată.
- Și a treia operație – este căutarea rapidă a tuturor valorilor după un anumit prefix.
LevelDB și RocksDB – aceste baze au fost dezvoltate de Google și Facebook. La început a apărut LevelDB. Apoi, băieții de la Facebook au preluat LevelDB și au început să o îmbunătățească, creând RocksDB. Acum, în Facebook, aproape toate bazele de date interne lucrează pe RocksDB, inclusiv au migrat MySQL pe RocksDB. L-au numit .
Un index inversat poate fi implementat folosind LevelDB. Cum se face asta? Salvăm ca și cheie label=value. Iar ca și valoare – identificatorul seriei temporale în care există perechea label=value.
Dacă avem multe serii temporale cu această pereche label=value, atunci vor exista multe rânduri în această bază de date cu aceeași cheie și valori diferite. timeseries_ids. Pentru a obține o listă cu toate timeseries_ids, care încep cu label=prefix, facem o scanare de interval, pentru care această bază de date este optimizată. Adică, alegem toate rândurile care încep cu label=prefix și obținem valorile necesare. timeseries_ids.
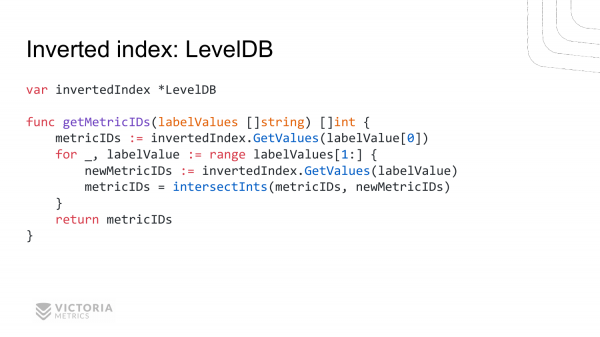
Iată o implementare aproximativă, cum ar arăta în Go. Avem un index inversat. Aceasta este LevelDB.
Funcția este aceeași ca pentru implementarea naivă. Se repetă aproape linie cu linie implementarea naivă. Singurul moment este că, în loc să apelăm la map , apelăm la indexul inversat. Extragem toate valorile pentru prima label=value. Apoi parcurgem toate perechile rămase label=value și extragem seturile corespunzătoare de metricIDs pentru acestea. Apoi găsim intersecția.
Se pare că totul este în regulă, dar în această soluție există dezavantaje. VictoriaMetrics a implementat inițial un index inversat pe baza LevelDB. Dar, în final, a fost nevoie să renunțe la el.
De ce? Pentru că LevelDB este mai lent decât implementarea naivă. În implementarea naivă, pentru cheia specificată, extragem imediat întregul slice metricIDs. Aceasta este o operație foarte rapidă – întregul slice este gata pentru utilizare.
În LevelDB, însă, la fiecare apel al funcției GetValues trebuie să parcurgem toate rândurile care încep cu label=value. Și pentru fiecare rând, trebuie să extragem valoarea timeseries_ids. Din aceste timeseries_ids colectăm un slice acestor timeseries_ids. Este evident că acest lucru este mult mai lent decât simpla accesare a unui map obișnuit după cheie.
A doua problemă este că LevelDB este scris în C. Apelurile la funcțiile C din Go nu sunt foarte rapide. Acestea durează sute de nanosecunde. Nu este foarte rapid, deoarece, comparativ cu un apel obișnuit al unei funcții scrise în Go, care durează 1-5 nanosecunde, diferența de performanță este de zeci de ori. Pentru VictoriaMetrics, aceasta a fost o problemă fatală 🙂
De aceea, am scris propria implementare a unui index invers. Și l-am numit .
Mergeset este bazat pe structura de date MergeTree. Această structură de date este împrumutată din ClickHouse. Este clar că mergeset trebuie optimizat pentru căutări rapide timeseries_ids după o cheie dată. Mergeset este scris complet în Go. Puteți consulta . Implementarea mergeset se află în folderul . Puteți încerca să înțelegeți ce se întâmplă acolo.
API-ul mergeset este foarte similar cu LevelDB și RocksDB. Adică, permite salvarea rapidă a noilor înregistrări și selectarea rapidă a înregistrărilor după un prefix dat.
Vom discuta despre dezavantajele mergeset mai târziu. Acum, să discutăm despre problemele întâmpinate cu VictoriaMetrics în producție la implementarea indexului invers.
De ce au apărut?
Prima cauză este rata mare de schimbare. În traducere, aceasta înseamnă o schimbare frecventă a seriilor temporale. Este cazul când o serie temporală se încheie și începe una nouă sau când încep multe serii temporale noi. Și acest lucru se întâmplă frecvent.
A doua cauză este numărul mare de serii temporale. La început, când monitorizarea câștiga popularitate, numărul de serii temporale era mic. De exemplu, pentru fiecare computer era necesar să monitorizăm încărcarea procesorului, memoriei, rețelei și discului. 4 serii temporale pentru fiecare computer. Ați avut, să zicem, 100 de computere și 400 de serii temporale. Este foarte puțin.
Pe parcursul timpului, oamenii au venit cu ideea de a măsura informații mai detaliate. De exemplu, să măsurăm încărcarea nu doar a întregului procesor, ci separat pentru fiecare nucleu de procesor. Dacă aveți 40 de nuclee de procesor, atunci, în mod corespunzător, aveți 40 de ori mai multe serii temporale pentru măsurarea încărcării procesorului.
Dar aceasta nu este tot. Fiecare nucleu de procesor poate avea mai multe stări, cum ar fi idle, când este inactiv. De asemenea, există activitatea în user space, activitatea în kernel space și alte stări. Și fiecare dintre aceste stări poate fi, de asemenea, măsurată ca o serie temporală separată. Aceasta crește suplimentar numărul seriilor cu 7-8 ori.
Dintr-o singură metrică am obținut 40 x 8 = 320 de metrici doar pentru un computer. Înmulțim cu 100, obținem 32 000 în loc de 400.
Apoi a apărut Kubernetes. Și a îngreunat lucrurile, pentru că în Kubernetes pot fi găzduite multe servicii diferite. Fiecare serviciu în Kubernetes este compus din multe poduri. Tot acest lucru trebuie monitorizat. Pe lângă aceasta, avem un deployment constant de noi versiuni ale serviciilor voastre. Pentru fiecare nouă versiune trebuie să creăm noi serii temporale. În cele din urmă, numărul seriilor temporale crește exponential și ne confruntăm cu problema unui număr mare de serii temporale, numită high-cardinality. VictoriaMetrics face față cu succes acestei probleme comparativ cu alte baze de date pentru serii temporale.
Să analizăm mai în detaliu high churn rate. De ce apare high churn rate în producție? Pentru că unele valori ale etichetelor și tagurilor se schimbă constant.
De exemplu, să luăm Kubernetes, în care există noțiunea deployment, adică atunci când este lansată o nouă versiune a aplicației voastre. Dezvoltatorii Kubernetes au decis să adauge id-ul deployment-ului în etichetă.
La ce a dus aceasta? La faptul că la fiecare nou deployment, toate seriile temporale vechi sunt întrerupte, iar în locul lor încep noi serii temporale cu o nouă valoare a etichetei deployment_id. Astfel de serii pot fi sute de mii și chiar milioane.
O caracteristică importantă a tuturor acestor aspecte este că numărul total de serii temporale crește, dar numărul seriilor temporale care sunt în prezent active, pentru care vin date, rămâne constant. Această stare este numită – high churn rate.
Principala problemă a high churn rate este de a asigura o viteză constantă de căutare pentru toate serii temporale pe baza unui set dat de etichete pe o anumită perioadă de timp. De obicei, această perioadă de timp este ultima oră sau ultima zi.
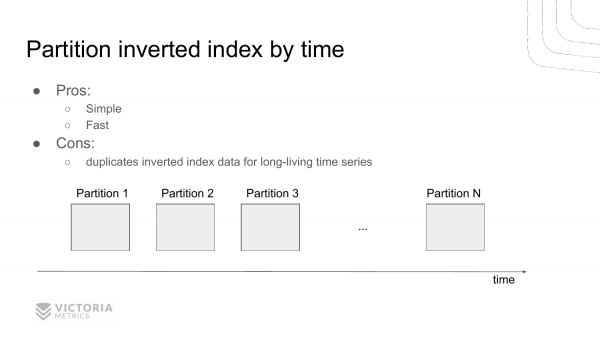
Cum putem rezolva această problemă? Iată prima variantă. Aceasta este de a împărți indexul inversat în părți independente în funcție de timp. Adică, trece un anumit interval de timp, terminăm lucrul cu indexul inversat curent și creăm un nou index inversat. Trec iar un alt interval de timp, creăm încă unul și tot așa.
Și în timpul extragerii din aceste indexuri inversate, găsim un set de indexuri inversate care intră în intervalul specificat. Și, în consecință, alegem de acolo id-urile seriilor temporale.
Aceasta permite economisirea resurselor, deoarece nu trebuie să examinăm părțile care nu se încadrează în intervalul specificat. Adică, de obicei, dacă alegem datele din ultima oră, atunci pentru intervalele temporale precedente, sărim peste cereri.
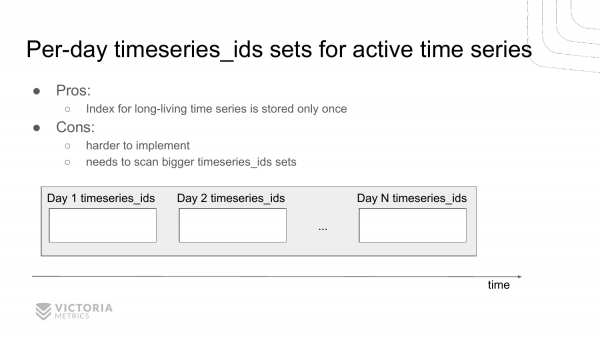
Există și o altă variantă de soluționare a acestei probleme. Aceasta este de a păstra pentru fiecare zi o listă separată de id-uri ale seriilor temporale care s-au întâlnit în acea zi.
Avantajul acestei soluții față de soluția anterioară este că nu duplicăm informația despre seriile temporale care nu dispar în timp. Acestea sunt constant disponibile și nu se schimbă.
Dezavantajul este că o astfel de soluție este mai complexă în implementare și mai dificilă în depanare. Și VictoriaMetrics a ales această soluție. Așa s-a întâmplat istoric. Această soluție se dovedește, de asemenea, destul de bună, comparativ cu cea anterioară. Deoarece această soluție nu a fost implementată din cauza nevoii de a dubla datele în fiecare partition pentru seriile temporale care nu se schimbă, adică care nu dispar în timp. VictoriaMetrics a fost în primul rând optimizată pentru consumul de spațiu pe disc, iar implementarea anterioară a deteriorat consumul de spațiu pe disc. Iar această implementare se potrivește mai bine pentru minimizarea consumului de spațiu pe disc, de aceea a fost aleasă.
A trebuit să luptăm cu ea. Lupta consta în faptul că, în această implementare, trebuie totuși să alegem o cantitate mult mai mare timeseries_ids pentru date, decât atunci când indexul inversat este împărțit pe timp.
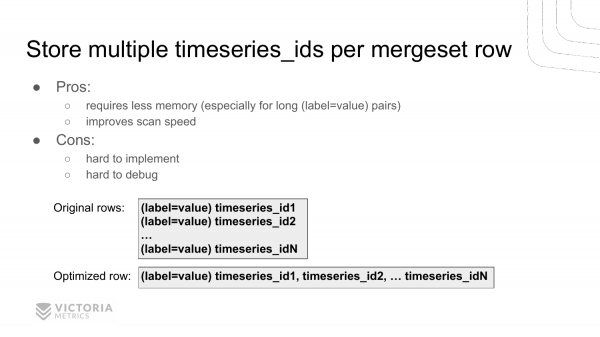
Cum am rezolvat această problemă? Am rezolvat-o într-un mod original – prin salvarea mai multor identificatori de serii temporale în fiecare înregistrare a indexului inversat, în loc de un singur identificator. Adică, avem o cheie label=value, care apare în fiecare serie temporală. Și acum păstrăm câteva timeseries_ids într-o singură înregistrare.
Iată un exemplu. În trecut aveam N înregistrări, iar acum avem o singură înregistrare, prefixul acesteia fiind același ca al tuturor celorlalte. Înregistrarea anterioară conținea toate ID-urile seriilor temporale.
Acest lucru a permis creșterea vitezei de scanare a unui astfel de index inversat cu până la 10 ori. Și a redus consumul de memorie pentru cache, deoarece acum stocăm șirul label=value doar o singură dată în cache, împreună cu N ori. Iar acest șir poate fi mare, dacă aveți în etichete și taguri șiruri lungi pe care Kubernetes le place să le adauge.
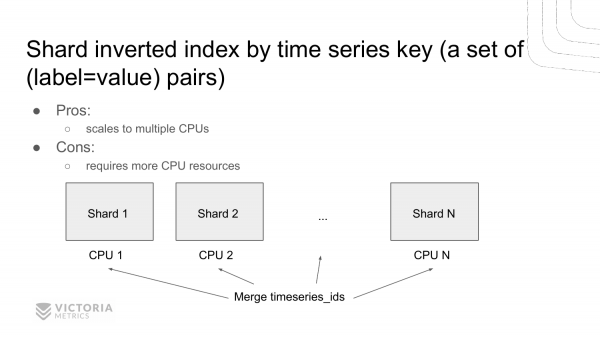
O altă opțiune pentru accelerarea căutării în indexul inversat este shardarea. Crearea mai multor indecși inversați în loc de unul singur și shardarea datelor între aceștia pe baza unei chei. Aceasta este o colecție cheie=valoare de perechi. Adică, obținem mai mulți indecși inversați independenți, pe care îi putem interoga în paralel pe mai multe procesoare. Implementările anterioare permiteau lucru doar în modul uniprocesor, adică scanarea datelor doar pe un singur nucleu. Această soluție permite scanarea datelor simultan pe mai multe nuclei, așa cum îi place lui ClickHouse să facă. Acest lucru intenționăm să implementăm.
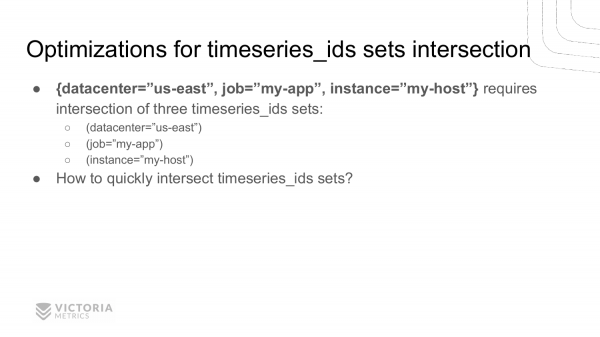
Acum, să ne întoarcem la subiect – la funcția de intersecție timeseries_ids. Să analizăm ce implementări ar putea exista. Această funcție permite găsirea timeseries_ids pentru un set dat de label=value.
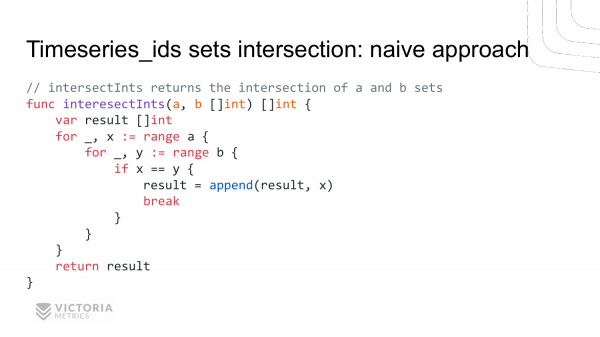
Prima opțiune este implementarea naivă. Două bucle imbricate. Aici primește ca input funcția intersectInts două slice-uri— a și b. La ieșire, ar trebui să ne returneze intersecția acestor slice-uri.
Implementarea naivă arată astfel. Parcurgem toate valorile din slice a, iar în interiorul acestei bucle parcurgem toate valorile din slice b. Și le comparăm. Dacă se potrivesc, înseamnă că am găsit intersecția. Și o salvăm în rezultat.
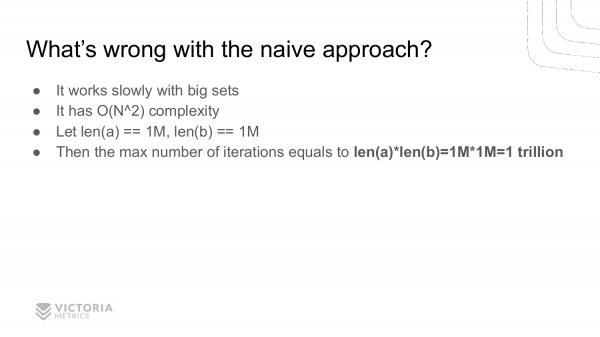
Ce dezavantaje există? Complexitatea pătratică – aceasta este principalul ei dezavantaj. De exemplu, dacă dimensiunile slice-urilor sunt a și b de un milion, atunci această funcție nu îți va da niciodată un răspuns. Deoarece va trebui să efectueze un trilion de iterații, ceea ce este foarte mult chiar și pentru computerele moderne.
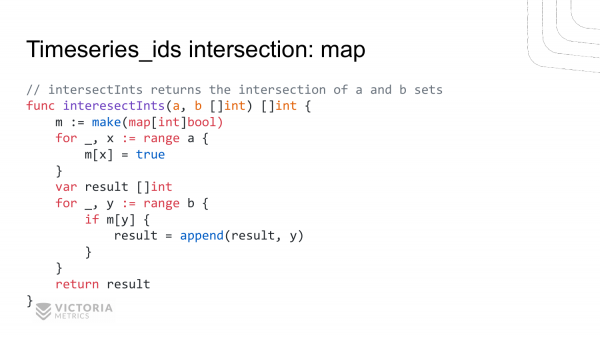
A doua implementare se bazează pe map. Creăm o mapă. Introducem în această mapă toate valorile din slice a. Apoi parcurgem un ciclu separat pe slice b. Și verificăm – există acea valoare din slice b în map. Dacă există, atunci îl adăugăm în rezultat.
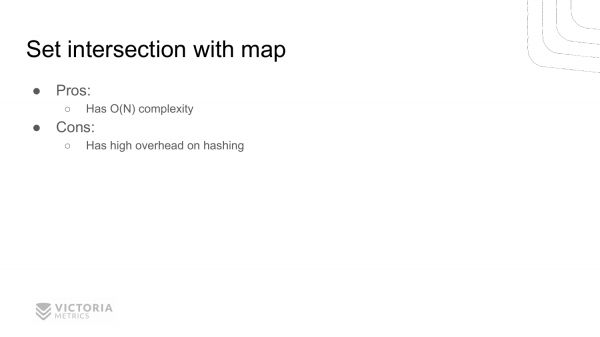
Care sunt avantajele? Avantajul constă în faptul că aici complexitatea este doar liniară. Adică, funcția se va executa de mult mai rapid pentru dimensiuni mari de slices. Pentru un slice de dimensiune un milion, această funcție se va executa în 2 milioane de iterații, spre deosebire de trilionul de iterații, cum era în funcția anterioară.
Dezavantajul este că această funcție necesită mai multă memorie pentru a crea acest map.
Al doilea dezavantaj – este overhead-ul mare pe hash. Acest dezavantaj nu este foarte evident. Și pentru noi nu a fost foarte evident niciodată, așa că la început implementarea intersecției în VictoriaMetrics a fost realizată prin map. Dar apoi profilarea a arătat că timpul de procesare al procesorului este cheltuit în principal pe scrierea în map și pe verificarea existenței valorii în acest map.
De ce se cheltuie timp de procesor în aceste locuri? Pentru că în liniile respective, Go efectuează operația de hashing. Adică, calculează hash-ul cheii pentru a accesa apoi la indexul specificat din HashMap. Operația de calculare a hash-ului se execută în zeci de nanosecunde. Este lent pentru VictoriaMetrics.
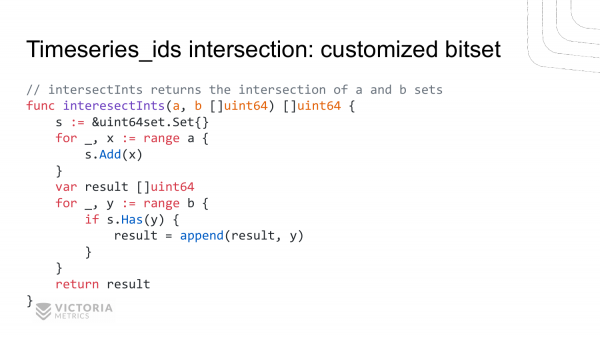
Am decis să implementez un bitset, optimizat special pentru acest caz. Iată cum arată acum intersecția a două slices. Aici creăm un bitset. Adăugăm în el elementele din primul slice. Apoi verificăm existența acestor elemente în al doilea slice. Și le adăugăm în rezultat. Adică, aproape nu se deosebește de exemplul anterior. Singurul aspect pe care l-am schimbat este că am înlocuit accesul la map cu funcții personalizate. add și has.
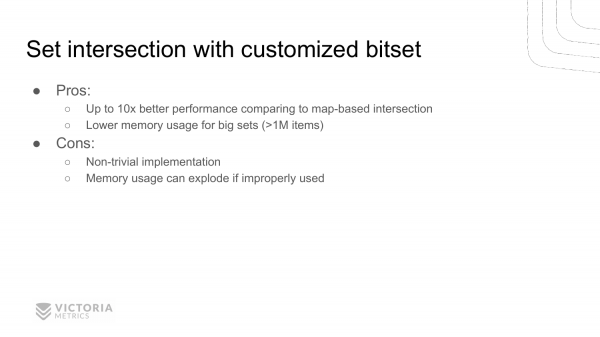
La prima vedere, pare că ar trebui să funcționeze mai încet, dacă înainte era folosit un map standard, iar acum sunt apelate și alte funcții, dar profilarea arată că această soluție funcționează de 10 ori mai repede decât un map standard pentru cazul cu VictoriaMetrics.
În plus, folosește mult mai puțină memorie în comparație cu implementarea pe map. Pentru că aici păstrăm biți în loc de valori de 8 biți.
Dezavantajul unei astfel de implementări este că nu este atât de evidentă, nu este triviială.
O altă deficiență pe care mulți ar putea să nu o observe este că această implementare poate funcționa slab în anumite cazuri. Adică, este optimizată pentru un caz specific, pentru cazul de intersecție a id-urilor seriilor temporale în VictoriaMetrics. Aceasta nu înseamnă că se va potrivi tuturor cazurilor. Dacă este utilizată incorect, vom obține nu un câștig de performanță, ci o eroare de tip out of memory și o încetinire a performanței.
Să analizăm implementarea acestei structuri. Dacă doriți să o vizualizați, ea se află în sursele VictoriaMetrics, în folderul . Este optimizată special pentru cazul VictoriaMetrics, unde timeseries_id reprezintă o valoare de 64 de biți, unde primii 32 de biți sunt constanți, iar doar ultimii 32 de biți se schimbă.
Această structură de date nu este stocată pe disc, funcționează doar în memorie.
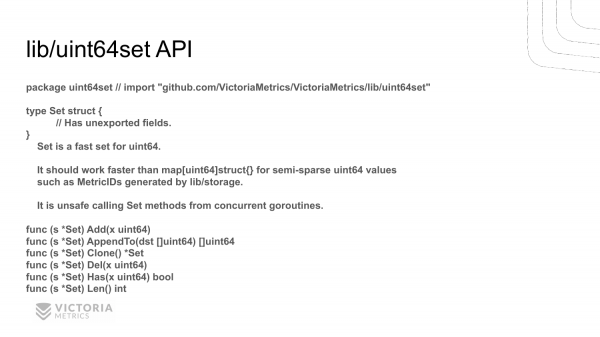
Iată API-ul său. Nu este foarte complex. API-ul este adaptat special pentru exemplul de utilizare VictoriaMetrics. Adică, nu există funcții inutile aici. Aici sunt funcțiile care sunt utilizate în mod clar de VictoriaMetrics.
Există funcția add, care adaugă valori noi. Există funcția has, care verifică valori noi. Și există funcția del, care șterge valori. Există o funcție auxiliară len, care returnează dimensiunea mulțimii. Funcția clone clonează mulțimea. Iar funcția appendto transformă acest set în slice. timeseries_ids.
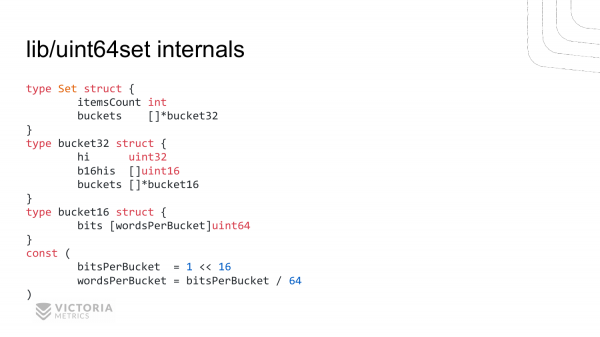
Iată cum arată implementarea acestei structuri de date. În set există doi elementi:
ItemsCount– este un câmp auxiliar, pentru a returna rapid numărul de elemente din set. S-ar putea să se fi descurcat fără acest câmp auxiliar, dar a trebuit să fie adăugat aici, deoarece VictoriaMetrics interoghează frecvent lungimea bitset-ului în algoritmii săi.Al doilea câmp este
buckets. Acesta este un slice din structurabucket32.În fiecare structură se stocheazăhicâmp. Acestea sunt cei 32 de biți superiori. Și două slice-uri —b16hisșibucketsdinbucket16structuri.
Aici sunt stocați cei 16 biți superiori ai celei de-a doua părți din structura de 64 de biți. Iar aici sunt bitset-urile pentru cei 16 biți inferiori ai fiecărui octet.
Bucket64 constă dintr-un tablou de uint64.Lungimea este calculată folosind aceste constante. Într-un bucket16 pot fi stocați maxim 2^16=65536 biți. Dacă se împarte la 8, atunci este 8 kilobyți. Dacă se împarte din nou la 8, atunci este 1000 uint64. valori. Adică, Bucket16 este o structură de 8 kilobyți.
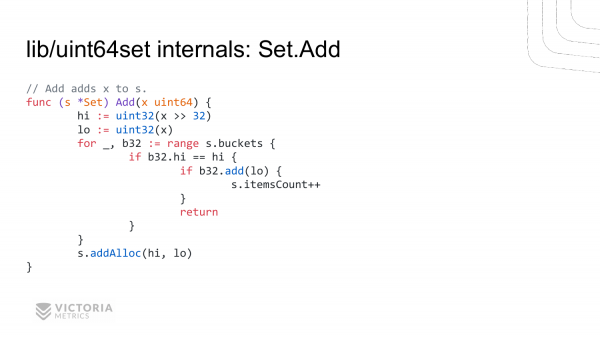
Să analizăm cum este implementată una dintre metodele acestei structuri pentru adăugarea unei valori noi.
Totul începe cu uint64. valoare. Calculăm primii 32 de biți, calculăm următorii 32 de biți. Parcurgem toate buckets. Comparăm primii 32 de biți din fiecare bucket cu valoarea adăugată. Și dacă sunt identici, apelăm funcția add din structura b32 buckets. Și adăugăm acolo următorii 32 de biți. Și dacă aceasta a returnat true, atunci înseamnă că am adăugat o astfel de valoare acolo și nu am avut această valoare înainte. Dacă returnează false, atunci o astfel de valoare a existat deja. Apoi, creștem numărul de elemente din structură.
Dacă nu am găsit cifra necesară bucket cu valoarea hi-corectă, atunci apelăm funcția addAlloc, care alocă un nou bucket, adăugându-l în structura bucket.
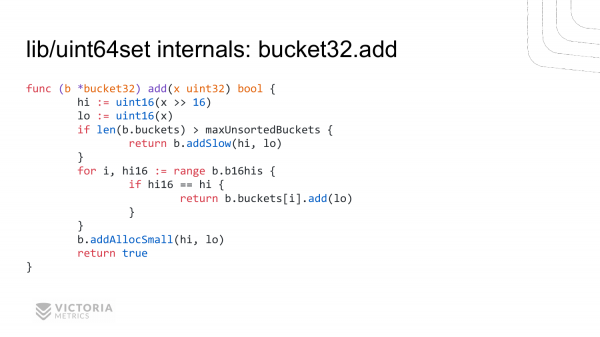
Aceasta este implementarea funcției b32.add. Este similară cu implementarea anterioară. Calculăm primii 16 biți, următorii 16 biți.
Apoi, parcurgem toți primii 16 biți. Găsim corespondente. Și la coincidences apelăm metoda add, pe care o vom analiza pe pagina următoare pentru bucket16.
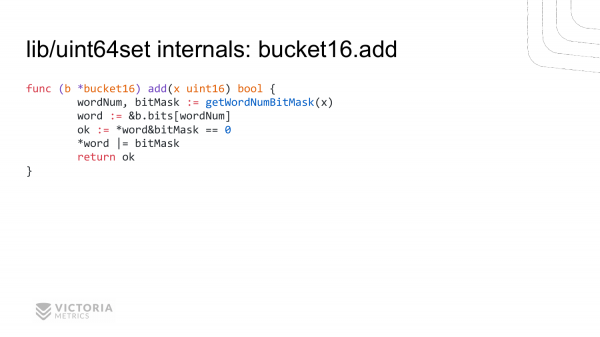
Și iată cel mai de jos nivel, care trebuie să fie maxim optimizat. Calculăm pentru uint64. id valoarea din slice bit, precum și bitmask. Aceasta este masca pentru această valoare de 64 de biți, care poate fi folosită pentru a verifica prezența acestui bit, sau pentru a-l seta. Verificăm prezența acestui bit, îl setăm și returnăm prezența. Iată o astfel de implementare care ne-a permis să accelerăm operația de intersecție a ids-urilor serii temporale de 10 ori comparativ cu hărțile obișnuite.
În VictoriaMetrics, pe lângă această optimizare, există multe alte optimizări. Majoritatea acestor optimizări au fost adăugate nu doar așa, ci după profilarea codului în producție.
Aceasta este regula principală a optimizării – să nu adăugăm optimizări presupunând că va exista o restricție, deoarece s-ar putea să fie că acolo nu există restricții. Optimizarea de obicei scade calitatea codului. De aceea, este mai bine să optimizăm doar după profilare și, de preferat, în producție, astfel încât să fie date reale. Pentru cei interesați, puteți consulta sursele VictoriaMetrics și studia alte optimizări care există acolo.
Am o întrebare despre bitset. Foarte asemănător cu implementarea vectorului C++ bool, bitset optimizat. Ați luat implementarea de acolo?
Nu, nu este așa. Când am implementat acest bitset, m-am bazat pe cunoștințele structurii acestor ids time series, care sunt utilizate în VictoriaMetrics. Structura lor este astfel încât cei 32 de biți superiori sunt în principal constanți. Cei 32 de biți inferiori pot varia. Cu cât bitul este mai mic, cu atât poate varia mai des. Prin urmare, această implementare este optimizată exact pentru această structură de date. Implementarea C++, atât cât știu, este optimizată pentru cazul general. Dacă faci optimizarea pentru cazul general, înseamnă că nu va fi cea mai optimă pentru cazul specific.
Îți recomand să te uiți și la prezentarea lui Alexey Milovid. Acum o lună, a vorbit despre optimizările din ClickHouse pentru specializări specifice. El explică exact că, în general, implementarea C++ sau orice altă implementare este adaptată pentru a funcționa bine în medie, în majoritate. Pot exista cazuri în care să funcționeze mai rău decât o implementare specializată pentru cunoștințele specifice, așa cum este cazul nostru, când știm că cei 32 de biți superiori sunt în principal constanți.
Am a doua întrebare. Care este diferența fundamentală față de InfluxDB?
Sunt multe diferențe fundamentale. Dacă ne referim la performanță și consum de memorie, InfluxDB în teste arată un consum de memorie cu 10 ori mai mare pentru time series de înaltă cardinalitate, când sunt multe, de exemplu, milioane. De exemplu, VictoriaMetrics consumă 1 GB pentru un milion de serii active, iar InfluxDB consumă 10 GB. Și aceasta este o diferență semnificativă.
A doua diferență fundamentală este că InfluxDB utilizează limbaje de interogare ciudate – Flux și InfluxQL. Ele nu sunt foarte convenabile pentru lucrul cu time series comparativ cu , care este suportat în VictoriaMetrics. PromQL este limbajul de interogare din Prometheus.
Și o altă diferență este că InfluxDB are un model de date puțin ciudat, unde fiecare linie poate avea mai multe fields cu un set diferit de tags. Aceste linii sunt împărțite în diverse tabele. Aceste complicații suplimentare complică lucrul ulterior cu această bază. Este greu de întreținut și înțeles.
În VictoriaMetrics, totul este mult mai simplu. Acolo, fiecare time series reprezintă un key-value. Valoarea este un set de puncte – (timestamp, value), iar cheia este un set label=value. Nu există nicio separare între fields și measurements. Acest lucru vă permite să selectați orice date și apoi să le combinați, să le adunați, să le scădeți, să le multiplicați, să le împărțiți, spre deosebire de InfluxDB, unde calculările între diferite serii nu sunt în continuare implementate, din câte știu. Chiar dacă ar fi implementate, ar fi dificil, ar trebui să scrieți o mulțime de cod.
Am o întrebare de clarificare. Am înțeles eu corect că a existat o problemă despre care ați menționat că acest index inversat nu încape în memorie, de aceea există partiționarea?
La început, am arătat o implementare simplistă a indexului inversat pe o mapă standard Go. O astfel de implementare nu este potrivită pentru baze de date, deoarece acest index inversat nu este salvat pe disc, iar baza de date trebuie să salveze pe disc pentru ca, la repornire, aceste date să rămână accesibile. În această implementare, la repornirea aplicației, indexul inversat va dispărea. Și veți pierde accesul la toate datele, deoarece nu veți putea să le găsiți.
Bună ziua! Vă mulțumesc pentru prezentare! Mă numesc Pavel. Sunt de la compania Wildberries. Am câteva întrebări pentru dumneavoastră. Prima întrebare. Credeți că, dacă ați fi ales un alt principiu la construirea arhitecturii aplicației dumneavoastră și ați fi partiționat datele în funcție de timp, ați fi putut să faceți intersecții ale datelor în căutare, bazându-vă doar pe faptul că într-o partiție se află datele pentru un anumit interval de timp? Adică pentru un singur interval de timp și nu ar fi trebuit să vă faceți griji că aveți date răspândite diferit? Întrebarea numărul 2 — deoarece implementați un astfel de algoritm cu bitset și tot restul, ați încercat să utilizați instrucțiunile procesorului? Poate ați încercat astfel de optimizări?
Răspund imediat la a doua întrebare. Până acum nu am ajuns acolo. Dar dacă va fi nevoie, vom ajunge. Iar prima, care a fost întrebarea?
Ați discutat două scenarii. Și ați spus că ați ales al doilea cu o implementare mai complexă. Și nu ați preferat primul, unde datele sunt partiționate în funcție de timp.
Da. În primul caz, volumul total al indicelui ar fi fost mai mare, deoarece în fiecare partiție ar fi trebuit să stocăm duplicate de date pentru seriile temporale care continuă prin toate aceste partiții. Și dacă rata de churn a seriilor temporale este mică, adică aceleași serii sunt folosite constant, atunci în primul caz am fi pierdut mult mai mult în ceea ce privește spațiul de stocare comparativ cu al doilea caz.
Așa este – partiționarea pe timp este o opțiune bună. O utilizează Prometheus. Dar în Prometheus există un alt dezavantaj. La unirea acestor fragmente de date, trebuie să păstreze în memorie informațiile meta pentru toate etichetele și seriile temporale. Așadar, dacă fragmentele de date sunt mari, pe care le unește, consumul de memorie crește foarte mult în timpul unirii, spre deosebire de VictoriaMetrics. La unirea VictoriaMetrics, consumul de memorie este practic inexistent, se consumă câțiva kilobiți, indiferent de dimensiunile fragmentelor de date unite.
Algoritmul pe care îl utilizați folosește memorie. Aici sunt notate etichetele seriilor temporale care au valori. Astfel, verificați existența pereche în un array de date și în altul. Și înțelegeți – a avut loc un intersect sau nu. De obicei, bazele de date implementează cursori, iteratori care stochează starea lor curentă și care parcurg datele sortate, astfel încât aveți o complexitate simplă pentru aceste operațiuni.
De ce nu folosim cursori pentru intersecția datelor?
Da.
În LevelDB sau în mergeset avem de fapt linii sortate. Putem să ne plimbăm cu un cursor și să găsim intersecția. Dar de ce nu folosim? Pentru că – este lent. Pentru că cursori implică apelarea unei funcții pentru fiecare linie. Apelul unei funcții durează 5 nanosecunde. Și dacă aveți 100.000.000 de linii, se dovedește că cheltuim o jumătate de secundă doar pentru apelul funcției.
Există așa ceva, da. Și ultima mea întrebare. Întrebarea poate părea puțin ciudată. De ce, în momentul în care sosesc datele, nu putem calcula toate agregatele necesare și să le salvăm în forma necesară? De ce să păstrăm volume uriașe în sisteme precum VictoriaMetrics, ClickHouse etc., pentru a pierde apoi foarte mult timp cu ele?
Voi da un exemplu pentru a fi mai clar. Să presupunem că, cum funcționează un mic vitezometru de jucărie? Acesta înregistrează distanța parcursă, adunând constant într-o mărime și timpul în cealaltă. Apoi împarte. Și obține viteza medie. Poți face ceva similar. Acumulând în timp toate faptele necesare.
Bine, am înțeles întrebarea. Exemplul tău are relevanță. Dacă știi ce agregate sunt necesare, atunci aceasta este cea mai bună implementare. Dar problema este că oamenii păstrează aceste metrici, unele date în ClickHouse și nu știu încă cum vor aggrega, filtra aceste date în viitor, așa că sunt nevoiți să păstreze toate datele brute. Dar dacă știi că trebuie să calculezi ceva mediu, de ce să nu-l calculezi, în loc să păstrezi o mulțime de valori brute acolo? Dar asta doar dacă știi exact ce ai nevoie.
Între timp, bazele de date pentru stocarea seriilor temporale suportă calculul agregatelor. De exemplu, Prometheus suportă . Adică, acest lucru poate fi realizat dacă știi ce agregate îți vor fi necesare. În VictoriaMetrics acest lucru nu există încă, dar de obicei este plasat Prometheus înainte de aceasta, unde se poate face în regulile de înregistrare.
De exemplu, la locul meu anterior de muncă a fost necesar să se calculeze numărul de evenimente într-un interval mobil în ultima oră. Problema era că a trebuit să fac o implementare personalizată în Go, adică un serviciu pentru a calcula acest lucru. Acest serviciu a fost, în cele din urmă, non-trivial, deoarece este complicat de calculat. Implementarea poate fi simplă dacă trebuie să calculezi anumite agregate pe intervale fixe de timp. Dacă vrei să calculezi evenimente într-un interval mobil, atunci nu este atât de simplu cum pare. Cred că acest lucru nu este încă implementat în ClickHouse sau în bazele de date pentru serii temporale, deoarece este complicat de realizat.
Și încă o întrebare. Tocmai am discutat despre medie și mi-am adus aminte că a fost odată o soluție numită Graphite cu backend-ul Carbon. Și acesta putea să reducă datele vechi, adică să lase un punct pe minut, un punct pe oră etc. În principiu, este destul de convenabil dacă avem nevoie de date brute, să spunem, pe parcursul unei luni, iar toate celelalte pot fi reduse. Dar Prometheus, VictoriaMetrics nu suportă această funcționalitate. Este planificat să suporte? Dacă nu, de ce?
Mulțumim pentru întrebare. Utilizatorii noștri o pun periodic. Întreabă când vom adăuga suport pentru reducerea numărului de date (downsampling). Aici sunt câteva probleme. În primul rând, fiecare utilizator înțelege prin downsampling ceva diferit: unii doresc să obțină un punct arbitrar într-un interval dat, alții doresc valorile maxime, minime sau medii. Dacă pentru baza dumneavoastră de date scriu date multe sisteme, nu puteți să le tratați pe toate la fel. Poate să se dovedească că pentru fiecare sistem trebuie folosit un tip diferit de downsampling. Și asta este complicat de implementat.
Și al doilea aspect este că VictoriaMetrics, la fel ca și ClickHouse, este optimizată pentru a lucra cu volume mari de date brute, de aceea poate procesa un miliard de linii în mai puțin de o secundă, dacă aveți multe nuclee în sistemul dumneavoastră. Scanarea punctelor din seria temporală în VictoriaMetrics este de 50.000.000 puncte pe secundă pe un nucleu. Iar această performanță se scalează pe nuclee disponibile. Adică, dacă aveți 20 de nuclee, de exemplu, veți obține scanarea unui miliard de puncte pe secundă. Și această proprietate a VictoriaMetrics și ClickHouse reduce necesitatea de downsampling.
O altă caracteristică este că VictoriaMetrics comprimă eficient aceste date. Comprimarea este în medie între 0,4 și 0,8 biți pe punct în producție. Fiecare punct este un timestamp + valoare. Și se comprimă la mai puțin de un byte în medie.
Sergei. Am o întrebare. Care este cantitatea minimă de timp pentru scriere?
O milisecundă. Recent am avut o discuție cu alți dezvoltatori de baze de date pentru serii temporale. La ei, cantitatea minimă de timp este de o secundă. În Graphite, de exemplu, tot o secundă. În OpenTSDB, de asemenea, o secundă. În InfluxDB, precizia este de nanosecunde. În VictoriaMetrics – o milisecundă, deoarece în Prometheus este de o milisecundă. Și VictoriaMetrics a fost dezvoltată inițial ca stocare externă pentru Prometheus. Dar acum poate salva date și din alte sisteme.
Persoana cu care am discutat spune că au o precizie de o secundă – le este suficient, deoarece depinde de tipul de date care sunt salvate în baza de date pentru serii temporale. Dacă sunt date DevOps sau date de la infrastructură, unde le colectați la un interval de 30 de secunde, într-un minut, atunci precizia de o secundă este suficientă, mai puțin nu este necesar. Dar dacă colectați aceste date din sistemele de tranzacționare de înaltă frecvență, atunci este nevoie de precizie de nanosecunde.
Precision in milliseconds with VictoriaMetrics is suitable for both DevOps cases and can work for the majority of the cases I mentioned at the beginning of the presentation. The only exception might be high frequency trading systems.
Thank you! And one more question. What is the compatibility in PromQL?
Complete backward compatibility. VictoriaMetrics fully supports PromQL. Additionally, it introduces extra extended functionality to PromQL called . There is a presentation on this extended functionality available on YouTube. I spoke about it at the Monitoring Meetup in spring in St. Petersburg.
Telegram channel .
Numai utilizatorii înregistrați pot participa la sondaj. , vă rugăm.
What prevents you from switching to VictoriaMetrics as a long-term storage solution for Prometheus? (Please write in the comments, I will add it to the survey))
71,4%I'm not using Prometheus5
28,6%I didn't know about VictoriaMetrics2
7 users voted. 12 users abstained.
Sursa: habr.com
