

Bună, comunitate Hub. Continuăm să împărtășim materiale interesante înainte de lansarea noilor cursuri. Astăzi, special pentru voi, am tradus un articol despre Google Cloud Spanner, corelându-l cu lansarea cursului. .
Publicat inițial în .
Ca o companie care oferă o gamă variată de soluții POS cloud pentru comercianți cu amănuntul, restauratori și vânzători online din întreaga lume, Lightspeed utilizează mai multe tipuri diferite de platforme de baze de date pentru diverse cazuri de utilizare tranzacțională, analitică și de căutare. Fiecare dintre aceste platforme de baze de date are propriile sale puncte forte și slabe. Așadar, când Google a introdus pe piață Cloud Spanner - o soluție promițătoare cu caracteristici nemaiîntâlnite în lumea bazelor de date relaționale, cum ar fi scalabilitatea orizontală aproape nelimitată și un SLA de 99,999% - nu am putut rata ocazia de a o avea în mâinile noastre!
Pentru a oferi o imagine de ansamblu cuprinzătoare a experienței noastre cu Cloud Spanner, precum și a criteriilor de evaluare pe care le-am folosit, vom discuta următoarele subiecte:
- Criteriile noastre de evaluare
- Cloud Spanner în câteva cuvinte
- Evaluarea noastră
- Concluziile noastre
1. Criteriile noastre de evaluare
Înainte de a ne aprofunda în caracteristicile Cloud Spanner, similaritățile și diferențele sale față de alte soluții de pe piață, să discutăm mai întâi despre principalele cazuri de utilizare pe care le-am avut în vedere când ne-am gândit unde să implementăm Cloud Spanner în infrastructura noastră:
- Ca o alternativă (dominantă) la soluția tradițională pentru baze de date SQL
- Ca soluție OLTP cu suport OLAP
Notă: Pentru simplificare și comoditate în comparație, acest articol compară Cloud Spanner cu variantele MySQL ale soluțiilor GCP Cloud SQL și Amazon AWS RDS.
Utilizarea Cloud Spanner ca alternativă la soluția tradițională pentru baze de date SQL
Într-un mediu al bazelor de date traditionale, atunci când timpul de răspuns la o interogare de bază de date se apropie sau chiar depășește valorile prag definite anterior de aplicație (în principal din cauza creșterii numărului de utilizatori și/sau interogărilor), există mai multe modalități de a reduce timpul de răspuns la niveluri acceptabile. Cu toate acestea, majoritatea acestor soluții necesită intervenție manuală.
De exemplu, primului pas pe care trebuie să-l facem este să ne uităm la diferitele parametrii ai bazei de date, legate de performanță, și să le ajustăm astfel încât să corespundă cel mai bine scenariilor de utilizare a aplicațiilor. Dacă acesta se dovedește a fi insuficient, se poate opta pentru scalarea verticală sau orizontală a bazei de date.
Scalarea verticală a aplicației implică actualizarea instanței serverului, de obicei prin adăugarea de mai mulți procesoare/core, memorie RAM suplimentară, stocare mai rapidă etc. Adăugarea de resurse hardware suplimentare duce la creșterea performanței bazei de date, măsurată în principal în tranzacții pe secundă și latența tranzacțiilor pentru sistemele OLTP. Sistemele de baze de date relaționale (care utilizează o abordare multi-threaded), cum ar fi MySQL, se scalaza bine pe verticală.
Această abordare are câteva dezavantaje, dar cel mai evident este dimensiunea maximă a serverului disponibil pe piață. Odată ce se atinge limita celei mai mari instanțe a serverului, nu mai rămâne decât o singură cale: scalarea orizontală.
Scalarea orizontală este o abordare prin care se adaugă mai multe servere în cluster, cu scopul de a crește ideal performanța în mod liniar prin adăugarea de servere. Majoritatea al bazelor de date sistemelor de baze de date se scalaza prost pe orizontală sau deloc. De exemplu, MySQL poate scala orizontal pentru operațiuni de citire, adăugând cititori slave, dar nu poate scala orizontal pentru operațiuni de scriere.
Pe de altă parte, datorită naturii sale, Cloud Spanner se poate scalaza cu ușurință orizontal cu un minim de intervenție.
Sistem de gestionare a bazelor de date complet funcțional ca serviciu trebuie evaluat din mai multe perspective. Ca bază, am luat cea mai populară bază de date din cloud - pentru Google, GCP Cloud SQL și pentru Amazon, AWS RDS. În evaluarea noastră ne-am concentrat pe următoarele categorii:
- Compararea funcționalităților: extensia SQL, DDL, DML; biblioteci de conexiune/conectori, suport pentru tranzacții etc.
- Suport pentru dezvoltare: ușurința dezvoltării și testării.
- Suport de administrare: gestionarea instanțelor - de exemplu, scalarea în sus/în jos și actualizarea instanțelor; SLA, backup și restaurare; securitate/controlul accesului.
Utilizarea Cloud Spanner ca soluție OLTP cu suport OLAP
Deși Google nu afirmă în mod explicit că Cloud Spanner este destinat prelucrării analitice, el împărtășește unele atribute cu alte mecanisme, precum Apache Impala & Kudu și YugaByte, care sunt dedicate sarcinilor de lucru OLAP.
Chiar dacă ar exista doar o mică probabilitate ca Cloud Spanner să includă un motor HTAP (prelucrare hibridă tranzacțională/analitică) scalabil orizontal, cu un set de funcții OLAP (mai mult sau mai puțin) utilizabil, credem că ar merita atenția noastră.
Având în vedere acest aspect, am examinat următoarele categorii:
- Încărcarea datelor, indici și suport pentru partiționare
- Performanța interogărilor și DML
2. Cloud Spanner în câteva cuvinte
Google Spanner este un sistem de gestionare a bazelor de date relaționale (RDBMS) de tip cluster, pe care Google îl folosește pentru mai multe servicii proprii. Google l-a făcut disponibil publicului pentru utilizatorii Google Cloud Platform la începutul anului 2017.
Iată câteva dintre atributele Cloud Spanner:
- Cluster RDBMS foarte sincronizat și scalabil: folosește sincronizarea hardware a timpului pentru a asigura consistența datelor.
- Suport pentru tranzacții încrucișate între tabele: tranzacțiile pot cuprinde mai multe tabele - nu trebuie să se limiteze la o singură tabelă (spre deosebire de Apache HBase sau Apache Kudu).
- Tabele pe baza cheii primare: toate tabelele trebuie să aibă o cheie primară (PK) declarată, care poate consta din mai multe coloane ale tabelei. Datele tabelare sunt stocate în ordinea PK, ceea ce le face foarte eficiente și rapide pentru căutarea după PK. Ca și alte sisteme bazate pe PK, implementarea trebuie să fie modelată cu privire la cazurile de utilizare preconizate, pentru a obține .
- Tabele intercalate: tabelele pot avea dependențe fizice una față de cealaltă. Rândurile tabelului copil pot fi asociate cu rândurile tabelului părinte. Această abordare accelerează căutarea relațiilor care pot fi definite în etapa de modelare a datelor, de exemplu, în cazul co-locării clienților și a facturilor acestora.
- Indici: Cloud Spanner suportă indici secundari. Un index consta din coloanele indexate și toate coloanele cheie primare. La cerere, indexul poate conține și alte coloane neindexate. Indexul poate fi intercalat cu tabelul părinte pentru a accelera interogările. Indicii sunt supuși mai multor restricții, cum ar fi numărul maxim de coloane suplimentare stocate în index. De asemenea, interogările prin indici pot fi mai puțin directe decât în alte SGBD-uri.
„Cloud Spanner alege indexul automat doar în cazuri rare. În special, Cloud Spanner nu alege automat un index secundar dacă interogarea solicită orice coloane care nu sunt stocate în ».
- Acord de nivel de servicii (SLA): desfășurare într-o singură regiune cu SLA de 99,99%; desfășurări multiregionale cu SLA de 99,999%. Deși acordul de nivel de servicii este, în esență, doar un acord și nu o garanție, cred că angajații Google au date precise pentru a face o astfel de afirmație serioasă. (Pentru referință, 99,999% înseamnă 26,3 secunde de întrerupere a serviciului pe lună.)
- Mai mult:
Notă: Proiectul Apache Tephra adaugă suport extins pentru tranzacții în Apache HBase (de asemenea, acum implementat în Apache Phoenix ca versiune beta).
3. Evaluarea noastră
Așadar, am citit toate afirmațiile Google despre avantajele Cloud Spanner - scalarea orizontală practic nelimitată, menținând în același timp o consitență ridicată și un SLA foarte înalt. Deși aceste cerințe sunt, în orice caz, extrem de greu de atins, scopul nostru nu a fost să le contestăm. În schimb, să ne concentrăm asupra altor aspecte care îngrijorează cei mai mulți utilizatori de baze de date: integritatea și ușurința de utilizare.
Am evaluat Cloud Spanner ca o înlocuire pentru Sharded MySQL
Google Cloud SQL și Amazon AWS RDS, două dintre cele mai populare SGBD-uri OLTP pe piața cloud, dispun de un set foarte mare de funcții. Totuși, pentru a scala aceste baze de date dincolo de dimensiunea unei singure instanțe, este necesar să implementați o fragmentare a aplicațiilor. Această abordare generează o complexitate suplimentară atât pentru aplicații, cât și pentru administrare. Am analizat cum se integrează Spanner în scenariul combinării mai multor segmente într-o singură instanță și ce funcții (dacă există) ar putea fii necesar să fie sacrificate.
Suport pentru SQL, DML și DDL, precum și conector și biblioteci?
În primul rând, la lansarea cu orice bază de date, trebuie să creați un model de date. Dacă credeți că puteți conecta JDBC Spanner la instrumentul dumneavoastră SQL preferat, veți descoperi că puteți interoga datele cu ajutorul său, dar nu puteți folosi pentru a crea tabele sau pentru modificări (DDL) sau orice operațiuni de inserare/actualizare/ștergere (DML). JDBC oficial de la Google nu suportă niciuna dintre acestea.
„În prezent, driverele nu suportă operatorii DML sau DDL.”
Documentația Spanner
Cu consola GCP situația nu este mai bună — puteți trimite doar interogări SELECT. Din fericire, există un driver JDBC cu suport pentru DML și DDL de la comunitate, inclusiv tranzacții. . Deși acest driver este extrem de util, lipsa unui driver JDBC oficial din partea Google este surprinzătoare. Din fericire, Google oferă un suport destul de larg pentru bibliotecile client (bazate pe gRPC): C#, Go, Java, node.js, PHP, Python și Ruby.
Utilizarea practic obligatorie a API-urilor personalizate Cloud Spanner (din cauza lipsei DDL și DML în JDBC) impune anumite limitări pentru zonele de cod conexe, cum ar fi pool-urile de conexiuni sau cadrele de legătură a bazei de date (de exemplu, Spring MVC). Ca regulă generală, când folosiți JDBC puteți alege liber pool-ul de conexiuni preferat (de exemplu, HikariCP, DBCP, C3PO etc.), care a fost testat și funcționează bine. În cazul API-urilor personalizate Spanner, trebuie să ne bazăm pe cadrele/poolurile de legături/sesiuni pe care le-am creat noi înșine.
Construcția orientată pe cheia primară (PK) permite Cloud Spanner să fie foarte rapid în accesarea datelor prin PK, dar duce și la unele probleme cu interogările.
- Nu puteți actualiza valoarea cheii primare; trebuie mai întâi să ștergeți înregistrarea cu PK-ul original și să o inserați din nou cu o nouă valoare. (Aceasta este similară cu alte baze de date/mecanisme de stocare orientate pe PK.)
- Toți operatorii UPDATE și DELETE trebuie să indice PK în WHERE, prin urmare, nu pot exista operatori DELETE unde să se lase gol — trebuie să existe întotdeauna o subinterogare, de exemplu: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Lipsa opțiunii de auto-increment sau orice altceva care stabilește o secvență pentru câmpul PK. Pentru ca acest lucru să funcționeze, valoarea corespunzătoare trebuie generată din aplicație.
Indici secundari?
Google Cloud Spanner are suport încorporat pentru indicii secundari. Aceasta este o caracteristică foarte plăcută, care nu este întotdeauna prezentă în alte tehnologii. Apache Kudu nu suportă deloc indicii secundari în prezent, iar Apache HBase nu suportă indicii în mod direct, dar îi poate adăuga prin Apache Phoenix.
Indicii în Kudu și HBase pot fi modelați ca o tabelă separată cu un set diferit de chei primare, dar atomicitatea operațiunilor efectuate cu tabela părinte și tabelele de index asociate trebuie gestionată la nivelul aplicației și nu este trivială în implementarea corectă.
Așa cum s-a menționat în recenzia Cloud Spanner, indicii săi pot diferi de indicii MySQL. Prin urmare, ar trebui să fim deosebit de prudenți atunci când construim interogări și profilăm, pentru a ne asigura că folosim indicele corespunzător acolo unde este necesar.
Vederi?
Un obiect foarte popular și util în baza de date sunt vederile. Acestea pot fi utile pentru o mulțime de cazuri de utilizare; două dintre preferatele mele sunt nivelul de abstractizare logică și nivelul de securitate. Din păcate, Cloud Spanner nu suportă vederi. Cu toate acestea, aceasta ne limitează doar parțial, deoarece nu există detalii de permisiuni la nivel de coloană, unde vederile ar putea fi o soluție acceptabilă.
În documentația Cloud Spanner, în secțiunea care descrie în detaliu cotele și limitele (), există, în special, una care poate fi problematica pentru unele aplicații: Cloud Spanner are, din fabrică, o limitare de maximum 100 baze de date pe instanță. Evident, aceasta poate deveni un obstacol major pentru o bază de date care este destinată să scaleze la mai mult de 100 de baze de date. Din fericire, după ce am discutat cu reprezentantul nostru tehnic de la Google, am aflat că această limită poate fi crescută practic la orice valoare prin intermediul serviciului de suport Google.
Suport pentru dezvoltare?
Cloud Spanner oferă un suport destul de decent pentru limbajele de programare care lucrează cu API-ul său. Bibliotecile oficiale suportate sunt în domeniul C#, Go, Java, node.js, PHP, Python și Ruby. Documentația este destul de detaliată, dar, ca în cazul altor tehnologii avansate, comunitatea este destul de mică în comparație cu cele mai populare tehnologii de baze de date, ceea ce poate duce la o creștere a timpului necesar pentru a rezolva cazurile de utilizare sau problemele mai puțin comune.
Așadar, ce zici de suportul pentru dezvoltarea locală?
Nu am găsit o modalitate de a crea o instanță Cloud Spanner în medii locale. Cel mai apropiat lucru pe care l-am obținut este o imagine Docker , care este, în principiu, similară, dar în practică diferă considerabil. De exemplu, CockroachDB poate utiliza PostgreSQL JDBC. Deoarece mediu de dezvoltare ar trebui să fie cât mai aproape de mediul de producție, Cloud Spanner nu este ideal, deoarece trebuie să te bazezi pe o instanță completă Spanner. Pentru a economisi costurile, poți alege o instanță într-o singură regiune.
Suport pentru administrare?
Crearea unei instanțe Cloud Spanner este foarte simplă. Trebuie doar să alegi între crearea unei instanțe multiregiune sau a uneia pentru o singură regiune, să indici regiunea(e) și numărul de noduri. În mai puțin de un minut, instanța va fi pornită și gata de lucru.
Câteva metrici de bază sunt disponibile direct pe pagina Spanner din consola Google. Vederi mai detaliate sunt disponibile prin Stackdriver, unde poți, de asemenea, să stabilești limite pentru metrici și politici de alertă.
Acces la resurse?
MySQL oferă setări extinse și foarte detaliate pentru permisiunile/rolurile utilizatorilor. Accesul la o anumită tabelă sau chiar la un subgrup al coloanelor acesteia poate fi configurat cu ușurință. Cloud Spanner utilizează instrumentul Google Identity & Access Management (IAM), care permite stabilirea politicilor și permisiunilor doar la un nivel foarte înalt. Cea mai detaliată opțiune este permisiunea la nivel de bază de date, care nu se încadrează în majoritatea cazurilor de utilizare în producție. Această restricție te obligă să adaugi măsuri suplimentare de securitate în codul, infrastructura, sau ambele pentru a preveni utilizarea neautorizată a resurselor Spanner.
Backup-uri?
Pe scurt, nu există backup-uri în Cloud Spanner. Deși cerințele ridicate ale SLA-ului Google pot garanta că nu vei pierde date din cauza defectării hardware-ului sau a bazei de date, greșelilor umane, defectelor aplicațiilor etc., știm cu toții regula: disponibilitatea ridicată nu înlocuiește o strategie de backup rezonabilă. În prezent, singura modalitate de a face backup datelor este prin transmiterea lor programatică din baza de date într-un mediu de stocare separat.
Performanța interogărilor?
Pentru încărcarea datelor și testarea interogărilor, am folosit Yahoo! Cloud Serving Benchmark. Tabelul de mai jos prezintă sarcina de lucru B YCSB cu un raport de citire de 95% și scriere de 5%.
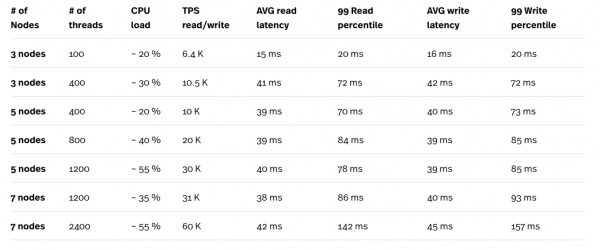
* Testul de încărcare a fost efectuat pe engine-ul de calcul (CE) n1-standard-32 (32 vCPU, 120 GB RAM), iar instanța de testare nu a fost niciodată un punct slab în teste.
** Numărul maxim de fire într-o instanță YCSB este de 400. A fost necesar să se execute șase instanțe paralele ale testelor YCSB, pentru a obține în total 2400 de fire.
Privind rezultatele testelor, în special combinația de sarcină pe procesor și TPS, vedem clar că Cloud Spanner se scalează destul de bine. Sarcina mare generată de un număr mare de fire este compensată de un număr considerabil de noduri în clusterul Cloud Spanner. Deși latența pare destul de mare, în special atunci când se lucrează cu 2400 de fire, poate fi necesar să se efectueze teste suplimentare cu 6 instanțe mai mici ale motorului de calcul pentru a obține numere mai precise. Fiecare instanță va rula un test YCSB în loc de o singură instanță mare CE cu 6 teste paralele. Astfel, va fi mai ușor să distingi între latențele cererilor Cloud Spanner și latențele adăugate de conexiunea de rețea între Cloud Spanner și instanța CE pe care se efectuează testul.
Cum se descurcă Cloud Spanner ca OLAP?
Partitionarea?
Împărțirea datelor în segmente fizic și/sau logic independente, numite partitii, este un concept foarte popular, specific majorității mecanismelor OLAP. Partitiile pot îmbunătăți semnificativ performanța interogărilor și mentenanța bazei de date. O aprofundare a partitiiilor ar necesita un articol (articole) separat, așadar să menționăm doar importanța existenței unei scheme de partitionare și sub-partitionare. Capacitatea de a împărți datele în partitii și chiar mai departe în subpartiții este esențială pentru performanța interogărilor analitice.
Cloud Spanner nu suportă partitii în sine. El împarte datele în interior în așa-numitele split-uri, pe baza intervalelor de cheie primară. Împărțirea se face automat pentru a echilibra sarcina în clusterul Cloud Spanner. O caracteristică foarte convenabilă a Cloud Spanner este că se împarte sarcina de bază a tabelului părinte (tabel care nu alternează cu altul). Spanner determină automat dacă split datele sunt accesate mai frecvent decât datele din alte split-uri și poate lua decizia de a desparte și mai mult. Astfel, mai multe noduri pot fi implicate în interogare, ceea ce crește eficiența lățimii de bandă.
Încărcarea datelor?
Metoda Cloud Spanner pentru date voluminoase este similară cu încărcarea obișnuită. Pentru a atinge performanța maximă, trebuie să urmați câteva recomandări, inclusiv:
- Sortează datele tale după cheia primară.
- Împărțiți-le în 10*numărul de noduri secțiuni separate.
- Creează un set de sarcini de lucru care să încarce datele în paralel.
Pentru această încărcare de date se folosesc toate nodurile Cloud Spanner.
Am folosit sarcina de lucru A YCSB pentru a genera un set de date din 10M de rânduri.
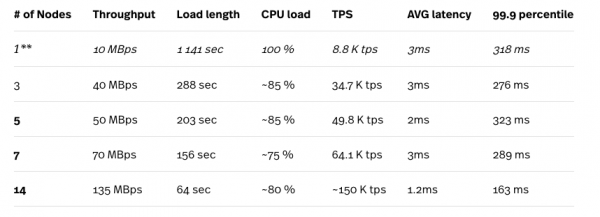
* Testul de încărcare a fost efectuat pe un motor de calcul n1-standard-32 (32 vCPU, 120 GB RAM), iar instanța de testare nu a fost niciodată un blocaj în teste.
** Configurația cu 1 nod nu este recomandată pentru nicio sarcină de producție.
După cum s-a menționat anterior, Cloud Spanner gestionează automat divizările în funcție de sarcina acestora, astfel încât rezultatele se îmbunătățesc după câteva repetiții succesive ale testului. Rezultatele prezentate aici sunt cele mai bune rezultate pe care le-am obținut. Privind numerele de mai sus, putem observa cum Cloud Spanner se scalează bine cu creșterea numărului de noduri din cluster. Numerele care ies în evidență reprezintă latențe medii extrem de scăzute, care contrastează cu rezultatele sarcinilor de lucru mixte (95% pentru citire și 5% pentru scriere), așa cum este descris în secțiunea de mai sus.
Scalare?
Creșterea și reducerea numărului de noduri Cloud Spanner este o sarcină realizată cu un singur clic. Dacă doriți să încărcați rapid datele, puteți lua în considerare maximizarea instanței (în cazul nostru a fost de 25 de noduri în regiunea US-EAST), apoi să reduceți numărul de noduri potrivit pentru încărcarea dumneavoastră obișnuită, după ce toate datele sunt în baza de date, având în vedere limita de 2 TB/nod.
Am fost reamintiți de această limită chiar și cu o bază de date mult mai mică. După câteva runde de teste de încărcare, baza noastră de date avea o dimensiune de aproximativ 155 GB, iar când am redus la o instanță cu 1 nod, am primit următoarea eroare:
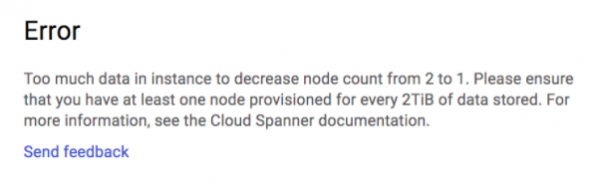
Am reușit să reducem scalarea de la 25 la 2 instanțe, dar am rămas blocați cu două noduri.
Creșterea și micșorarea numărului de noduri din clusterul Cloud Spanner poate fi automatizată prin intermediul REST API-ului. Aceasta poate fi deosebit de utilă pentru reducerea încărcăturii mari asupra sistemului în orele de vârf.
Performanța interogărilor OLAP?
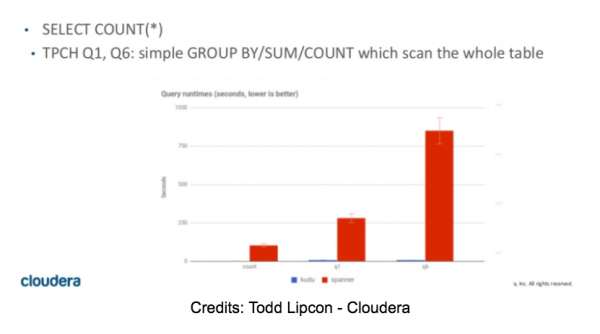
Inițial, am planificat să alocăm un timp considerabil evaluării noastre asupra Spanner pentru această parte. După câteva SELECT COUNT, ne-am dat seama imediat că testarea va fi scurtă și că Spanner NU va fi un motor potrivit pentru OLAP. Indiferent de numărul de noduri din cluster, simpla interogare a numărului de rânduri dintr-o tabelă cu 10M de rânduri a durat între 55 și 60 de secunde. În plus, orice interogare care necesita o cantitate mai mare de memorie pentru stocarea rezultatelor intermediare a eșuat cu eroarea OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M valori distincte)-> SpoolingHashAggregateIterator a rămas fără memorie în timpul adăugării unui nou rând.
Unele cifre pentru interogările TPC-H pot fi găsite în articolul lui Todd Lipkon , diapozitivele 42 și 43. Aceste cifre sunt în concordanță cu propriile noastre rezultate (din păcate).
4. Concluziile noastre
Având în vedere starea actuală a funcțiilor Cloud Spanner, este greu de imaginat că poate fi o înlocuire simplă pentru soluțiile OLTP existente, mai ales când nevoile dumneavoastră vor depăși limitele sale. Ar trebui să fie cheltuit un timp considerabil pentru a construi o soluție care să țină cont de dezavantajele Cloud Spanner.
Când am început evaluarea Cloud Spanner, ne-am așteptat ca funcțiile de gestionare să fie la nivelul altor soluții Google SQL, sau cel puțin nu foarte departe de ele. Dar am fost surprinși de lipsa totală a copiilor de siguranță și de controlul extrem de limitat al accesului la resurse. Nefiind menționat lipsa vederilor, a mediului local de dezvoltare, a secvențelor neacceptate, JDBC fără suport DML și DDL și așa mai departe.
Așadar, unde să se ducă cineva care trebuie să scaleze o bază de date tranzacțională? Se pare că pe piață nu există încă o soluție unică care să se potrivească tuturor cazurilor de utilizare. Există multe soluții cu cod sursă închis și deschis (unele dintre ele fiind menționate în acest articol), fiecare având punctele sale forte și slabe, dar niciuna dintre ele nu oferă un SaaS cu SLA de 99,999% și un grad înalt de consistență. Dacă un nivel ridicat de SLA este obiectivul dumneavoastră principal și nu sunteți dispus să creați o soluție proprie pentru medii cloud multiple, Cloud Spanner ar putea fi soluția pe care o căutați. Dar trebuie să fiți conștienți de toate limitările sale.
Pentru corectitudine, trebuie menționat că Cloud Spanner a fost lansat pentru accesul public abia în primăvara anului 2017, așa că este rezonabil să ne așteptăm ca unele dintre deficiențele sale actuale să dispară în cele din urmă (sperăm), iar când se va întâmpla acest lucru, ar putea schimba jocul. La urma urmei, Cloud Spanner nu este doar un proiect de nișă pentru Google. Google îl folosește ca bază pentru alte produse Google. Iar când Google a înlocuit recent Megastore în Google Cloud Storage cu Cloud Spanner, acest lucru a permis Google Cloud Storage să devină strict consistent pentru listele de obiecte la nivel mondial (ceea ce nu se aplică încă pentru ).
Așadar, speranța încă există… sperăm.
Aceasta este tot. La fel ca autorul articolului, și noi continuăm să sperăm, dar voi ce părere aveți despre asta? Scrieți în comentarii.
Îi invităm pe toți să viziteze în cadrul căruia vom detalia cursul de la OTUS.
Sursa: habr.com
