

Vom discuta despre utilizarea Zabbix cu TimescaleDB ca backend. Vă vom arăta cum să porniți de la zero și cum să migrați de la PostgreSQL. De asemenea, vom prezenta teste comparative de performanță pentru cele două configurații.
HighLoad++ Siberia 2019. Sala „Tomsk”. 24 iunie, 16:00. Teze și . Cea de-a doua conferință HighLoad++ va avea loc pe 6 și 7 aprilie 2020 la Sankt Petersburg. Detalii și bilete .
Andrei Gușin (în continuare – AG): – Eu sunt inginer de suport tehnic la ZABBIX (în continuare – „Zabbix”), formator. Activez de mai bine de 6 ani în suportul tehnic și m-am confruntat direct cu performanța. Astăzi voi vorbi despre performanța pe care o poate oferi TimescaleDB, comparând-o cu PostgreSQL 10 obișnuit. De asemenea, voi oferi o prezentare generală despre modul în care funcționează.
Principalele provocări de performanță: de la colectare la curățarea datelor
Să începem prin a spune că există anumite provocări de performanță cu care se confruntă fiecare sistem de monitorizare. Prima provocare de performanță este colectarea și procesarea rapidă a datelor.
Un sistem de monitorizare bun trebuie să primească rapid și la timp toate datele, să le proceseze conform expresiilor trigger, adică să le proceseze în funcție de anumite criterii (în diferite sisteme este diferit) și să le salveze în baza de date pentru a putea fi utilizate ulterior.
A doua provocare de performanță este stocarea istoriei. Este important să păstrați în baza de date datele și să aveți acces rapid și convenabil la aceste metrici, care au fost colectate pe o anumită perioadă de timp. Cel mai important este să aveți ușurința de a obține aceste date, pentru a le folosi în rapoarte, grafice, trăgători, în anumite valori prag, pentru alerte etc.
A treia provocare de performanță este curățarea istoriei, adică atunci când ajungeți în acea zi în care nu mai este nevoie să păstrați anumite metrici detaliate, care au fost colectate în ultimii 5 ani (chiar și luni sau două luni). Anumite noduri din rețea au fost eliminate sau anumite gazde, iar metricile nu mai sunt necesare, deoarece au devenit învechite și nu mai sunt colectate. Totul trebuie curățat pentru a evita extinderea bazei de date la o dimensiune mare. În general, curățarea istoriei este, de cele mai multe ori, o provocare serioasă pentru stocare – afectează semnificativ performanța.
Cum să rezolvăm problemele de cache?
Acum voi vorbi în mod specific despre „Zabbix”. În „Zabbix”, prima și a doua apelare sunt rezolvate prin intermediul cache-ului.
Colectarea și procesarea datelor – folosim memoria RAM pentru a stoca toate aceste date. Acum, despre aceste date va fi vorbit mai în detaliu.
De asemenea, pe partea bazei de date există un anumit caching pentru selecțiile de bază – pentru grafice și alte elemente.
Caching pe serverul Zabbix în sine: avem ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Ce înseamnă acestea?
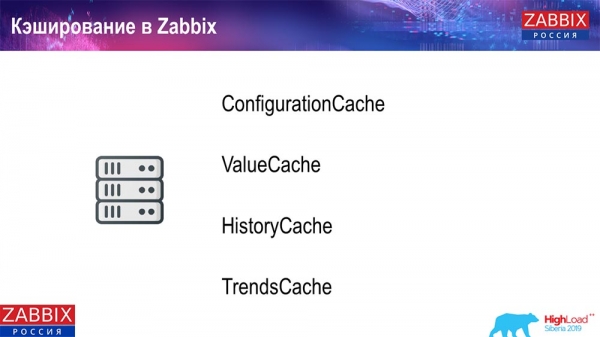
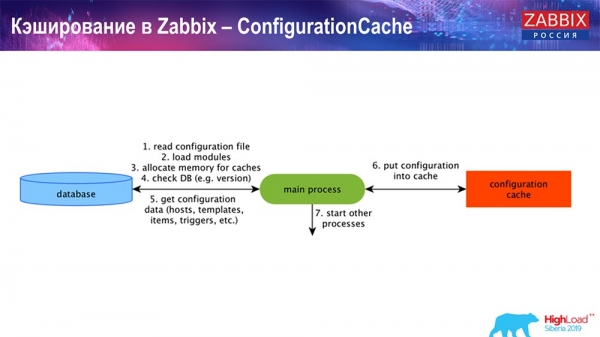
ConfigurationCache – acesta este cache-ul principal, unde stocăm metricele, gazdele, elementele de date, trigerii; tot ce este necesar pentru preprocesare, colectarea datelor, de pe ce gazde să colectăm, cu ce frecvență. Totul este stocat în ConfigurationCache, pentru a nu apela baza de date, a nu crea cereri suplimentare. După ce serverul pornește, actualizăm acest cache (îl creăm) și-l actualizăm periodic (în funcție de setările de configurare).
Caching în Zabbix. Colectarea datelor
Aici schema este destul de mare:
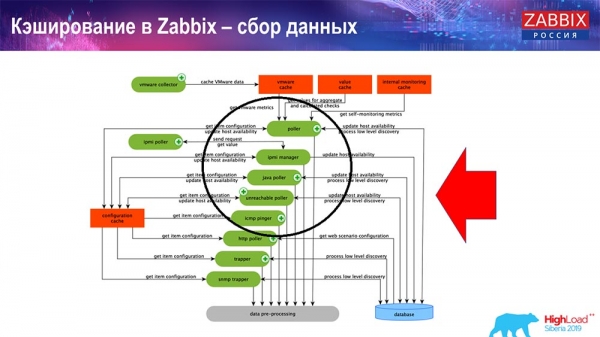
Principalele din schemă – acestea sunt colectoarele:
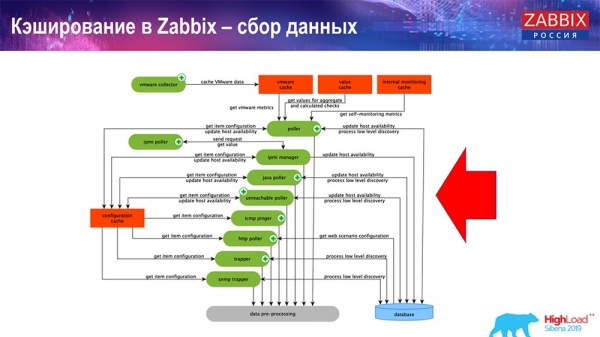
Acestea sunt procesele de colectare în sine, diferite „pollere” care se ocupă cu diferite tipuri de colectare. Ele colectează date prin icmp, ipmi, prin diferite protocoale și transmit toate acestea către preprocesare.
PreProcessing HistoryCache
De asemenea, dacă avem elemente de date calculabile (cei care sunt familiarizați cu „Zabbix” știu), adică elemente de date calculabile, de agregare – le extragem direct din ValueCache. Despre cum se umple acesta, voi povesti mai târziu. Toate aceste colectoare folosesc ConfigurationCache pentru a primi sarcinile lor și apoi le transmit pentru preprocesare.
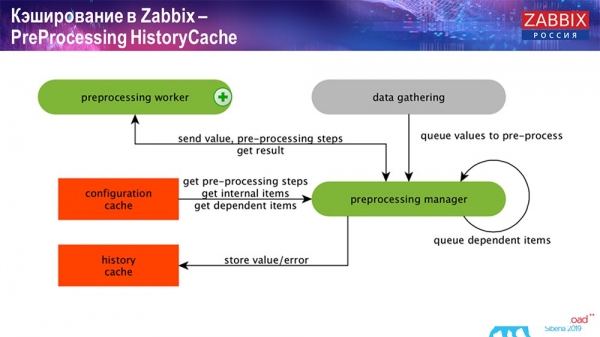
Preprocesarea utilizează de asemenea ConfigurationCache pentru obținerea pașilor preprocesării, procesează aceste date în diverse moduri. Începând cu versiunea 4.2, aceasta a fost mutată pe proxy. Este foarte convenabil, deoarece preprocesarea în sine este o operație destul de grea. Și dacă aveți un „Zabbix” foarte mare, cu un număr mare de elemente de date și o frecvență mare de colectare, atunci asta ușurează foarte mult munca.
Prin urmare, după ce am procesat aceste date într-un fel cu ajutorul preprocesării, le stocăm în HistoryCache pentru a le procesa ulterior. Aici se încheie colectarea datelor. Trecem la procesul principal.
Funcția History syncer
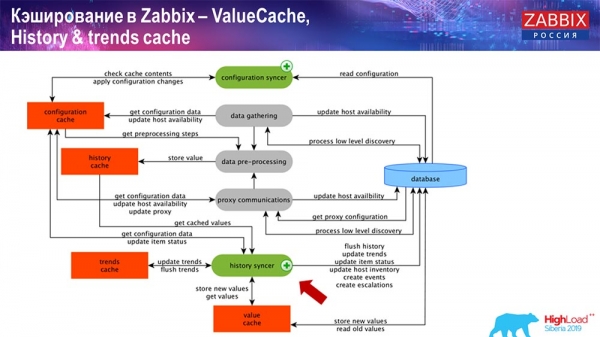
Principalul proces în «Zabbix» (deoarece este o arhitectură monolitică) este History syncer. Acesta este procesul principal care se ocupă de prelucrarea atomica a fiecărui element de date, adică a fiecărui valoare:
- primește valoarea (o preia din HistoryCache);
- verifică în Configuration syncer: există vreo regulă pentru calculare - le calculează;
dacă există - creează evenimente, creează escaladări pentru a genera o notificare, dacă este necesar conform configurației; - înregistrează regulile pentru prelucrarea ulterioară, agregare; dacă agregi pentru ultima oră și așa mai departe, această valoare este memorată de ValueCache, pentru a nu face referire la tabelul istoric; astfel, ValueCache se completează cu datele necesare pentru calcularea regulilor, a elementelor calculate etc.;
- apoi History syncer scrie toate datele în baza de date;
- baza de date le scrie pe disc - procesul de prelucrare se finalizează aici.
Baze de date. Cache-uri
Pe partea bazei de date, când vrei să vizualizezi grafice sau diverse rapoarte despre evenimente, există diferite cache-uri. Dar în cadrul acestei prezentări nu voi discuta despre ele.
Pentru MySQL există Innodb_buffer_pool, o mulțime de cache-uri diferite care pot fi de asemenea configurate.
Dar acestea sunt principalele:
- shared_buffers;
- effective_cache_size;
- shared_pool.
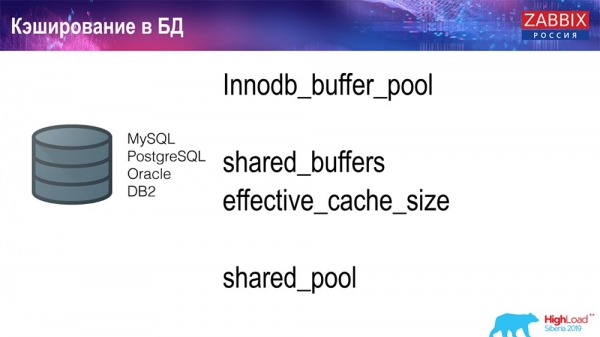
Am prezentat pentru toate bazele de date că există anumite cache-uri care permit păstrarea în memorie a datelor care sunt frecvent necesare pentru interogări. Acestea au propriile tehnologii pentru asta.
Despre performanța bazei de date
Prin urmare, există un mediu concurential, adică serverul Zabbix colectează date și le stochează. La repornire, de asemenea, citește din istorie pentru a completa ValueCache și așa mai departe. De asemenea, pot exista scripturi și rapoarte care utilizează API-ul Zabbix, care este construit pe baza interfeței web. API-ul Zabbix intră în baza de date și obține datele necesare pentru a genera grafice, rapoarte sau o listă a evenimentelor, ultimelor probleme.
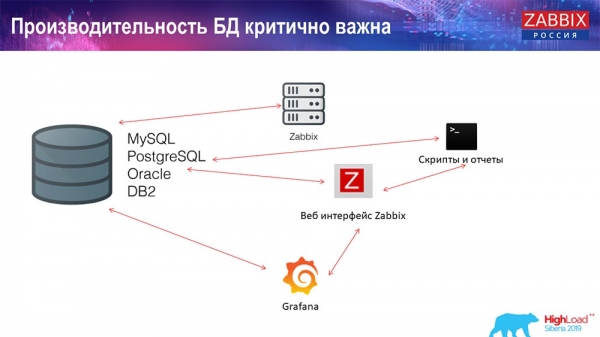
De asemenea, o soluție foarte populară pentru vizualizare este Grafana, utilizată de utilizatorii noștri. Aceasta poate accesa direct atât prin API-ul Zabbix, cât și prin baza de date. De asemenea, creează o anumită competiție pentru obținerea datelor: este necesară o configurare mai rafinată și bună a bazei de date, pentru a asigura o livrare rapidă a rezultatelor și testarea.
Curățarea istoricului. În Zabbix există Housekeeper
A treia apelare utilizată în «Zabbix» este curățarea istoricului cu ajutorul Housekeeper. «Housekeeper» respectă toate setările, adică în elementele de date este specificat cât timp să păstrați (în zile), cât timp să păstrați tendințele și dinamica schimbărilor.
Nu am povestit despre TrendCache, pe care îl calculăm pe loc: datele sosesc, le agregăm pe parcursul unei ore (de obicei sunt numere pentru ultima oră), cantitatea medie / minimă și le înregistrăm o dată pe oră în tabelul dinamicii schimbărilor («Trends»). «Housekeeper» este activat și șterge datele din baza de date cu selecții obișnuite, ceea ce nu este întotdeauna eficient.
Cum se poate înțelege că nu este eficient? Puteți vedea în graficele de performanță a proceselor interne această imagine:
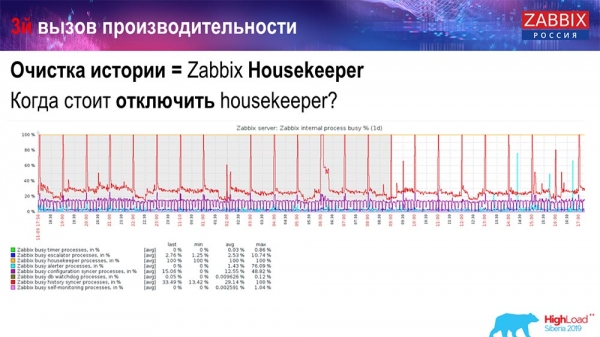
Aveți și History syncer constant ocupat (grafic roșu). Iar graficul „portocalie”, care se află deasupra. Acesta este «Housekeeper», care este activat și așteaptă de la baza de date să șteargă toate rândurile pe care le-a specificat.
Să luăm un anumit ID de element: trebuie să ștergem ultimele 5.000; desigur, pe baza indicilor. Dar, în general, setul de date este suficient de mare – baza de date tot trebuie să citească de pe disc și să-l aducă în cache, iar aceasta este o operațiune foarte costisitoare pentru baza de date. În funcție de dimensiunile acesteia, acest lucru poate duce la anumite probleme de performanță.
Dezactivarea «Housekeeper» se poate face simplu – avem interfața web cunoscută. Setările din Administration general (setările pentru «Housekeeper») dezactivăm housekeeping-ul intern pentru istoricul și tendințele interne. Prin urmare, «Housekeeper» nu mai gestionează acest lucru:
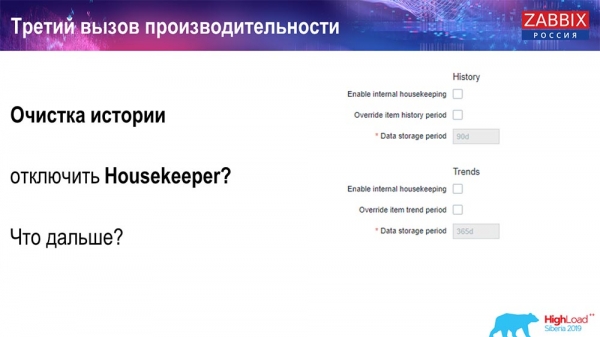
Ce se poate face mai departe? Ați dezactivat, graficele s-au aliniat… Ce probleme ar putea apărea în continuare? Ce ar putea ajuta?
Partiționarea
În general, aceasta se configurează pe fiecare bază de date relațională menționată de mine, într-un mod diferit. MySQL are propria tehnologie. Dar, în general, sunt foarte asemănătoare, vorbim despre PostgreSQL 10 și MySQL. Desigur, există multe diferențe interne în modul în care este implementat totul și modul în care afectează performanța. Însă, în general, crearea unei noi partiții duce adesea și la anumite probleme.
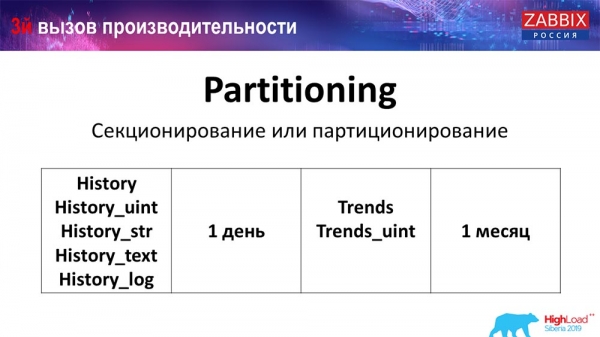
În funcție de configurația dvs. (cât de multe date generați într-o singură zi), de obicei se stabilește cea mai minimă – este de 1 zi/partiție, iar pentru „tendințe”, dinamica schimbărilor – 1 lună/partiție nouă. Aceasta poate varia dacă aveți o configurație foarte mare.
Să vă spun de la început despre dimensiunile configurației: până la 5.000 de valori noi pe secundă (nvps, așa-numitul) – acesta va fi considerat un «set-up» mic. Mediu – de la 5 la 25 de mii de valori pe secundă. Tot ce depășește – este deja instalații mari și foarte mari, care necesită o configurare foarte atentă a bazei de date.
Pe instalațiile foarte mari, 1 zi – ar putea să nu fie optim. Personal, am văzut în MySQL partiții de 40 de gigabaiți pe zi (și ar putea fi chiar mai mult). Acesta este un volum foarte mare de date, care poate duce la anumite probleme. Trebuie să fie redus.
De ce este necesară partiționarea?
Ce aduce partiționarea, cred că toată lumea știe – este secționarea tabelelor. Adesea sunt fișiere separate pe disc și interogări span. Este mai optim să selectezi o partiție, dacă aceasta este inclusă în partiționarea obișnuită.
Pentru «Zabbix», în special, se folosește pe interval, adică folosim timestamp (un număr obișnuit, timp de la începutul epocii). Stabiliți începutul zilei/terminarea zilei, iar aceasta reprezintă partiția. În consecință, dacă accesați datele cu două zile în urmă, acestea sunt selectate mai repede din baza de date, deoarece trebuie să încărcați doar un fișier în cache și să-l emiteți (nu o tabelă mare).
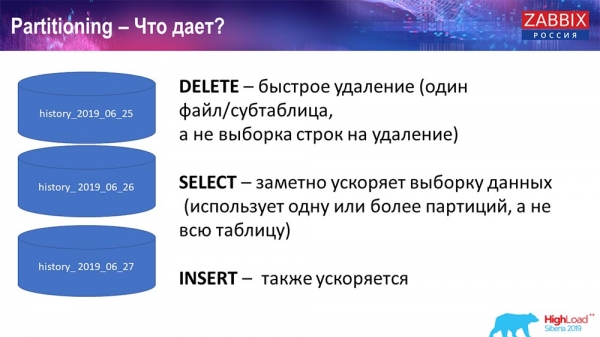
Multe baze de date, de asemenea, accelerează inserarea (inserarea într-o sub-tabelă). Deși vorbesc abstract în acest moment, dar este posibil. Partiționarea ajută adesea.
Elasticsearch pentru NoSQL
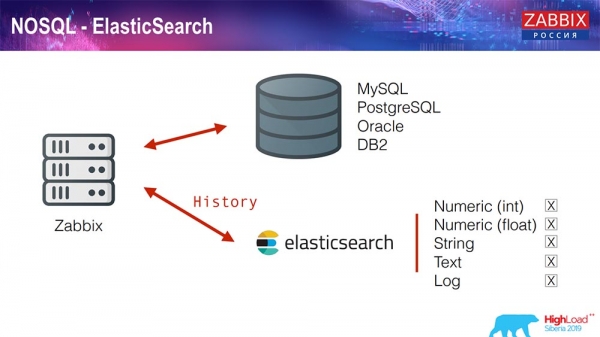
Recent, în 3.4, am implementat o soluție pentru NoSQL. Am adăugat posibilitatea de a scrie în Elasticsearch. Puteți scrie anumite tipuri: alegeți – fie scrieți numere, fie câteva semne; avem text de tip șir, puteți scrie jurnale în Elasticsearch... În consecință, interfața web va apela deja la Elasticsearch. Aceasta funcționează excelent în anumite cazuri, dar în prezent poate fi utilizată.
TimescaleDB. Hiper-tabele
Pentru versiunea 4.4.2, am observat un lucru, și anume TimescaleDB. Ce este aceasta? Este o extensie pentru PostgreSQL, adică are o interfață nativă PostgreSQL. În plus, această extensie permite o gestionare mult mai eficientă a datelor de tip time-series și oferă partajare automată. Cum arată asta:
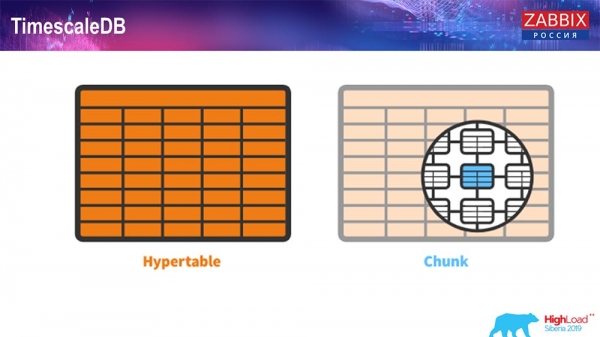
Aceasta este o hypertable – un concept din Timescale. Este o hiper-tabelă pe care o creați, iar în ea se află chunk-uri. Chunk-urile sunt partiții, sunt sub-tabele, dacă nu mă înșel. Este într-adevăr eficient.
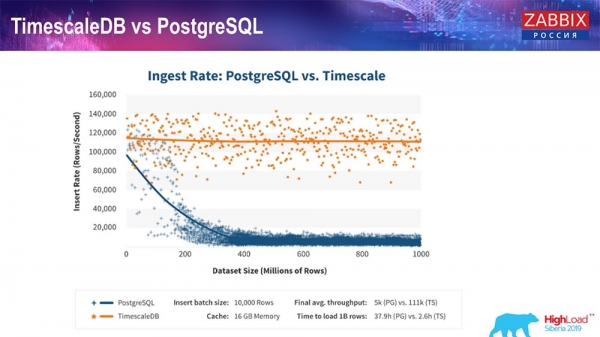
TimescaleDB și PostgreSQL
Așa cum susțin producătorii TimescaleDB, aceștia folosesc un algoritm mai corect pentru gestionarea interogărilor, în special pentru inserții, care permite menținerea unei performanțe aproape constante pe măsură ce dimensiunea dataset-ului de inserții crește. Adică după 200 de milioane de rânduri, PostgreSQL începe să încetinească semnificativ și pierde performanța practic la zero, în timp ce Timescale permite inserarea datelor cât mai eficient, indiferent de cantitatea de date.
Cum se instalează TimescaleDB? Este simplu!
Este descris în documentație – poate fi instalat din pachete pentru orice... Depinde de pachetele oficiale PostgreSQL. Poate fi compilat manual. Așa s-a întâmplat că a trebuit să compilez pentru baza de date.
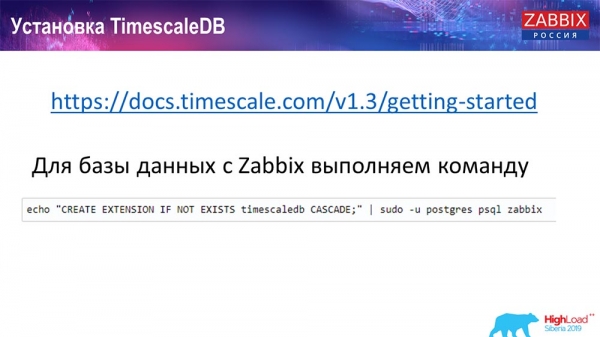
Pe Zabbix, pur și simplu activăm extensia. Cred că cei care au folosit extensia în PostgreSQL... Pur și simplu activați extensia, o creați pentru baza de date Zabbix pe care o folosiți.
Și ultimul pas...
TimescaleDB. Migrarea tabelelor de istorie
Trebuie să creați o hypertable. Există o funcție specială pentru asta – Create hypertable. Primul parametru indică tabelul necesar în această bază de date (pentru care trebuie creată hipertabela).
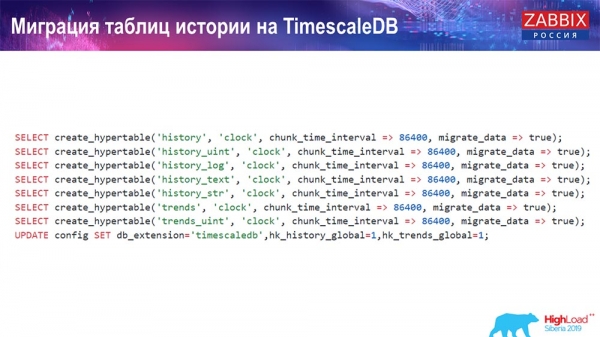
Câmpul pe care trebuie să-l creați și chunk_time_interval (acesta este intervalul chunk-urilor (partițiilor care trebuie utilizate). 86 400 – este o zi.
Parametrul migrate_data: dacă îl setați pe true, va muta toate datele curente în chunk-urile deja create.
Eu am folosit migrate_data – durează un timp considerabil, în funcție de dimensiunea bazei de date. Am avut peste un terabyte – crearea a durat mai mult de o oră. În unele cazuri, în timpul testării, am șters datele istorice pentru text (history_text) și string (history_str), pentru a nu le muta – pentru că, de fapt, nu m-au interesat.
Și ultima actualizare o facem în extensia noastră db_extention: instalăm timescaledb, astfel încât baza de date și, în special, „Zabbix”, să înțeleagă că există o extensie db. Aceasta o activează și folosește sintaxa și interogările corecte către baza de date, folosind deja acele „funcționalități” necesare pentru TimescaleDB.
Configurarea serverului
Am folosit două servere. Primul server este o mașină virtuală destul de mică, cu 20 de procesoare și 16 gigabytes de memorie RAM. Am configurat pe ea „PostgreSQL” 10.8:
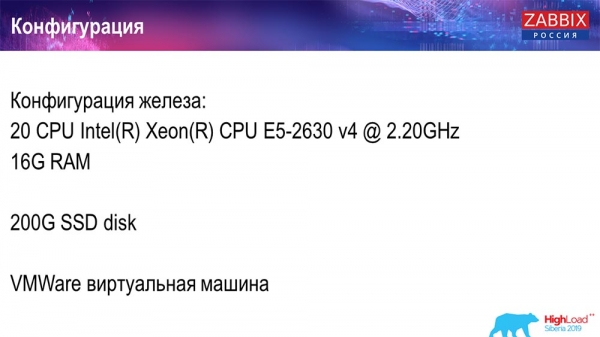
Sistemul de operare a fost Debian, sistemul de fișiere – xfs. Am realizat setări minime pentru a utiliza această bază de date, în afară de ceea ce va folosi însăși „Zabbix”. Pe această mașină se află serverul „Zabbix”, PostgreSQL și agenți de încărcare.
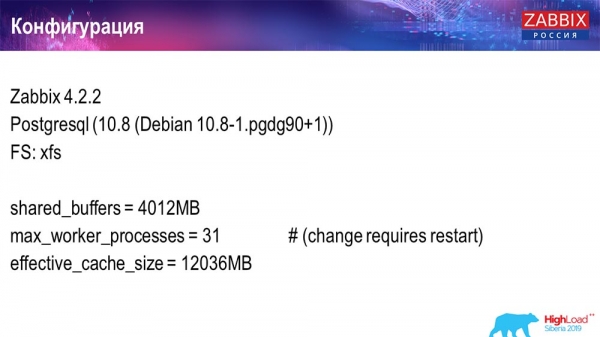
Am folosit 50 de agenți activi, care folosesc LoadableModule pentru a genera rapid rezultate variate. Aceștia au generat linii, numere și așa mai departe. Am umplut baza de date cu o cantitate mare de date. Inițial, configurația conținea 5000 de elemente de date pentru fiecare host, iar aproximativ fiecare element de date conținea un trigger – pentru a face ca aceasta să fie o configurație reală. Uneori, pentru a utiliza, chiar este necesar mai mult de un trigger.
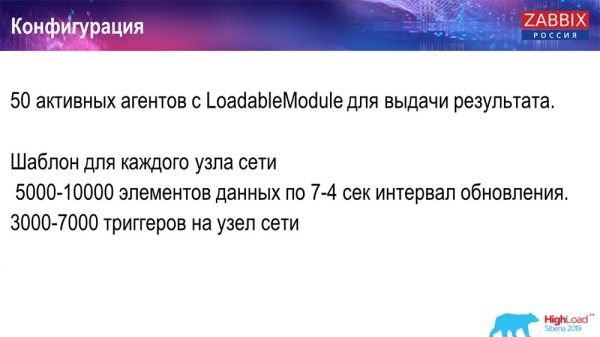
Am reglat intervalul de actualizare și încărcătura folosind nu doar cei 50 de agenți (am adăugat și altele), ci și prin elemente de date dinamice, reducând intervalul de actualizare la 4 secunde.
Test de performanță. PostgreSQL: 36 de mii de NVP-uri
Prima rulare, prima configurație a fost pe un PostgreSQL 10 curat pe acest hardware (35 de mii de valori pe secundă). În general, așa cum se poate vedea pe ecran, inserarea datelor durează fracțiuni de secundă – totul este bine și rapid, SSD-uri (200 gigabytes). Singurul lucru este că 20 GB se umplu destul de repede.
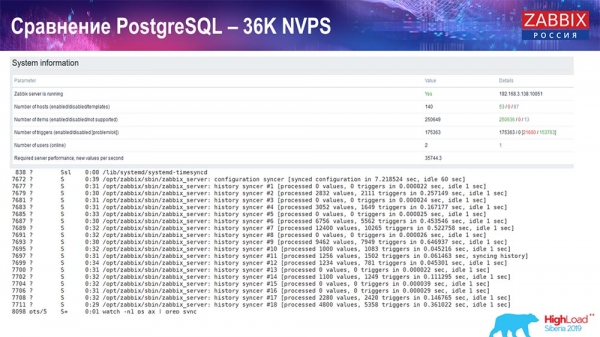
Vor fi destul de multe astfel de grafice. Acesta este dashboard-ul standard de performanță al serverului „Zabbix”.
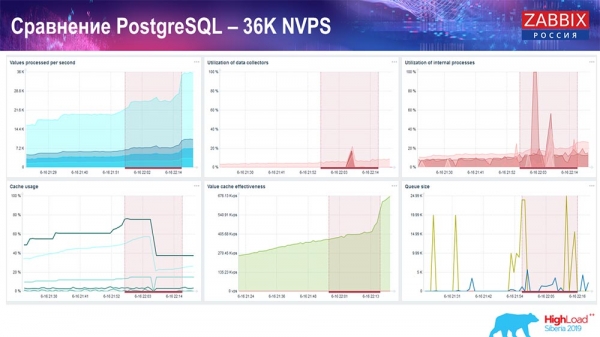
Primul grafic – numărul de valori pe secundă (albastru, în colțul din stânga sus), 35 de mii de valori în acest caz. Acesta (în partea de sus, la centru) este încărcarea proceselor de colectare, iar aceasta (în colțul din dreapta sus) este încărcarea proceselor interne: history syncers și housekeeper, care aici (în partea de jos la centru) au fost executați timp destul.
Acest grafic (în centrul de jos) arată utilizarea ValueCache – câte hituri ValueCache pentru declanșatori (câteva mii de valori pe secundă). Un alt graf important este al patrulea (în stânga jos), care arată utilizarea HistoryCache, despre care am vorbit, care este un buffer înainte de inserția în Bază de Date.
Test de performanță. PostgreSQL: 50 de mii NVP-uri
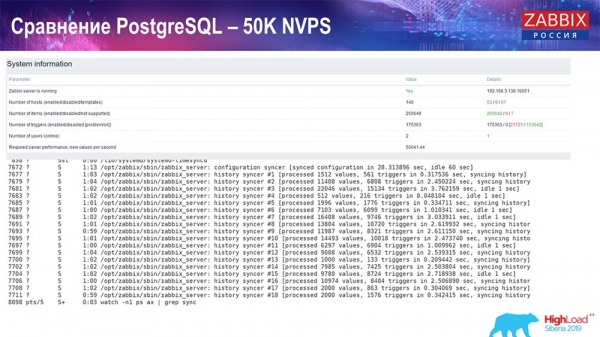
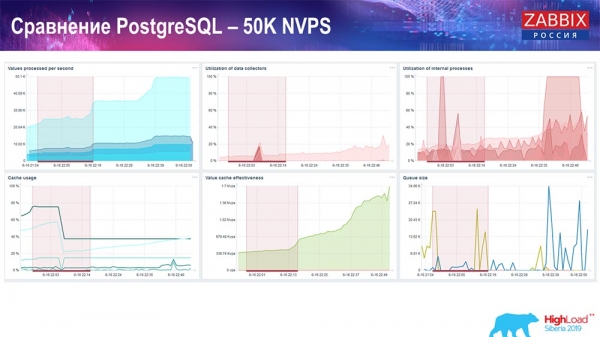
Apoi am crescut sarcina la 50 de mii de valori pe secundă pe aceeași mașină. La încărcarea cu „Housekeeper”, 10 mii de valori erau deja scrise în 2-3 secunde, inclusiv calculele. Așa cum este ilustrat în captura de ecran următoare:
„Housekeeper” începe deja să interfereze cu funcționarea, dar în general, încărcarea trapper-elor history-syncer este în continuare la 60 % (al treilea grafic, în dreapta sus). HistoryCache începuse să se umple activ chiar în timpul utilizării „Housekeeper”-ului (în stânga jos). Era de aproximativ o jumătate de gigabyte, umplut cu 20%.
Test de performanță. PostgreSQL: 80 de mii NVP-uri
Am crescut apoi la 80 de mii de valori pe secundă:
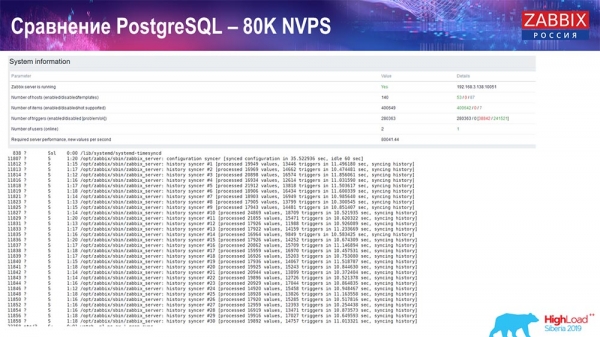
Asta a fost aproximativ 400 de mii de elemente de date, 280 de mii de declanșatori. Inserția, așa cum puteți vedea, a dus la o încărcare considerabilă a history-syncer-elor (erau 30). Apoi am crescut diferite parametere: history-syncer-ii, cache-ul… Pe această mașină, încărcarea history-syncer-ilor a început să crească la maxim, practic, „în raft” – astfel, HistoryCache a intrat într-o încărcare foarte mare:
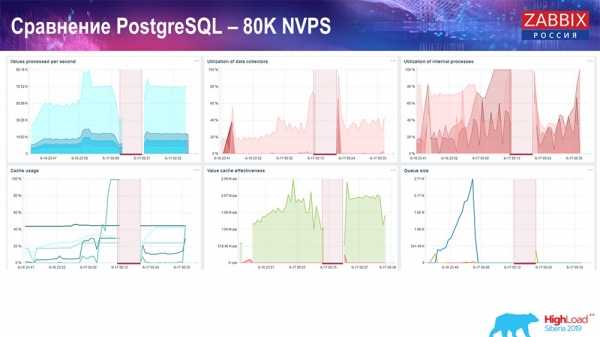
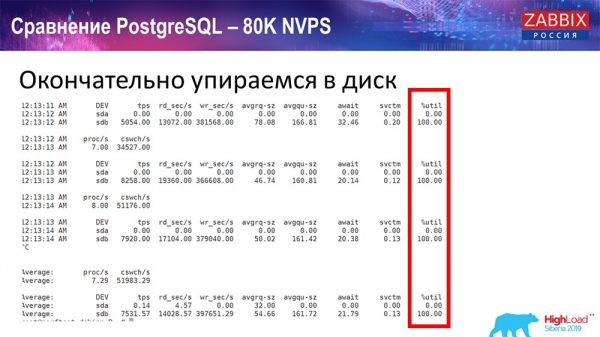
În tot acest timp am observat toate parametrii sistemului (cum este utilizat procesorul, memoria RAM) și am descoperit că utilizarea discurilor era la maximum – am atingea capacitatea maximă a acestui disc pe această mașină, pe această mașină virtuală. „Postgres” a început să elimine date activ la o astfel de intensitate și discul deja nu mai reușea să scrie, să citească…
Am luat un alt server, care avea deja 48 de procesoare și 128 de gigabyte de memorie RAM:
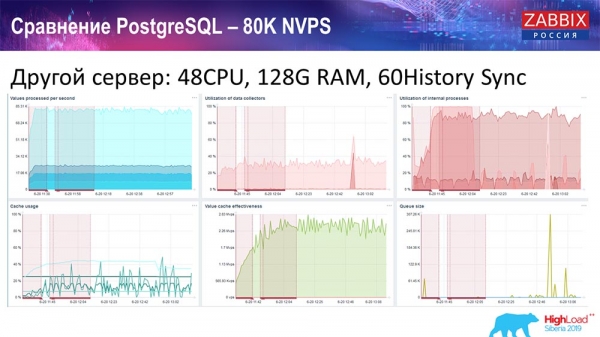
De asemenea, l-am „tunat” – am instalat History syncer (60 de bucăți) și am obținut o performanță acceptabilă. Practic nu suntem „în raft”, dar probabil că aceasta este limita de performanță, unde este necesar să întreprindem ceva.
Test de performanță. TimescaleDB: 80 de mii NVP-uri
Am avut ca obiectiv principal utilizarea TimescaleDB. Pe fiecare grafic se observă o cădere:
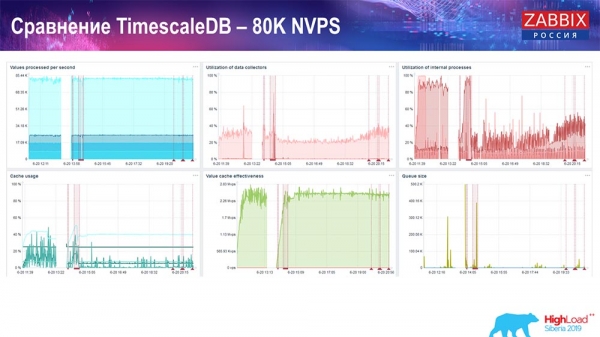
Aceste eșuări sunt, de fapt, migrarea datelor. După aceasta, în serverul „Zabbix”, profilul de încărcare a istoriei sincronizatoarelor, după cum vedeți, s-a schimbat semnificativ. Acesta permite practic inserarea datelor de aproape trei ori mai repede și folosește mai puțin HistoryCache – în consecință, datele vor fi livrate la timp. Din nou, 80 de mii de valori pe secundă este o rată destul de ridicată (desigur, nu pentru „Yandex”). În general, acesta este un setup destul de mare, cu un singur server.
Test de performanță PostgreSQL: 120 de mii de NVP-uri
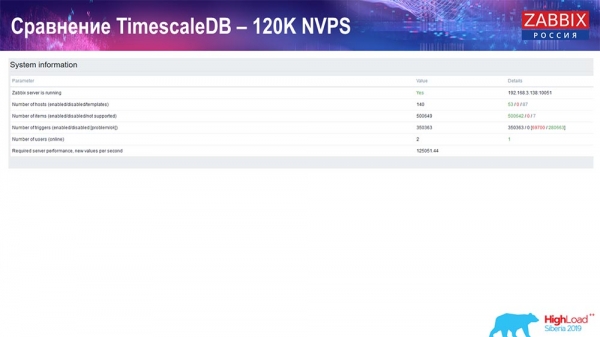
Apoi, am crescut valoarea numărului de elemente de date la o jumătate de milion și am obținut o valoare estimată de 125 de mii pe secundă:
Și am obținut graficele astfel:
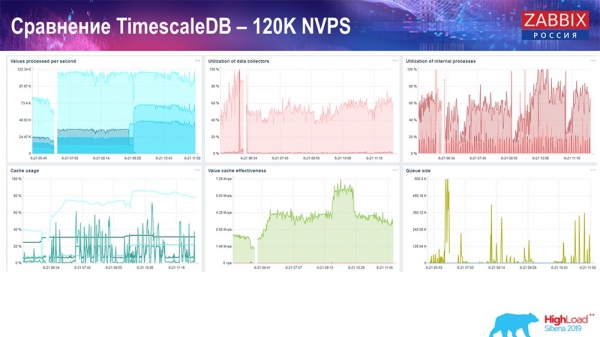
În principiu, acesta este un setup funcțional, poate opera pentru o perioadă destul de lungă. Dar, deoarece aveam un disc de doar 1,5 terabyte, l-am consumat în câteva zile. Cel mai important este că, în același timp, s-au creat noi partiții în TimescaleDB, iar acest lucru, pentru performanță, a trecut complet neobservat, spre deosebire de MySQL.
De obicei, partițiile sunt create noaptea, deoarece acest lucru blochează complet inserția și lucrul cu tabelele, putând duce la degradarea serviciului. În acest caz, acest lucru nu s-a întâmplat! Principala sarcină a fost să verificăm capacitățile TimescaleDB. Rezultatul obținut a fost: 120 de mii de valori pe secundă.
Există, de asemenea, exemple în „comunitate”:
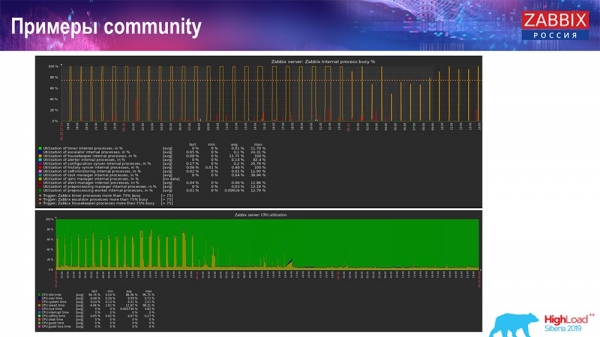
O persoană a activat și TimescaleDB și utilizarea io.weight a scăzut pe procesor; iar utilizarea elementelor proceselor interne a scăzut, de asemenea, datorită activării TimescaleDB. De altfel, acestea sunt discuri obișnuite, adică o mașină virtuală pe discuri normale (nu SSD)!
Pentru anumite setup-uri mici, care se confruntă cu performanța discului, TimescaleDB, după părerea mea, este o soluție foarte bună. Aceasta va permite să continui să lucrezi până când vei migra pe hardware mai rapid pentru baza de date.
Vă invit pe toți la evenimentele noastre: Conferința – în Moscova, Summit – în Riga. Folosiți canalele noastre – „Telegram”, forum, IRC. Dacă aveți întrebări – veniți la noi la stand, putem vorbi despre tot.
Întrebările audienței
Întrebare din audiență (în continuare – A): – Dacă TimescaleDB este atât de simplu de configurat și oferă un astfel de impuls de performanță, atunci, poate, ar trebui utilizat ca cea mai bună practică pentru configurarea „Zabbix” cu „Postgres”? Și există vreo capcană sau dezavantaj al acestei soluții, sau totuși, dacă am decis să fac „Zabbix”, pot lua liniștit „Postgres”, să instalez deodată „Timescale” și să folosesc fără a mă gândi la probleme?
AG: – Da, aș spune că este o recomandare bună: să folosești „Postgres” direct cu extensia TimescaleDB. Așa cum am spus, există multe recenzii pozitive, în ciuda faptului că această „caracteristică” este experimentală. Dar, de fapt, testele arată că este o soluție excelentă (cu TimescaleDB), și cred că va continua să evolueze! Urmărim cum se dezvoltă această extensie și vom corecta ce trebuie.
Chiar și în timpul dezvoltării ne-am bazat pe una dintre cele mai cunoscute „caracteristici”: acolo puteai lucra puțin diferit cu bucățile. Dar apoi au eliminat asta în următoarea versiune și a trebuit să nu ne mai bazăm pe acel cod. Aș recomanda utilizarea acestei soluții în multe setări. Dacă folosești MySQL… pentru setările medii, orice soluție funcționează destul de bine.
A: – În ultimele grafice, care provin de la comunitate, a fost un grafic cu „Housekeeper”:
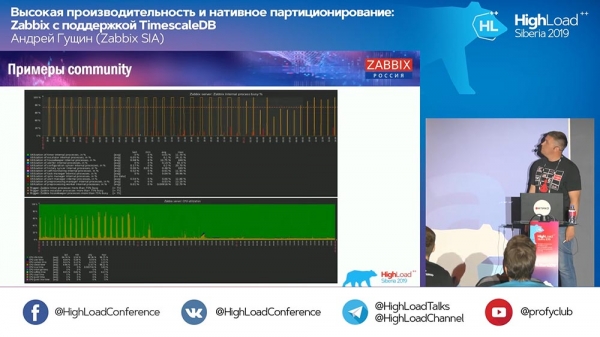
A continuat să funcționeze. Ce face „Housekeeper” în cazul TimescaleDB?
AG: – Acum nu pot spune cu exactitate – voi verifica codul și voi oferi detalii suplimentare. Folosește interogări specifice TimescaleDB nu pentru eliminarea bucăților, ci cumva pentru agregare. Până atunci, nu sunt pregătit să răspund la această întrebare tehnică. O să clarificăm astăzi sau mâine la stand.
A: – Am o întrebare similară – despre performanța operațiunii de eliminare în „Timescale”.
A (răspuns din audiență): – Când elimini date dintr-un tabel, dacă faci asta prin delete, atunci trebuie să parcurgi tabelul – să ștergi, să cureți, să marchezi totul pentru un viitor vacuum. În „Timescale”, având bucăți, poți să le ștergi. În termeni practici, îi spui pur și simplu fișierului care se află în big data: „Șterge!”
«Timescale» înțelege pur și simplu că acel chunk nu mai există. Și cum se integrează în planificatorul de cereri, prinde condițiile tale din select sau din alte operații și înțelege imediat că acel chunk nu mai este - „Nu mă voi duce acolo din nou!” (datele sunt absente). Și asta e tot! Asta înseamnă că scanarea tabelului este înlocuită de ștergerea fișierului binar, deci este rapid.
A: – Am abordat deja subiectul non-SQL. Din câte înțeleg, „Zabbix” nu are nevoie foarte mult să modifice datele, ci totul este mai mult un fel de log. Se pot folosi baze de date specializate care nu pot schimba datele, dar care salvează, acumulează, oferă date mult mai repede – Clickhouse, de exemplu, ceva asemănător cu Kafka?.. Kafka este totuși tot un log! Se pot integra cumva?
AG: – Se poate face exportul. Avem o anumită „funcționalitate” din versiunea 3.4: poți scrie în fișiere toate fișierele istorice, evenimentele, tot ce există; și apoi, cu un anumit procesor, trimite către orice altă bază de date. De fapt, mulți reconfigurează și scriu direct în baza de date. Istoricul e scris în fișiere, se rotesc aceste fișiere și așa mai departe, iar acest lucru poate fi transferat în „Clickhouse”. Nu pot spune nimic despre planuri, dar, posibil, suportul pentru soluțiile NoSQL (precum „Clickhouse”) va continua.
A: – Deci, se pare că se poate scăpa complet de Postgres?
AG: – Desigur, cea mai complicată parte în „Zabbix” sunt tabelele istorice, care creează cele mai multe probleme, și evenimentele. În acest caz, dacă nu păstrezi evenimentele pentru mult timp și păstrezi istoricul cu tendințe într-un alt depozit rapid, atunci în general nu ar trebui să fie probleme.
A: – Poți evalua cât de mult mai repede va funcționa totul dacă trecem la „Clickhouse”, de exemplu?
AG: – Nu am testat. Cred că, măcar aceleași cifre pot fi atinse destul de ușor, având în vedere că „Clickhouse” are propriul său interfață, dar nu pot spune cu certitudine. Ar fi mai bine să testăm. Totul depinde de configurație: câte hosturi ai și așa mai departe. Inserarea este una, dar trebuie să retragi aceste date – cu Grafana sau altceva.
A: – Deci, se vorbește despre o competiție echilibrată, nu despre un avantaj mare al acestor baze de date rapide?
AG: – Cred că, atunci când integrăm, vom avea teste mai precise.
A: – Unde a dispărut vechiul și bunul RRD? Ce a determinat trecerea la bazele de date SQL? Inițial, toate metricile erau colectate pe RRD.
AG: – În «Zabbix», RRD a existat, poate, într-o versiune foarte veche. Au existat întotdeauna baze de date SQL – abordarea clasică. Abordarea clasică este MySQL, PostgreSQL (există de foarte mult timp). Noi avem o interfață comună pentru bazele de date SQL și RRD, pe care practic nu am folosit-o niciodată.

Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
