

Pe 26 februarie am organizat un meetup Apache Ignite GreenSource, la care au participat contribuabili ai proiectului open source. Un eveniment important în viața acestei comunități a fost refacerea componentului , care permite desfășurarea de microservicii personalizate direct în clusterul Ignite. Despre acest proces complicat a vorbit la meetup , inginer software și contribuabil la Apache Ignite de mai bine de doi ani.
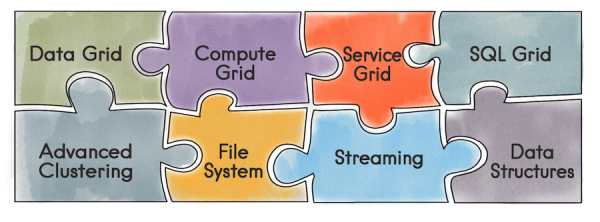
Să începem cu ce este Apache Ignite. Este o bază de date care reprezintă un depozit distribuit Key/Value cu suport SQL, tranzacții și caching. În plus, Ignite permite desfășurarea de servicii personalizate direct în clusterul Ignite. Dezvoltatorului îi devin accesibile toate uneltele oferite de Ignite - structuri de date distribuite, Messaging, Streaming, Compute și Data Grid. De exemplu, utilizând Data Grid, problema administrării unei infrastructuri separate pentru depozitul de date dispare și, ca urmare, costurile indirecte asociate.
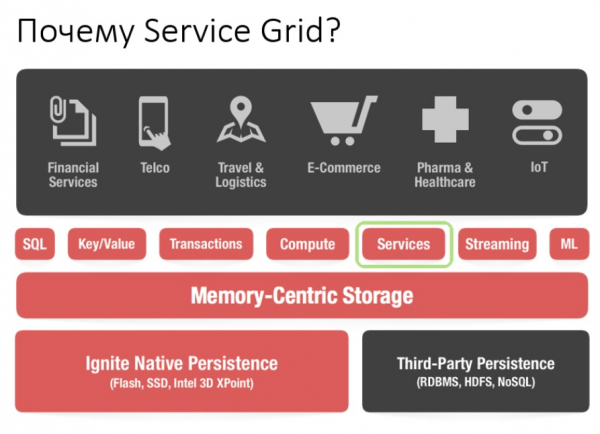
Folosind API-ul Service Grid, este posibil să desfășurați un serviciu, indicând pur și simplu în configurație schema de desfășurare și, respectiv, serviciul însuși.
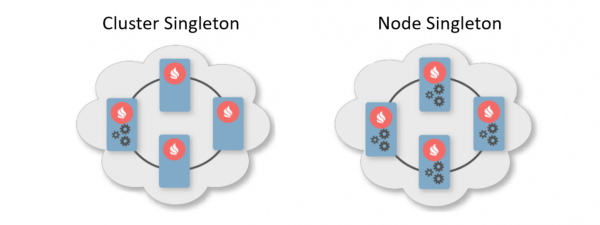
Schema de desfășurare este, de obicei, specificarea numărului de instanțe care ar trebui să fie desfășurate pe nodurile clusterului. Există două scheme tipice de desfășurare. Prima - Cluster Singleton: în orice moment, în cluster va fi garat un singur exemplar al serviciului personalizat. A doua - Node Singleton: pe fiecare nod al clusterului este desfășurat câte un exemplar al serviciului.
De asemenea, utilizatorul poate specifica numărul de instanțe ale serviciului în întregul cluster și defini un predicat pentru filtrarea nodurilor corespunzătoare. În acest scenariu, Service Grid va calcula singur distribuția optimă pentru desfășurarea serviciilor.
În plus, există o funcționalitate numită Affinity Service. Affinity este o funcție care determină legătura între chei și partiții, precum și legătura dintre grupuri și noduri în topologie. Pe baza cheii, se poate identifica nodul primar unde sunt stocate datele. Astfel, puteți asocia propriul serviciu cu cheia și cu memoria cache a funcției de afinitate. În cazul în care funcția de afinitate se schimbă, va avea loc o redeployare automată. Astfel, serviciul va fi întotdeauna plasat lângă datele pe care trebuie să le manipuleze, reducând astfel cheltuielile de acces la informații. Această schemă poate fi numită o formă de calcul colocalizat.
Acum, că am discutat despre avantajele Service Grid, să vorbim despre istoria sa de dezvoltare.
Ce a fost înainte
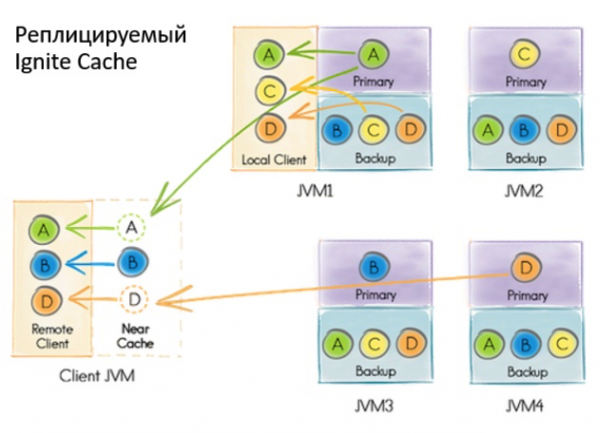
Implementarea anterioară a Service Grid s-a bazat pe un sistem de cache replicat tranzacțional Ignite. Prin cuvântul „cache” în Ignite se înțelege un depozit. Deci, nu este ceva temporar, așa cum s-ar putea crede. Deși cache-ul este replicat și fiecare nod conține un set complet de date, în interior cache-ul are o reprezentare partiționată. Acest lucru se datorează optimizării depozitelor.
Ce se întâmpla atunci când un utilizator dorea să implementeze un serviciu?
- Toate nodurile din cluster se aboneau la actualizările de date din depozit printr-un mecanism încorporat de Continuous Query.
- Nodul inițiator, sub o tranzacție read-committed, făcea o înregistrare în bază care conținea configurația serviciului, inclusiv instanța serializată.
- La primirea unei notificări despre o nouă înregistrare, coordonatorul calcula distribuția pe baza configurației. Obiectul obținut era scris din nou în bază.
- Dacă un nod intra în distribuție, coordonatorul trebuia să-l implementeze.
Ce nu ne mulțumea
La un moment dat, am realizat că nu putem lucra cu serviciile în acest mod. Motivul era destul de variat.
Dacă în timpul implementării apărea o eroare, aceasta putea fi observată doar din jurnalele nodului unde s-a petrecut totul. Există doar o implementare asincronă, așa că, după ce utilizatorul recăpăta controlul de la metoda de implementare, era nevoie de un timp suplimentar pentru a porni serviciul — și în acel timp, utilizatorul nu putea gestiona nimic. Pentru a dezvolta Service Grid în continuare, a compune noi funcționalități, a atrage utilizatori noi și a face viața tuturor mai ușoară, era necesar să schimbăm ceva.
Când am proiectat noul Service Grid, ne-am dorit în primul rând să oferim o garanție pentru desfășurarea sincronizată: de îndată ce utilizatorului i se restituie controlul de la API, acesta poate folosi imediat serviciile. De asemenea, ne-am dorit să oferim inițiatorului capacitatea de a gestiona erorile desfășurării.
În plus, am vrut să facilităm implementarea, adică să eliminăm tranzacțiile și rebalansarea. Deși cache-ul este replicabil și nu există balsoing, în timpul unei desfășurări mari cu numeroase noduri au apărut probleme. Atunci când topologia se schimbă, nodurile trebuie să schimbe informații, iar în timpul unei desfășurări mari aceste date pot cântări foarte mult.
Când topologia era instabilă, coordonatorului îi era necesar să recalibreze distribuția serviciilor. Și în general, când trebuie să lucrați cu tranzacții pe o topologie instabilă, acest lucru poate conduce la erori dificil de anticipat.
Probleme
Ce transformări globale ar fi fără probleme însoțitoare? Prima dintre ele a fost schimbarea topologiei. Trebuie să înțelegem că în orice moment, chiar și în momentul desfășurării serviciului, un nod poate intra în cluster sau ieși din acesta. Mai mult, dacă un nod intră în cluster în timpul desfășurării, va fi necesar să transmitem consistent toate informațiile despre servicii către noul nod. Aici nu este vorba doar despre ceea ce a fost déjà desfășurat, ci și despre desfășurările actuale și viitoare.
Aceasta este doar una dintre problemele care pot fi adunate într-o listă separată:
- Cum se desfășoară serviciile configurate static la pornirea nodului?
- Ieșirea unui nod din cluster – ce facem dacă nodul găzduia servicii?
- Ce facem dacă s-a schimbat coordonatorul?
- Ce facem dacă clientul s-a reconectat la cluster?
- Trebuie să procesăm cererile de activare / dezactivare și cum?
- Și ce se întâmplă dacă s-a apelat la distrugerea cache-ului, iar noi avem servicii de afinitate legate de acesta?
Și acestea nu sunt toate.
Soluție
Ca scop, am ales abordarea bazată pe evenimente, cu implementarea comunicării între procese prin mesaje. În Ignite sunt deja implementate două componente care permit nodurilor să trimită mesaje între ele – communication-spi și discovery-spi.
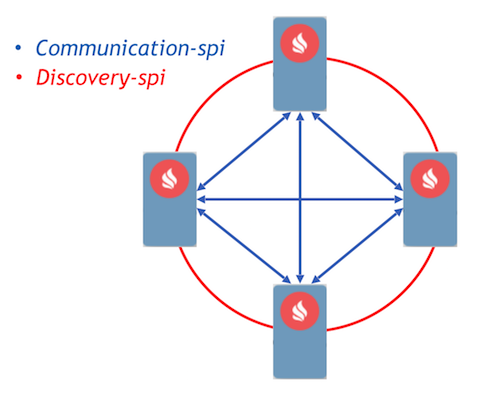
Communication-spi permite nodurilor să comunice direct și să trimită mesaje. Este potrivit pentru transferul unui volum mare de date. Discovery-spi permite trimiterea unui mesaj tuturor nodurilor din cluster. În implementarea standard, aceasta se face printr-o topologie de tip "inel". Există, de asemenea, o integrare cu Zookeeper, caz în care se utilizează o topologie de tip "stea". De asemenea, merită menționat un aspect important: discovery-spi oferă garanții că mesajul va fi livrat în ordinea corectă tuturor nodurilor.
Să analizăm protocolul de implementare. Toate cererile utilizatorilor pentru implementare și dezintegrare sunt trimise prin discovery-spi. Acest lucru oferă următoarele garanții:
- Cererile vor fi primite de toate nodurile din cluster. Acest lucru va permite continuarea procesării cererii în cazul schimbării coordonatorului. De asemenea, aceasta înseamnă că pentru un singur mesaj fiecare nod va avea toate metadatele necesare, cum ar fi configurația serviciului și instanța sa serializată.
- Ordinea strictă de livrare a mesajelor permite rezolvarea conflictelor de configurație și cererilor concurente.
- deoarece intrarea nodului în topologie este, de asemenea, gestionată prin discovery-spi, nodul nou va primi toate datele necesare pentru a lucra cu serviciile.
La primirea cererii, nodurile din cluster o validează și formează sarcini pentru procesare. Aceste sarcini sunt stocate într-o coadă și apoi procesate într-un alt fir de execuție de un lucrător separat. Acest lucru este implementat astfel deoarece implementarea poate dura un timp semnificativ, iar întârzierea fluxului de discovery ar fi inacceptabilă.
Toate cererile din coadă sunt procesate de managerul de implementare. Acesta are un lucrător special care scoate o sarcină din această coadă și o inițiază pentru a începe desfășurarea. După aceasta, au loc următoarele acțiuni:
- Fiecare nod își calculează singur distribuția datorită unei noi funcții de asignare determinate.
- Nodurile formează un mesaj cu rezultatele desfășurării și îl trimit coordonatorului.
- Coordonatorul agregă toate mesajele și formează rezultatul întregului proces de desfășurare, care este trimis prin discovery-spi tuturor nodurilor din cluster.
- La primirea rezultatului, procesul de desfășurare se finalizează, după care sarcina este eliminată din coadă.
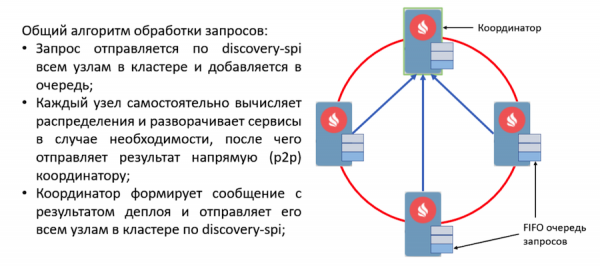
Noua design bazat pe evenimente: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Dacă a apărut o eroare în momentul desfășurării, nodul include imediat această eroare în mesajul pe care îl trimite coordonatorului. După agregarea mesajelor, coordonatorul va avea informații despre toate erorile din timpul desfășurării și va trimite acest mesaj prin discovery-spi. Informațiile despre erori vor fi disponibile pe orice nod din cluster.
Conform acestui algoritm, toate evenimentele importante din Service Grid sunt procesate. De exemplu, schimbarea topologiei este, de asemenea, un mesaj prin discovery-spi. În general, comparativ cu ceea ce era înainte, protocolul s-a dovedit a fi destul de ușor și fiabil. Atât de mult, încât poate gestiona orice situație în timpul desfășurării.
Ce urmează
Acum despre planuri. Orice modificare majoră în proiectul Ignite este realizată ca o inițiativă de îmbunătățire a Ignite, așa-numitul IEP. Redesign-ul Service Grid are, de asemenea, un IEP - cu un nume amuzant, «Schimbarea uleiului în Service Grid». Dar, de fapt, nu am schimbat uleiul din motor, ci motorul întreg.
Am împărțit sarcinile din IEP în 2 faze. Prima fază este o fază majoră, care constă în refacerea protocolului de desfășurare. Aceasta a fost deja integrată în master, poate fi testat noul Service Grid care va apărea în versiunea 2.8. A doua fază include multe alte sarcini:
- Redesfășurare la cald
- Versionarea serviciilor
- Creșterea disponibilității
- Client subțire
- Instrumente de monitorizare și calculare a diverselor metrici
În final, vă recomandăm Service Grid pentru construirea sistemelor de înaltă disponibilitate. De asemenea, vă invităm să ne împărtășiți experiența dvs. în și Experiența dvs. este cu adevărat importantă pentru comunitate, ajutând la înțelegerea direcției de dezvoltare viitoare a acestui component.
Sursa: habr.com
