

In-Memory este un set de concepte de stocare a datelor, când acestea sunt păstrate în memoria RAM a aplicației, iar discul este folosit pentru backup. În abordările clasice, datele sunt stocate pe disc, iar memoria este utilizată ca cache. De exemplu, o aplicație web cu un backend pentru prelucrarea datelor solicită aceste date din depozit: le primește, le transformă, iar apoi sunt transmise prin rețea. În In-Memory, calculul este direcționat spre date - în depozit, unde sunt prelucrate, reducând astfel încărcarea rețelei.

Ce alte oportunități oferă In-Memory și în ce constă această abordare, va fi explicat de Vladimir Pligin — inginer la compania GridGain. Acest material de revizuire va fi util dezvoltatorilor backend pentru aplicații web care nu au lucrat cu In-Memory și doresc să încerce sau sunt interesați de tendințele moderne în dezvoltarea soluțiilor software și proiectarea arhitecturii.
Notă. Articolul se bazează pe transcrierea prezentării lui Vladimir de la conferința #GetIT Conf. Înainte de introducerea autoizolării, am organizat în mod regulat întâlniri și conferințe pentru dezvoltatori la Moscova și Sankt Petersburg: discutam despre tendințe, întrebări actuale de dezvoltare, probleme și soluții. Acum nu putem organiza conferințe, dar este momentul perfect pentru a împărtăși materiale utile din trecut.
Cine și cum folosește In-Memory
In-Memory este folosit cel mai adesea acolo unde interacțiunea rapidă cu utilizatorul sau prelucrarea unor volume mari de date este esențială.
- Băncile folosesc In-Memory, de exemplu, pentru a reduce întârzierile în utilizarea aplicațiilor de către clienți sau pentru a analiza clienții înainte de a acorda un credit.
- Fintech folosește In-Memory pentru a îmbunătăți performanța serviciilor și aplicațiilor bancare care externalizează procesarea și analizarea datelor.
- Companiile de asigurări: pentru calcularea riscurilor, de exemplu, analizând datele clienților de-a lungul mai multor ani.
- Companiile de logistică. Ele procesează cantități mari de date, de exemplu, pentru a calcula rutele optime pentru transportul de mărfuri și pasageri cu mii de parametri, monitorizând statutul expedierilor.
- Retail. Soluțiile In-Memory ajută la servirea mai rapidă a clienților și la procesarea unor volume mari de informații: livrări, facturi, tranzacții, disponibilitatea a mii de produse în stocuri, pregătirea rapoartelor analitice.
- În IoT In-Memory înlocuiește bazele de date tradiționale.
- Companiile фармацевтice utilizează In-Memory, de exemplu, pentru generarea combinațiilor de ingrediente ale medicamentelor.
Voi împărtăși câteva exemple despre cum clienții noștri folosesc soluțiile In-Memory și cum le puteți implementa la voi.
In-Memory ca depozit principal
Unul dintre clienții noștri este un furnizor mare de echipamente medicale din SUA. Ei folosesc soluția In-Memory ca depozit principal de date. Toate datele sunt stocate pe disc, iar un subset de date care este utilizat activ este păstrat în memorie. Metodele de accesare a depozitului sunt standard: GDBC (Generic Database Connector) și limbajul de interogare SQL.
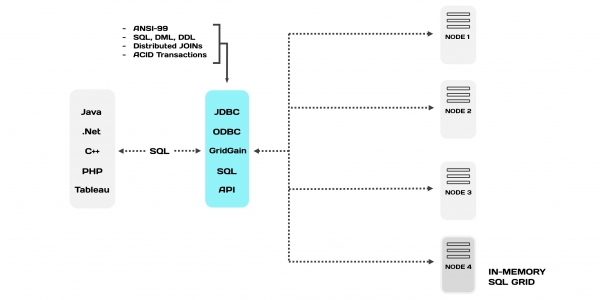
Toate acestea sunt cunoscute sub numele de In-Memory Database (IMDB) sau Memory-Centric Storage. Această categorie de soluții are multe denumiri, acestea nu sunt singurele.
Caracteristicile IMDB:
- Datele stocate în In-Memory și accesibile prin SQL sunt aceleași ca și în celelalte abordări. Ele sunt sincronizate, singura diferență fiind modul de prezentare și de accesare. Există tranzacționalitate între date.
- IMDB sunt mai rapide decât bazele de date relaționale, deoarece accesarea informațiilor din memorie este mai rapidă decât de pe disc.
- Algoritmii interni de optimizare au mai puține instrucțiuni.
- IMDB sunt potrivite pentru gestionarea datelor, evenimentelor și tranzacțiilor în aplicații.
IMDB susțin parțial ACID: atomicitate, consistență și izolare. Dar nu susțin „durabilitatea” — în cazul opririi curentului, toate datele sunt pierdute. Pentru a rezolva această problemă, pot fi utilizate snapshot-uri — un „instantaneu” al bazei de date, similar unui backup al bazei de date pe un hard disk sau înregistrarea tranzacțiilor (loguri) pentru a recupera datele după repornire.
Pentru a crea aplicații rezistente la defecțiuni
Să ne imaginăm o arhitectură clasică a unei aplicații web rezistente la defecțiuni. Aceasta funcționează astfel: toate solicitările sunt distribuite de un echilibrator de sarcină între servere. Acest sistem este rezistent, deoarece serverele se duplicate și se susțin reciproc în caz de incidente.
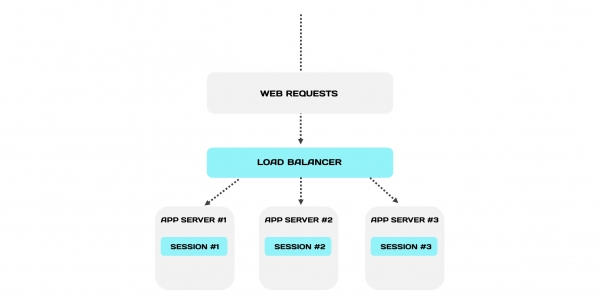
Echilibratorul direcționează toate solicitările dintr-o sesiune strict pe un singur server. Acesta este mecanismul sesiunilor stabile: fiecare sesiune este legată de server, în care este stocată și procesată local.
Ce se va întâmpla când unul dintre servere?
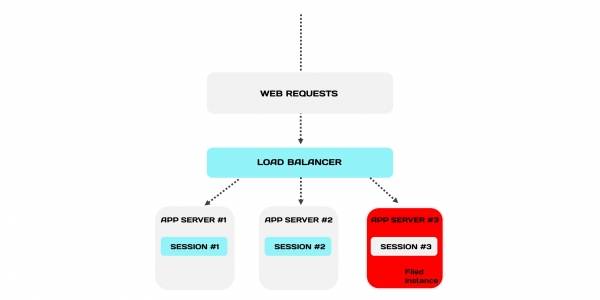
Serviciul nu va fi afectat, deoarece arhitectura este duplicată. Dar vom pierde un subset de sesiuni ale serverului căzut. De asemenea, utilizatorii care sunt conectați la aceste sesiuni vor fi afectați. De exemplu, un client finalizează o comandă și brusc este deconectat din cont. Va fi nemulțumit când se va reconecta și va descoperi că trebuie să reia procesul de comandă.
De la aplicația web se așteaptă să suporte un număr mare de utilizatori și să nu "înghețe" pentru a le permite o experiență confortabilă. Dar în caz de defecțiune, cu fiecare solicitare următoare, timpul de interacțiune cu stocarea sesiunilor va crește. Aceasta va crește latența medie pentru ceilalți utilizatori. Dar aceștia nu vor să aștepte mai mult decât sunt obișnuiți.
Această problemă poate fi rezolvată, similar clientului nostru – un mare furnizor PASS din SUA. Acesta folosește In-Memory pentru a clusteriza sesiunile web. În acest scop, acestea sunt stocate nu local, ci centralizat – în clusterul In-Memory. În acest caz, sesiunile sunt accesibile mult mai rapid, deoarece se află deja în memorie.
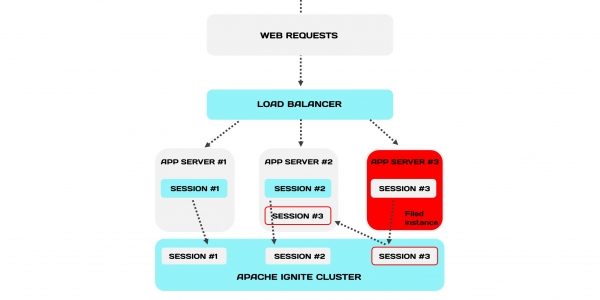
Când serverul se prăbușește, echilibratorul trimite solicitările căzute pe alte servere, la fel ca în arhitectura clasică. Dar există o diferență importantă: sesiunile sunt stocate în clusterul In-Memory iar serverele au acces la sesiunile serverului căzut.
Această arhitectură crește rezistența la defecțiuni a întregului sistem. Mai mult, este posibil să renunțăm complet la mecanismul sesiunilor stabile.
Procesarea tranzacțional-analitică hibridă (HTAP)
De obicei, sistemele tranzacționale și cele analitice sunt separate. Când acestea sunt divizate, baza de date principală este supusă la sarcini. Pentru prelucrarea analitică, datele sunt copiate într-o replică, astfel încât procesarea analitică să nu interfereze cu procesele tranzacționale. Dar copierea se efectuează cu întârziere - fără întârziere, replicarea nu este posibilă. Dacă o facem sincron, aceasta va încetini de asemenea baza principală și nu vom obține câștiguri.
În HTAP, totul funcționează diferit - aceeași stocare de date este utilizată pentru sarcina tranzacțională din aplicații și pentru interogările analitice, care pot dura mult timp. Atunci când datele se află în memoria operativă, interogările analitice sunt realizate mai rapid, iar serverul de baze de date este mai puțin solicitat (în medie).
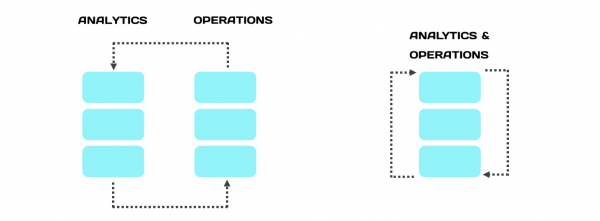
Abordarea hibridă „rupe zidul” între procesarea tranzacțiilor și analytics. Dacă executăm analytics pe aceeași stocare, interogările analitice sunt lansate pe datele din memoria operativă. Ele sunt mult mai precise, mai interpretabile și mai adecvate.
Integrarea soluțiilor In-Memory
O modalitate simplă (relativ) este să dezvoltăm totul de la zero. Păstrăm datele pe disc, iar cele active în memorie. Acest lucru ajută la gestionarea repornirilor serverului sau a deconectărilor.
Aici funcționează două scenarii principale, când datele sunt stocate pe disc. În primul, dorim să gestionăm căderile sau repornirile planificate ale clusterului sau ale unor părți - dorim să utilizăm, ca o bază de date simplă. În al doilea scenariu, atunci când datele sunt prea multe, o parte din ele se află în memorie.
Dacă nu există posibilitatea de a construi totul de la zero, este posibil să integrăm soluția In-Memory în deja arhitectura existentă. Dar nu toate soluțiile In-Memory sunt potrivite pentru asta. Există trei condiții obligatorii. Soluția In-Memory trebuie să suporte:
- o modalitate standard de conectare la baza de date, care va fi sub ea (de exemplu, MySQL);
- un limbaj standard de interogare, pentru a nu rescrie sau modifica logica de interacțiune cu stocarea;
- tranzacționalitate - pentru a păstra semantica interacțiunii.
Dacă toate cele trei condiții sunt respectate, integrarea este posibilă. Plasăm In-Memory Data Grid între aplicație și bază. Acum interogările de scriere vor fi delegate către baza de date inferioară, iar interogările de citire vor fi îndreptate către baza de date, dacă datele nu sunt în cache.
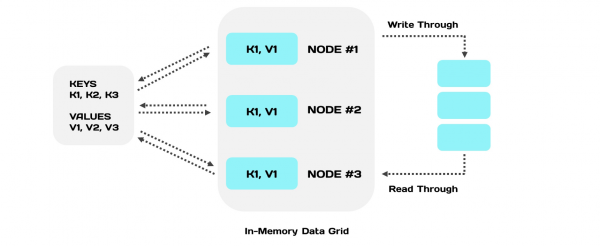
Dacă accesul rapid la date și procesarea acestora sunt importante, de exemplu, pentru analize de afaceri, ar trebui să luați în considerare implementarea In-Memory. Pentru realizare, puteți utiliza ambele metode în proiectarea unei noi arhitecturi.
Sursa: habr.com
