

Dezvoltarea industrială a sistemelor software necesită o atenție mare la fiabilitatea produsului final, precum și un răspuns rapid la defecțiuni și erori, în cazul în care acestea au loc. Monitorizarea, desigur, ajută la reacționarea mai eficientă și mai rapidă în fața defecțiunilor, dar nu este suficientă. În primul rând, este foarte dificil să urmărești un număr mare de servere - este nevoie de multe persoane. În al doilea rând, trebuie să înțelegi bine cum funcționează aplicația pentru a prognoza starea acesteia. Prin urmare, este nevoie de multe persoane care să înțeleagă bine sistemele pe care le dezvoltăm, metricile și caracteristicile acestora. Să presupunem că, chiar dacă găsim un număr suficient de persoane dornice să se ocupe de aceasta, mai este nevoie de mult timp pentru a le antrena.
Ce trebuie să facem? Aici ne vine în ajutor inteligența artificială. Articolul va vorbi despre (predictive maintenance). Această abordare câștigă tot mai multă popularitate. Au fost scrise un număr mare de articole, inclusiv pe Habr. Mari companii folosesc în mod activ această abordare pentru a menține funcționalitatea serverelor lor. După ce am studiat un număr mare de articole, am decis să încercăm să aplicăm această abordare. Ce a ieșit din aceasta?
Introducere
Sistemul software dezvoltat ajunge, mai devreme sau mai târziu, în exploatare. Este important pentru utilizator ca sistemul să funcționeze fără întreruperi. Dacă totuși apare o situație de urgență, aceasta trebuie rezolvată cu întârzieri minime.
Pentru a simplifica suportul tehnic al sistemului software, în special dacă există multe servere, se folosesc de obicei programe de monitorizare care preiau metrici de la sistemul software în funcțiune, oferă posibilitatea de a diagnostica starea acestuia și ajută la determinarea cauzei defecțiunii. Acest proces se numește monitorizarea sistemului software.
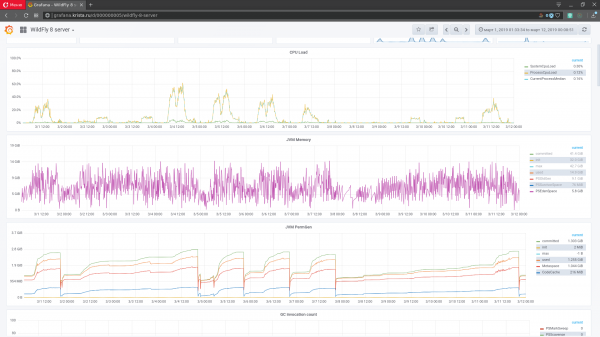
Figura 1. Interfața pentru monitorizarea grafana
Metricile sunt diferite indicatori ai unui sistem software, al mediului său de execuție sau al unei mașini de calcul fizice sub care este lansat sistemul, cu un marcaj temporal, acel moment în care au fost obținute metricile. În analiza statică, datele metricilor se numesc serii temporale. Pentru a observa starea unui sistem software, metricile sunt prezentate sub formă de grafice: pe axa X se află timpul, iar pe axa Y valorile (figura 1). Dintr-un sistem software funcțional pot fi extrase câteva mii de metrici (din fiecare nod). Acestea formează un spațiu metric (serii temporale multidimensionale).
Deoarece pentru sistemele software complexe se extrag un număr mare de metrici, monitorizarea manuală devine o sarcină complicată. Pentru a reduce volumul de date analizate de administrator, instrumentele de monitorizare conțin unelte pentru identificarea automată a problemelor posibile. De exemplu, se poate configura un trigger care să se activeze în cazul în care spațiul liber de pe disc scade sub un prag specificat. De asemenea, se poate diagnostica automat oprirea serverului sau o încetinire critică a vitezei de servicii. În practică, instrumentele de monitorizare se descurcă bine cu identificarea defectelor deja survenite sau cu identificarea simptomelor simple ale defectelor viitoare, dar, în general, prezicerea unei posibile defecțiuni rămâne o provocare pentru ele. Prezicerea prin analiza manuală a metricilor necesită implicarea specialiștilor calificați. Este o activitate cu o productivitate scăzută. Majoritatea posibilelor defecte pot rămâne neobservate.
În ultima vreme, printre marii IT-ști care dezvoltă software, devine din ce în ce mai popular așa-numitul serviciu de întreținere predictivă a sistemelor software. Esența acestui abordări constă în identificarea defectelor care duc la degradarea sistemului în etape incipiente, înainte de apariția unei defecțiuni, folosind inteligența artificială. Această abordare nu exclude complet monitorizarea manuală a sistemului. Ea servește ca suport pentru procesul de monitorizare în sine.
Principalul instrument pentru realizarea întreținerii predictive este sarcina de a găsi anomalii în seriile temporale, deoarece atunci când apare o anomalia în date există o mare probabilitate ca, după un timp, să apară o defecțiune apare o defect sau o defecțiune. O anomalie este o deviație a indicatorilor unui sistem software, cum ar fi identificarea degradării vitezei de execuție a unei cereri de un anumit tip sau scăderea medie a numărului de solicitări procesate într-un nivel constant de sesiuni ale clienților.
Timpul de căutare a anomaliilor pentru sistemele software are specificul său. Ideea este că pentru fiecare sistem software este necesară dezvoltarea sau ajustarea metodelor existente, deoarece căutarea anomaliilor depinde foarte mult de datele în care este realizată, iar datele sistemelor software variază foarte mult în funcție de instrumentele de implementare a sistemelor, până la tipul de mașină de calcul pe care rulează.
Metode de căutare a anomaliilor în prognoza defectelor sistemelor software
În primul rând, merită menționat că ideea de prognozare a defectelor a fost inspirată de articolul . Pentru a verifica eficiența abordării de căutare automată a anomaliilor, a fost aleasă sistemul software „Web-Consolidare”, care este unul dintre proiectele companiei NPO „Krista”. Pentru acesta, anterior se efectua un monitorizare manuală pe baza metricelor obținute. Deoarece sistemul este destul de complex, se colectează un număr mare de metrici: indicatori JVM (încărcarea colectorului de gunoi), indicatori ai sistemului de operare sub care rulează codul (memorie virtuală, % utilizare CPU), indicatori de rețea (încărcarea rețelei), serverului (încărcarea CPU, memorie), metricile wildfly și metricele proprii ale aplicației pentru toate subsistemele critice.
Toate metricile sunt colectate din sistem cu ajutorul graphite. Inițial, a fost folosită baza whisper ca soluție standard pentru grafana, dar odată cu creșterea numărului de clienți graphite nu a mai putut face față, epuizând capacitatea de transmisie a subsistemului de stocare a datelor. După aceasta, s-a decis căutarea unei soluții mai eficiente. Alegerea a fost în favoarea , ceea ce a permis reducerea semnificativă a încărcării subsistemului de stocare și a diminuat cu cinci-sase ori volumul de stocare ocupat. Mai jos este prezentată schema mecanismului de colectare a metricilor utilizând graphite+clickhouse (figura 2).
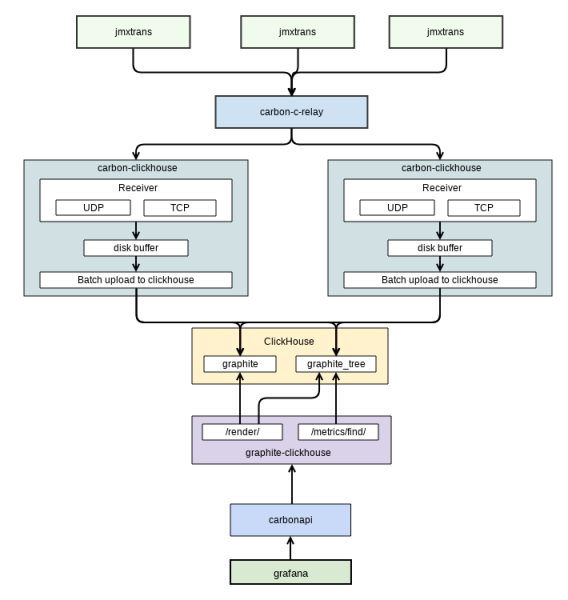
Figura 2. Schema de colectare a metricilor
Schema preluată din documentația internă. Aceasta ilustrează schimbul de date între grafana (interfață utilizator pentru monitorizare, pe care o folosim) și graphite. Colectarea metricilor din aplicație este realizată de un software separat – . Acesta le stochează în graphite.
Sistemul „Web-Consolidare” are o serie de caracteristici care cauzează probleme în prognozarea defecțiunilor:
- adesea se schimbă trendul. Pentru acest sistem software sunt lansate diverse versiuni. Fiecare dintre ele aduce modificări în partea de program a sistemului. Prin urmare, dezvoltatorii afectează direct metricile acestui sistem și pot provoca schimbări de trend;
- particularitățile implementării, precum și scopurile utilizării de către clienți ale acestui sistem, adesea generează anomalii fără o degradare prealabilă;
- procentul de anomalii în raport cu întregul set de date este mic (< 5%);
- pot apărea întreruperi în obținerea datelor din sistem. În anumite intervale scurte de timp, sistemul de monitorizare nu reușește să obțină metrici. De exemplu, dacă serverul este suprasolicitat. Pentru antrenarea rețelei neuronale, acest lucru este critic. Se creează necesitatea de a umple golurile în mod sintetic;
- Cazurile cu anomalii sunt adesea relevante doar pentru un anumit număr/ lună/ timp (sezonalitate). Acest sistem are un regulament clar de utilizare de către utilizatori. Prin urmare, metricile sunt relevante doar pentru un anumit moment. Sistemul poate fi utilizat nu constant, ci doar în anumite luni: selectiv, în funcție de an. Apar situații în care același comportament al metricilor într-un caz poate duce la defecțiunea sistemului software, iar în altul nu.
La început, au fost analizate metodele de detectare a anomaliilor în datele de monitorizare a sistemelor software. În articolele din acest domeniu, la procente mici de anomalii în raport cu restul setului de date, se propune adesea utilizarea rețelelor neuronale.
Logica principală pentru căutarea anomaliilor folosind datele rețelelor neuronale este ilustrată în figura 3:
Figura 3. Căutarea anomaliilor prin intermediul rețelei neuronale
În rezultatul prognozei sau al recuperării feroniei fluxului actual de metrici se calculează abaterea de la cele obținute de la sistemul software funcțional. În cazul unei diferențe mari între metricii obținuți de la sistemul software și cei ai rețelei neuronale, se poate concluziona despre anomalia actualului segment de date. Acest lucru generează o serie de probleme în utilizarea rețelelor neuronale:
- pentru funcționarea corectă în modul de flux, datele pentru antrenarea modelelor de rețele neuronale trebuie să conțină doar date „normale”;
- este necesară o modelare actualizată pentru o detecție corectă. Schimbarea tendințelor și sezonalității în metrici poate cauza un număr mare de alarme false ale modelului. Pentru a o actualiza, trebuie să se definească clar momentul în care modelul devine învechit. Dacă modelul este actualizat prea devreme sau prea târziu, este probabil să apară un număr mare de alarme false.
De asemenea, nu trebuie uitată căutarea și prevenirea apariției frecvente a alarmelor false. Se presupune că acestea vor apărea cel mai des în situații anormale. Totuși, ele pot fi și rezultatul erorilor rețelei neuronale din cauza insuficienței antrenării acesteia. Este necesar să se minimizeze numărul alarmelor false ale modelului. În caz contrar, previziunile false vor consuma mult timp al administratorului destinat verificării sistemului. Mai devreme sau mai târziu, va duce la situația în care administratorul pur și simplu va înceta să reacționeze la sistemul de monitorizare „paranoic”.
Rețea neuronală recurentă
Pentru detectarea anomaliilor în seriile temporale se poate aplica cu memorie LSTM. Problema este doar că aceasta poate fi aplicată doar pentru seriile temporale previzibile. În cazul nostru, nu toate metricile sunt previzibile. Încercarea de a aplica RNN LSTM pentru seria temporală este prezentată în figura 4.
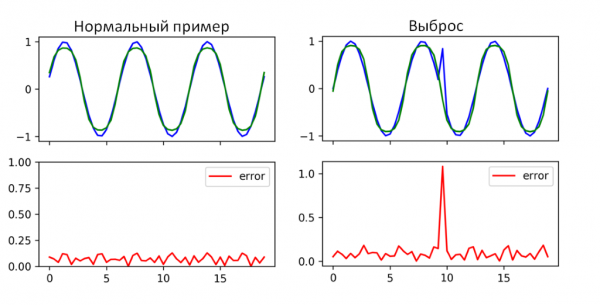
Figura 4. Exemplu de funcționare a rețelei neuronale recursive cu celule de memorie LSTM
După cum se poate observa din figura 4, RNN LSTM a reușit să identifice anomaliile în această perioadă de timp. Acolo unde rezultatul are o eroare de predicție mare (eroare medie), a avut loc cu adevărat o anomalie în indicatori. Utilizarea unei singure RNN LSTM va fi clar insuficientă, deoarece aceasta este aplicabilă unui număr mic de metrici. Poate fi utilizată ca metodă auxiliară de căutare a anomaliilor.
Autoencoder pentru prognozarea defectelor
– este, în esență, o rețea neuronală artificială. Strat de intrare – encoder, strat de ieșire – decoder. Dezavantajul tuturor rețelelor neuronale de acest tip este că nu localizează bine anomaliile. S-a ales arhitectura unui autoencoder sincron.
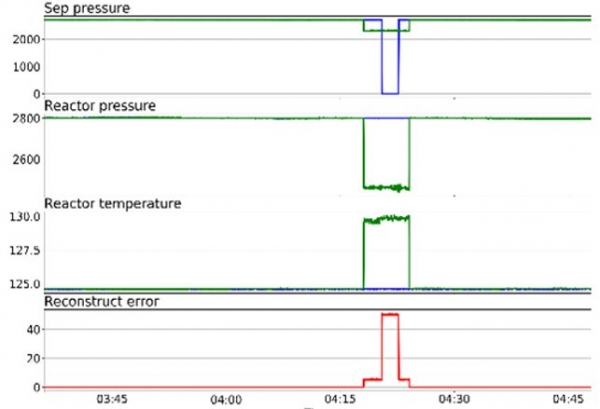
Figura 5. Exemplu de funcționare a autoencoder-ului
Autoencoderele sunt antrenate pe date normale și apoi găsesc ceva anormal în datele furnizate modelului. Exact ceea ce este necesar pentru această sarcină. Rămâne doar să alegem care dintre autoencodere se potrivește cel mai bine acestei sarcini. Cea mai simplă formă arhitecturală a unui autoencoder este o rețea neuronală simplă, de tip feedforward, foarte similară cu (multilayer perceptron, MLP), având un strat de intrare, un strat de ieșire și unul sau mai multe straturi ascunse care le conectează.
Cu toate acestea, diferențele dintre autoencodere și MLP constau în faptul că în autoencoder stratul de ieșire are același număr de noduri ca și stratul de intrare și că, în loc să învețe să prezică valoarea țintă Y, dată de intrarea X, autoencoder-ul învață să-și reconstruiască propriile X. Prin urmare, autoencoderele sunt modele de învățare nesupravegheată.
Sarcina autoencoder-ului constă în găsirea indicilor temporali r0 … rn, corespunzători elementelor anormale din vectorul de intrare X. Acest efect este realizat prin căutarea erorii pătratice.
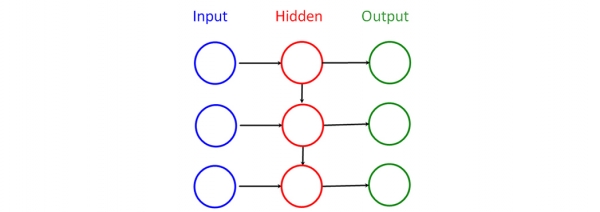
Figura 6. Autoencoder sincron
Pentru autoencoder s-a ales . Avantajele sale: posibilitatea utilizării modului de procesare în flux și un număr relativ mai mic de parametri ai rețelei neuronale în comparație cu alte arhitecturi.
Mecanismul de minimizare a falselor alarme
Având în vedere că apar diferite situații neprevăzute, precum și posibila insuficientă instruire a rețelei neuronale, s-a luat decizia de a dezvolta un mecanism de minimizare a alarmelor false pentru modelul dezvoltat de detectare a anomaliilor. Acest mecanism se bazează pe o bază de șabloane clasificată de administrator.
(algoritmul DTW, de la engl. dynamic time warping) permite găsirea unei corespondențe optime între secvențe temporale. A fost utilizat pentru prima dată în recunoașterea vocală: folosit pentru a determina cum cele două semnale vocale reprezintă aceeași frază pronunțată inițial. Ulterior, i s-au găsit aplicații și în alte domenii.
Principiul de bază al minimizării alarmelor false este colectarea unei baze de etaloane prin intermediul unui operator care clasifică cazurile suspecte detectate cu ajutorul rețelelor neuronale. Ulterior, se compară etalonul clasificat cu cazul detectat de sistem și se trage o concluzie cu privire la apartenența acestuia la o alarmă falsă sau la o eroare reală. Precis, pentru a compara cele două serii temporale se utilizează algoritmul DTW. Principalul instrument în minimizare rămâne clasificarea. Se presupune că, după colectarea unui număr mare de cazuri etalon, sistemul va solicita mai puțin operatorului din cauza similitudinii majorității cazurilor și a apariției similare.
În final, pe baza metodelor de rețele neuronale descrise mai sus, a fost construit un program experimental pentru prognoza defecțiunilor sistemului „Web-Consolidare”. Scopul acestui program a fost, folosind arhiva existentă de date de monitorizare și informații despre defecțiunile deja petrecute, să evalueze competența acestei abordări pentru sistemele noastre software. Schema de funcționare a programului este prezentată mai jos, în figura 7.
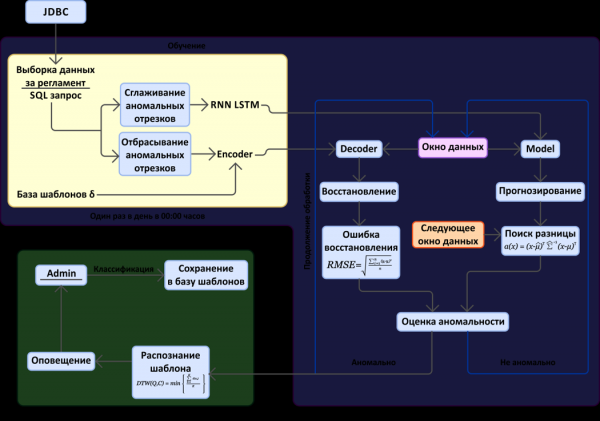
Figura 7. Schema prognozei defecțiunilor pe baza analizei spațiului metricilor
În schemă se pot evidenția două blocuri principale: căutarea segmentelor anormale de timp în fluxul de date de monitorizare (metrici) și mecanismul de minimizare a alarmelor false. Notă: în scopuri experimentale, datele sunt obținute prin conexiune JDBC din baza de date, în care sunt salvate cu graphite.
Următorul este interfața rezultată în urma dezvoltării sistemului de monitorizare (figura 8).
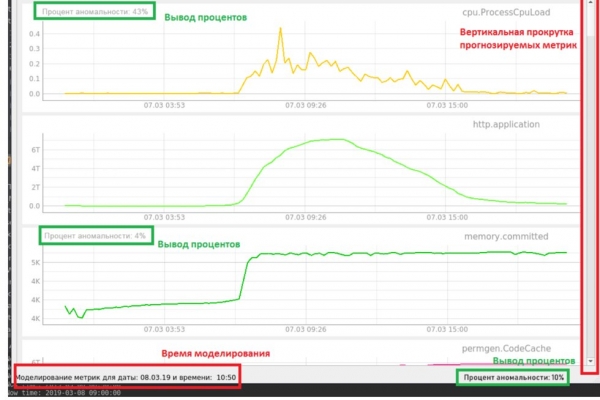
Figura 8. Interfața sistemului experimental de monitorizare
Interfața afișează procentul de anomalii pe metricile obținute. În cazul nostru, obținerea este modelată. Avem deja toate datele pentru câteva săptămâni și le încărcăm treptat pentru a verifica cazul cu anomalia care duce la defectare. În bara de stare de jos se afișează procentul total de anomalii al datelor în momentul respectiv, care este determinat prin intermediul unui autoencoder. De asemenea, pentru metricile prognozate se afișează un procent separat, calculat de RNN LSTM.
Exemplu de detectare a anomaliilor pe baza indicatorilor CPU prin intermediul rețelei neuronale RNN LSTM (figura 9).
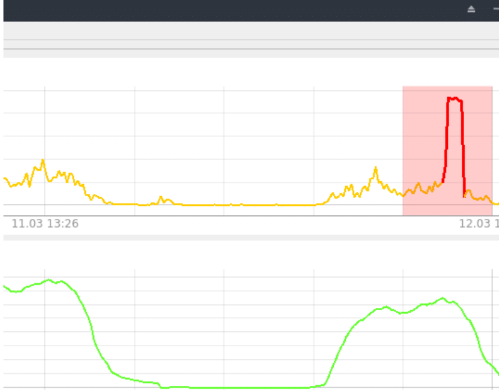
Figura 9. Detectarea cu RNN LSTM
Un caz destul de simplu, practic un simplu outlier, dar care duce la defectarea sistemului, a fost calculat cu succes prin RNN LSTM. Indicatorul de anomalii în acest interval de timp este de 85 – 95%, orice valoare peste 80% (prag stabilit experimental) este considerată anomalie.
Exemplu de detectare a anomaliilor, când sistemul nu a reușit să se încarce după actualizare. Această situație este detectată de autoencoder (figura 10).
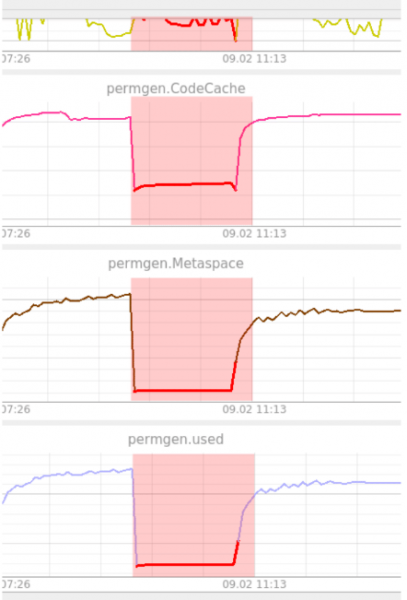
Figura 10. Exemplu de detectare cu autoencoderul
După cum se poate observa din figură, PermGen a rămas blocat la un anumit nivel. Autoencoderul a considerat aceasta ca fiind ciudat, deoarece anterior nu a văzut nimic asemănător. Aici anomalia rămâne la 100% până când sistemul revine în stare de funcționare. Anomalia este afișată pe toate metricile. Așa cum s-a spus anterior, autoencoderul nu poate localiza anomaliile. Operatorul este responsabil să îndeplinească această funcție în aceste situații.
Concluzie
PC-ul „Web-Consolidare” este dezvoltat de mai mulți ani. Sistemul se află într-o stare destul de stabilă, iar numărul incidentelor înregistrate este mic. Cu toate acestea, au fost identificate anomalii care duc la defectare cu 5 – 10 minute înainte de apariția defectului. În unele cazuri, notificarea despre defectare ar fi ajutat să se economisească timpul alocat pentru efectuarea lucrărilor de „reparație”.
În urma experimentelor realizate, este prea devreme pentru a trasa concluzii definitive. În acest moment, rezultatele sunt contradictorii. Pe de o parte, se observă că algoritmii pe bază de rețele neuronale sunt capabili să identifice anomalii „utile”. Pe de altă parte, rămâne un procent mare de alarme false, iar nu toate anomaliile identificate de un specialist calificat pot fi detectate de rețeaua neuronală. Un dezavantaj este că, în prezent, rețeaua neuronală necesită un antrenament bazat pe un profesor pentru a funcționa corect.
Pentru dezvoltarea ulterioară a sistemului de prognoză a defectelor și pentru a-l aduce într-o stare satisfăcătoare, se pot lua în considerare mai multe direcții. Este necesar un analize mai detaliate ale incidentelor cu anomalii care conduc la defecțiuni, prin adăugarea unei liste de metri critici care afectează semnificativ starea sistemului și eliminarea celor irelevante. De asemenea, continuând în această direcție, s-ar putea încerca specializarea algoritmilor specific pentru cazurile noastre de anomalii care duc la defecte. Există și o altă cale. Aceasta ar fi îmbunătățirea arhitecturilor rețelelor neuronale și, în acest fel, creșterea preciziei de detecție și reducerea timpului de antrenare.
Îi mulțumesc colegilor care m-au ajutat la redactarea și menținerea actualității acestui articol: și Serghei Finogenov.
Sursa: habr.com
