

— este un sistem de gestionare a bazelor de date coloane pentru procesarea analitică online (OLAP) cu sursă deschisă, creat de Yandex. Este folosit de Yandex, CloudFlare, VK.com, Badoo și alte servicii din întreaga lume pentru stocarea unor volume extrem de mari de date (inserarea a mii de rânduri pe secundă sau petabytes de date stocate pe disc).
Într-o bază de date „preregistribuție”, exemplele fiind MySQL, Postgres, MS SQL Server, datele sunt stocate într-o ordine specifică:
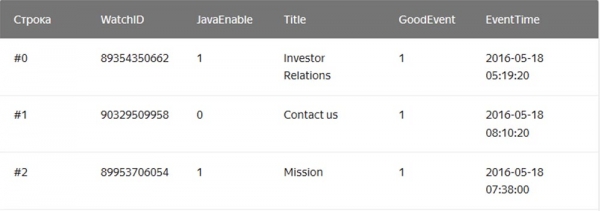
În acest caz, valorile aparținând unui singur rând sunt stocate fizic apropiate. În sistemele de baze de date coloane, valorile din coloane diferite sunt stocate separat, iar datele unei coloane sunt stocate împreună:
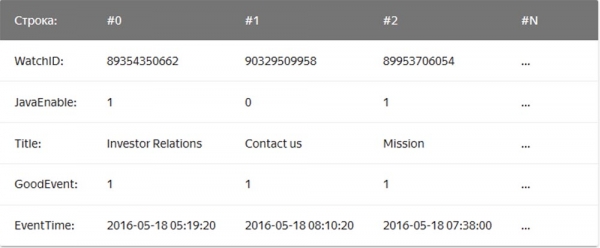
Exemple de sisteme de baze de date coloane sunt Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Compania – mailforwarder a început să utilizeze Clickhouse în 2018 pentru generarea de rapoarte și a fost foarte impresionată de simplitatea, scalabilitatea, suportul SQL și rapiditatea acesteia. Viteza de operare a acestui SGBD era aproape magică.
Simplitate
Clickhouse se instalează pe Ubuntu cu o singură comandă. Dacă știți SQL, puteți începe imediat să utilizați Clickhouse pentru nevoile dumneavoastră. Totuși, acest lucru nu înseamnă că puteți efectua un 'show create table' în MySQL și să copiați și să lipiți SQL în Clickhouse.
Comparativ cu MySQL, acest SGBD are diferențe importante între tipurile de date în definițiile schemei tabelului, așa că pentru a lucra confortabil, va fi nevoie totuși de puțin timp pentru a modifica definițiile schemei tabelului și a studia motoarele de tabel.
Clickhouse funcționează excelent fără software suplimentar, dar dacă doriți să utilizați replicarea, va trebui să instalați ZooKeeper. Analiza performanței interogărilor arată rezultate excelente — tabelele de sistem conțin toate informațiile, iar toate datele pot fi obținute cu ajutorul vechiului și plictisitorului SQL.
Performanță
- compararea Clickhouse cu Vertica și MySQL pe un server cu configurația: două socket-uri Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 pe 8 HDD SATA de 6TB, ext4.
- compararea Clickhouse cu depozitul de date cloud Amazon RedShift.
- Extrase din blogul :
Baza de date ClickHouse are un design foarte simplu — toate nodurile din cluster au aceeași funcționalitate și pentru coordonare folosesc doar ZooKeeper. Am construit un mic cluster din câteva noduri și am efectuat teste, în cadrul cărora am descoperit că sistemul are o performanță destul de impresionantă, care corespunde avantajelor declarate în benchmark-urile bazelor de date analitice. Am decis să examinăm mai în detaliu conceptul din spatele ClickHouse. Prima dificultate în cercetare a fost lipsa instrumentelor și numărul redus al comunității ClickHouse, așa că am aprofundat designul acestei baze de date pentru a înțelege cum funcționează.
ClickHouse nu acceptă primirea datelor direct de la Kafka, deoarece este doar o bază de date, așa că am scris propriul serviciu de adaptoare în limbajul Go. Acesta citea mesajele codificate Cap’n Proto de la Kafka, le transforma în TSV și le insera în ClickHouse în pachete prin intermediul interfeței HTTP. Mai târziu, am rescris acest serviciu pentru a folosi biblioteca Go împreună cu propriul nostru interfeței ClickHouse pentru a îmbunătăți performanța. La evaluarea performanței primirii pachetelor am descoperit un lucru important — s-a dovedit că la ClickHouse, această performanță depinde mult de dimensiunea pachetului, adică de numărul de rânduri inserate simultan. Pentru a înțelege de ce se întâmplă acest lucru, am studiat cum ClickHouse stochează datele.
Principalul motor, mai exact, familia de motoare pentru tabele, folosită de ClickHouse pentru stocarea datelor, este MergeTree. Acest motor este conceptual similar cu algoritmul LSM utilizat în Google BigTable sau Apache Cassandra, însă evită construirea unei tabele intermediare în memorie și scrie datele direct pe disc. Acest lucru îi oferă o capacitate excelentă de scriere, deoarece fiecare pachet inserat este sortat doar după „cheia principală” primary key, comprimat și scris pe disc pentru a forma un segment.
Lipsa unei tabele de memorie sau a unei noțiuni de „frescă” a datelor înseamnă de asemenea că acestea pot fi doar adăugate, modificarea sau ștergerea nefiind suportată de sistem. În prezent, singura modalitate de a șterge datele este prin eliminarea lor pe luni calendaristice, deoarece segmentele niciodată nu trec granița lunii. Echipa ClickHouse lucrează activ pentru a face această funcție configurabilă. Pe de altă parte, acest lucru face ca scrierea și îmbinarea segmentelor să fie fără conflicte, astfel că lățimea de bandă a recepției se scalează liniar cu numărul de inserții paralele, până când se atinge limita I/O sau a nucleelor.
Cu toate acestea, această circumstanță înseamnă de asemenea că sistemul nu este potrivit pentru pachete mici, motiv pentru care sunt folosite servicii Kafka și insertoare pentru tamponare. În continuare, ClickHouse continuă în fundal să efectueze constant îmbinarea segmentelor, astfel încât multe părți mici de informație vor fi unite și scrise de un număr mai mare de ori, crescând astfel intensitatea scrierii. Totuși, prea multe părți neconectate vor cauza un throttling agresiv al inserțiilor până când îmbinarea continuă. Am descoperit că cel mai bun compromis între recepția datelor în timp real și performanța recepției este primirea într-o tabelă a unui număr limitat de inserții pe secundă.
Cheia performanței citirii tabelelor este indexarea și plasarea datelor pe disc. Indiferent cât de rapidă este procesarea, atunci când motorul trebuie să scaneze terabytes de date de pe disc și să utilizeze doar o parte din acestea, acest lucru va dura timp. ClickHouse este un depozit pe coloane, astfel încât fiecare segment conține un fișier pentru fiecare coloană cu valori sortate pentru fiecare rând. Astfel, coloanele întregi, care nu sunt incluse în interogare, pot fi ocolite la început, iar apoi mai multe celule pot fi procesate în paralel cu o execuție vectorizată. Pentru a evita scanarea completă, fiecare segment are un mic fișier index.
Având în vedere că toate coloanele sunt sortate după „cheia primară”, fișierul index conține doar etichetele (rândurile capturate) ale fiecărui N-lea rând, pentru a putea să le stocheze în memorie chiar și pentru tabele foarte mari. De exemplu, se poate seta o valoare implicită de „a marca fiecare 8192-lea rând”, astfel încât o indexare „sărăcăcioasă” a unei tabele cu 1 trilion de rânduri, care se încadrează ușor în memorie, va ocupa doar 122.070 de caractere.
Dezvoltarea sistemului
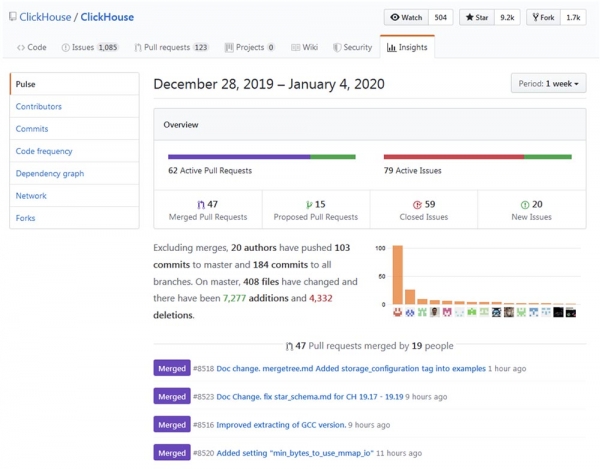
Dezvoltarea și îmbunătățirea Clickhouse poate fi urmărită pe și se poate verifica că procesul de „maturizare” se desfășoară într-un ritm impresionant.
Popularitate
Se pare că popularitatea Clickhouse crește exponențial, în special în comunitatea de limbă rusă. Conferința de anul trecut High load 2018 (Moscova, 8-9 noiembrie 2018) a arătat că monștri precum vk.com și Badoo folosesc Clickhouse, cu ajutorul căruia introduc date (de exemplu, jurnale) de la zeci de mii de servere simultan. Într-un videoclip de 40 de minute . În curând vom publica transcrierea pe Habr pentru a facilita lucrul cu materialul.
Domenii de aplicare
După ce am petrecut ceva timp cercetând, cred că există domenii în care ClickHouse poate fi util sau poate înlocui complet alte soluții mai tradiționale și populare, cum ar fi MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot și Druid. Detaliile privind utilizarea ClickHouse pentru modernizarea sau înlocuirea completă a acestor SGBD-uri sunt prezentate mai jos.
Extinderea capacităților MySQL și PostgreSQL
Recent, am înlocuit parțial MySQL cu ClickHouse pentru platforma de buletine informative . Problema a constat cu MySQL era că, din cauza unui design necorespunzător, înregistra fiecare e-mail trimis și fiecare link din acest e-mail cu un hash base64, creând o masivă tabelă MySQL (email_stats). După ce am trimis utilizatorilor serviciului doar 10 milioane de e-mailuri, această tabelă ocupa 150 GB de spațiu pe disc, iar MySQL începea să „îngreuneze” la interogări simple. Pentru a remedia problema spațiului pe disc, am utilizat cu succes compresia tabelei InnoDB, care a redus dimensiunea acesteia de patru ori. Totuși, nu are sens să păstrăm mai mult de 20-30 de milioane de e-mailuri în MySQL doar pentru a citi istoricul, deoarece orice interogare simplă, care dintr-un anumit motiv trebuie să efectueze o scanare completă, duce la swap și o mare încărcare pe I/O, despre care primeam regulat alerte Zabbix.
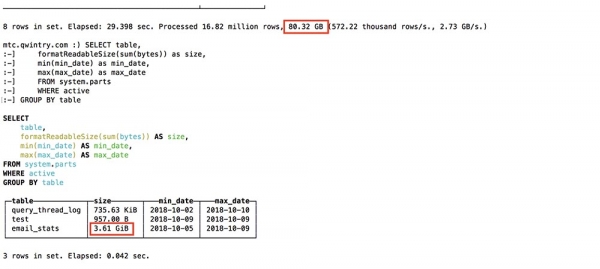
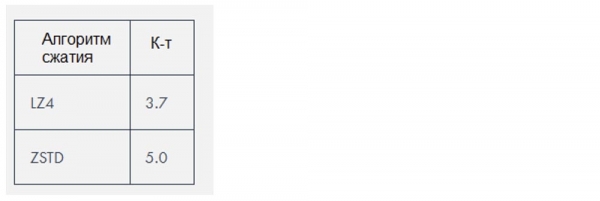
Clickhouse folosește două algoritmi de compresie, care reduc volumul de date cu aproximativ , dar în acest caz particular, datele erau deosebit de „compresibile”.
Înlocuirea ELK
Din experiența proprie, stiva ELK (ElasticSearch, Logstash și Kibana, în acest caz particular ElasticSearch) necesită mult mai multe resurse pentru a funcționa decât sunt necesare pentru stocarea jurnalelor. ElasticSearch este un motor excelent dacă ai nevoie de o căutare text complet bună în jurnale (iar eu nu cred că ai nevoie de asta), dar mă întreb de ce a devenit de facto motorul standard pentru gestionarea jurnalele. Performanța sa în primire, combinată cu Logstash, ne-a creat probleme chiar și cu sarcini destul de mici și a necesitat adăugarea unui volum tot mai mare de memorie RAM și spațiu pe disc. Ca bază de date, Clickhouse este mai bun decât ElasticSearch din următoarele motive:
- Suport pentru dialectul SQL;
- O mai bună rată de compresie a datelor stocate;
- Suport pentru căutarea expresiilor regulate Regex în loc de căutarea textului complet;
- Planificare îmbunătățită a interogărilor și o performanță generală mai bună.
În prezent, cea mai mare problemă care apare în compararea ClickHouse cu ELK este lipsa soluțiilor pentru livrarea jurnalelor, precum și lipsa documentației și a ghidurilor în acest domeniu. Totuși, orice utilizator poate configura ELK folosind ghidul Digital Ocean, ceea ce este foarte important pentru o adoptare rapidă a unor tehnologiilor similare. Aici există un motor de bază de date, dar încă nu există Filebeat pentru ClickHouse. Da, există și un sistem pentru lucrul cu jurnalele , există un instrument pentru a introduce în ClickHouse datele fișierelor jurnal, dar toate acestea necesită mai mult timp. Totuși, ClickHouse rămâne lider datorită simplității sale, astfel încât chiar și începătorii o instalează ușor și încep să o folosească complet în decurs de 10 minute.
Preferând soluțiile minimaliste, am încercat să folosesc FluentBit, un instrument pentru exportarea jurnalele cu un consum foarte mic de memorie, împreună cu ClickHouse, încercând în același timp să evit utilizarea Kafka. Cu toate acestea, este necesar să se rezolve mici incompatibilități, cum ar fi , înainte de a putea fi făcut fără un strat proxy care transformă datele din FluentBit în ClickHouse.
Ca alternativă la Kibana, se poate folosi ClickHouse ca backend pentru . Din câte am înțeles, pot apărea probleme de performanță atunci când se renderizează un număr foarte mare de puncte de date, în special cu versiunile mai vechi de Grafana. La Qwintry nu am încercat încă acest lucru, dar plângerile despre astfel de probleme apar din când în când pe canalul de suport ClickHouse de pe Telegram.
Înlocuirea Google Big Query și Amazon RedShift (soluție pentru mari companii)
O utilizare ideală a BigQuery este să încarci 1 TB de date JSON și să efectuezi interogări analitice asupra acestora. Big Query este un produs excelent, a cărui scalabilitate este greu de supralicitat. Este un software mult mai complex decât ClickHouse, care funcționează pe un cluster intern, dar din perspectiva clientului are multe în comun cu ClickHouse. BigQuery se poate „scumpi” rapid, odată ce începi să plătești pentru fiecare SELECT, astfel încât acesta este o adevărată soluție SaaS cu toate avantajele și dezavantajele sale.
ClickHouse este cea mai bună alegere atunci când efectuezi multe interogări costisitoare din punct de vedere al resurselor de calcul. Cu cât efectuezi mai multe interogări SELECT în fiecare zi — cu atât mai mult are sens să înlocuiești Big Query cu ClickHouse, deoarece o astfel de înlocuire te poate ajuta să economisești mii de dolari, dacă este vorba despre multe terabytes de date procesate. Acest lucru nu se aplică datelor stocate, al căror procesare în Big Query este destul de ieftină.
În articolul co-fondatorului companiei Altinity, Alexandru Zaitsev se discută despre avantajele migrației bazei de date.
Înlocuirea TimescaleDB
TimescaleDB este o extensie PostgreSQL care optimizează manipularea seriilor temporale în baza de date obișnuită., ).
Deși ClickHouse nu este un competitor serios în nișa seriilor temporale, datorită structurii sale pe coloane și execuției vectoriale a interogărilor, în majoritatea cazurilor de procesare a interogărilor analitice, este mult mai rapid decât TimescaleDB. Performanța de preluare a datelor în loturi a ClickHouse este de aproximativ 3 ori mai mare, folosind de asemenea de 20 de ori mai puțin spațiu pe disc, ceea ce este cu adevărat important pentru procesarea unor volume mari de date istorice..
Spre deosebire de ClickHouse, singura modalitate de a economisi puțin spațiu pe disc în TimescaleDB este utilizarea ZFS sau a unor sisteme de fișiere similare.
Actualizările viitoare ale ClickHouse vor introduce probabil compresia delta, ceea ce îl va face și mai potrivit pentru procesarea și stocarea datelor de serii temporale. TimescaleDB ar putea deveni o alegere mai bună decât ClickHouse „gol” în următoarele cazuri:
- instalații mici cu foarte puțin RAM (<3 GB);
- număr mare de INSERT-uri mici, pe care nu doriți să le bufferizați în fragmente mari;
- consistență mai bună, uniformitate și cerințe ACID;
- suport pentru PostGIS;
- integrare cu tabelele existente PostgreSQL, deoarece TimescaleDB este, în esență, PostgreSQL.
Competitivitate cu sistemele Hadoop și MapReduce
Hadoop și alte produse MapReduce pot efectua o mulțime de calcule complexe, dar, în general, funcționează cu întârzieri mari. ClickHouse rezolvă această problemă, procesând terabytes de date și oferind rezultatul aproape instantaneu. Astfel, ClickHouse este mult mai eficient pentru realizarea de cercetări analitice rapide și interactive, ceea ce ar trebui să atragă specialiști în domeniul prelucrării datelor.
Competitivitate cu Pinot și Druid
Cei mai apropiați concurenți ai ClickHouse sunt produsele open source scalabile pe coloane, Pinot și Druid. O comparație excelentă a acestor sisteme a fost publicată în articolul de la 1 februarie 2018.
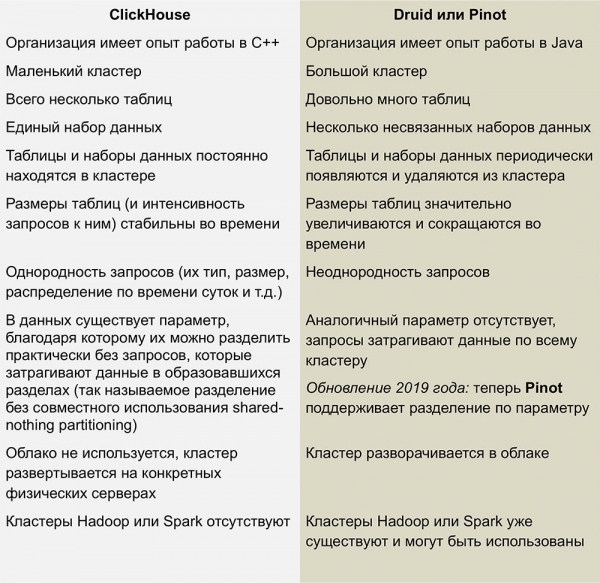
Acest articol necesită actualizare – afirmă că ClickHouse nu suportă operații UPDATE și DELETE, ceea ce nu este complet corect în ceea ce privește cele mai recente versiuni.
Nu avem suficientă experiență în lucrul cu aceste SGBD-uri, dar nu-mi place deloc complexitatea infrastructurii utilizate pentru a rula Druid și Pinot - este o mulțime de „părți mobile”, înconjurate de Java din toate părțile.
Druid și Pinot sunt proiecte incubatoare Apache, iar evoluția lor este detaliat documentată de Apache pe paginile proiectelor lor de pe GitHub. Pinot a apărut în incubator în octombrie 2018, iar Druid s-a născut cu 8 luni mai devreme - în februarie.
Lipsa informațiilor despre modul în care funcționează AFS îmi ridică câteva, și poate chiar prostii, întrebări. Mă întreb dacă autorii Pinot au observat că Fundația Apache este mai înclinați spre Druid și dacă această atitudine față de competitor le-a provocat un sentiment de invidie? Se va încetini dezvoltarea Druid și se va accelera dezvoltarea Pinot, dacă sponsorii care susțin primul se vor interesa brusc de al doilea?
Dezavantajele ClickHouse
Imaturitate: este evident că este încă o tehnologie incipientă, dar oricum, nu existe nimic de acest gen în alte SGBD-uri columnare.
Inserțiile mici funcționează prost cu viteza mare: inserțiile trebuie să fie împărțite în bucăți mari, deoarece performanța inserțiilor mici scade proporțional cu numărul de coloane din fiecare rând. Așa sunt stocate datele în ClickHouse pe disc - fiecare coloană reprezintă 1 fișier sau mai multe, așa că pentru a insera 1 rând care conține 100 de coloane, trebuie să deschideți și să scrieți cel puțin 100 de fișiere. De aceea, pentru a bufferiza inserțiile este nevoie de un intermediar (cu excepția cazului în care clientul însuși nu asigură bufferizarea) - de obicei, acesta este Kafka sau un sistem de gestionare a coșurilor. Se poate folosi, de asemenea, motorul Buffer table pentru a copia ulterior bucăți mari de date în tabelele MergeTree.
Îmbinările de tabele sunt limitate de memoria RAM a serverului, dar, cel puțin, ele există acolo! De exemplu, Druid și Pinot nu au deloc astfel de îmbinări, deoarece este dificil de implementat direct în sistemele distribuite care nu suportă transferul de bucăți mari de date între noduri.
Conclusions
În următorii ani, plănuim să folosim pe scară largă ClickHouse în Qwintry, deoarece acest sistem de gestionare a bazelor de date oferă un echilibru excelent între performanță, overhead redus, scalabilitate și simplitate. Sunt aproape sigur că va începe să se răspândească rapid, odată ce comunitatea ClickHouse va găsi mai multe modalități de a-l utiliza în instalații mici și medii.
Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
