

Algoritmii gestionați de date, cum ar fi rețelele neuronale, au făcut furori în lume. Evoluția lor a fost determinată de mai multe motive, inclusiv echipamentele ieftine și puternice și volumele uriașe de date. Rețelele neuronale sunt în prezent în avangarda tuturor sarcinilor „cognitive”, precum recunoașterea imaginilor, înțelegerea limbajului natural etc. Dar acestea nu ar trebui să fie limitate la astfel de sarcini. În acest material, se discută despre modul de comprimare a imaginilor utilizând rețele neuronale, cu ajutorul învățării reziduale. Abordarea prezentată în articol funcționează mai repede și mai bine decât codec-urile standard. Schemele, ecuațiile și, desigur, tabela cu teste sunt disponibile mai jos.
Acest articol se bazează pe lucrare. Se presupune că sunteți familiarizat cu rețelele neuronale și conceptele lor convoluție și funcția de pierdere.
Ce este comprimarea imaginilor și ce tipuri există?
Comprimarea imaginilor este procesul de transformare a unei imagini astfel încât să ocupe mai puțin spațiu. Stocarea simplă a imaginilor ar ocupa mult spațiu, de aceea există codec-uri, precum JPEG și PNG, care sunt destinate reducerii dimensiunii imaginii originale.
Este bine cunoscut faptul că există două tipuri de comprimare a imaginilor: fără pierderi și cu pierderi. Așa cum sugerează numele, la comprimarea fără pierderi se pot recupera datele imaginii originale, iar la comprimarea cu pierderi unele date se pierd în timpul comprimării. De exemplu, JPG este un algoritm cu pierderi [nota trad. — de obicei, să nu uităm nici de JPEG fără pierderi], iar PNG este un algoritm fără pierderi.
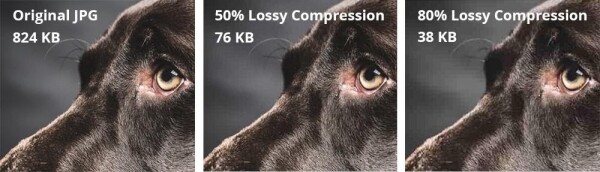
Compararea comprimării fără pierderi și cu pierderi
Observați că imaginea din dreapta are multe artefacte blocante. Acestea sunt informații pierdute. Pixelii vecini de culori similare sunt comprimați ca o singură zonă pentru a economisi spațiu, dar se pierde informația despre pixelii reali. Desigur, algoritmii aplicați în codecurile JPEG, PNG etc. sunt mult mai complecși, dar acesta este un exemplu intuitiv bun de comprimare cu pierderi. Comprimarea fără pierderi este bună, dar fișierele comprimate fără pierderi ocupă mult spațiu pe disc. Există metode mai eficiente de comprimare a imaginilor fără a pierde prea multe informații, dar acestea sunt destul de lente, iar multe folosesc abordări iterative. Acest lucru înseamnă că nu pot fi rulate în paralel pe mai multe nuclee ale procesorului central sau grafic. O astfel de restricție le face complet nepractice în utilizarea de zi cu zi.
Introducerea rețelei neuronale convoluționale
Dacă trebuie să calculați ceva și calculele pot fi aproximative, adăugați . Autorii au folosit o rețea neuronală convoluțională destul de standard pentru a îmbunătăți comprimarea imaginilor. Metoda prezentată nu numai că funcționează la nivelul celor mai bune soluții (dacă nu chiar mai bine), dar poate utiliza și calculul paralel, ceea ce duce la o creștere abruptă a vitezei. Motivul este că rețelele neuronale convoluționale (CNN) sunt foarte bune în extragerea informației spațiale din imagini, care sunt apoi reprezentate într-o formă mai compactă (de exemplu, sunt salvate doar „biturile importante” ale imaginii). Autorii au dorit să utilizeze această capacitate a CNN pentru a reprezenta mai bine imaginile.
Arhitectură
Autorii au propus o rețea dublă. Prima rețea primește ca intrare imaginea și generează o reprezentare compactă (ComCNN). Ieșirea acestei rețele este apoi procesată de un codec standard (de exemplu, JPEG). După procesarea cu codec, imaginea este trimisă către a doua rețea, care „corectează” imaginea din codec în încercarea de a restitui imaginea originală. Autorii au numit această rețea CNN reconstructor (RecCNN). La fel ca GAN, ambele rețele sunt antrenate iterativ.
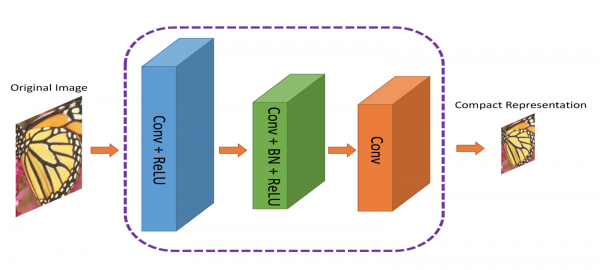
ComCNN Reprezentarea compactă este trimisă codec-ului standard
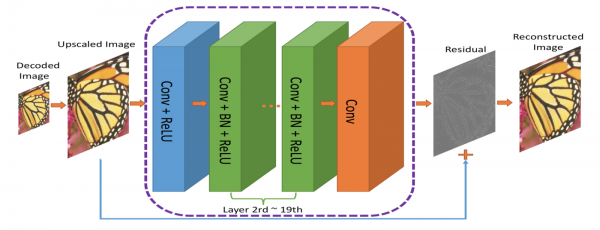
RecCNN. Ieșirile ComCNN sunt scalate și trimise la RecCNN, care va încerca să învețe restul
Ieșirile codec-ului se scaldă cu creșterea și sunt apoi transmise către RecCNN. RecCNN va încerca să genereze o imagine cât mai similară cu originalul.
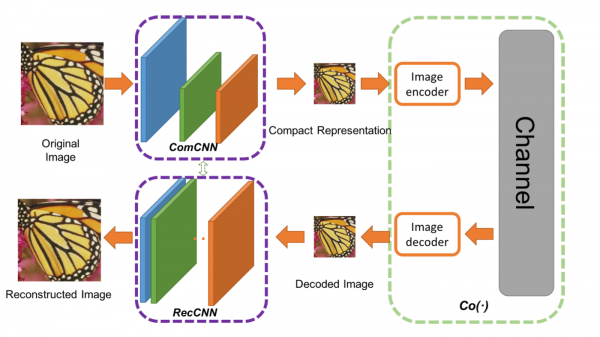
Cadru transversal pentru compresia imaginilor. Co(.) este un algoritm de compresie a imaginilor. Autorii au aplicat JPEG, JPEG2000 și BPG.
Ce este restul?
Restul poate fi considerat un pas postprocesare pentru „îmbunătățirea” imaginii decodificate de codec. Dispunând de o cantitate mai mare de „informații” despre lume, rețeaua neuronală poate lua decizii cognitive despre ce să corecteze. Această idee se bazează pe , despre care puteți citi mai multe detalii. .
Funcțiile de pierdere
Două funcții de pierdere sunt utilizate deoarece avem două rețele neuronale. Prima dintre ele, ComCNN, este marcată ca L1 și este definită astfel:
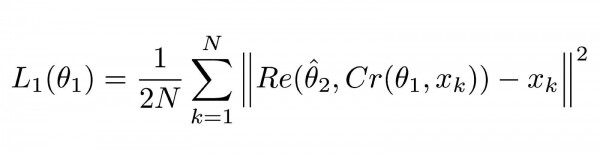
Funcția de pierdere pentru ComCNN
Explicație
Această ecuație poate părea complexă, dar de fapt este o standard (eroare medie pătratică). MSE. ||² reprezintă norma vectorului pe care ei îl includ.
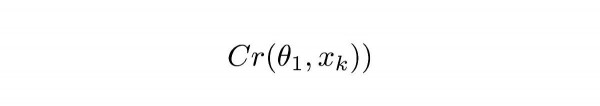
Ecuația 1.1
Cr reprezintă ieșirile ComCNN. θ reprezintă parametrii învățabili ai ComCNN, XK este imaginea de intrare.
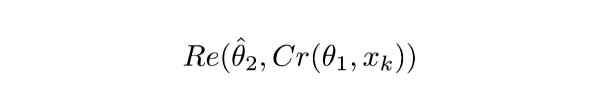
Ecuația 1.2
Re() reprezintă RecCNN. Această ecuație transmite pur și simplu valoarea ecuației 1.1 în RecCNN. θ reprezintă parametrii învățabili ai RecCNN (acoperișul de sus indică faptul că parametrii sunt fixați).
Definiție intuitivă
Ecuația 1.0 va determina ComCNN să își schimbe greutățile astfel încât, după recrearea cu RecCNN, imaginea finală să arate cât mai similar posibil cu imaginea de intrare. A doua funcție de pierdere a RecCNN este definită astfel:
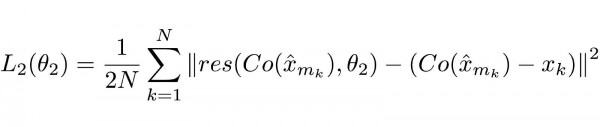
Ecuația 2.0
Explicație
Din nou, funcția poate părea complexă, dar este în mare parte o funcție standard de pierdere a rețelei neuronale (MSE).
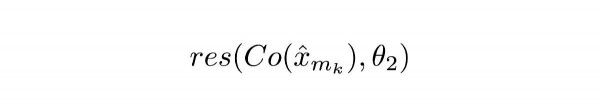
Ecuația 2.1
Co() reprezintă ieșirea codec-ului, x cu acoperișul de sus reprezintă ieșirea ComCNN. θ2 sunt parametrii învățabili ai RecCNN. res() reprezintă pur și simplu ieșirea residuală a RecCNN. Este demn de menționat că RecCNN este antrenat pe diferența dintre Co() și imaginea de intrare, dar nu pe imaginea de intrare.
Definiție intuitivă
Ecuația 2.0 va determina RecCNN să își schimbe greutățile astfel încât ieșirile să arate cât mai asemănătoare posibile cu imaginea de intrare.
Schema de învățare
Modelele sunt antrenate iterativ, similar cu Greutatea primului model este fixată, în timp ce greutatea celui de-al doilea model este actualizată, apoi greutatea celui de-al doilea model este fixată, în timp ce primul model se antrenează.
Teste
Autorii au comparat metoda lor cu metodele existente, inclusiv codecurile simple. Metoda lor funcționează mai bine decât altele, menținând în același timp o viteză ridicată pe hardware-ul corespunzător. În plus, autorii au încercat să folosească doar una dintre cele două rețele și au observat o scădere a performanței.
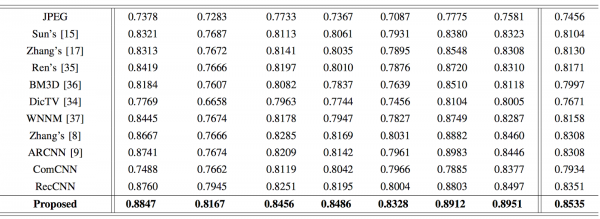
Compararea indicelui de similaritate structurală (SSIM). Valorile ridicate indică o similaritate mai bună cu originalul. Rezultatul muncii autorilor este evidențiat cu caractere îngroșate.
Concluzie
Am examinat o nouă modalitate de aplicare a învățării profunde pentru comprimarea imaginilor, discutând despre posibilitatea utilizării rețelelor neuronale în sarcini în afară de cele „generale”, cum ar fi clasificarea imaginilor și procesarea limbajului. Această metodă nu doar că nu cedează standardelor moderne, dar permite și procesarea imaginilor mult mai rapid.
Studenții la rețele neuronale au acum o modalitate mai ușoară, deoarece am creat un cod promoțional special pentru utilizatorii Habr. HABR, oferind o reducere suplimentară de 10% față de discountul indicat pe banner.
Alte cursuri
Articole recomandate
Sursa: habr.com
