

În prezent, există soluții gata făcute (proprietare) pentru monitorizarea fluxurilor IP(TS), de exemplu și , acestea dispun de un set destul de bogat de funcții și, de obicei, astfel de soluții sunt disponibile la marii operatori care oferă servicii TV. În acest articol, se descrie o soluție bazată pe proiectul open source , destinat controlului minim al fluxurilor IP(TS) prin intermediul contorului CC (continuity counter) și al bit rate-ului. O eventuală utilizare ar fi controlul pierderii de pachete sau a fluxului întreg printr-un canal L2 închiriat (care nu poate fi monitorizat corespunzător, de exemplu, prin citirea contoarelor de pierdere din cozi).
Un scurt rezumat despre TSDuck
TSDuck este un software open source (licență 2-Clause BSD) (un set de utilitare de linie de comandă și o bibliotecă pentru dezvoltarea propriilor utilitare sau plugin-uri) pentru manipularea fluxurilor TS. Ca intrare, poate lucra cu IP (multicast/unicast), http, hls, tunere dvb, demodulator dvb-asi de la dektec, are un generator intern de flux TS și citire din fișiere. Ca ieșire, poate salva în fișier, IP (multicast/unicast), hls, demodulatoare de la dektec și HiDes, player-e (mplayer, vlc, xine) și drop. Între intrare și ieșire, pot fi incluse diferite procesatoare de trafic, cum ar fi remapping-ul PID-urilor, scrambling/descrambling, analiza contoarelor CC, calcularea bit rate-ului și alte operațiuni tipice pentru fluxurile TS.
În acest articol, fluxurile IP (multicast) vor fi utilizate ca intrare, folosind procesoarele bitrate_monitor (din denumire este evident ce este) și continuity (analiza contoarelor CC). Fără probleme, se poate înlocui IP multicast cu un alt tip de intrare, acceptat de TSDuck.
Există TSDuck pentru majoritatea sistemelor de operare actuale. Pentru Debian nu există, dar s-a reușit să se compileze fără probleme pe debian 8 și debian 10.
În continuare, se folosește versiunea TSDuck 3.19-1520, sistemul de operare utilizat este Linux (pentru pregătirea soluției s-a folosit debian 10, pentru utilizarea reală — CentOS 7)
Pregătirea TSDuck și a sistemului de operare
Înainte de a monitoriza fluxurile reale, trebuie să ne asigurăm că TSDuck funcționează corect și că nu apar pierderi la nivelul plăcii de rețea sau al sistemului de operare (socket). Acest lucru este necesar pentru a nu ne întreba ulterior unde au avut loc pierderile — în rețea sau „în interiorul serverului”. Putem verifica pierderile la nivelul plăcii de rețea cu comanda ethtool -S ethX, configurările se fac tot cu ethtool (de obicei, trebuie să creștem buffer-ul RX (-G) și uneori să dezactivăm anumite offloads (-K)). Ca recomandare generală, se poate sugera utilizarea unui port separat pentru primirea traficului analizat, dacă este posibil, pentru a minimiza alertele false legate de faptul că pierderea a avut loc în mod corespunzător pe portul analizerului din cauza altui trafic. Dacă nu este posibil (se folosește un mini-computer/NUC cu un singur port), atunci este deosebit de recomandat să se configureze prioritizarea traficului analizat în raport cu celălalt pe dispozitivul la care este conectat analizerul. În ceea ce privește mediile virtuale, aici trebuie să fim prudenți și să fim capabili să identificăm pierderile de pachete începând de la portul fizic și terminând cu aplicația din interiorul mașinii virtuale.
Generarea și primirea fluxului în cadrul gazdei
Ca prim pas în pregătirea TSDuck, vom genera și primi trafic într-o singură gazdă folosind netns.
Pregătim mediul:
ip netns add P #creăm netns P, în care se va realiza analiza traficului
ip link add type veth #creăm o pereche veth - veth0 rămâne în netns implicit (traficul va fi generat pe această interfață)
ip link set dev veth1 netns P #veth1 - plasăm în netns P (traficul va fi primit pe această interfață)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #activăm IP pe veth1, nu contează ce anume
ip netns exec P ip ro add default via 192.0.2.2 #setăm ruta implicită în interiorul netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #dezmultiplicăm IPv6 pe veth0 - acest lucru se face pentru ca deșeurile externe să nu fie incluse în contorul TX
ifconfig veth0 up #activăm interfața veth0
ip route add 239.0.0.1 dev veth0 #creăm o rută astfel încât OS-ul să dirijeze traficul către 239.0.0.1 pe calea veth0
Mediul este pregătit. Vom lansa analizerul de trafic:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
unde „-p 1 -t 1” înseamnă că trebuie să calculăm bitrate-ul în fiecare secundă și să afișăm informații despre bitrate în fiecare secundă
Lansăm generatorul de trafic cu o viteză de 10Mbit/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
unde «-p 7 -e» înseamnă că trebuie să împachetăm câte 7 pachete TS într-un pachet IP și să facem acest lucru rigid (-e), adică să așteptăm întotdeauna 7 pachete TS de la ultimul procesor înainte de a trimite formarea pachetului IP.
Analizatorul începe să emită mesajele așteptate:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, TS bitrate: 9,970,016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, TS bitrate: 10,022,656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, TS bitrate: 9,980,544 bits/s
Acum adăugăm câteva drop-uri:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPși apar mesaje de genul celor:
* 2020/01/03 14:57:11 - continuity: packet index: 80,745, PID: 0x0000, missing 7 packets
* 2020/01/03 14:57:11 - continuity: packet index: 83,342, PID: 0x0000, missing 7 packets
ceea ce este de așteptat. Dezactivăm pierderea pachetelor (ip netns exec P iptables -F) și încercăm să creștem bitrate-ul generatorului la 100Mbit/s. Analizatorul raportează multe erori CC și aproximativ 75 Mbit/s în loc de 100. Încercăm să înțelegem cine este vinovat — generatorul nu reușește sau este o problemă diferită, pentru aceasta lansăm generația unui număr fix de pachete (700000 TS-pachete = 100000 IP-pachete):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
După cum se poate observa, au fost generate exact 100000 IP-pachete (151925460-151825460). Asta înseamnă că trebuie să analizăm ce se întâmplă cu analizadorul, pentru asta comparăm cu contorul RX pe veth1, acesta fiind strict egal cu contorul TX pe veth0, apoi vedem ce se întâmplă la nivel de socket:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Aici vedem numărul de drop-uri = 24355. În pachetele TS, acestea sunt 170485 sau 24.36% din 700000, astfel vedem că acele 25% din bitrate-ul pierdut sunt drop-uri în socket-ul UDP. Drop-urile în socket-ul UDP apar de obicei din cauza lipsei de buffer, să vedem care este dimensiunea buffer-ului socket-ului implicit și dimensiunea maximă a buffer-ului:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Astfel, dacă aplicațiile nu cer explicit dimensiunea buffer-ului, socket-urile sunt create cu un buffer de 208 Kb, dar dacă cer mai mult, tot nu vor primi dimensiunea solicitată. Deoarece în tsp pentru intrarea IP se poate stabili dimensiunea buffer-ului (—buffer-size), nu vom modifica dimensiunea implicită a socket-ului, ci vom stabili doar dimensiunea maximă a buffer-ului socket-ului și vom specifica dimensiunea buffer-ului explicit prin argumentele tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Cu o astfel de ajustare a buffer-ului socket-ului, bitrate-ul raportat acum este de aproximativ 100Mbit/s, fără erori CC.
După consumul de CPU al aplicației tsp. În ceea ce privește un singur nucleu i5-4260U CPU @ 1.40GHz, pentru analiza unui flux de 10 Mbit/s este necesar 3-4% CPU, 100 Mbit/s — 25%, 200 Mbit/s — 46%. La specificarea % de pachete pierdute, încărcătura pe CPU nu crește aproape deloc (dar poate scădea).
Pe un hardware mai performant, am reușit fără probleme să generăm și să analizăm fluxuri de peste 1 Gbit/s.
Testarea pe plăcile de rețea reale
După testarea pe un pereche veth, trebuie să luăm două gazde sau două porturi ale aceleași gazde, să conectăm porturile între ele, pe unul să pornim generatorul, iar pe celălalt analizorul. Aici nu au apărut surprize, dar de fapt totul depinde de hardware; cu cât este mai slab, cu atât va fi mai interesant.
Utilizarea datelor colectate de sistemul de monitorizare (Zabbix)
Tsp nu are un API machine-readable de tip SNMP sau similar. Mesajele CC trebuie aggregate cel puțin la 1 secundă (în cazul unui procent ridicat de pachete pierdute, pot exista sute/mi de mesaje pe secundă, în funcție de bitrate).
Astfel, pentru a salva atât informațiile, cât și a desena graficele legate de erorile CC și bitrate și pentru a face unele analize, următoarele opțiuni ar putea fi disponibile:
- Parsează și agregă (pe CC) output-ul tsp, adică transformă-l în forma necesară.
- Îmbunătățește tsp și/sau pluginurile pentru procesor bitrate_monitor și continuity, astfel încât rezultatul să fie oferit într-o formă machine-readable, adecvată pentru sistemul de monitorizare.
- Scrie aplicația ta deasupra bibliotecii tsduck.
Este evident că, din punct de vedere al efortului, opțiunea 1 este cea mai simplă, mai ales având în vedere că tn însuși tsduck este scris într-un limbaj de nivel inferior (după standardele moderne) (C++)
Un prototip simplu de parser+aggregator în bash a arătat că, pe un flux de 10 Mbit/s și 50% pierderi de pachete (cea mai proastă variantă), procesul bash consuma de 3-4 ori mai mult CPU decât procesul tsp. Această variantă de evoluție a evenimentelor este inacceptabilă. De fapt, un fragment din acest prototip este mai jos.
Paste pe bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Pe lângă faptul că funcționează inacceptabil de lent, bash nu are fire de execuție adecvate, iar sarcinile bash sunt procese independente, astfel că a fost necesară înregistrarea valorii missingPackets odată pe secundă la efectul secundar (la primirea mesajelor de bitrate, care sosesc în fiecare secundă). În final, bash a fost lăsat deoparte și s-a decis să se scrie o wrapper (parser + aggregator) în golang. Consumul de CPU al unui cod similar în golang este de 4-5 ori mai mic decât al procesului tsp. Accelerarea wrapper-ului prin înlocuirea bash cu golang a fost de aproximativ 16 ori, iar rezultatul general este acceptabil (overhead-ul pe CPU în cel mai rău caz este de 25%). Fișierul sursă în golang se află .
Lansarea wrapper-ului
Pentru a lansa wrapper-ul, a fost creat un șablon simplu de serviciu pentru systemd (). Se presupune că wrapper-ul în sine este compilat într-un fișier binar (go build tsduck-stat.go), plasat în /opt/tsduck-stat/. Se presupune că se folosește golang cu suport pentru monochronic clock (>=1.9).
Pentru a crea o instanță a serviciului, trebuie să executați comanda systemctl enable tsduck-stat@239.0.0.1:1234, apoi să-l porniți cu systemctl start tsduck-stat@239.0.0.1:1234.
Descoperire din Zabbix
Pentru ca zabbix să poată realiza descoperirea serviciilor în execuție, a fost creat un (discovery.sh), în formatul necesar pentru descoperirea Zabbix, se presupune că este plasat acolo - în /opt/tsduck-stat. Pentru a rula descoperirea prin zabbix-agent, trebuie să adăugați în directorul cu configurațiile agentului zabbix pentru a adăuga un parametru user.
Șablon Zabbix
(tsduck_stat_template.xml) conține o regulă de auto-descoperire, prototipuri de elemente de date, grafice și triggere.
Listă de verificare scurtă (în caz că cineva decide să folosească)
- Asigurați-vă că tsp nu drop-ează pachete în condiții «ideale» (generatorul și analizatorul sunt conectate direct), dacă există pierderi, consultați pct.2 sau textul articolului în acest sens.
- Faceți tuning-ul buffer-ului maxim al socket-ului (net.core.rmem_max=8388608).
- Compilați tsduck-stat.go (go build tsduck-stat.go).
- Plasați șablonul serviciului în /lib/systemd/system.
- Porniți serviciile cu systemctl, verificați că au început să apară contoare (grep «» /dev/shm/tsduck-stat/*). Numărul de servicii este egal cu numărul fluxurilor multicast. Aici poate fi necesar să creați o rută către grupul multicast, posibil să dezactivați rp_filter sau să creați o rută către ip-ul sursă.
- Rulați discovery.sh, asigurați-vă că generează json.
- Plasați config-ul agentului zabbix, reporniți agentul zabbix.
- Încărcați șablonul în zabbix, aplicați-l pe gazda pe care o monitorizați și pe care este instalat zabbix-agent, așteptați aproximativ 5 minute, verificați dacă au apărut elemente noi de date, grafice și triggere.
Rezultatul
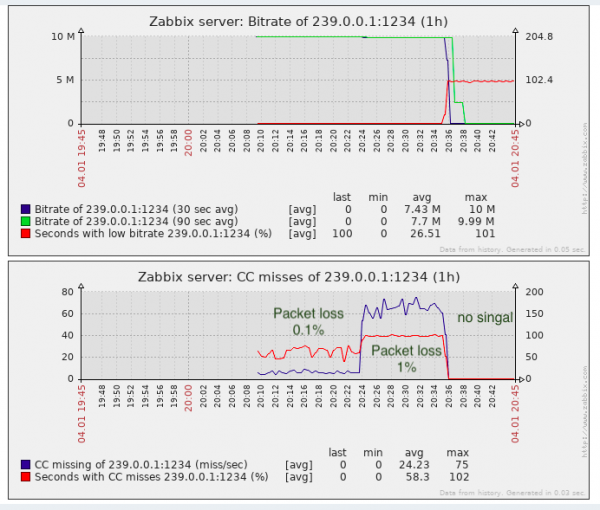
Pentru sarcina de identificare a pierderii pachetelor, este suficient, mai bine decât absența monitorizării.
În realitate, CC-„pierderile” pot apărea la lipirea fragmentelor video (după cum știu, așa se fac inserțiile în centrele de televiziune locale din RF, adică fără recalcularea contorului CC), este bine să ții cont de asta. În soluțiile proprietare, această problemă este parțial ocolită prin detectarea etichetelor SCTE-35 (dacă acestea sunt adăugate de generatorul de flux).
Din perspectiva monitorizării calității transportului, lipsește monitorizarea jitter (IAT), deoarece echipamentele TV (fie ele modulatoare sau dispozitive finale) au cerințe legate de acest parametru și nu întotdeauna se poate extinde jitbuffer-ul la infinit. Iar jitter-ul poate varia atunci când echipamentele cu buffer mari sunt utilizate în tranzit și QoS-ul pentru transmiterea acestui tip de trafic în timp real nu este setat sau nu este suficient de bine configurat.
Sursa: habr.com
