

Sărbătorile s-au încheiat și revenim cu al doilea nostru articol din seria despre Istio Service Mesh.
Tema de astăzi este Circuit Breaker, care în traducere în română înseamnă „disjunctor”, cunoscut și sub denumirea populară de „automatul de protecție”. Doar că în Istio acest automat nu deconectează un circuit scurtcircuitat sau suprasolicitat, ci containerele defecte.
Cum ar trebui să funcționeze ideal
Când microserviciile sunt gestionate de Kubernetes, de exemplu, în cadrul platformei OpenShift, ele se scalază automat în sus și în jos în funcție de încărcare. Deoarece microserviciile funcționează în poduri, la un singur punct final pot exista mai multe instanțe ale microserviciului containerizat, iar Kubernetes va ruta cererile și va echilibra încărcarea între acestea. Și – în mod ideal – totul ar trebui să funcționeze perfect.
Ne amintim că microserviciile sunt mici și efemere. Efemeritatea, în acest context, înseamnă ușurința cu care apar și dispar, aspeptare căreia îi subestimăm adesea importanța. Nașterea și moartea unei noi instanțe de microserviciu într-un pod sunt lucruri complet normale, pe care OpenShift și Kubernetes le gestionează bine, și totul funcționează minunat – dar din nou, doar în teorie.
Cum funcționează de fapt
Acum imaginați-vă că o anumită instanță a microserviciului, adică un container, a devenit defectă: fie nu răspunde (eroare 503), fie – ceea ce este și mai neplăcut – răspunde, dar este prea lent. Cu alte cuvinte, are mici erori sau nu răspunde la cereri, dar nu este eliminat automat din grup. Ce ar trebui să facem în acest caz? Să repetăm încercarea? Să-l eliminăm din schema de rutare? Și ce înseamnă „prea lent” – câte date sunt acestea, și cine le stabilește? Poate ar trebui pur și simplu să-i dăm o pauză și să încercăm din nou mai târziu? Dacă da, atunci cât de târziu?
Ce este Pool Ejection în Istio
Și aici intervine Istio cu automatele sale de protecție Circuit Breaker, care elimină temporar containerele defecte din grupul de resurse de rutare și echilibrare a încărcării, implementând procedura de Pool Ejection.
Folosind strategia de detectare a anomaliilor (outlier detection), Istio detectează podurile anormale, care se abată de la norma generală, și le elimină din grupul de resurse pentru o perioadă specificată, cunoscută sub denumirea de „fereastra de somn” (sleep window).
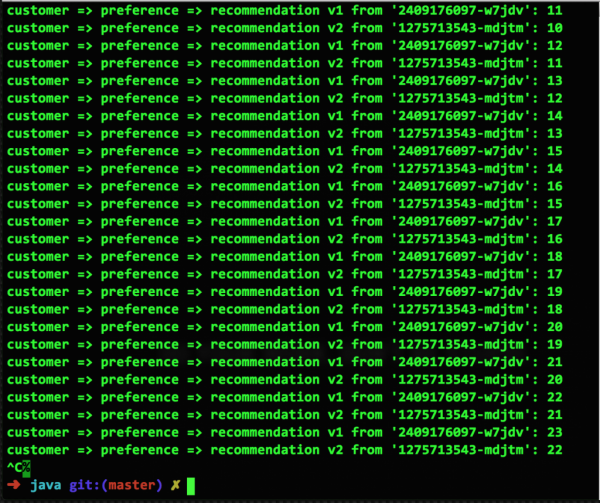
Pentru a arăta cum funcționează acest lucru în Kubernetes pe platforma OpenShift, să începem cu un screenshot al microservicelor care funcționează normal din exemplul din repository . Aici avem două poduri, v1 și v2, fiecare conținând un container. Atunci când reguli de rutare Istio nu sunt utilizate, Kubernetes aplică implicit rutarea echilibrată uniform:
Ne pregătim pentru o defecțiune
Înainte de a face Pool Ejection, trebuie să creăm o regulă de rutare Istio. Să presupunem că dorim să distribuim cererile între poduri în proporție de 50/50. De asemenea, vom crește numărul de containere v2 de la unul la două, iată cum:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Acum stabilim o regulă de rutare pentru a distribui traficul între poduri în proporție de 50/50.
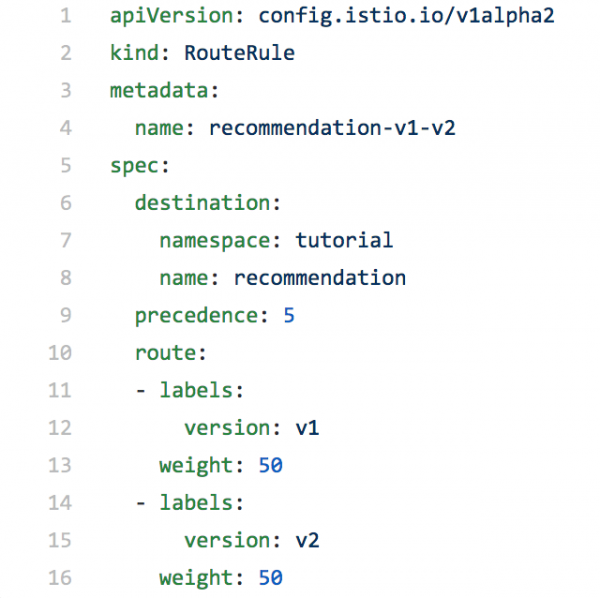
Iată cum arată rezultatul acestei reguli:
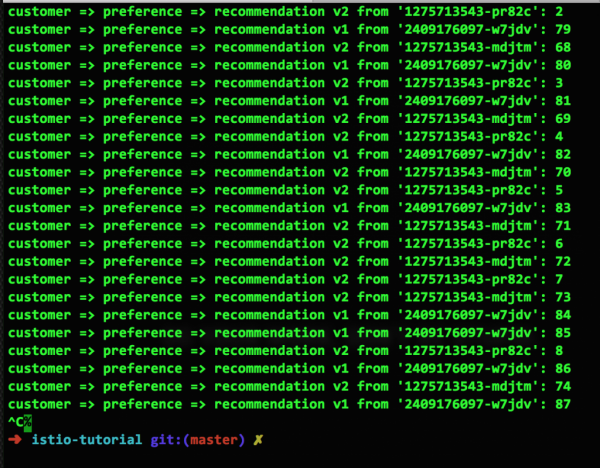
Se poate observa că în acest screenshot nu este 50/50, ci 14:9, dar cu timpul situația se va ajusta.
Provocăm o defecțiune
Acum vom scoate din funcțiune unul dintre cele două containere v2, astfel încât să avem un container v1 funcțional, un container v2 funcțional și un container v2 defect:
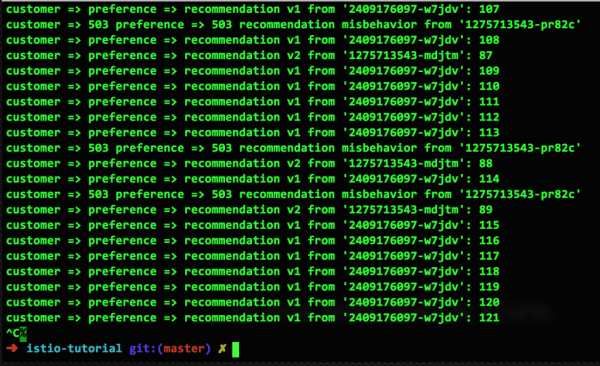
Remediem defecțiunea
Așadar, avem un container defect, iar acum a venit momentul pentru Pool Ejection. Cu un config foarte simplu, vom exclude acest container defect din orice scheme de rutare timp de 15 secunde, în așteptarea că se va restabili (fie se va reporni, fie va recupera performanța). Iată cum arată acest config și rezultatele sale:
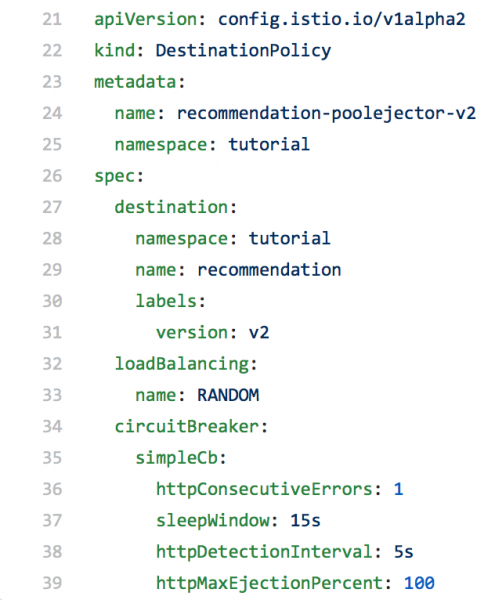
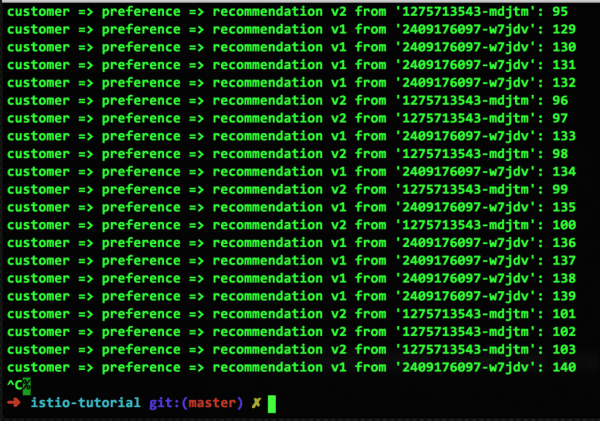
După cum se observă, containerul defect v2 nu mai este utilizat în rutarea cererilor, deoarece a fost exclus din pool. Dar, după 15 secunde, se va întoarce automat în pool. Practic, tocmai am demonstrat cum funcționează Pool Ejection.
Începem să construim arhitectura
Pool Ejection, împreună cu capabilitățile de monitorizare Istio, permite începerea construcției unui cadru de înlocuire automată a containerelor defecte, pentru a reduce sau chiar a elimina timpii morți și defecțiunile.
NASA are un slogan celebru - Failure Is Not an Option, atribuit managerului de zbor . În română, acesta poate fi tradus ca „Eșecul nu este o opțiune”, iar sensul este că totul poate fi făcut să funcționeze având suficientă voință. Totuși, în viața reală, eșecurile nu se întâmplă doar ocazional, ci sunt inevitabile, pretutindeni și în toate domeniile. Cum putem face față acestor situații în cazul microserviciilor? După părerea noastră, este mai bine să ne bazăm nu pe voința umană, ci pe capacitățile containerelor. , , și .
Istio, așa cum am menționat mai devreme, implementează o concepție bine cunoscută din lumea fizică, și anume conceptul de disjunctor automat. Așa cum un disjunctor electric deconectează o parte problemă a circuitului, tot așa Circuit Breaker din Istio întrerupe legătura dintre fluxul de cereri și containerul problematic atunci când există o problemă cu punctul final, de exemplu, când serverul a căzut sau a început să încetinească.
În plus, în al doilea caz, problemele sunt cu atât mai multe, deoarece încetinirea unui container nu doar că produce o cascadă de întârzieri în serviciile care îl accesează, și, ca rezultat, reduce performanța sistemului în ansamblu, ci și generează cereri repetate către serviciul deja lent, ceea ce agravează situația.
Circuit Breaker în teorie
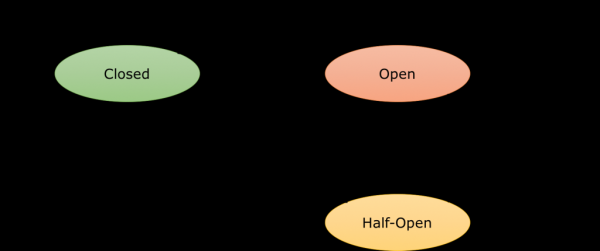
Circuit Breaker este un proxy care controlează fluxul cererilor către punctul final. Atunci când acest punct încetează să funcționeze sau, în funcție de setările specificate, începe să încetinească, proxy-ul întrerupe legătura cu containerul. După aceea, traficul este redirecționat către alte containere, pur și simplu din cauza echilibrării încărcării. Legătura rămâne deschisă (open) pe parcursul unei feronierii stabilite, să spunem, două minute, și apoi este considerată semi-deschisă (half-open). Încercarea de a trimite următoarea cerere determină starea ulterioară a conexiunii. Dacă totul este în regulă cu serviciul, conexiunea revine la starea de funcționare și devine din nou închisă (closed). Dacă serviciul continuă să aibă probleme, conexiunea se deschide din nou și se reactivează fereastra de somn. Așa arată o diagramă simplificată a schimbărilor de stare ale Circuit Breaker:
Este important de menționat că totul se întâmplă la nivelul, așa-zisei, arhitecturi de sistem. Prin urmare, va trebui la un moment dat să învățați aplicațiile dvs. să funcționeze cu Circuit Breaker, de exemplu, oferind un răspuns implicit sau, dacă este posibil, ignorând existența serviciului. Pentru aceasta, se folosește pattern-ul bulkhead, dar acesta depășește subiectul acestui articol.
Circuit Breaker în practică
Ca exemplu, vom lansa pe OpenShift două versiuni ale microserviciului nostru de recomandări. Versiunea 1 va funcționa normal, în timp ce în v2 vom introduce o întârziere pentru a imita un blocaj pe server. Instrumentul folosit pentru vizualizarea rezultatelor este :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
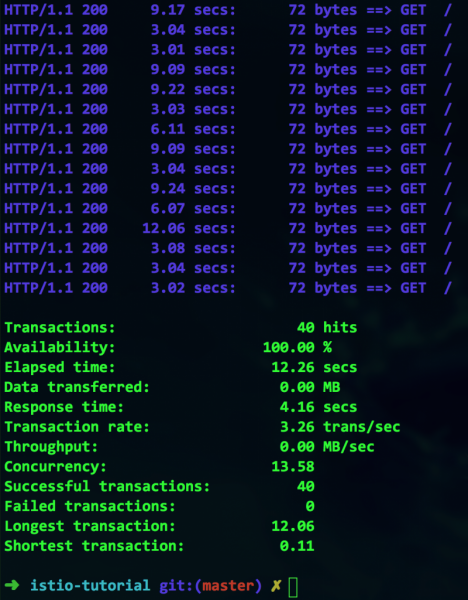
Totul pare să funcționeze, dar la ce preț? La prima vedere, avem o disponibilitate de 100%, dar dacă ne uităm mai atent – durata maximă a tranzacției este de 12 secunde. Acesta este clar un punct slab și trebuie să îl remediem.
Pentru aceasta, vom folosi Istio pentru a exclude apelurile către containerele lente. Iată cum arată configurația corespunzătoare folosind Circuit Breaker:
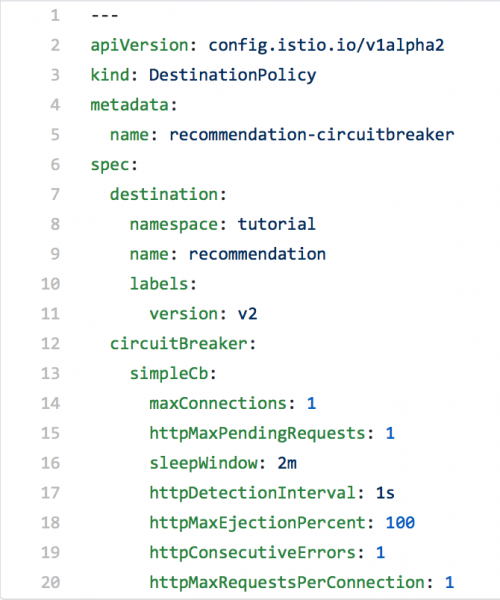
Ultima linie cu parametrul httpMaxRequestsPerConnection semnalează că conexiunea trebuie să fie deschisă la încercarea de a crea o nouă – a doua – conexiune pe lângă cea existentă. Deoarece containerul nostru imită un serviciu care întârzie, astfel de situații vor apărea periodic, iar Istio va returna o eroare 503, iar ceea ce va arăta siege:
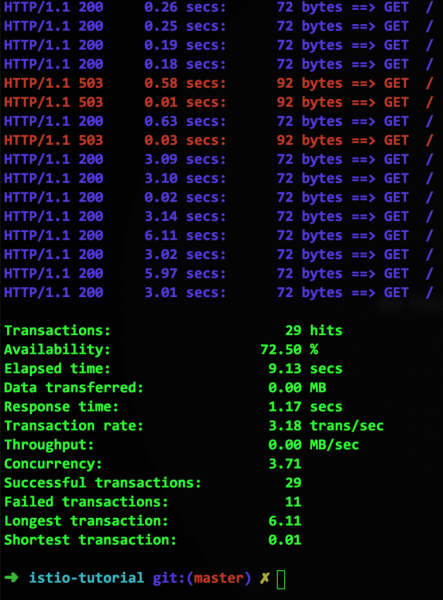
Bine, avem Circuit Breaker, ce urmează?
Așadar, am implementat deconectarea automată, fără a modifica codul sursă al serviciilor în sine. Folosind Circuit Breaker și procedura descrisă anterior de Pool Ejection, putem elimina din pool-ul de resurse containerele care blochează, până când acestea revin la normal, și putem verifica starea lor la intervale definite – în exemplul nostru, două minute (parametrul sleepWindow).
Rețineți că capacitatea aplicației de a reacționa la eroarea 503 este încă definită la nivelul codului său sursă. Există numeroase strategii pentru utilizarea Circuit Breaker, care se aplică în funcție de situație.
În următoarea postare: vom discuta despre trasarea și monitorizarea care sunt deja integrate sau ușor de adăugat în Istio, precum și despre cum putem introduce erori în sistem intenționat.
Sursa: habr.com
