

De la redactorul blogului Google: Te-ai întrebat vreodată cum intervin inginerii Google Cloud Technical Solutions (TSE) în solicitările tale de suport tehnic? Inginerii de suport tehnic TSE au responsabilitatea de a identifica și rezolva sursele problemelor semnalate de utilizatori. Unele dintre aceste probleme sunt destul de simple, dar uneori apare o solicitare care necesită atenția a mai multor ingineri. În acest articol, unul dintre angajații TSE ne va povesti despre o problemă foarte complexă din practica sa recentă — . În timpul acestei povești, vom observa cum au reușit inginerii să rezolve situația și ce nouă cunoștințe au dobândit în timpul remedierii erorii. Sperăm că această poveste nu doar că va explica un bug adânc înrădăcinat, ci va oferi și o înțelegere a proceselor care au loc atunci când se face o solicitare de suport la Google Cloud.
Remedierea problemelor este atât știință, cât și artă. Totul începe cu formularea unei ipoteze despre cauza comportamentului anormal al sistemului, după care aceasta este testată. Cu toate acestea, înainte de a formula o ipoteză, trebuie să definim clar și să formulăm cu precizie problema. Dacă întrebarea este prea vagă, va trebui să analizezi totul în profunzime; acesta este „arta” remediării problemelor.
În contextul Google Cloud, aceste procese sunt mult mai complicate, deoarece Google Cloud se străduiește din răsputeri să garanteze confidențialitatea utilizatorilor săi. Din acest motiv, inginerii TSE nu au acces la editarea sistemelor tale, nici la o analiză atât de detaliată a configurațiilor, așa cum o fac utilizatorii. Prin urmare, pentru a verifica vreo ipoteză, noi (inginerii) nu putem modifica rapid sistemul.
Unii utilizatori cred că vom rezolva totul ca mecanicii într-un service auto și pur și simplu ne trimit ID-ul mașinii virtuale, în timp ce, în realitate, procesul decurge într-un format bazat pe discuție: colectarea informațiilor, formularea și confirmarea (sau infirmarea) ipotezelor, iar, în cele din urmă, soluționarea problemei se bazează pe comunicarea cu clientul.
Problema în discuție
Astăzi avem în față o poveste cu un final fericit. Unul dintre motivele pentru care cazul propus a fost soluționat cu succes se datorează descrierii foarte detaliate și precise a problemei. Mai jos, puteți vedea o copie a primului tichet (editat pentru a ascunde informațiile confidențiale):
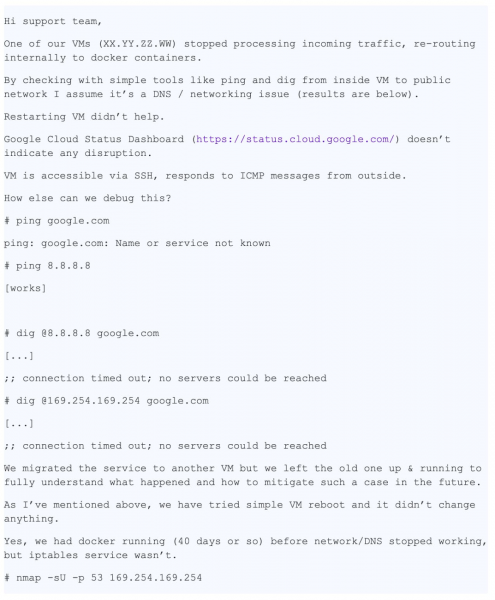
Acest mesaj conține foarte multe informații utile pentru noi:
- Este specificată VM-ul concretă
- Problema în sine este specificată — nu funcționează DNS-ul
- Este indicat unde se manifestă problema — VM și container
- Sunt enumerate pașii parcurși de utilizator pentru identificarea problemei
Solicitarea a fost înregistrată ca „P1: Impact critic — Serviciu inutilizabil în producție”, ceea ce înseamnă monitorizarea constantă a situației 24/7 conform schemei „Follow the Sun” (puteți citi mai multe despre ), transferându-se de la o echipă de asistență tehnică la alta la fiecare schimbare a fusului orar. Practic, până la momentul în care problema a ajuns la echipa noastră din Zurich, a reușit să ocolească globul. Între timp, utilizatorul a luat măsuri pentru a diminua impactul, dar se temea de repetarea situației în producție, deoarece cauza principală nu fusese încă descoperită.
La momentul în care tichetul a ajuns la Zurich, aveam deja următoarele informații:
- Conținut
/etc/hosts - Conținut
/etc/resolv.conf - Ieșire
iptables-save - Fișierul
ngreppcap adunat de echipă
Cu aceste date, eram pregătiți să începeți faza de „investigație” și depanare.
Primii noștri pași
În primul rând, am verificat jurnalele și statusul serverului de metadate și ne-am asigurat că funcționează corect. Serverul de metadate răspunde la adresa IP 169.254.169.254 și, printre altele, se ocupă de gestionarea numelui de domeniu. Am verificat, de asemenea, că firewall-ul funcționează corect cu VM-ul și nu blochează pachetele.
A fost o problemă ciudată: verificarea nmap a infirmat principala noastră ipoteză despre pierderile de pachete UDP, așa că am conceput mental alte câteva opțiuni și metode de verificare:
- Pachetele dispar selectiv? => Verificați regulile iptables
- Nu e cumva prea mic ? => Проверить вывод
ip a show - Problema afectează doar pachetele UDP sau și cele TCP? => Rulați
dig +tcp - Se returnează pachetele generate de dig? => Rulați
tcpdump - Funcționează corect libdns? => Rulați
stracepentru verificarea transmiterii pachetelor în ambele direcții
Aici decidem să facem un apel cu utilizatorul pentru a depana live.
În timpul apelului, reușim să verificăm mai multe lucruri:
- După câteva verificări, excludem regulile iptables din lista cauzelor
- Verificăm interfețele rețelei și tabelele de rutare și re-verificăm corectitudinea MTU-ului
- Descoperim că
dig +tcp google.com(TCP) funcționează corect, dardig google.com(UDP) nu funcționează - După ce rulăm
tcpdumpfuncționează până acumdig, descoperim că pachetele UDP se întorc - Rulăm
strace dig google.comși vedem cum dig apelează corectsendmsg()șirecvms(), totuși a doua este întreruptă din cauza timeout-ului
Din păcate, se termină schimbul și suntem nevoiți să transferăm problema în zona orară următoare. Totuși, apelul a stârnit interes în echipa noastră și un coleg propune să creăm pachetul DNS de bază folosind modulul python scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Acest fragment creează un pachet DNS și trimite cererea serverului de metadata.
Utilizatorul rulează codul, răspunsul DNS se întoarce, și aplicația îl primește, confirmând absența problemei la nivelul rețelei.
După încă o „călătorie în jurul lumii”, apelul revine echipei noastre, iar eu îmi asum complet responsabilitatea, considerând că utilizatorului îi va fi mai convenabil dacă apelul nu mai rătăcește.
Între timp, utilizatorul este de acord să ne ofere un instantaneu al imaginii sistemului. Acestea sunt vești excelente: posibilitatea de a testa singur sistemul accelerează semnificativ procesul de depanare, deoarece nu mai trebuie să cer utilizatorului să ruleze comenzi, să-mi trimită rezultate și să le analizez, pot face totul eu!
Colegii mei încep să mă invidieze puțin. La prânz discutăm despre apel, dar nimeni nu are idei despre ce se întâmplă. Din fericire, utilizatorul a luat deja măsuri de atenuare a efectelor și nu se grăbește, așa că avem timp să disecăm problema. Și deoarece avem imaginea, putem efectua orice teste ne interesează. Excelent!
Revenind un pas în urmă
Una dintre cele mai populare întrebări la interviul pentru postul de inginer sistem este: „Ce se întâmplă când pingi ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
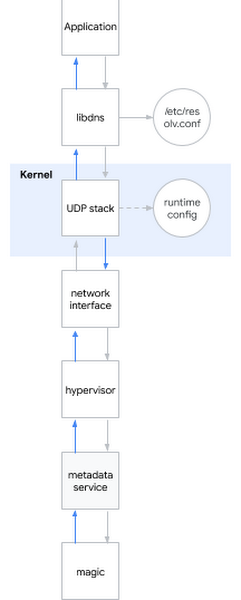
Decid să aplic această întrebare de resurse umane la problema curentă. În esență, atunci când încerci să determinți un nume DNS, se întâmplă următoarele:
- Aplicația apelează o bibliotecă de sistem, cum ar fi libdns
- libdns verifică configurația sistemului pentru a determina la ce server DNS să se conecteze (în diagramă este 169.254.169.254, serverul de metadate)
- libdns utilizează apeluri de sistem pentru a crea un socket UDP (SOCKET_DGRAM) și pentru a trimite pachete UDP cu cererea DNS în ambele direcții
- Prin intermediul interfeței sysctl, se poate configura stiva UDP la nivel de nucleu
- Nucleul interacționează cu hardware-ul pentru a transmite pachete prin rețea prin intermediul interfeței de rețea
- Hypervisorul captează și transmite pachetul către serverul de metadate la contactul cu acesta
- Serverul de metadate cu magia sa determină numele DNS și returnează un răspuns prin același proces
Îmi amintesc ce ipoteze am discutat până acum:
Ipoteza: Bibliotecile sunt defecte
- Test 1: să rulăm strace în sistem, să verificăm dacă dig apelează apeluri de sistem corecte
- Rezultatul: se apelează apeluri de sistem corecte
- Test 2: prin srapy să verificăm dacă putem determina numele ocolind bibliotecile de sistem
- Rezultatul: putem
- Test 3: să rulăm rpm -V pe pachetul libdns și md5sum pe fișierele bibliotecii
- Rezultatul: codul bibliotecii este identic cu codul din sistemul de operare funcțional
- Test 4: să montăm imaginea sistemului de fișiere rădăcină a utilizatorului pe VM fără un comportament similar, să rulăm chroot, să vedem dacă DNS funcționează
- Rezultatul: DNS funcționează corect
Concluzie pe baza testelor: problema nu este în biblioteci
Ipoteza: Există o eroare în configurațiile DNS
- Test 1: să verificăm tcpdump și să observăm dacă pachetele DNS sunt trimise și primite corect după rularea dig
- Rezultatul: pachetele sunt transmise corect
- Test 2: să verificăm din nou pe server
/etc/nsswitch.confși/etc/resolv.conf - Rezultatul: totul este corect
Concluzie pe baza testelor: problema nu este în configurația DNS
Ipoteza: nucleul este deteriorat
- Test: să instalăm un nou nucleu, să verificăm semnătura, să repornim
- Rezultatul: comportament similar
Concluzie pe baza testelor: nucleul nu este deteriorat
Ipoteza: comportament incorect al rețelei utilizatorului (sau al interfeței de rețea a hypervisorului)
- Test 1: să verificăm setările firewall-ului
- Rezultatul: firewall-ul permite pachetele DNS atât pe gazdă, cât și pe GCP
- Test 2: să interceptăm traficul și să urmărim corectitudinea transmiterii și întoarcerii cererilor DNS
- Rezultatul: tcpdump confirmă primirea pachetelor reversibile de către gazdă
Concluzie pe baza testelor: problema nu este în rețea
Ipoteza: serverul de metadate nu funcționează
- Test 1: să verificăm logurile serverului de metadate pentru anomalii
- Rezultatul: nu există anomalii în loguri
- Test 2: ocolind serverul de metadate prin
dig @8.8.8.8 - Rezultatul: rezolvarea este afectată chiar și fără utilizarea serverului de metadate
Concluzie pe baza testelor: problema nu este în serverul de metadate
Concluzie: am testat toate subsistemele cu excepția setărilor de mediu!
Adâncindu-mă în setările de mediu ale nucleului
Pentru configurarea mediului de execuție al nucleului, puteți utiliza opțiunile din linia de comandă (grub) sau interfața sysctl. Am verificat /etc/sysctl.conf și să ne gândim, am descoperit câteva setări personalizate. Simțind că m-am prins de ceva, am exclus toate setările ne-rețea sau non-tcp, rămânând cu un grup de setări net.core. Apoi m-am dus acolo unde VM-urile au permisiuni de gazdă și am început să aplic setările una câte una de la VM-ul defect, până am găsit autorul:
net.core.rmem_default = 2147483647Iată-l, configurația DNS defectuoasă! Am găsit instrumentul crimei. Dar de ce se întâmplă asta? Aveam nevoie în continuare de un motiv.
Configurarea dimensiunii de bază a bufferului pachetelor DNS se face prin net.core.rmem_default. Valoarea tipică variază undeva între 200KiB, totuși, dacă serverul dumneavoastră primește multe pachete DNS, puteți mări dimensiunea bufferului. Dacă, în momentul în care sosește un nou pachet, bufferul este plin, de exemplu, deoarece aplicația nu-l procesează suficient de repede, veți începe să pierdeți pachete. Clientul nostru a crescut corect dimensiunea bufferului deoarece se temea de pierderea datelor, deoarece utiliza o aplicație pentru colectarea metricilor prin pachete DNS. Valoarea pe care a stabilit-o a fost maximul posibil: 231-1 (dacă setați 231, nucleul va returna „ARGUMENT INVALID”).
Deodată, am realizat de ce nmap și scapy funcționează corect: ele folosesc socketuri brute! Socketurile brute diferă de cele normale: ele ocolesc iptables și nu sunt tamponate!
Dar de ce „buffer prea mare” provoacă probleme? El evident nu funcționează așa cum ar trebui.
Până în acest moment, am reușit să reproduc problema pe mai multe nuclee și numeroase distribuții. Problema s-a manifestat deja pe nucleul 3.x și acum apare și pe nucleul 5.x.
Într-adevăr, când rulam
sysctl -w net.core.rmem_default=$((2**31-1))DNS-ul înceta să funcționeze.
Am început să caut valori funcționale printr-un algoritm simplu de căutare binară și am descoperit că sistemul funcționează cu 2147481343, însă acest număr era pentru mine o secvență de cifre fără sens. I-am propus clientului să încerce acest număr, iar el a răspuns că sistemul a funcționat cu google.com, dar continua să returneze o eroare cu alte domenii, așa că am continuat investigația.
Am instalat , un instrument de care ar fi trebuit să mă folosesc mai devreme: arată exact unde ajunge un pachet în nucleu. Vinovată s-a dovedit a fi funcția udp_queue_rcv_skb. Am descărcat sursele nucleului și am adăugat câteva pentru a urmări exact unde ajunge pachetul. Am descoperit rapid condiția necesară if, și o vreme pur și simplu m-am uitat la ea, pentru că atunci totul s-a prins în imaginea de ansamblu: 231-1, un număr absurd, un domeniu nefuncțional… A fost vorba de un fragment de cod în __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Rețineți:
rmemare tipul intdimensiuneare tipul u16 (un int semn neînscris pe 16 biți) și păstrează dimensiunea pachetuluisk->sk_rcybufare tipul int și păstrează dimensiunea buffers care este definită ca valoarea dinnet.core.rmem_default
Când sk_rcvbuf aproape de 231, iar suma dimensiunii pachetului poate duce la . Și fiindcă este int, valoarea sa devine negativă, astfel încât condiția devine adevărată atunci când ar trebui să fie falsă (mai multe despre asta puteți afla din ).
Eroarea se rezolvă într-un mod trivial: prin conversie la unsigned int. Am aplicat soluția și am repornit sistemul, după care DNS-ul a început din nou să funcționeze.
Gustul victoriei
Am trimis descoperirile mele clientului și am expediat patch-ul nucleului. Sunt mulțumit: fiecare piesă a puzzle-ului a fost completă, pot explica exact de ce am observat ceea ce am observat și, cel mai important, am reușit să găsim soluția problemei datorită muncii în echipă!
Trebuie să recunoaștem că acest caz a fost rar, iar din fericire, utilizatorii noștri nu ne trimit adesea cereri atât de complexe.
Sursa: habr.com
