

Bună ziua tuturor. În acest articol, voi explica de ce noi, la Avito, am ales Kafka acum nouă luni și ce reprezintă acesta. Voi împărtăși unul dintre cazurile de utilizare — broker de mesaje. La final, vom discuta despre beneficiile pe care le-am obținut din aplicarea abordării Kafka as a Service.
Problema
Pentru început, puțin context. Cu ceva timp în urmă, am început să ne îndepărtăm de arhitectura monolitică, iar acum, la Avito, există deja câteva sute de servicii diferite. Acestea au propriile stocări, propriul stivă de tehnologii și sunt responsabile pentru partea lor de logică de afaceri.
Una dintre problemele cu un număr mare de servicii este comunicarea. Serviciul A dorește adesea să afle informații pe care le are serviciul B. În acest caz, serviciul A se adresează serviciului B printr-o API sincronă. Serviciul C vrea să știe ce se întâmplă în cazul serviciilor G și D, iar acestea, la rândul lor, sunt interesate de serviciile A și B. Pe măsură ce numărul acestor servicii "curioase" crește, legăturile dintre ele devin un ghem complicat.
În același timp, în orice moment, serviciul A poate deveni indisponibil. Și ce ar trebui să facă serviciul B și toate celelalte servicii legate de acesta? Iar dacă pentru a efectua o operațiune de afaceri trebuie să se facă o serie de apeluri sincrone consecutive, probabilitatea ca întreaga operațiune să eșueze crește și mai mult (iar aceasta devine mai mare cu cât această serie este mai lungă).
Alegerea tehnologiei
Bine, problemele sunt clare. Acestea pot fi rezolvate prin crearea unei sisteme centralizate de schimb de mesaje între servicii. Acum, fiecare serviciu trebuie să știe doar despre această sistemă de schimb de mesaje. În plus, sistemul însuși trebuie să fie tolerant la erori și scalabil orizontal, precum și, în caz de avarii, să acumuleze un buffer de apel pentru procesarea ulterioară.
Acum să alegem tehnologia pe care va fi implementată livrarea mesajelor. Pentru aceasta, mai întâi să înțelegem ce așteptăm de la ea:
- mesajele între servicii nu trebuie să se piardă;
- mesajele pot fi duplicate;
- mesajele pot fi stocate și citite pentru o durată de câteva zile (buffer persistent);
- serviciile se pot abona la datele care le interesează;
- mai multe servicii pot citi aceleași date;
- mesajele pot conține un payload detaliat și voluminos (transfer de stare purtat de evenimente);
- uneori este necesară o garanție a ordinii mesajelor.
De asemenea, a fost esențial pentru noi să alegem un sistem extrem de scalabil și de încredere, cu o capacitate mare de procesare (de cel puțin 100k mesaje de câțiva kilobiți pe secundă).
În această etapă, ne-am despărțit de RabbitMQ (dificil de menținut stabil la rate mari de procesare), PGQ de la SkyTools (prea lent și slab scalabil) și NSQ (nepermanent). Toate aceste tehnologii sunt utilizate în compania noastră, dar nu se potriveau cu sarcina pe care trebuia să o rezolvăm.
Apoi am început să explorăm tehnologii noi pentru noi - Apache Kafka, Apache Pulsar și NATS Streaming.
Primul pe care l-am exclus a fost Pulsar. Am decis că Kafka și Pulsar sunt soluții destul de asemănătoare. Și, deși Pulsar a fost testat de companii mari, este mai nou și oferă latențe mai mici (în teorie), am decis să păstrăm Kafka din cele două, ca standard de facto pentru astfel de sarcini. Probabil ne vom întoarce la Apache Pulsar în viitor.
Și iată că au rămas doi candidați: NATS Streaming și Apache Kafka. Am studiat destul de detaliat ambele soluții, iar ambele s-au potrivit pentru sarcină. Dar, în cele din urmă, ne-am temut de tânărul NATS Streaming (și de faptul că unul dintre principalii dezvoltatori, Tyler Treat, a decis să părăsească proiectul și să înceapă unul propriu - Liftbridge). De asemenea, modul de Clustering al NATS Streaming nu oferea posibilitatea de scalare orizontală puternică (probabil că aceasta nu mai este o problemă după adăugarea modului de partitioning în 2017).
Cu toate acestea, NATS Streaming este o tehnologie grozavă, scrisă în Go și având suport din partea Cloud Native Computing Foundation. Spre deosebire de Apache Kafka, nu are nevoie de Zookeeper pentru a funcționa (posibil, ), deoarece interiorul său implementa RAFT. În plus, NATS Streaming este mai simplu de administrat. Nu excluzem că ne vom întoarce la această tehnologie în viitor.
Cu toate acestea, astăzi câștigătorul nostru este Apache Kafka. În testele noastre, a demonstrat a fi suficient de rapid (peste un milion de mesaje pe secundă la citire și la scriere pentru un volum de mesaj de 1 kilobit), suficient de fiabil, bine scalabil și dovedit prin experiență în producție de companii mari. În plus, Kafka este susținut de cel puțin câteva companii comerciale mari (noi, de exemplu, folosim versiunea Confluent), iar Kafka are un ecosistem dezvoltat.
Prezentare generală Kafka
Înainte de a începe, vă recomand din start o carte excelentă - „Kafka: The Definitive Guide” (există și în traducerea în rusă, dar termenii sunt puțin derutanti). În ea puteți găsi informații necesare pentru o înțelegere de bază a Kafka și chiar puțin mai mult. Documentația de la Apache și blogul de la Confluent sunt, de asemenea, foarte bine scrise și ușor de citit.
Așadar, să aruncăm o privire asupra modului în care este organizată Kafka dintr-o perspectivă de ansamblu. Topologia de bază a Kafka constă din producer, consumer, broker și zookeeper.
Broker
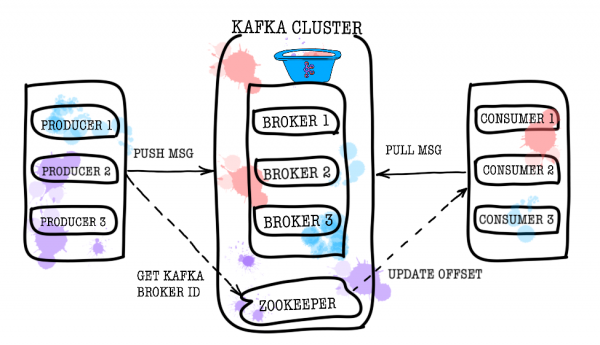
Brokerul (broker) este responsabil pentru stocarea datelor dumneavoastră. Toate datele sunt stocate în formă binară, iar brokerul știe puțin despre ce reprezintă acestea și care este structura lor.
Fiecare tip logic de eveniment se află, de obicei, într-un topic separat (topic). De exemplu, un eveniment de creare a unei anunțuri poate ajunge în topicul item.created, iar un eveniment de modificare a acestuia – în item.changed. Topicurile pot fi considerate clasificatori de evenimente. La nivel de topic, se pot seta următorii parametri de configurare:
- volumul datelor stocate și/sau vechimea acestora (retention.bytes, retention.ms);
- factorul de redundanță a datelor (replication factor);
- dimensiunea maximă a unui mesaj (max.message.bytes);
- numărul minim de replici sincronizate, în care se pot scrie date în topic (min.insync.replicas);
- posibilitatea de a efectua failover pe o replică întârziată nesincronizată cu o potențială pierdere de date (unclean.leader.election.enable);
- și multe altele ().
La rândul său, fiecare topic este împărțit în una sau mai multe partiții (partition). Evenimentele ajung în cele din urmă în partiții. Dacă în cluster există mai mult de un broker, partițiile vor fi distribuite uniform între toți brokerii (cât mai mult posibil), ceea ce va permite scalarea sarcinii de scriere și citire pe un topic simultan pe mai mulți brokeri.
Pe disc, datele pentru fiecare partiție sunt stocate sub formă de fișiere de segmente, care, în mod implicit, au dimensiunea de un gigabyte (controlat prin log.segment.bytes). O caracteristică importantă este că ștergerea datelor din partiții (la activarea retention) se face exact pe segmente (nu se poate șterge un singur eveniment dintr-o partiție, se poate șterge doar un întreg segment, și anume unul neactiv).
Zookeeper
Zookeeper joacă rolul de depozit pentru metadate și coordonator. El este capabil să spună dacă brokerii sunt activi (o puteți observa din perspectiva zookeeper-ului utilizând comanda zookeeper-shell ls /brokers/ids), care dintre brokeri este controller (get /controller), sunt partitiile în stare sincronizată cu replicile lor (get /brokers/topics/topic_name/partitions/partition_number/state). De asemenea, producătorul și consumatorul vor comunica întâi cu zookeeper pentru a afla pe care broker sunt stocate anumite topicuri și partiții. În cazurile în care un topic are un factor de replicare mai mare de 1, zookeeper va indica care partiții sunt lideri (în care se va efectua scrierea și din care se va citi). În cazul căderii broker-ului, informațiile despre noile partiții lider vor fi scrise exact în zookeeper (începând din versiunea 1.1.0, asincron, ).
În versiunile mai vechi ale Kafka, zookeeper era responsabil și pentru stocarea offset-urilor, dar acum acestea sunt stocate într-un topic special __consumer_offsets pe broker (deși puteți utiliza în continuare zookeeper în aceste scopuri).
Cel mai simplu mod de a transforma datele dvs. în dovleci este chiar pierderea informațiilor din zookeeper. Într-un astfel de scenariu, va fi foarte greu să înțelegeți ce și de unde trebuie să citiți.
Producer
Producer-ul este cel mai adesea un serviciu care efectuează scrierea directă a datelor în Apache Kafka. Producer-ul alege topic-ul în care vor fi stocate mesajele sale tematice și începe să scrie informații în acesta. De exemplu, producer-ul poate fi un serviciu de anunțuri. În acest caz, va trimite în topicurile tematice evenimente precum „anunț creat”, „anunț actualizat”, „anunț șters” etc. Fiecare eveniment reprezintă o pereche cheie-valoare.
Implicit, toate evenimentele sunt distribuite pe partițiile topic-ului folosind round-robin dacă cheia nu este specificată (pierdând ordonarea), și prin MurmurHash (cheie), dacă cheia este prezentă (ordonarea în cadrul unei singure partiții).
Aici trebuie menționat că Kafka garantează ordinea evenimentelor doar în cadrul unei singure partiții. Totuși, de multe ori acest lucru nu reprezintă o problemă. De exemplu, este posibil să se adauge cu certitudine toate modificările unui singur anunț într-o partiție (menținând astfel ordinea acestor modificări în cadrul anunțului). De asemenea, se pot transmite numere de ordine într-unul dintre câmpurile evenimentului.
Consumer
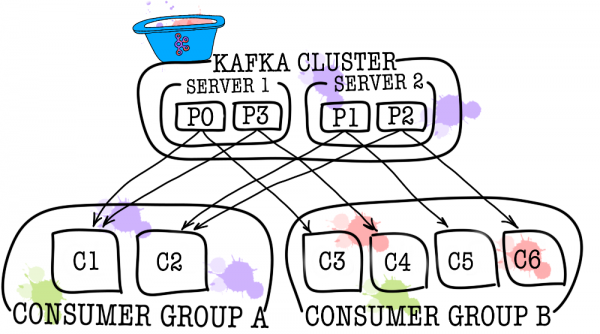
Consumerul este responsabil pentru obținerea datelor din Apache Kafka. Dacă revenim la exemplul de mai sus, consumerul poate fi un serviciu de moderare. Acest serviciu se va abona la topicul serviciului de anunțuri și, atunci când apare un nou anunț, îl va primi și va analiza pentru a verifica dacă respectă anumite politici stabilite.
Apache Kafka reține ultimele evenimente primite de consumer (pentru aceasta se folosește un topic de servicii. __consumer__offsets), asigurând astfel că, la citirea cu succes, consumerul nu va primi același mesaj de două ori. Cu toate acestea, dacă se folosește opțiunea enable.auto.commit = true și se lasă complet monitorizarea poziției consumer-ului pe seama Kafka, este posibil să . În codul de producție, de obicei, poziția consumer-ului este controlată manual (dezvoltatorul gestionează momentul în care trebuie să aibă loc un commit al evenimentului citit).
În cazurile în care un singur consumer nu este suficient (de exemplu, fluxul de evenimente noi este foarte mare), se pot adăuga încă câțiva consumatori, legându-i împreună într-un consumer group. Consumer group reprezintă logic același consumer, dar cu distribuirea datelor între participanții grupului. Aceasta permite fiecărui participant să preia o parte din mesaje, astfel scalând viteza de citire.
Rezultatele testării
Aici nu voi scrie multe explicații, ci voi împărtăși doar rezultatele obținute. Testarea a fost realizată pe 3 mașini fizice (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), brokerii și zookeeper au fost desfășurați în lxc.
Testarea performanței
În timpul testării au fost obținute următoarele rezultate.
- Viteza de scriere a mesajelor de 1KB simultan de către 9 producători — 1300000 evenimente pe secundă.
- Viteza de citire a mesajelor de 1KB simultan de către 9 consumatori — 1500000 evenimente pe secundă.
Testarea rezilienței
În timpul testării au fost obținute următoarele rezultate (3 brokeri, 3 zookeeper).
- Defecțiunea unui broker nu duce la oprirea sau indisponibilitatea clusterului. Funcționarea continuă în mod normal, dar pe brokerii rămași există o sarcină mai mare.
- Terminarea neplanificată a două brokeri într-un cluster format din trei brokeri și min.isr = 2 duce la indisponibilitatea cluster-ului pentru scriere, dar rămâne disponibil pentru citire. În cazul în care min.isr = 1, cluster-ul rămâne disponibil atât pentru citire, cât și pentru scriere. Totuși, acest mod contravine cerinței de înaltă păstrare a datelor.
- Terminarea neplanificată a unuia dintre serverele Zookeeper nu duce la oprirea sau indisponibilitatea cluster-ului. Funcționarea continuă în mod normal.
- Terminarea neplanificată a două servere Zookeeper duce la indisponibilitatea cluster-ului până la restabilirea funcționării cel puțin unui server Zookeeper. Această afirmație este adevărată pentru un cluster Zookeeper format din 3 servere. Ca urmare a cercetărilor, s-a decis extinderea cluster-ului Zookeeper la 5 servere pentru a crește reziliența.
Kafka ca serviciu
Am constatat că Kafka este o tehnologie excelentă care ne permite să rezolvăm sarcina propusă (implementarea unui broker de mesaje). Cu toate acestea, am decis să interzicem serviciilor accesul direct la Kafka și am închis-o deasupra cu un serviciu data-bus. De ce am făcut acest lucru? De fapt, sunt câteva motive.
Data-bus a preluat toate sarcinile legate de integrarea cu Kafka (implementarea și configurarea consumatorilor și producătorilor, monitorizarea, alertarea, logarea, scalarea etc.). Astfel, integrarea cu brokerul de mesaje se face cât mai simplu.
Data-bus a permis abstractizarea de un anumit limbaj sau bibliotecă pentru lucrul cu Kafka.
Data-bus a permis altor servicii să se abstreze de stratul de stocare. Poate că, la un moment dat, vom schimba Kafka cu Pulsar, și nimeni nu va observa (toate serviciile cunosc doar API-ul data-bus).
Data-bus a preluat validarea schemelor de evenimente.
Cu ajutorul data-bus-ului a fost implementată autentificarea.
Sub umbrela data-bus-ului, putem actualiza versiunile Kafka fără downtime, neobservat, și gestiona centralizat configurațiile producătorilor, consumatorilor, brokerilor etc.
Data-bus ne-a permis să adăugăm funcționalitățile necesare care nu sunt disponibile în Kafka (precum auditul topicurilor, monitorizarea anomaliilor din cluster, crearea DLQ etc.).
Data-bus permite implementarea failover-ului într-un mod centralizat pentru toate serviciile.
În prezent, pentru a începe trimiterea de evenimente către brokerul de mesaje, este suficient să conectați o mică bibliotecă în codul serviciului dumneavoastră. Atât. Aveți posibilitatea de a scrie, citi și scala cu o singură linie de cod. Toată implementarea este ascunsă de ochii dumneavoastră, lăsând la suprafață doar câteva manete de tipul dimensiunii batch-ului. Sub capotă, serviciul data-bus ridică în Kubernetes numărul necesar de instanțe de producători și consumatori și le furnizează configurația necesară, dar toate acestea sunt transparente pentru serviciul dumneavoastră.
Desigur, nu există o soluție universală și această abordare are propriile sale limitări.
- Data-bus trebuie susținut de sine, spre deosebire de bibliotecile externe.
- Data-bus crește numărul de interacțiuni între servicii și brokerul de mesaje, ceea ce duce la o scădere a performanței în comparație cu Kafka gol.
- Nu totul poate fi ascuns atât de simplu de servicii, nu ne dorim să duplicăm funcționalitatea KSQL sau Kafka Streams în data-bus, de aceea uneori trebuie să permitem serviciilor să acceseze direct.
În cazul nostru, avantajele au depășit dezavantajele, iar soluția de a ascunde brokerul de mesaje sub un serviciu separat s-a dovedit a fi justificată. Într-un an de utilizare, nu am avut accidente sau probleme grave.
P.S. Mulțumesc iubitei mele, Ekaterina Obalaya, pentru imaginile grozave folosite în acest articol. Dacă v-au plăcut, vor mai exista și alte ilustrații.
Sursa: habr.com
