

Bun venit, Habr!
Într-o vreme, noi am fost primii care au adus pe piața rusă tema și continuăm să ne concentrăm asupra dezvoltării acesteia. În special, ni s-a părut interesant subiectul interacțiunii dintre Kafka și . O revizuire (și destul de prudentă) pe această temă a fost publicată pe blogul companiei Confluent încă din octombrie anul trecut, scrisă de Gwen Shapira. Astăzi vrem să atragem atenția asupra unui articol mai recent, din aprilie, scris de Johann Gyger, care, deși nu a ezitat să pună un semn de întrebare în titlu, abordează tema într-o manieră mai concretă, însoțind textul cu linkuri interesante. Vă cerem scuze pentru traducerea liberă a termenului „chaos monkey”, dacă puteți!
Introducere
Kubernetes este destinat să funcționeze cu sarcini fără stare. În general, aceste sarcini de lucru sunt reprezentate sub forma unei arhitecturi bazate pe microservicii, sunt ușoare, se pretează bine la scalarea orizontală, respectă principiile aplicațiilor 12-factor și permit utilizarea întrerupătoarelor automate (circuit breaker) și maimuțelor haotice (chaos monkeys).
Kafka, situat de cealaltă parte, funcționează de fapt ca o bază de date distribuită. Astfel, atunci când lucrați, trebuie să țineți cont de starea sa, care este mult mai greoaie decât cea a unui microserviciu. Kubernetes suportă sarcini cu stare, dar, așa cum indică Kelsey Hightower în două dintre tweet-urile sale, trebuie tratate cu prudență:
Unii cred că, dacă aplici Kubernetes pe o sarcină cu stare, acesta devine o bază de date complet gestionată, capabilă să concureze cu RDS. Nu este așa. Poate că, dacă te străduiești suficient, adăugând componente suplimentare și implicând o echipă de ingineri SRE, poți construi RDS deasupra Kubernetes.
Întotdeauna recomand tuturor să manifeste o prudență deosebită atunci când rulează sarcini cu stare pe Kubernetes. Cei mai mulți dintre cei care se întreabă, „pot rula sarcini cu stare pe Kubernetes” nu au suficientă experiență în utilizarea Kubernetes și, de multe ori, nici cu sarcina despre care întreabă.
Deci, ar trebui să rulăm Kafka pe Kubernetes? Întrebarea următoare: va funcționa mai bine Kafka fără Kubernetes? Iată de ce vreau să subliniez în acest articol cum Kafka și Kubernetes se completează reciproc și care sunt capcanele care pot apărea în combinația lor.
Timp de execuție
Să discutăm despre un aspect de bază — mediu de execuție ca atare
Procesul
Brokerii Kafka sunt eficienți în utilizarea CPU. TLS poate adăuga anumite cheltuieli. Cu toate acestea, clienții Kafka pot suprasolicita CPU-ul mai mult dacă utilizează criptarea, dar acest lucru nu afectează brokerii.
Memorie
Brokerii Kafka consumă memorie. Dimensiunea heap-ului JVM este de obicei limitată la 4–5 GB, dar veți avea nevoie și de multă memorie sistemică, deoarece Kafka folosește foarte activ cache-ul de pagini. În Kubernetes, stabiliți corespunzător limitele resurselor și cererile pentru containere.
Stocare de date
Stocarea de date în containere este efemeră – datele se pierd la repornire. Pentru datele Kafka, puteți folosi un volum, iar efectul va fi similar: datele brokerului dumneavoastră vor fi pierdute după finalizare. Mesajele dumneavoastră pot fi totuși păstrate pe alți brokeri ca replici. Prin urmare, după repornire, brokerul care a eșuat trebuie mai întâi să replica toate datele, iar acest proces poate necesita mult timp. emptyDirDe aceea, ar trebui să folosiți stocare de date pe termen lung. Să fie o stocare de lungă durată non-locală cu un sistem de fișiere XFS sau, mai precis, ext4. Nu folosiți NFS. V-am avertizat. NFS versiuni v3 sau v4 nu vor funcționa. Pe scurt, brokerul Kafka se va opri dacă nu poate șterge directorul cu date din cauza problemei cu "renumirile stupide", care este actuală în NFS. Dacă până acum nu v-am convins, citiți cu mare atenție
această articol .
Rețea
Asemenea majorității sistemelor distribuite, performanța Kafka depinde semnificativ de minimizarea latențelor de rețea și maximizarea lățimii de bandă. Nu încercați să plasați toți brokerii pe același nod, deoarece acest lucru va reduce disponibilitatea. Dacă un nod Kubernetes eșuează, întregul cluster Kafka va eșua și el. De asemenea, nu dispărați clusterul Kafka pe întregi centre de date. Același lucru se aplică și clusterului Kubernetes. O bună compensație în acest caz este alegerea unor zone de disponibilitate diferite.
Configurație
Manifesturi obișnuite
Pe site-ul Kubernetes există despre cum să configurați ZooKeeper folosind manifesturi. Deoarece ZooKeeper face parte din Kafka, este convenabil să începeți familiarizarea cu conceptele Kubernetes aplicabile aici. Odată ce înțelegeți asta, veți putea utiliza aceleași concepte și cu clusterul Kafka.
- Sub: un pod – este unitatea minimă de desfășurare din Kubernetes. Podul conține sarcina dumneavoastră de lucru, iar podul corespunde unui proces din clusterul dumneavoastră. Podul conține unul sau mai multe containere. Fiecare server ZooKeeper din ansamblu și fiecare broker din clusterul Kafka va funcționa într-un pod separat.
- StatefulSet: StatefulSet – este un obiect Kubernetes care funcționează cu sarcini de lucru multiple, care păstrează starea, iar astfel de sarcini necesită coordonare. StatefulSet oferă garanții cu privire la ordonarea podurilor și unicitatea acestora.
- Servicii headless: Serviciile permit desprinderea podurilor de clienți printr-un nume logic. Kubernetes răspunde în acest caz de echilibrarea încărcării. Totuși, în operațiunile cu sarcinile de lucru care păstrează starea, cum ar fi în cazul ZooKeeper și Kafka, clienții trebuie să comunice cu o instanță anume. Aici intervine utilitatea serviciilor headless: în acest caz, clientul va avea totuși un nume logic, dar nu va fi necesar să se adreseze direct podului.
- Volum pentru stocare pe termen lung: astfel de volume sunt necesare pentru configurarea unei stocări de bloc fără localitate, menționată anterior.
Pe oferă un set exhaustiv de manifesturi,cu ajutorul cărora este ușor să începeți lucrul cu Kafka pe Kubernetes.
Diagrama Helm
Helm este un manager de pachete pentru Kubernetes, care poate fi comparat cu managerii de pachete pentru sisteme de operare, cum ar fi yum, apt, Homebrew sau Chocolatey. Cu ajutorul său, este ușor să instalați pachete software predeterminate, descrise în diagramele Helm. O diagramă Helm bine concepută facilitează sarcina complexă de a configura corect toate parametrii pentru utilizarea Kafka pe Kubernetes. Există mai multe diagrame Kafka: cea oficială se află , există una de la , și alta de la .
Operatori
Deoarece Helm are anumite limitări, un alt instrument câștigă popularitate: operatorii Kubernetes. Un operator nu doar împachetează software-ul pentru Kubernetes, ci vă permite să desfășurați și să gestionați acest software.
În lista se menționează doi operatori pentru Kafka. Unul dintre ei este . Cu ajutorul lui Strimzi, nu este deloc greu să ridicați un cluster Kafka în câteva minute. Practic, nu este necesară nicio configurare, de asemenea, operatorul oferă câteva opțiuni plăcute, cum ar fi criptarea TLS de tip «punct-la-punct» în interiorul cluster-ului. Confluent oferă de asemenea .
Performanță
Este foarte important să testați performanța, echipând exemplarul dvs. de Kafka cu puncte de control. Aceste teste vă vor ajuta să descoperiți potențiale blocaje, înainte ca problemele să înceapă. Din fericire, Kafka oferă deja două instrumente pentru testarea performanței: kafka-producer-perf-test.sh și kafka-consumer-perf-test.sh. Folosiți-le activ. Ca referință, puteți verifica rezultatele descrise de Jay Kreps, sau să vă orientați după Amazon MSK de Stéphane Maarek.
Operații
Monitorizare
Transparența în sistem este foarte importantă – altfel nu veți înțelege ce se întâmplă în el. Astăzi există un set solid de instrumente care oferă monitorizare bazată pe metrici în stil cloud native. Două instrumente populare pentru acest scop sunt Prometheus și Grafana. Prometheus poate colecta metrici din toate procesele Java (Kafka, Zookeeper, Kafka Connect) prin intermediul exportatorului JMX – într-un mod foarte simplu. Dacă adăugați metricile cAdvisor, veți putea înțelege mai bine cum sunt utilizate resursele în Kubernetes.
Strimzi oferă un exemplu foarte util de tablă de bord Grafana pentru Kafka. Acesta vizualizează metrici cheie, cum ar fi sectoarele care nu sunt replicate sau cele care sunt offline. Totul este foarte clar. Aceste metrici sunt completate cu informații despre utilizarea resurselor și performanță, precum și indicatori de stabilitate. Astfel, obțineți un monitorizare de bază a cluster-ului Kafka fără costuri!
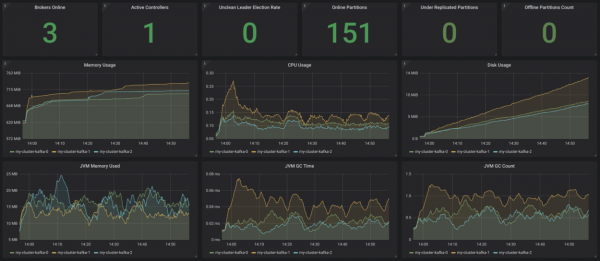
Sursa:
Toate acestea ar fi bine să fie completate cu monitorizarea clienților (metrici pentru consumatori și producători), precum și cu monitorizarea întârzierii (pentru aceasta există ) și monitorizarea de la un capăt la altul – pentru aceasta utilizați .
Logare
Logarea este o altă sarcină esențială. Asigurați-vă că toate containerele din instalarea dvs. Kafka sunt logate în stdout și stderr, precum și că cluster-ul dvs. Kubernetes agregă toate jurnalele într-o infrastructură centralizată de logare, de exemplu, în .
Verificarea funcționalității
Kubernetes utilizează sonde de „vitalitate” (liveness) și „pregătire” (readiness) pentru a verifica dacă sud-urile dvs. funcționează corect. Dacă sondajul de vitalitate eșuează, Kubernetes va opri acest container, iar apoi îl va repornit automat, dacă politica de repornire este stabilită corespunzător. Dacă sondajul de pregătire eșuează, Kubernetes va izolaa acest sud de a răspunde la cereri. Astfel, în astfel de cazuri, nu mai este necesară intervenția manuală, ceea ce reprezintă un avantaj major.
Implementarea actualizărilor
StatefulSet susține actualizări automate: atunci când se alege strategia RollingUpdate, fiecare sud Kafka va fi actualizat pe rând. Astfel, durata întreruperilor poate fi redusă la zero.
Scalare
Scalarea cluster-ului Kafka este o sarcină complexă. Totuși, în Kubernetes este foarte simplu să scalați sud-urile la un anumit număr de replici, ceea ce înseamnă că puteți defini declaraativ câți brokeri Kafka doriți. Cea mai dificilă parte în acest caz este reatribuirea sectoarelor după scalarea în sus sau înainte de scalarea în jos. Din nou, Kubernetes vă va ajuta cu această sarcină.
Administrare
Sarcinile legate de administrarea cluster-ului dumneavoastră Kafka, în special crearea topicurilor și realocarea secțiunilor, pot fi realizate folosind scripturi shell disponibile, deschizând interfața de linie de comandă în podurile dumneavoastră. Cu toate acestea, această soluție nu este prea elegantă. Strimzi suportă gestionarea topicurilor printr-un alt operator. Aici este loc de îmbunătățiri.
Backup și restaurare
Acum disponibilitatea Kafka va depinde și de disponibilitatea Kubernetes. Dacă cluster-ul Kubernetes va cădea, în cel mai rău caz, va cădea și cluster-ul Kafka. Conform legii lui Murphy, acest lucru se va întâmpla, iar dumneavoastră veți pierde date. Pentru a reduce riscul unei astfel de situații, este bine să elaborați o concept de backup. Puteți utiliza MirrorMaker, o altă opțiune fiind implicarea S3, așa cum este descris în acest de la Zalando.
Concluzie
Când lucrați cu clustere Kafka mici sau medii, este cu siguranță avantajos să folosiți Kubernetes, deoarece acesta oferă flexibilitate suplimentară și simplifică gestionarea operatorilor. Dacă aveți cerințe nefuncționale foarte strict legate de întârziere și/sau lățime de bandă, atunci poate ar fi mai bine să luați în considerare o altă opțiune de desfășurare.
Sursa: habr.com
