

Norii sunt asemenea unei cutii magice - îndici ce ai nevoie, iar resursele apar din neant. Mașini virtuale, baze de date, rețea - toate acestea îți aparțin în totalitate. Există și alți utilizatori în cloud, dar în universul tău ești singurul conducător. Ești sigur că vei obține întotdeauna resursele necesare, fără să te consulti cu alții și stabilești singur cum va arăta rețeaua. Cum funcționează această magie care permite cloud-ului să aloce resurse în mod elastic și să izoleze complet utilizatorii unii de alții?
Cloud-ul AWS este un sistem mega-complex, care s-a dezvoltat evolutiv din 2006. O parte din această evoluție a fost martor Vasili Pantyuhin — arhitectul Amazon Web Services. Ca arhitect, el vede nu doar rezultatul final, ci și provocările pe care le depășește AWS. Cu cât înțelegi mai bine cum funcționează sistemul, cu atât devine mai mare încrederea. De aceea, Vasilii va împărtăși secretele serviciilor cloud AWS. În acest articol, vei descoperi structura serverelor fizice AWS, scalabilitatea elastică a bazelor de date, baza de date personalizată Amazon și metodele de creștere a performanței mașinilor virtuale, în timp ce le reduci costurile. Cunoașterea abordărilor arhitecturale Amazon te va ajuta să folosești mai eficient serviciile AWS și, poate, îți va oferi idei noi pentru dezvoltarea propriilor soluții.
Despre speaker: Vasilii Pantyuhin () a început ca administrator Unix în companiile .ru, a petrecut 6 ani lucrând cu echipamente mari Sun Microsystems, și 11 ani promovând centrismul datelor în EMC. A evoluat natural spre cloud-uri private, iar în 2017 a trecut la cele publice. Acum oferă sfaturi tehnice pentru a ajuta să trăiască și să se dezvolte în cloud-ul AWS.
Declinarea: tot ce urmează este părerea personală a lui Vasilii și poate să nu corespundă poziției Amazon Web Services. a prezentării, pe baza căreia a fost creat articolul, este disponibilă pe canalul nostru de YouTube.
De ce vorbesc despre structura Amazon
Mașina mea prima avea o „mâner” - cu cutie de viteze mecanică. A fost minunat datorită senzației de a putea controla mașina și de a o gestiona complet. Îmi plăcea, de asemenea, că mă înțelegeam, măcar vag, cu principiul ei de funcționare. În mod natural, imaginația mea despre structura cutiei era destul de simplistă - cam ca o cutie de viteze pe bicicletă.
Totul a fost minunat, cu o singură excepție — statul în trafic. Te simți ca și cum nu faci nimic, dar constant schimbi vitezele, apeși pe ambreiaj, accelerezi, frânezi — din cauza asta, într-adevăr, obosești. Problema traficelor s-a rezolvat parțial când familia a cumpărat o mașină cu transmisie automată. La volan, a apărut timpul să mă gândesc la ceva, să ascult o carte audio.
De asemenea, în viața mea a apărut o enigmă, deoarece am încetat complet să înțeleg cum funcționează mașina mea. O mașină modernă este un dispozitiv complex. Aceasta se adaptează simultan la zeci de parametri diferiți: apăsarea pedalei de accelerație, frâna, stilul de condus, calitatea drumului. Nu mai înțeleg cum funcționează.
Când am început să mă ocup de cloud-ul Amazon, pentru mine a fost, de asemenea, un mister. Doar că acest mister este cu un ordin mai ridicat, pentru că în mașină este un singur șofer, iar în AWS sunt milioane. Toți utilizatorii conduc simultan, accelerează și frânează. Este uimitor cum ajung acolo unde își doresc — pentru mine, aceasta este o minune! Sistemul se adaptează automat, se scalează și se ajustează elastic pentru fiecare utilizator, astfel că acesta simte că este singur în acest Univers.
Magia s-a risipit puțin când, mai târziu, am venit să lucrez ca arhitect la Amazon. Am văzut cu ce probleme ne confruntăm, cum le rezolvăm, cum dezvoltăm serviciile. Pe măsură ce înțelegerea sistemului crește, apare mai multă încredere în serviciu. De aceea vreau să împărtășesc imaginea a ceea ce se află sub capota cloud-ului AWS.
Despre ce vom discuta
Am ales o abordare diversificată — am selectat 4 servicii interesante despre care merită să vorbim.
Optimizarea serverelor. Clouds efemere cu o întrupare fizică: centre de date fizice, unde se află servere fizice, care vibrează, se încălzesc și luminează becurile.
Funcții serverless (Lambda) — probabil, cel mai scalabil serviciu din cloud.
Scalarea bazelor de date. Voi povesti despre cum construim bazele noastre de date scalabile.
Scalarea rețelei. Ultima parte, în care voi deschide structura rețelei noastre. Este o minune — fiecare utilizator al cloud-ului crede că este singur în cloud și nu vede deloc ceilalți chiriași.
Notă. În acest articol se va discuta despre optimizarea serverelor și scalarea bazei de date. Scalarea rețelei va fi discutată în articolul următor. Unde sunt funcțiile serverless? Despre acestea a fost publicată o explicare separată «». În aceasta se discută despre mai multe metode diferite de scalare, și soluția Firecracker este explicată în detaliu — un simbioză a celor mai bune calități ale mașinilor virtuale și containerelor.
Servere
Cloud-ul este efemer. Dar această efemeritate are totuși o întruchipare fizică — serverele. Inițial, arhitectura lor a fost clasică. Un chipset standard x86, plăci de rețea, Linux, hipervizor Xen, pe care au fost rulate mașinile virtuale.
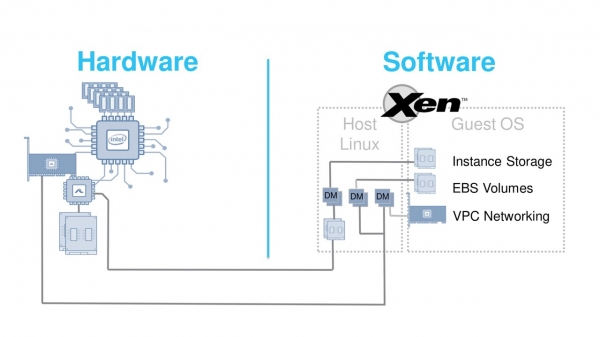
În 2012, o astfel de arhitectură făcea față cerințelor sale. Xen este un hipervizor excelent, dar are un dezavantaj serios. Acesta are costuri de suprasarcină destul de mari pentru emularea dispozitivelor. Odată cu apariția unor plăci de rețea mai rapide sau a discurilor SSD, aceste costuri de suprasarcină devin prea mari. Cum putem face față acestei probleme? Am decis să lucrăm pe două fronturi — să optimizăm atât hardware-ul, cât și hipervizorul. Sarcina este foarte serioasă.
Optimizarea hardware-ului și a hipervizorului
Nu vom reuși să facem totul dintr-o dată și bine. Ce înseamnă «bine», inițial nu era clar.
Am decis să aplicăm o abordare evolutivă — schimbăm un element important al arhitecturii și îl lansăm în producție.
Incepem să călcăm pe toate greblele, ascultăm plângerile și sugestiile. Apoi schimbăm alt component. Așa, prin mici incermente, schimbăm radical întreaga arhitectură bazându-ne pe feedback-ul utilizatorilor și al echipei de suport.
Transformările au început în 2013 cu cea mai complicată — rețeaua. În C3 instanțele standard au fost adăugate o placă specială Network Accelerator. Aceasta era conectată printr-un scurt cablu loopback pe panoul frontal. Inestetic, dar în cloud nu se vede. Totuși, interacțiunea directă cu hardware-ul a îmbunătățit semnificativ jitter-ul și capacitatea de transmisie a rețelei.
Apoi, am decis să ne ocupăm de îmbunătățirea accesului la stocarea blocului de date EBS — Elastic Block Storage. Aceasta este o combinație între rețea și stocare. Complexitatea constă în faptul că, deși pe piață existau plăci Network Accelerator, nu existau opțiuni de a cumpăra hardware pentru Storage Accelerator. Așa că ne-am adresat startup-ului Annapurna Labs, care a dezvoltat pentru noi cipuri speciale ASIC. Acestea au permis conectarea volumelor EBS de la distanță ca unități NVMe.
În instanțe C4 am rezolvat două probleme. Prima - am realizat o pregătire pentru tehnologia NVMe, care era promițătoare, dar nouă la acel moment. A doua - am descărcat semnificativ procesorul central prin mutarea procesării cererilor către EBS pe o nouă placă. A ieșit foarte bine, așa că acum Annapurna Labs face parte din Amazon.
Până în noiembrie 2017, ne-am dat seama că a sosit timpul să schimbăm și hipervizorul în sine.
Noul hipervizor a fost dezvoltat pe baza modulelor Kernel KVM îmbunătățite.
Acesta a permis reducerea semnificativă a cheltuielilor pentru emularea dispozitivelor și a lucrat direct cu noile cipuri ASIC. Instanțele C5 au fost primele mașini virtuale care au folosit noul hipervizor. L-am numit Nitro.
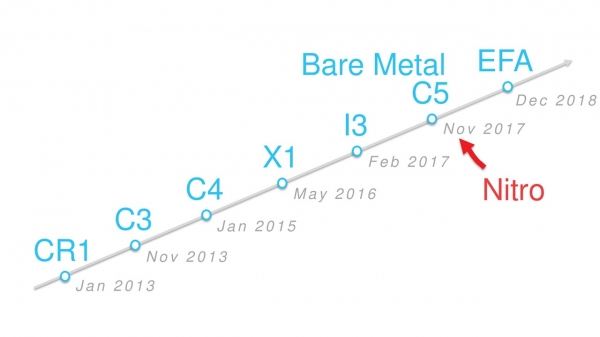 Evoluția instanțelor pe o linie temporală.
Toate noile tipuri de mașini virtuale care au apărut din noiembrie 2017 funcționează pe acest hipervizor. Instanțele Bare Metal nu au hipervizor,, dar sunt, de asemenea, numite Nitro, deoarece folosesc plăci specializate Nitro.
În următorii doi ani, numărul tipurilor de instanțe Nitro a depășit câteva zeci: A1, C5, M5, T3 și altele.
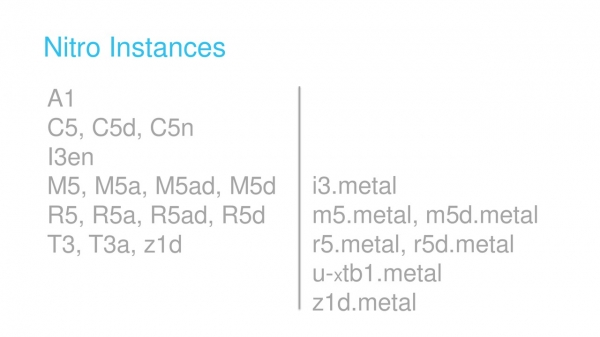
Tipuri de instanțe.
Cum sunt construite mașinile Nitro moderne
Acestea au trei componente principale: hipervizor Nitro (despre care s-a vorbit mai sus), cip de securitate și plăci Nitro.
Cipul de securitate este integrat direct în placa de bază. Acesta controlează numeroase funcții importante, de exemplu, controlul încărcării sistemului de operare gazdă.
Plăcile Nitro există în patru tipuri. Toate au fost dezvoltate de Annapurna Labs și se bazează pe ASIC-uri comune. O parte din firmware-ul lor, de asemenea, este comun.
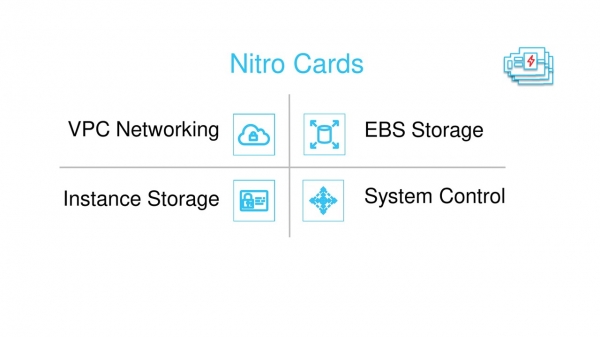
Cele patru tipuri de plăci Nitro.
Una dintre plăci este destinată lucrului cu rețeauaVPC. Aceasta este vizibilă în mașinile virtuale ca placă de rețea ENA — Elastic Network Adaptor. De asemenea, aceasta encapsulează traficul atunci când este transmis prin rețeaua fizică (despre care vom vorbi în a doua parte a articolului), controlează firewall-ul Security Groups, se ocupă de rutare și alte aspecte rețea.
Plăcile separate lucrează cu stocarea blocurilor EBS și cu discurile integrate în server. Acestea sunt prezentate pentru mașina virtuală ca adaptori NVMe. De asemenea, se ocupă de criptarea datelor și monitorizarea discurilor.
Sistemul de plăci Nitro, hipervizorul și cipul de securitate sunt unite într-o rețea SDN sau Software Defined Network. Controlul acestei rețele (Control Plane) este responsabil controler de hartă.
Desigur, continuăm dezvoltarea de noi ASIC. De exemplu, la sfârșitul anului 2018 am lansat cipul Inferentia, care permite o gestionare mai eficientă a sarcinilor de învățare automată.
Cipul Inferentia Processor pentru Învățare Automată.
Bază de date scalabilă
O bază de date tradițională are o structură stratificată. Dacă simplificăm foarte mult, se pot identifica următoarele niveluri.
- SQL — pe care lucrează gestionarii de clienți și cereri.
- Asigurări tranzacții — aici totul este clar, ACID și toate celelalte.
- Cache, care este asigurată de pool-urile de buffer.
- Logare — se ocupă de gestionarea redo-logs-urilor. În MySQL, acestea se numesc Bin Logs, iar în PostgreSQL — Write Ahead Logs (WAL).
- Stocare – direct înregistrare pe disc.
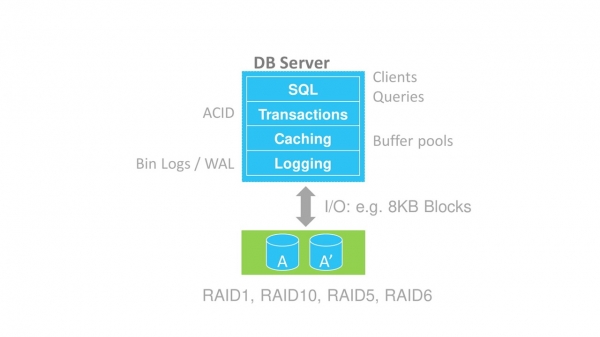
Structura stratificată a bazei de date.
Există diferite metode de scalare a bazelor de date: sharding, arhitectura Shared Nothing, discuri partajate.
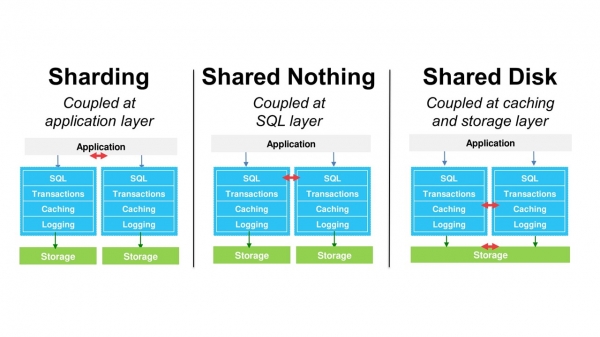
Cu toate acestea, toate aceste metode păstrează aceeași structură monolitică a bazei de date. Aceasta limitează semnificativ scalabilitatea. Pentru a rezolva această problemă, am dezvoltat propria noastră bază de date — Amazon Aurora. Este compatibilă cu MySQL și PostgreSQL.
Amazon Aurora
Ideea arhitecturală principală este de a separa nivelurile de stocare și logare de baza de date principală.
Spunând mai devreme, nivelul de caching l-am realizat, de asemenea, ca fiind independent. Arhitectura încetează să mai fie monolitică și obținem libertăți suplimentare în scalarea blocurilor individuale.
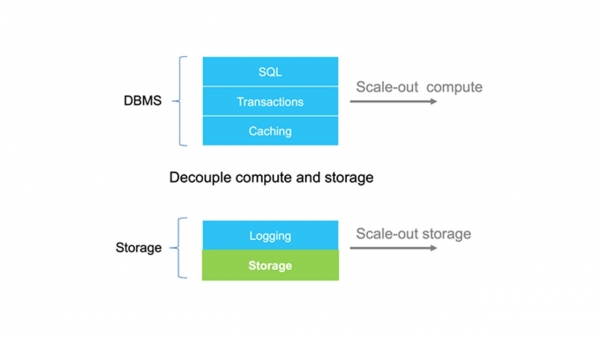
Nivelurile de logare și stocare sunt separate de baza de date.
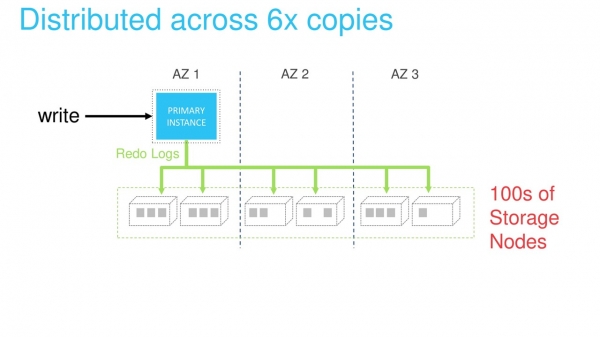
O SGBD tradițională înregistrează datele pe sistemul de stocare sub formă de blocuri. În Amazon Aurora, am creat un stocaj „inteligent”, care poate comunica în limbajul redo-logs-urilor. În interiorul său, stocajul transformă logurile în blocuri de date, monitorizează integritatea acestora și efectuează automat backup-uri.
Această abordare permite implementarea unor lucruri interesante precum clonarea. Aceasta funcționează fundamental mai repede și mai eficient, deoarece nu necesită crearea unei copii complete a tuturor datelor.
Nivelul de stocare este realizat sub forma unui sistem distribuit. Acesta constă dintr-un număr foarte mare de servere fizice. Fiecare redo-log este procesat și salvat simultan de șase noduri. Aceasta asigură protecția datelor și distribuția sarcinii.
Scalarea pentru citire poate fi realizată prin replici corespunzătoare. Stocarea distribuită elimină necesitatea sincronizării între instanța principală a bazei de date, prin care scriem datele, și celelalte replici. Datele actualizate sunt garantat disponibile pentru toate replicile.
Singura problemă este caching-ul datelor vechi pe replicile de citire. Dar această sarcină poate fi rezolvată prin transmiterea tuturor jurnalelor redo pe replici prin rețeaua internă. Dacă jurnalul este în cache, este marcat ca invalid și se rescrie. Dacă nu este în cache, este pur și simplu abandonat.
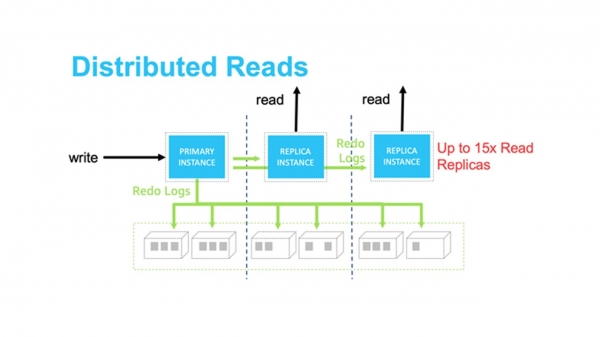
Am rezolvat problema stocării.
Cum să scalăm nivelurile DBMS
Aici scalarea orizontală este mult mai complicată. Așadar, vom urma calea scalării verticale clasice.
Să presupunem că avem o aplicație care comunică cu DBMS-ul printr-un nod master.
La scalarea verticală, alocăm un nou nod care va avea mai mulți procesoare și memorie.
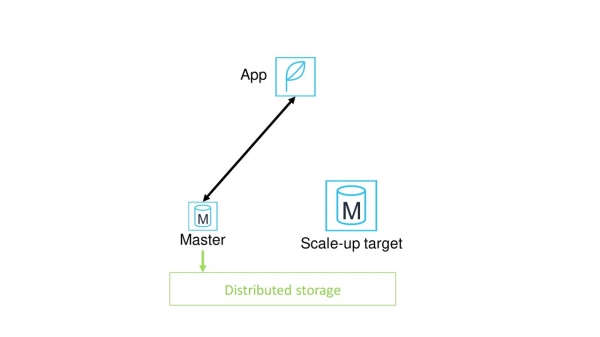
Apoi, comutăm aplicația de la vechiul nod master la nou. Apare o problemă.
- Aceasta va necesita o întrerupere semnificativă a aplicației.
- Noul nod master va avea un cache rece. Performanța DB-ului va fi maximă doar după încălzirea cache-ului.
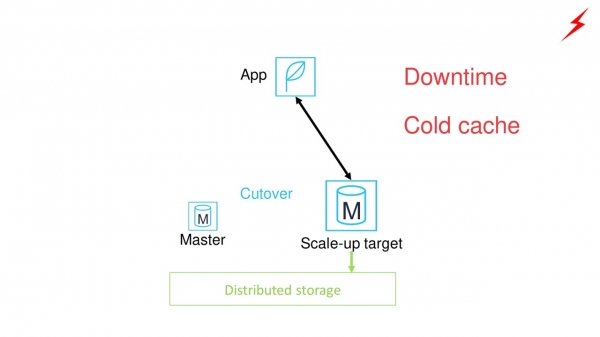
Cum putem îmbunătăți situația? Să punem un proxy între aplicație și nodul master.
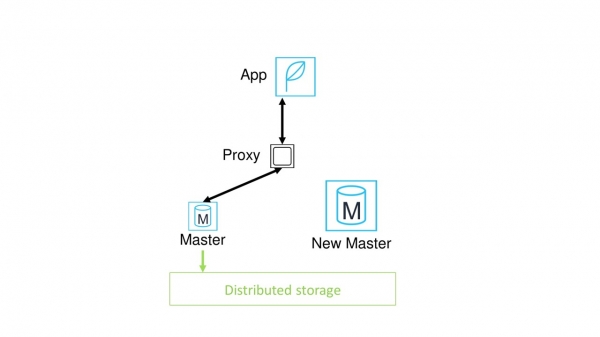
Ce ne va aduce asta? Acum nu trebuie să redirecționăm manual toate aplicațiile către noul nod. Comutarea poate fi realizată prin proxy și va fi semnificativ mai rapid.
Se pare că problema a fost rezolvată. Dar nu, încă suferim din cauza necesității de încălzire a cache-ului. În plus, a apărut o nouă problemă - acum proxy-ul este un potențial punct de defectare.
Soluția finală cu Amazon Aurora serverless
Cum am rezolvat aceste probleme?
Am păstrat proxy-ul. Acesta nu este o instanță separată, ci o întreagă flotă distribuită de proxy-uri, prin care aplicațiile se conectează la baza de date. Orice nod în cazul defectării poate fi înlocuit aproape instantaneu.
Am adăugat un rezervor de noduri calde de diferite dimensiuni. Prin urmare, atunci când este necesară alocarea unui nou nod mai mare sau mai mic, acesta este imediat disponibil. Nu trebuie să așteptăm până se încarcă.
întregul proces de scalare este controlat de un sistem specializat de monitorizare. Monitorizarea urmărește constant starea nodului principal curent. Dacă detectează, de exemplu, că sarcina procesorului a atins o valoare critică, îi va anunța pe instanțele calde că este necesară alocarea unui nou nod.
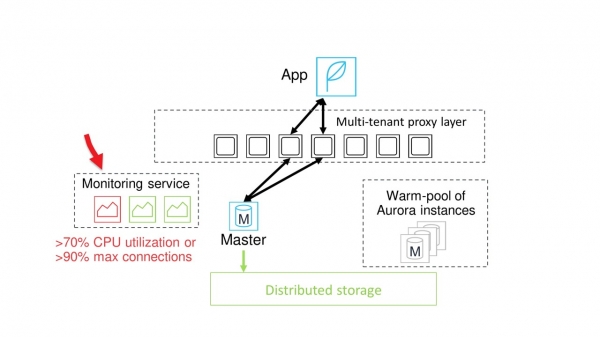
Proxii distribuiți, instanțe calde și monitorizare.
Nodul de putere necesară este disponibil. Pe acesta se copiază puzderile de buffer, iar sistemul începe să aștepte un moment sigur pentru comutare.
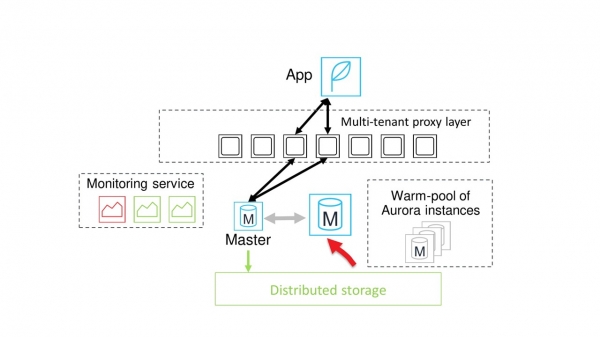
De obicei, momentul pentru comutare apare destul de repede. Atunci, comunicația între proxi și vechiul nod principal este suspendată, toate sesiunile fiind comutate pe noul nod.
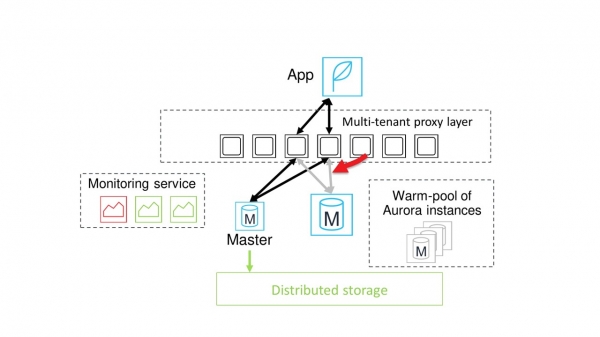
Activitatea cu baza de date este reluată.
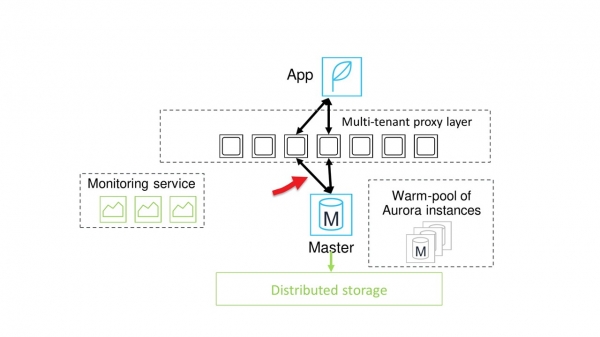
Pe grafic se vede că suspendarea este, într-adevăr, foarte scurtă. Pe graficul albastru este sarcina, iar pe treptele roșii — momentele de scalare. Picăturile temporare din graficul albastru reprezintă exact acea întârziere scurtă.
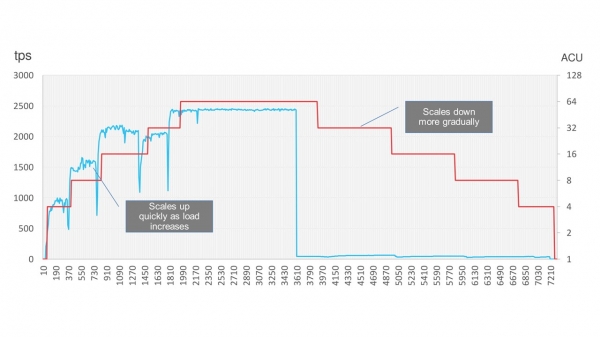
Apropo, Amazon Aurora permite economisirea resurselor și oprirea bazei de date când aceasta nu este folosită, de exemplu, în weekend. După oprire, sarcina bazei de date își reduce treptat puterea și se deconectează pentru o perioadă de timp. Când sarcina revine, aceasta se reîntrege gradual.
În partea următoare a poveștii despre dispozitivul Amazon, vom vorbi despre scalarea rețelei. Abonați-vă și urmăriți actualizările pentru a nu rata articolul.
Pe Vasili Pantyuhin va susține o prezentare intitulată „”. Ce modele de proiectare a sistemelor distribuite folosește Amazon, care sunt motivele posibile ale eșecurilor serviciilor, ce înseamnă arhitectura bazată pe celule, Lucru constant, Shuffle Sharding — va fi interesant. Mai sunt mai puțin de o lună până la conferință — . 24 octombrie este termenul limită pentru creșterea prețurilor.
Sursa: habr.com
